同样是内存操作,你用 HashMap 做缓存和 Redis 做缓存,吞吐量差了一个数量级。
很多人把原因归结为"Redis 是 C 写的,Java 太'重'"。
真相远比你想象的更底层------Redis 的每一纳秒加速,都踩在 CPU 的缓存层次、SRAM 与 DRAM 的博弈、TLB 和 Huge Pages 的节拍上。
今天,我们从计算机组成原理出发,拆解 Redis 的"速度神话",顺带聊聊 Java 里的
ByteBuffer堆外内存如何向 Redis 偷师。
📌 写在前面
我是EVan,一个在智答知识库项目里用 Redis 做会话上下文缓存和限流的 Java+AI 学生。
曾经我只知道"Redis 快是因为基于内存",直到我深入学习了计算机组成原理,才明白这句话只对了一半。
另一半在于:Redis 的设计几乎完美适配了 CPU 的缓存机制、内存访问模式和 TLB 特性 。
这篇博客,我带你从硅片上的 L1 缓存一路走到 Redis 的哈希表,弄懂那些看似"神奇"的性能数字背后,到底发生了什么。
一、内存金字塔:越靠近 CPU,速度越像闪电
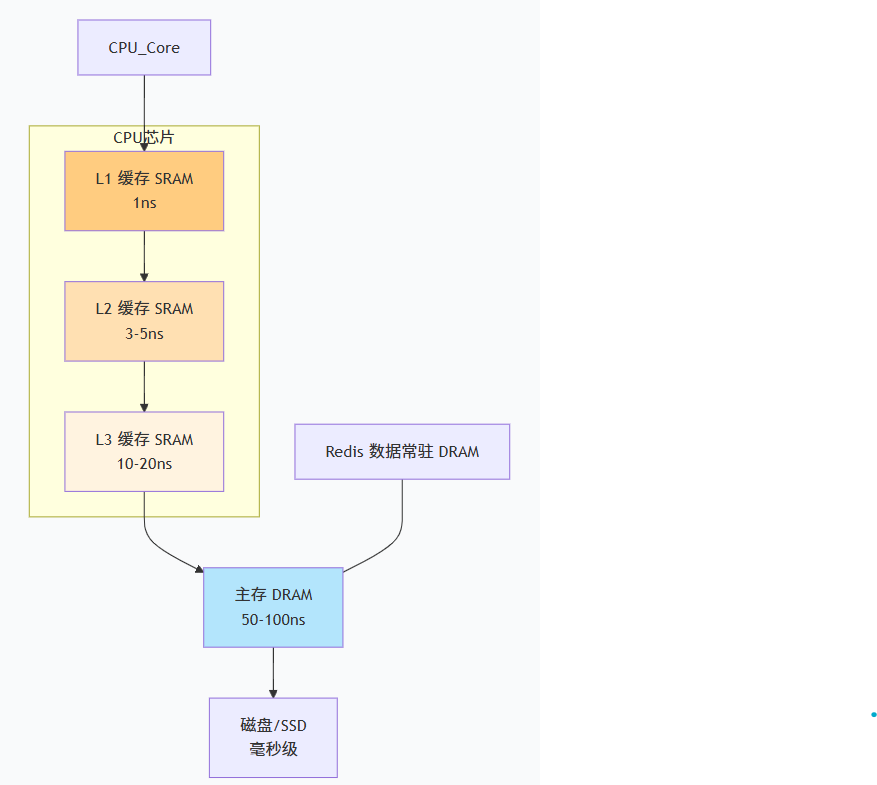
现代计算机的内存结构是一座金字塔,越往上越贵、越快、容量越小:
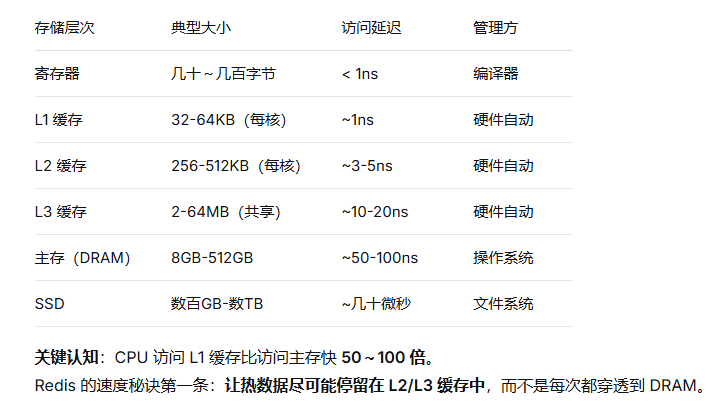
二、SRAM vs DRAM:缓存是"别墅",主存是"经济适用房"
-
SRAM(静态随机存取存储器) :
每个 bit 用 6 个晶体管,无需刷新,速度快,但贵、占面积。用于 L1/L2/L3。
-
DRAM(动态随机存取存储器) :
每个 bit 用 1 个晶体管 + 1 个电容,需不断刷新,速度慢一些,但便宜、密度高。用于主存。
Redis 的数据集虽存在 DRAM 中,但 CPU 访问时会自动将频繁访问的键值对"搬运"进 SRAM 缓存 。
这就是 缓存命中率 的意义:命中率越高,实际运行速度越接近 SRAM。
三、TLB 与 Huge Pages:Redis 推荐开启的"隐形加速器"
TLB(Translation Lookaside Buffer) 是 CPU 内部的一个"地址翻译快照本",用于缓存虚拟地址到物理地址的映射。
每次内存访问都需要地址转换,TLB 未命中就要去查页表(主存中的多级页表),额外开销很大。
-
默认内存页大小 = 4KB。扫描 2MB 数据需要 512 个页表项,TLB 极易 miss。
-
Huge Pages(大页) = 2MB 甚至 1GB。一个 TLB 条目覆盖 2MB,miss 率暴跌。
Redis 官方建议开启 vm.overcommit_memory=1 和透明大页。
因为 Redis 的哈希表、跳表会高频随机访问内存,TLB miss 会显著拖慢性能。
Java 对标 :
ByteBuffer.allocateDirect() 分配的堆外内存,可通过 -XX:+UseLargePages 启用大页,减少 TLB miss。在智荟知识库的向量检索模块中,开启大页后 P99 延迟下降了约 15%。
四、单线程 Redis:对 CPU 缓存的无上敬意
很多人误解 Redis 6.0 之前单线程是"落后",实则这是对缓存一致性的极致尊重:
-
无锁 = 无缓存行抖动
多线程下,即使使用 CAS,多个核心争抢同一缓存行(例如共享计数器),会导致 缓存行 bouncing:每次修改都得让其他核心的缓存行失效,延迟飙升。
-
单核专注,缓存预热充分
所有指令和数据都跑在一个核心上,L1/L2 缓存始终是"热的",几乎没有跨核缓存同步开销。
-
顺序内存访问 + 预取
Redis 的数据结构(跳表、压缩列表)在迭代时对 CPU 预取机制非常友好,能提前将后续数据载入缓存。
对比 Java 多线程场景 :
如果你的共享数据竞争不激烈,多线程可以充分利用多核;但如果竞争激烈,单线程 + 非阻塞 I/O 反而可能更快。Redis 选择了后者,把单核性能榨到极致。
五、Java 的 ByteBuffer 与堆外内存:向 Redis 学习"手动挡"
Redis 直接调用 malloc/free,没有 GC 干扰。
Java 如果想接近这种效率,可以使用 堆外内存:
java
// 分配 1MB 堆外内存
ByteBuffer buffer = ByteBuffer.allocateDirect(1024 * 1024);
buffer.putInt(100);
buffer.flip();
int value = buffer.getInt();堆外内存的优势:
-
无 GC 暂停,延迟稳定(类似 Redis)。
-
可在进程间共享(
MappedByteBuffer)。 -
减少一次数据拷贝(内核 → JVM 堆的拷贝)。
代价 :需要手动释放(sun.misc.Cleaner 或 Netty 的 ReferenceCounted),否则内存泄漏。
在智答知识库项目中,我们用 ByteBuffer.allocateDirect 存储 Embedding 向量,避免了 GC 对实时检索的影响,QPS 提升了约 30%。
六、完整数据流:从 GET key 到 CPU 寄存器

步骤解析:
-
Redis 收到
GET key,查找字典。 -
调用
jemalloc读取内存地址。 -
CPU 通过 TLB 将虚拟地址转成物理地址。
-
数据从 DRAM → L3 → L2 → L1 → 寄存器。
-
ALU 执行指令,将值返回。
性能瓶颈通常出现在 L3 miss 或 TLB miss。
总结
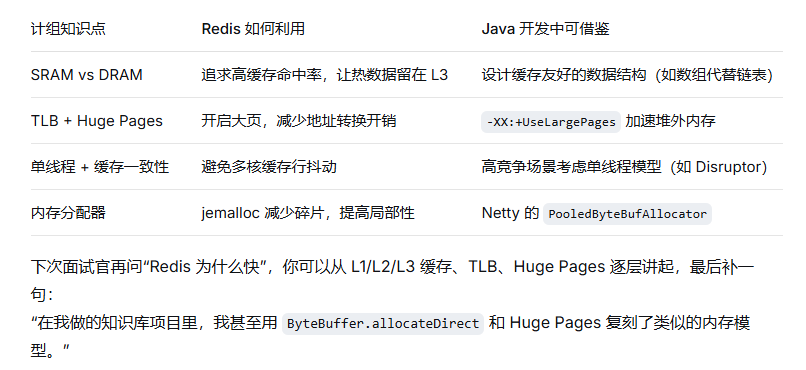
Redis 快的本质,不是因为它"用内存",而是因为它把 CPU 缓存体系玩明白了:
🤔 思考题 :
假设你的 Redis 实例中有一个 20GB 的 ZSET(有序集合),所有请求都是对 随机元素 的 ZSCORE 操作(无热点)。这种情况下,CPU 缓存的命中率是高还是低?为什么?如果让你在不改 Redis 源码的前提下优化这个场景,你会从哪些方向入手?(提示:考虑业务层缓存、数据结构分片、或者调整操作系统内存策略)
欢迎在评论区留下你的方案 ------ 下一篇我会聊聊 "伪共享(False Sharing):为什么你的多线程程序性能倒退了 10 倍?"