一、为什么是"全景图 + 长镜头"
最近在使用 ChatGPT 的 Image2 做图时,我逐渐发现一个很有意思的方向:它真正强的,不是"画一张图",而是"表达一段视觉叙事"。
一开始我只是想生成一些普通配图,比如技术博客插图、流程示意图,但很快遇到几个问题:
- 画面容易"散",缺乏结构
- 多元素场景容易混乱
- 风格不稳定,难以复用
直到我开始尝试一个思路:把一张图,当作一段"电影长镜头"来设计。也就是我想做的不只是静态画面,而是构建一个连续的空间、流动的时间、可读的叙事。
于是,"全景图 + 长镜头"的表达方式就出来了。
二、Image2 的核心能力(本质理解)
在多次实验之后,我对 Image2 的能力有一个更清晰的判断:
2.1 它不是在"画图",而是在"构图"
传统理解:输入 prompt → 输出图像
但实际更像:输入语义结构 → 生成视觉组织
它会自动帮你完成:
- 空间分层(前景 / 中景 / 远景)
- 视觉引导(光线 / 道路 / 人物)
- 信息排布(重点区域 vs 背景)
2.2 它具备"时间表达能力"
这是很多人忽略的一点。
当我们输入写:
-
left to right progression
-
life journey
-
transformation over time
模型会尝试构建一种 "空间承载时间"的表达方式,也就是:
-
左边 = 过去
-
右边 = 未来
-
中间 = 过渡
这正是"全景长镜头"的核心。
2.3 它能理解"电影语言"
一些关键词非常关键:
-
cinematic
-
ultra-wide
-
panoramic
-
single-take
-
dolly shot
这些不是装饰词,而是在控制画面的"拍摄方式"。
三、提示词工程:从"写句子"到"搭结构"
这是整篇文章最核心的部分,很多人写 prompt 的方式是描述你想看到什么。但更有效的方式是:构建一个视觉结构。
3.1 一个通用 Prompt 结构
我总结了一套比较稳定的模板:
[视角] + [镜头语言] + [主体] + [环境] + [时间/叙事] + [风格] + [细节强化]3.2 拆解一个真实案例
我用的核心 prompt(简化版):
Cinematic ultra-wide panoramic single-take life journey,
a continuous scene flowing from left to right,
showing a person's life from birth to old age,
with seamless environmental transitions and lighting evolution
(1)镜头层
决定"怎么拍"
- Cinematic → 电影质感
- ultra-wide → 视野宽广
- panoramic → 全景
- single-take → 长镜头
(2)叙事层
决定"讲什么"
- life journey
- from birth to old age
- left to right
(3)结构层
决定"怎么连起来"
- continuous scene
- seamless transitions
(4)表现层
决定"氛围"
-
lighting evolution
-
atmosphere
在这里,Prompt 不只是一句话,而是一个"分层控制系统"
四、实战案例:人生全景长镜头
这是我实际做的一张图的思路(文字版拆解)。
4.1 初始问题
最开始的问题是画面割裂(像拼接),时间感不明显,重点不突出
4.2 结构重建
我不再写"内容",而是先设计结构:
左 → 右 = 时间轴
前 → 后 = 空间层次
光 → 影 = 情绪变化
4.3 引入"电影镜头语言"
加入:
-
single-take(连续镜头)
-
dolly shot(推进感)
-
environmental storytelling(环境叙事)
结果明显改善,画面开始"流动"起来
4.4 细节强化
最后才加入以下关键元素:
- 人物阶段(婴儿 / 青年 / 老年)
- 环境变化(房间 → 学校 → 城市 → 夕阳)
- 光影变化(清晨 → 正午 → 黄昏)
4.5 效果图
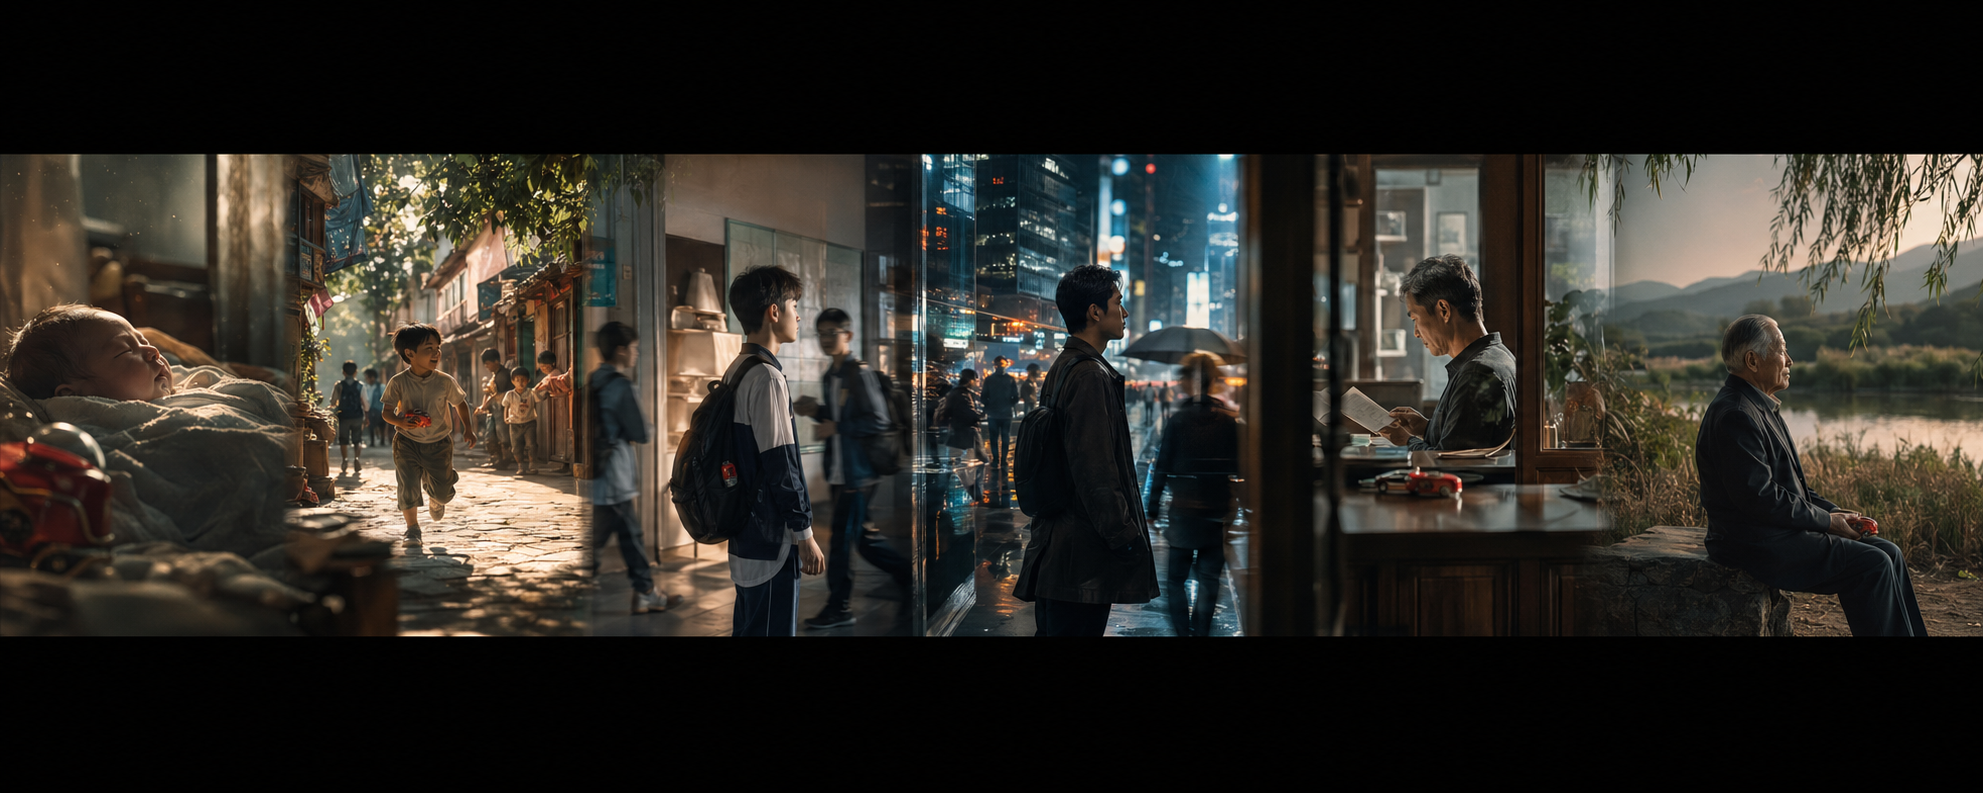
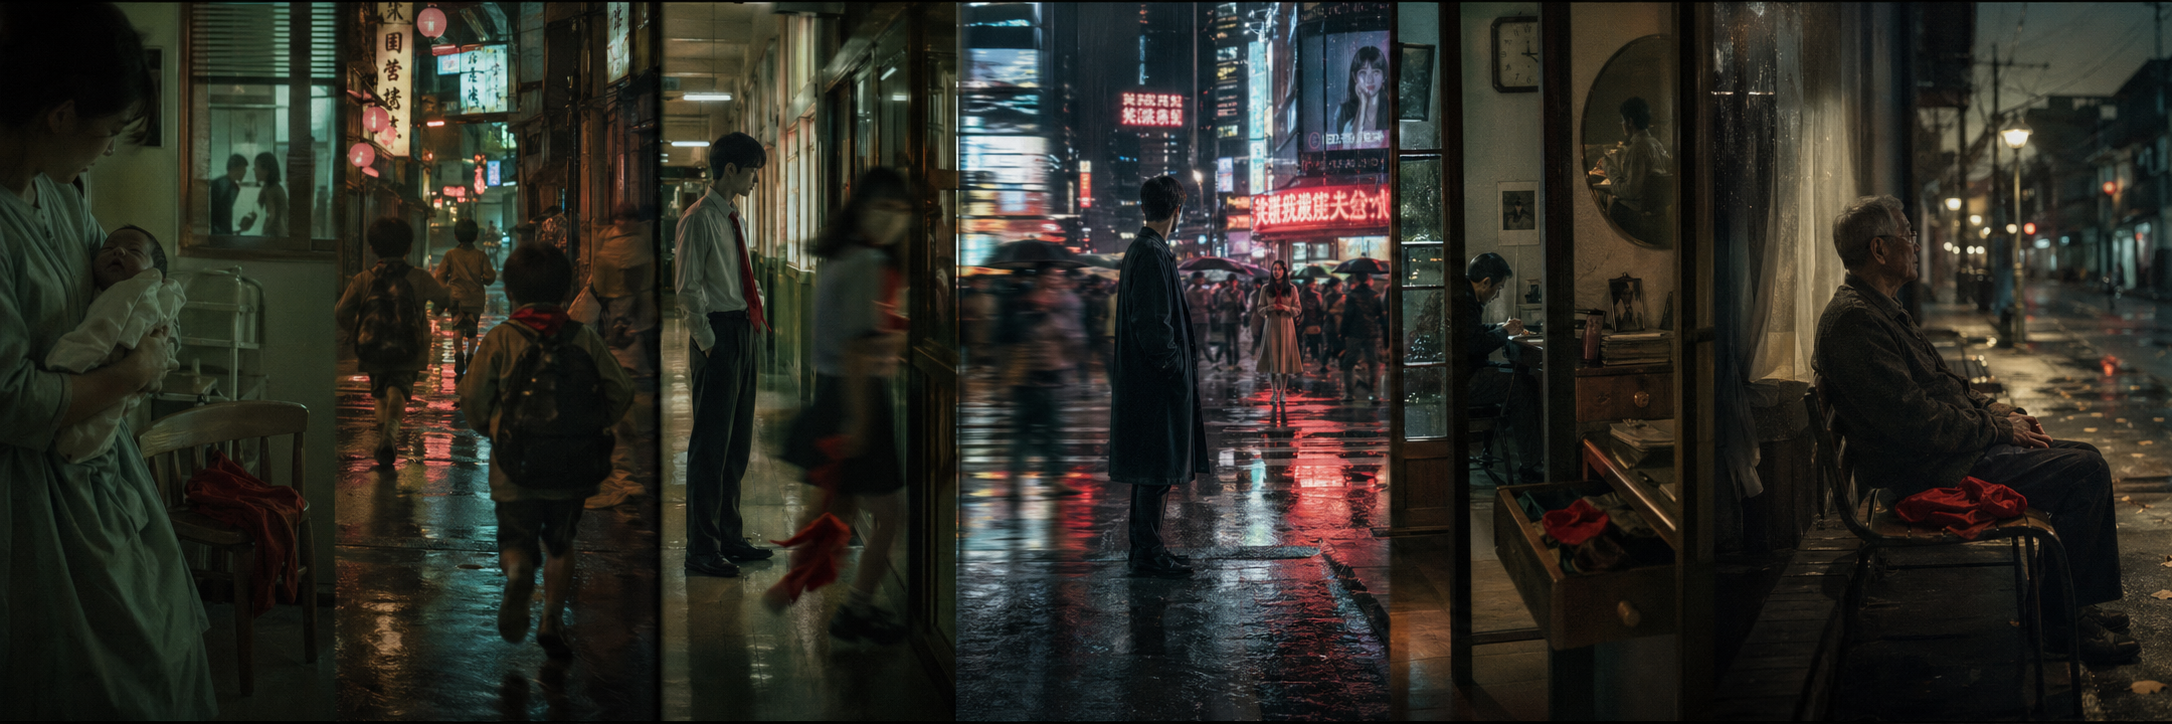
我们来看看最终的成果,以下是我在三个不同的创作阶段生成的图片。
(1) 阶段一:直接根据prompt生成
画面零碎,没有故事细节感。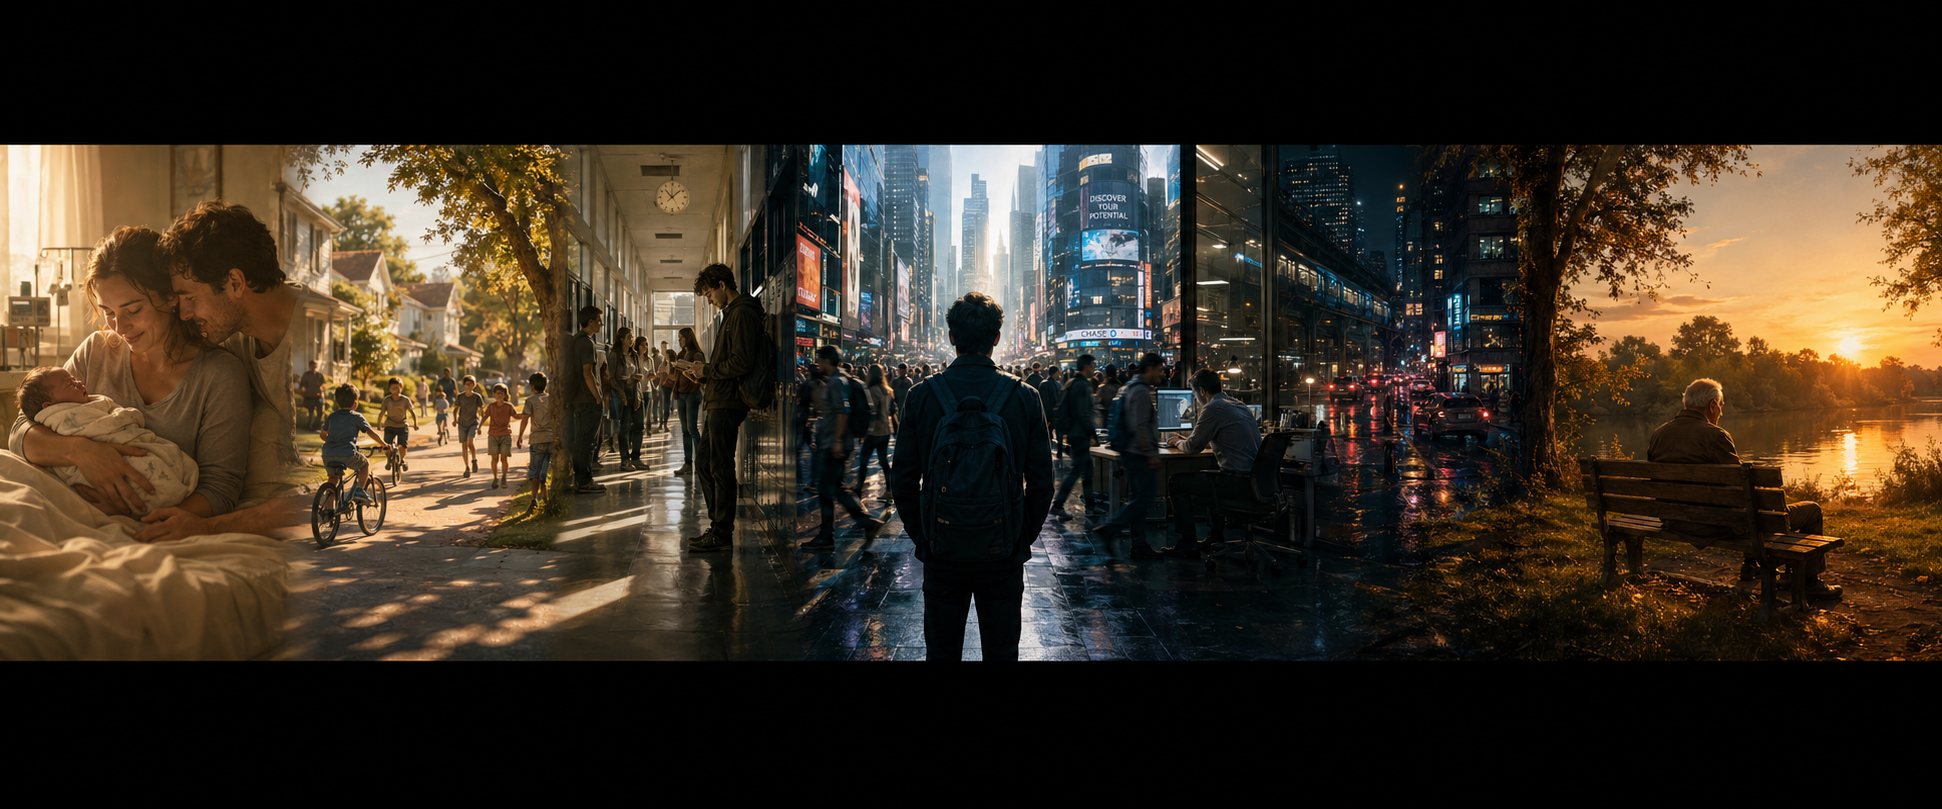
(2) 阶段二:加入镜头语言
画面细腻了一些,但是感觉没有特色。
(3) 阶段三:加入特定风格设定
例如这里,我参考了王家卫的风格,阴湿感中透露出莫名的压抑的那种风格。
五、常见失败模式(很真实)
这部分非常关键,我踩过不少坑:
5.1 信息堆砌
beautiful, detailed, ultra realistic, 8k, masterpiece...👉 结果:没有重点
5.2 抽象描述过多
a meaningful life, emotional journey...👉 结果:模型"乱猜"
5.3 风格冲突
realistic + anime + watercolor👉 结果:画面崩坏
六、一套可复用工作流
我现在基本固定用这套流程:
6.1 定义表达目标
不是"画什么",而是想表达什么信息 / 情绪
6.2 搭结构
选择一种空间结构(层次)、时间结构(流动)
6.3 加入镜头语言
例如:
- cinematic
- wide shot
- macro
- aerial
6.4 控制风格
统一写实 / 插画 / 游戏风
6.5 多轮迭代
重点不是一次成功,而是逐步收敛
七、总结
这次用 Image2 做全景图,我最大的收获不是学会了写 prompt,而是理解了:如何用一张图表达"时间 + 空间 + 情绪"。
当你开始用结构思维、镜头语言、叙事方式,去写 prompt 时,你会发现生成的就不再是"图片",而是"画面"。
如果你也在做类似的图(全景、故事、流程可视化),建议你试试先设计结构,再写提示词,效果会完全不一样。