大模型 天生就有有记忆缺陷 。
就同HTTP请求一般,每次对大模型的请求,都是无状态的。
所以为了让大模型拥有记忆 ,就需要在每次请求里 面,携带上 他之前说过的话。从而模仿他的记忆,让他知道,自己是谁,为谁服务,服务什么,服务对象又有什么性格等等...
但是这就会遇到一个很严肃的问题。大模型的推理文本长度是有限 的。
也就是我们常说的上下文 。这就牵扯出 一个问题:
主流大模型的上下文长度也就1Mtoken左右。而国产大模型通常也就是256K左右。
这就意味着上下文长度是有限的 ,所以非常宝贵。
同时因为大模型的注意力机制的原因,上下文越长 ,推理的所需耗费 的几何倍上升 ,并且精度 也会越低 。
所以,记忆模块的设计,就至关重要!
为好奇的小伙伴,补充一下什么是注意力机制 :
他的核心就是自注意力机制 (Transformer),不再像RNN那样串行处理,而是一次性看待整段输入(可以并行处理)。
做法就是,对每个token 生成Q 、K 、V 三个向量,计算出所有token的Q 与K 的相似度得分 ,拿着这个相似度去和V做一个加权求和 。从而能让token和语境关联。
就相当于把苹果手机中的,苹果从原本的向量区间,拉到手机品牌向量区间那样。
一、记忆模块设计
在开始搭建记忆模块之初 ,最先做的并不应该是RAG!
而是在domain协议层,定下契约 。之后不论是写入、召回都会按照固定的格式进行。
通常记忆模块 会分四层 。
感知记忆 (当前的输入)、短期记忆 (上下文的压缩)、长期记忆 (沉淀后的记忆)、结构化记忆(存储的用户的习惯、爱好、目标等)。
而我在设计中,
我对所有的 memory 记忆类型 分为三种:
- 结构化type。
- 长期记忆。
- 上下文压缩后的摘要,服务与上下文恢复。
同时,为了保护用户隐私,我又分了三层。
- self:用户个人隐私,像习惯、爱好、自己的上下文等。
- org:组织级别的,拥有对应权限的人可以共享。
- platform:平台运维级别的。
虽然有些功能,暂时不需要实现,但是协议是非常有必要提前定义好的。
二、记忆治理
第一部分,已经定义好类型 与权限 了。
但在入库前,更重要的就是定入库的规则。
我这里分为了两层:
- 软规则:写进 prompt ,让 LLM 按照给定的规则去"理解和生成"。
- 硬规则:负责最终"裁决和落库",像权限的过滤,字段的合法性校验等,尽可能的规避LLM生成的错误。
其中,软规则中的prompt更多是在告诉LLM。
- 什么样的内容算高价值
- 什么东西不能记
- Fact、Document、摘要等等,给出来的东西应该是什么类型
- 生成的是json格式
- 等等...
硬规则 ,就是对生成的东西进行一次强校验。
就像权限范围 、TTL 等,都是需要自软规则 里面抽取出来,经过 一遍硬规则 的手。
确保一切没有问题。在入库。
我举个简单的例子:
比如用户说:
"以后请你回答时更简洁一点。我最近 30 天目标是刷 200 道题。"
LLM 可能提两个候选:
json
[
  {
    "type": "fact",
    "namespace": "user_preference",
    "key": "answer_style",
    "value": {"style": "concise"},
    "source_kind": "explicit_user_statement",
    "scope_hint": "self",
    "confidence": 0.95
  },
  {
	 "type": "fact",
	 "namespace": "oj_goal",
	 "key": "current_goal",
	 "value": {"goal": "200 problems in 30 days"},
	 "source_kind": "explicit_user_statement",
	 "scope_hint": "self",
	 "confidence": 0.91,
	 "ttl_hint": {
	   "mode": "duration",
	   "days": 30,
	   "reason": "用户明确说最近 30 天目标"
	  }
]- 先判断一下致信度,太低的话直接skip掉。
- 然后根据LLM生成的,开始配置一下权限,在过滤一遍TTL等,最后入库。
三、上下文压缩,以及上下文恢复
现在定义了如何记忆类型、以及允许什么样的内容入库。
但是另一个影响对话质量的就是上下文的质量。
也就是说:
下一轮对话到来时,如何在有限的 token 预算里,把真正有价值的上下文重新恢复给模型。
技术上,我了解最粗暴的方式,就是滑动窗口 ,自动将越界的删除掉。
其次就是摘要压缩 ,对越界的内容进行压缩后,在携带。但是这样会导致精度问题。
后来就有了层次压缩 ,如:最近10轮的压缩,10~50轮的轻度压缩,更后方的重度压缩。
但是这会导致一些重要信息,被裁剪忽略掉。
所以后来又出现了重要性过滤。不在一味的按先后顺序。等等...
所以我这里做的是分层恢复 策略。
我会将上下文分为好几层进行控制:
第一层放:最新的决策和最近确认过的重要结论,优先级放到最高。
第二层放:当前还没有闭环的问题、待确定的问题。
第三层放:会话级别摘要,用来恢复长对话主线,而不是历史回放。
第四层放:已经沉淀出来的用户偏好、阶段目标、画像信息等。
第五层放:一下RAG召回的经验等。
第六层放:最近的几轮的对话内容。
其中,我把用户最近一次的问题,放到了最后。
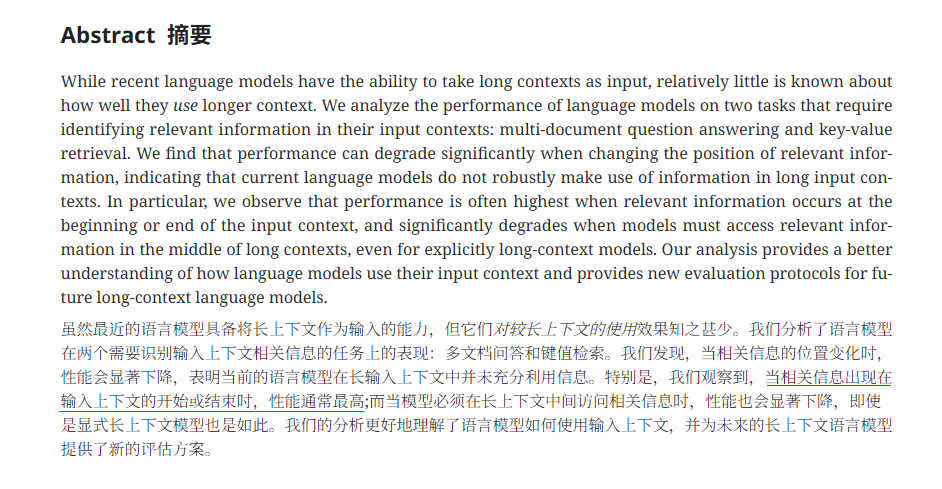
因为我之前在读arXiv的一篇论文(读 "archive"),参考他上面的内容:
模型对长上下文的中间信息利用很不稳定,相关信息放到开头或结尾表现会更好。
有兴趣的可以瞅瞅:
四、RAG 切分入库
之前已经把协议、提示词、上下文的组成搞定。
但在,我规定的上下文组成的第五层中,是需要RAG召回的,这也就意味着,需要先切分入库。
切分入库的质量越高,召回的质量就越高。
最简单的切分方式就是固定大小 切分,但是这样很死板,上下文语义会很不完整。
所以就有了语义切分 ,按照标点符号进行切分。
但有时,先表格、函数代码这些特殊情况,是无法进行语义切分 的,所以就需要对这些专项内容切分 。
其实还有成本更高的父子切分,就是你检索到子片的时候,会把与他相连的上下文一起带回。
而我的本项目,需求不高,所以做的是语义切分,
- 首先按段落切分
- 如果越界了在按照符号切分。
并且会保留相邻chunk的150个字符,用来维持语义。
最后在入qdrant与mysql的时。
我是以mysql作为真相数据源存document与元数据。
在 qdrant 里面存的是向量 、权限范围 用于筛选、和对应mysql的数据索引,用于去数据库中检索。
我在我的代码中也考虑过专项内容切分,考虑到了表格、代码,但是暂时还没有引入语法解析工具这种更高精度的切分。
五、混合召回策略
在上下文压缩的时候,我已经把需要召回的内容,表述的很明白。
但是那个时候为了表述清楚 ,内部的组成结构,所以我说的还是比较直白 和死板。
通常我会先判断一下两个数组:
最近决策 :只有 key_points 不会空才加载。(这个是对话中的要点)
待完成内容 :只有 open_loops 不为空才加载,他的存在可以让上下文的连续性更丝滑。
对话压缩后的摘要 :长对话必备!
Fact格式化内容 :这个达到阈值才能被加载,比如用户性格爱好,最近有啥目标 等用户画像 。
RAG检索 :若检索出来了,需执行度高于阈值,且top前5。
最后就是一些tools信息,与用户最近一次的问题了。
六、我想说的话
本次整体是我自己手写搭建的。
目的就是为了深入理解记忆机制的底层原理 。
但是如果要在生产级别项目中,为了追求快速开发。
可以复用像 mem0,这种记忆框架。