本博客深度整合磁盘物理结构、CHS/LBA寻址、磁盘逻辑抽象(一维/二维/三维数组)、inode原理、Ext块组架构、路径解析、挂载机制及软硬链接核心知识,配合命令演示、C代码示例、对比表格与大量示意图,真正做到"知其所以然"。适合Linux后端、运维、嵌入式、内核入门者,也可直接作为面试复习纲要。
前言
在 Linux 世界里,一切皆文件 。
支撑"文件"正常工作的底层基石,就是 Ext 系列文件系统。绝大多数 Linux 发行版(Ubuntu、CentOS、Debian)默认使用 Ext4,它的前身是 Ext2、Ext3。
很多同学只会用 ls/cd/mkdir,却不懂:
- 磁盘到底怎么存数据?
- CHS 和 LBA 是什么关系?磁盘如何从三维变成一维数组?
- inode 是什么?为什么删除文件还要看链接数?
- 目录到底是不是文件?
- 软链接和硬链接本质区别是什么?
- 挂载到底在做什么?
- 为什么有时候磁盘没满,却提示无法创建文件?
这篇文章一次性把所有原理讲透。
一、磁盘物理结构:存储的最底层真相
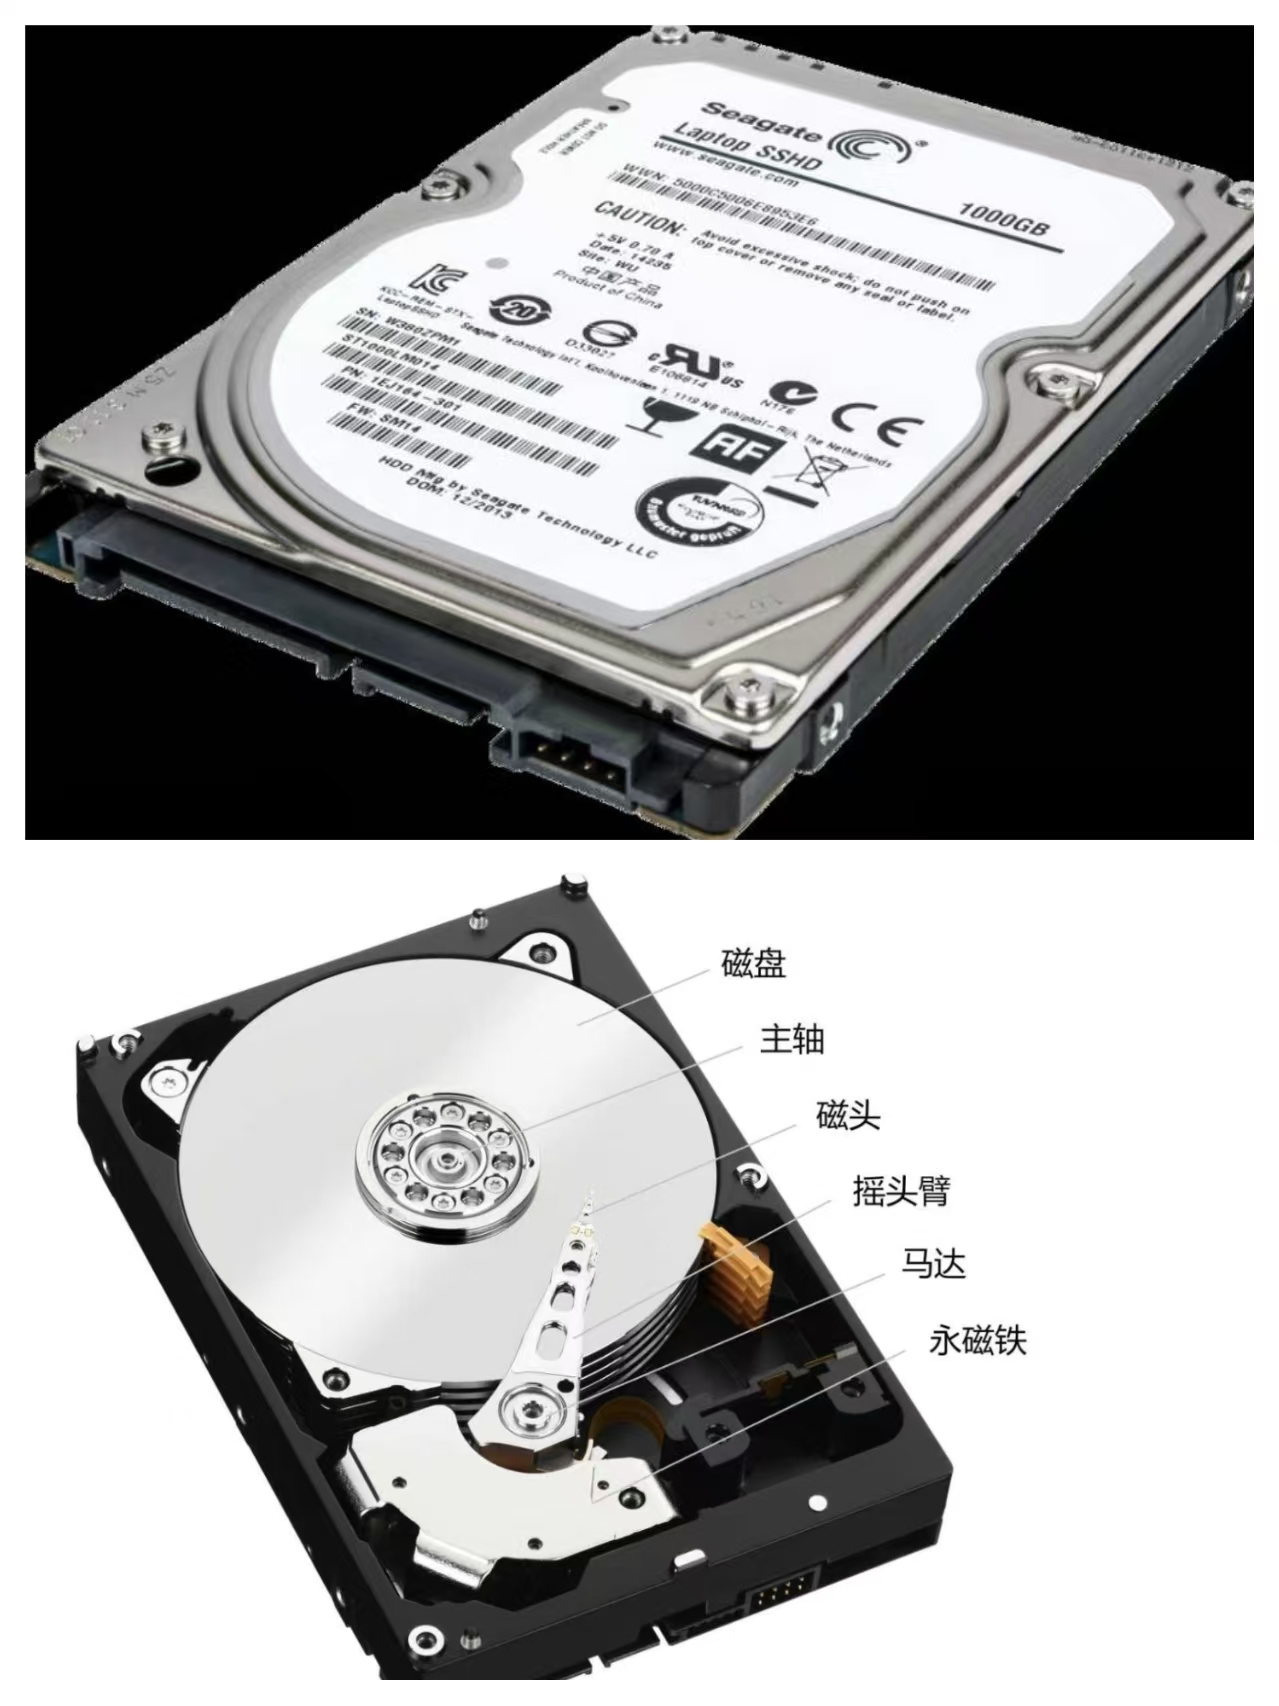
机械硬盘是计算机中唯一的机械设备,相比内存虽然慢,但容量大、价格便宜。
1.1 核心部件
- 盘片(Platter):涂有磁性材料,双面均可存储数据。
- 主轴(Spindle):带动盘片高速旋转。
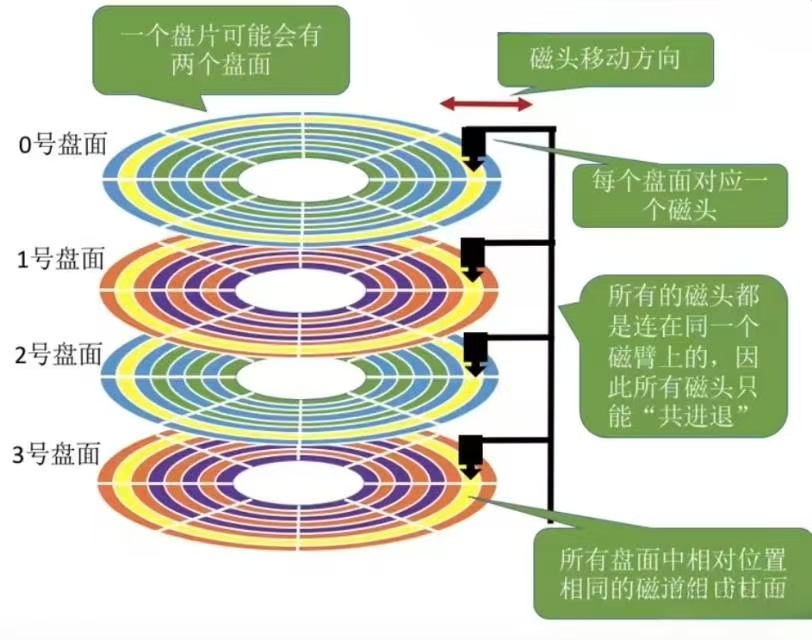
- 磁头(Head) :每个盘面配一个磁头,负责读写。所有磁头共进退。
- 磁臂(Actuator Arm):驱动所有磁头同步移动。
- 音圈电机:精准控制磁臂定位。
1.2 磁盘的存储结构:扇区、磁道、柱面
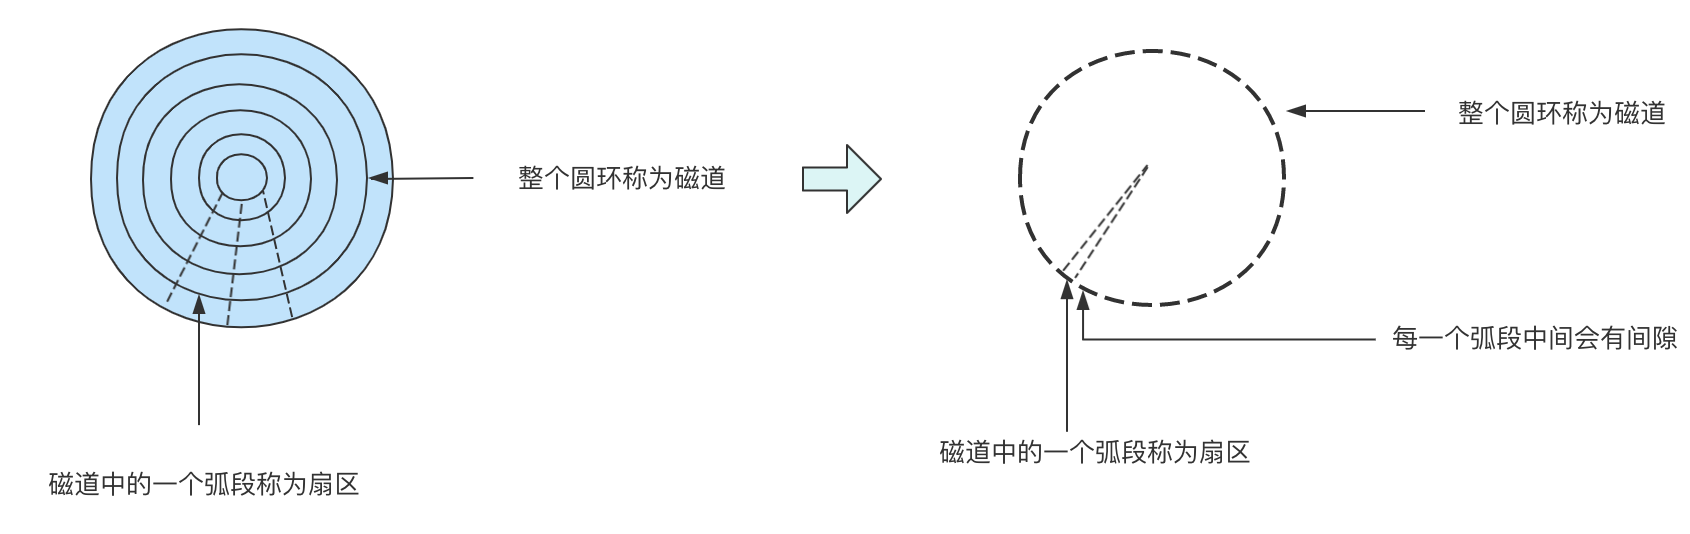
每个盘面被划分为一个个同心圆环,称为磁道(Track) 。磁道再被等分为扇区(Sector)。
- 扇区 :磁盘读写的最小物理单元,固定 512 字节。
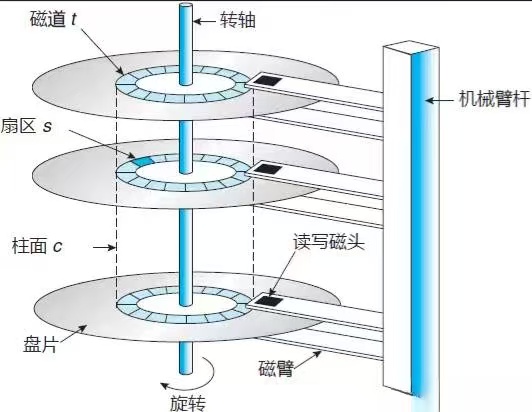
- 磁道 :某一盘面上的同心圆,所有盘面上相同半径的磁道在逻辑上构成一个柱面(Cylinder)。
- 柱面:分区的最小单位。
单个盘片的磁道扇区视图:
多个盘片组成的柱面视图:
1.3 如何定位一个扇区?------ CHS 寻址
早期采用三维坐标定位扇区:
- C(Cylinder,柱面):先找哪一个柱面
- H(Head,磁头):再确定柱面内哪一个磁头(即哪一个盘面/磁道)
- S(Sector,扇区) :最后定位该磁道上的第几个扇区(注意:扇区号从 1 开始)
CHS 寻址的上限约为 8.4GB(1024柱面 × 256磁头 × 63扇区 × 512字节)。
二、磁盘的逻辑结构:从三维到一维的抽象(重点)
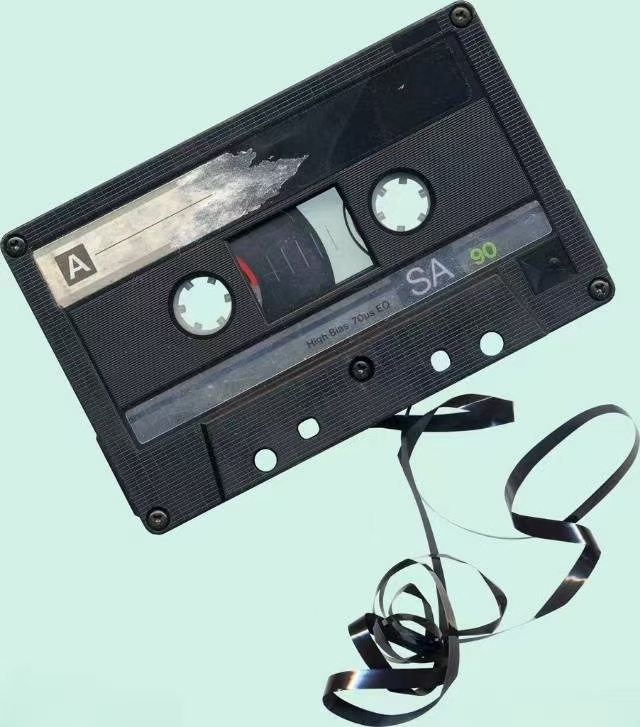
2.1 理解思路:像磁带一样拉直
磁带可以存储数据,把磁带"拉直"就形成线性结构。磁盘虽然是硬质的,但逻辑上可以想象成卷在一起的磁带 ,拉直后,每个扇区就有了一个线性下标,这就是 LBA(Logical Block Address) 的由来。
2.2 真实过程:从三维数组到一维 LBA
磁盘的真实物理结构可以这样逐层理解:
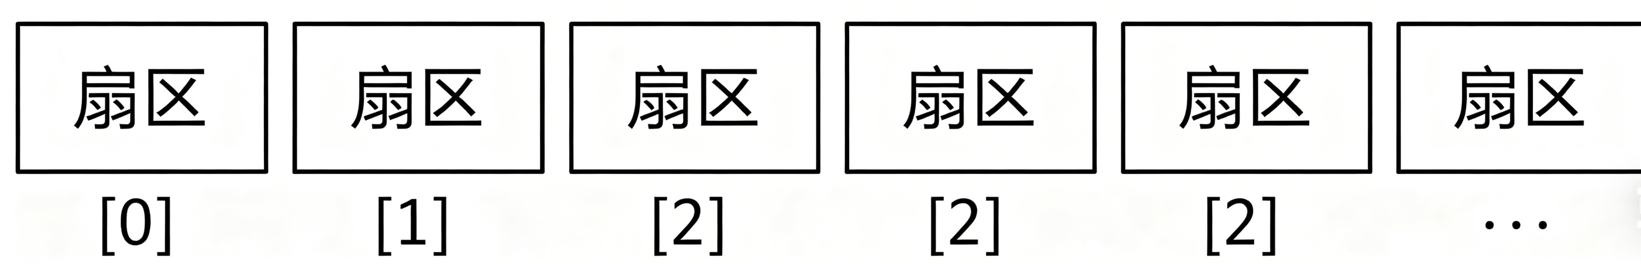
① 磁道 → 一维数组
某一盘面的某一个磁道展开,就是一条扇区序列,就像一个一维数组,每个元素是一个 512 字节的扇区。
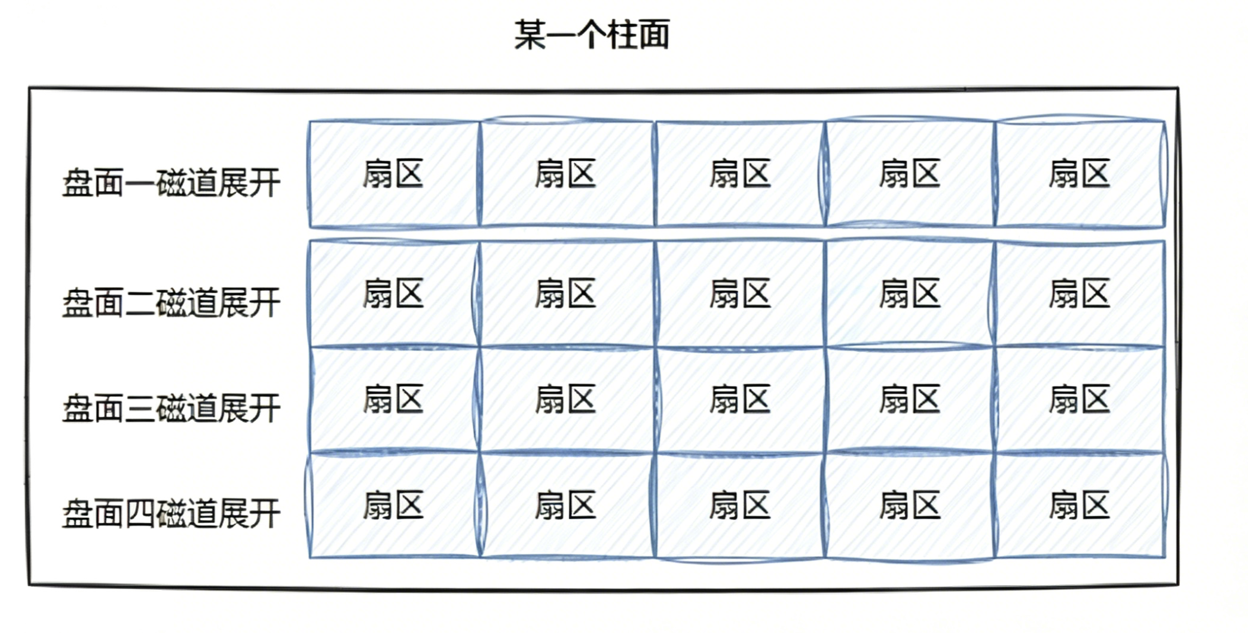
② 柱面 → 二维数组
由于磁头共进退,所有盘面上相同半径的磁道构成一个柱面。柱面上的每个磁道扇区个数相同,所以一个柱面展开后就是一张二维的扇区数组表(行 = 磁头/盘面,列 = 扇区)。
③ 整盘 → 三维数组(多个二维数组)
整个磁盘就是多个柱面(柱面0、柱面1、柱面2...)叠加,即多张二维扇区数组表,形成一个三维数组。
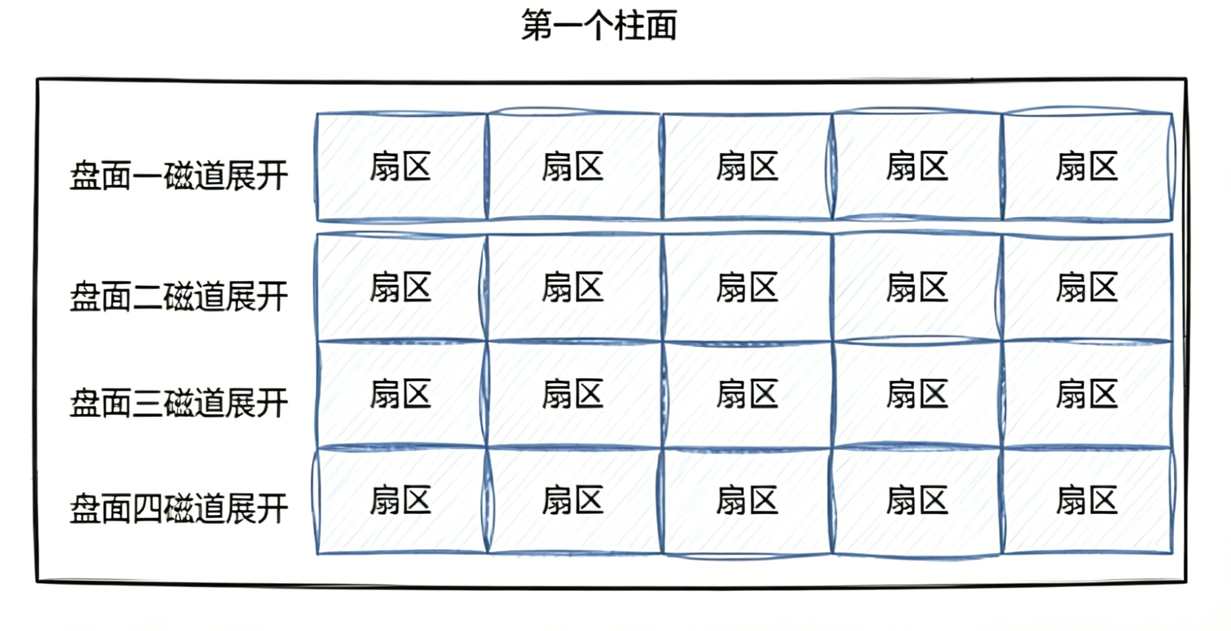
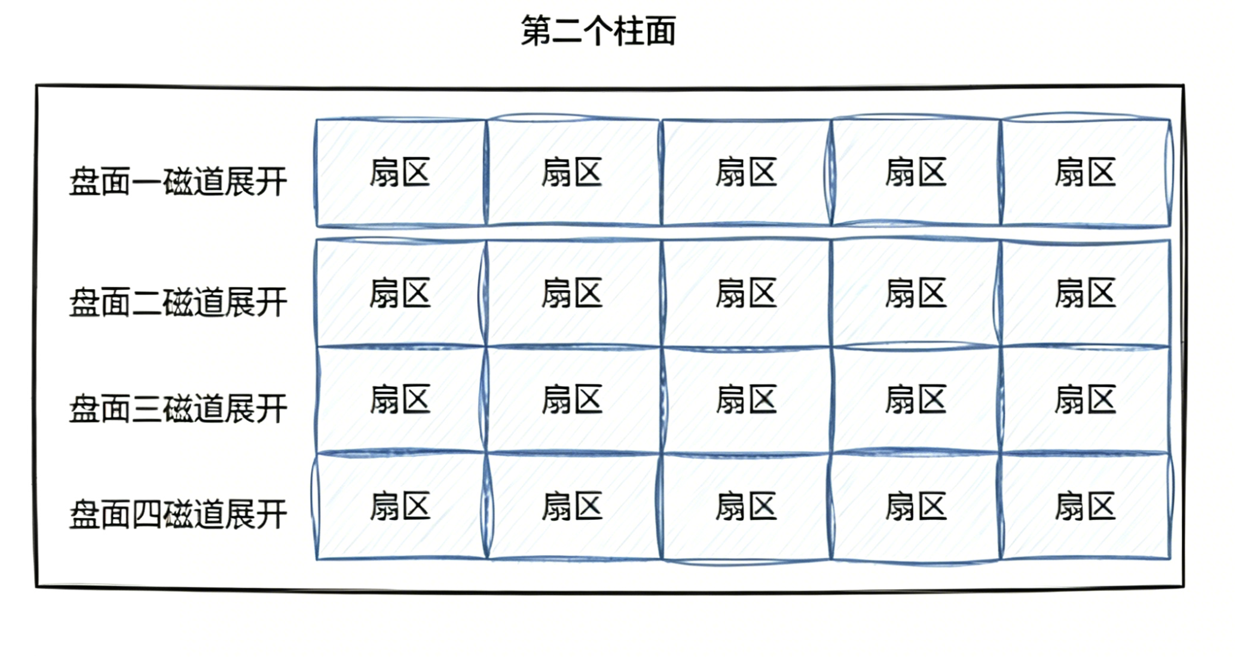
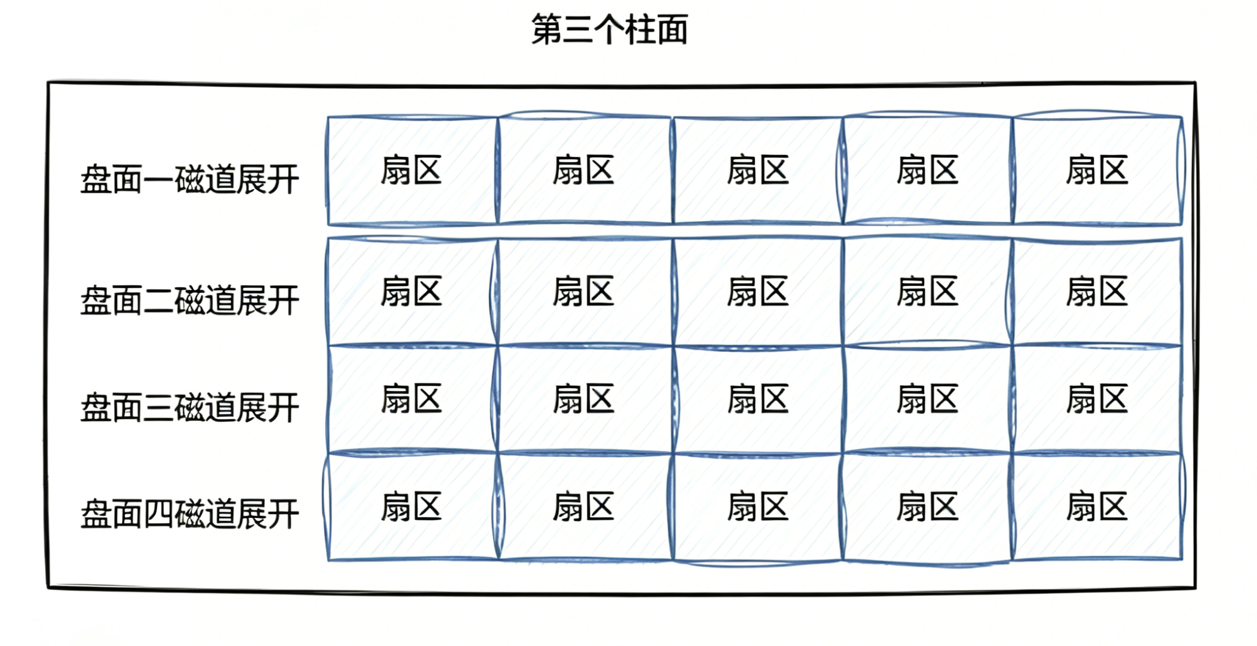
第 n 个 柱 面...
④ 最终抽象 → 一维 LBA 数组
学过 C/C++ 数组就会知道,三维数组在内存中本质上仍是一维的。同理,磁盘最终被抽象为一个以扇区为元素的一维数组 ,每个扇区有一个唯一的下标,即 LBA 地址 。
图示:
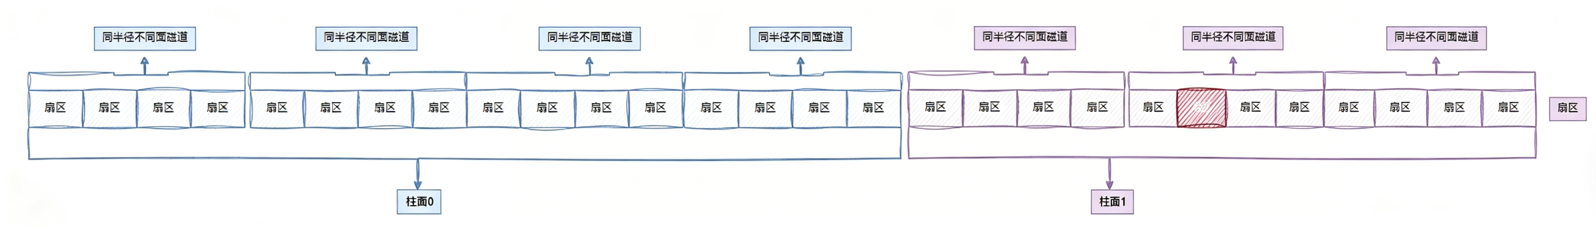
核心结论:从此往后,操作系统只认 LBA,磁盘的固件负责将 LBA 自动转换为 CHS 去定位物理扇区。
2.3 LBA ↔ CHS 转换公式
python
# CHS → LBA(扇区号 S 从 1 开始,LBA 从 0 开始)
LBA = C × (磁头数 × 每磁道扇区数) + H × 每磁道扇区数 + S - 1

# LBA → CHS
C = LBA // (磁头数 × 每磁道扇区数)
H = (LBA % (磁头数 × 每磁道扇区数)) // 每磁道扇区数
S = (LBA % 每磁道扇区数) + 1
✅ 重点:磁头数 × 每磁道扇区数 = 单个柱面的扇区总数,这是换算中的关键中间量。
三、从物理到逻辑:块、分区与文件系统
3.1 块(Block):文件系统的最小读写单位
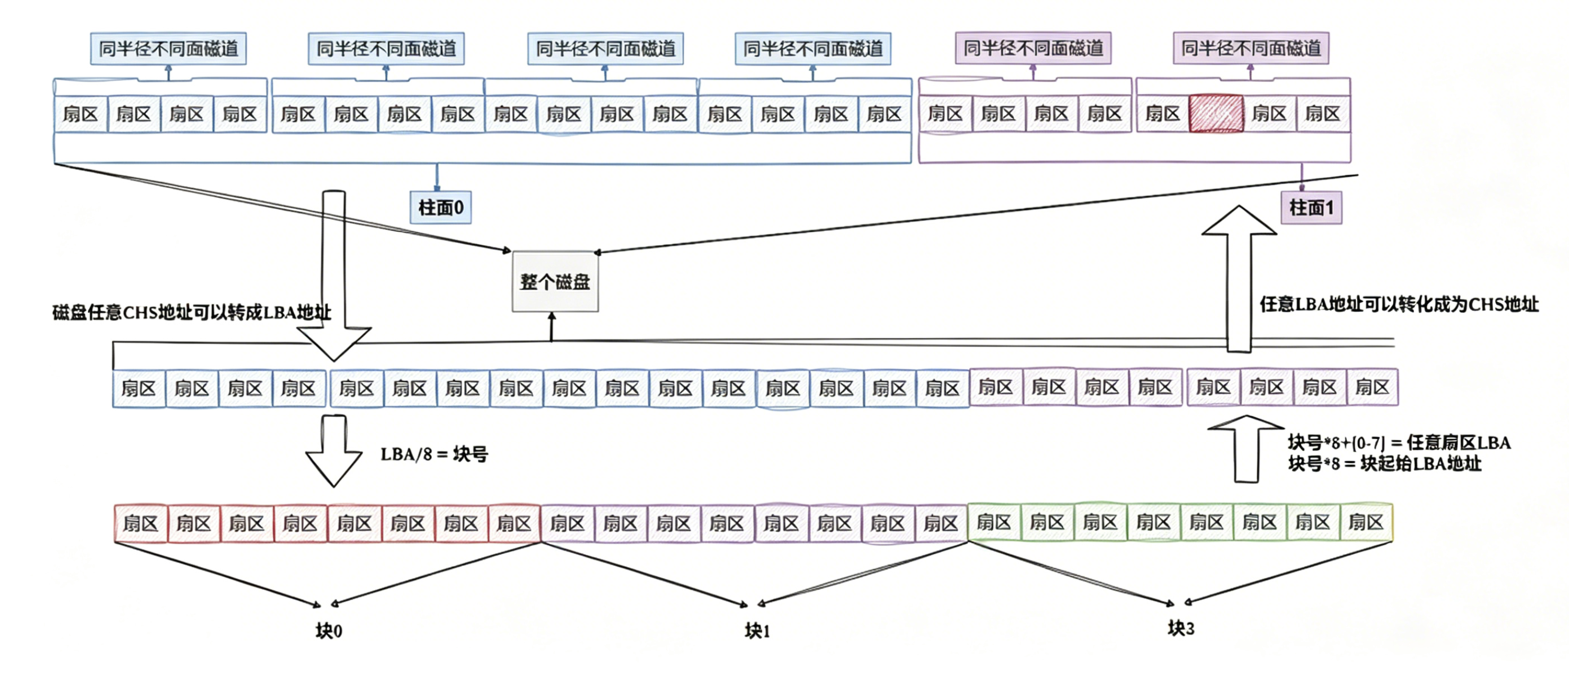
逐个扇区读写效率太低,操作系统一次读写多个连续扇区,这个逻辑单位称为块(Block)。
- 常见大小:4KB(= 8 个扇区)
- 格式化时确定,不可更改
- 文件存取、空间分配均以块为单位
python
# 块号与 LBA 的简单换算(以 4KB 块为例)
块号 = LBA // 8
LBA  = 块号 × 8 + 块内扇区偏移
3.2 分区(Partition)
磁盘可被划分为多个分区,柱面是分区的最小单位。分区本质上就是划定起始和结束柱面,每个区内的扇区分布就清晰了。
Linux 下磁盘设备文件示例:
/dev/sda:第一块 SCSI/SATA 磁盘/dev/sda1:第一块磁盘的第一个分区
图示:
3.3 格式化 = 创建文件系统
所谓"格式化",就是向分区写入管理数据,构建文件系统。后续所有文件的增删查改都在这个框架下进行。
四、inode:文件的真正灵魂(核心重点)
4.1 核心思想
Linux 文件 = 元信息(inode)+ 数据内容(data block)
属性和内容分离存储。文件名不属于 inode!
每个文件有且只有一个 inode,inode 大小固定(通常 128 字节 或 256 字节),任何文件的内容大小可以不同,但属性大小一定相同。
4.2 inode 里存了什么?
c
struct ext2_inode {
    __le16  i_mode;         // 文件类型和权限
    __le16  i_uid;          // 所有者用户ID
    __le32  i_size;         // 文件大小(字节)
    __le32  i_atime;        // 最后访问时间 (Access)
    __le32  i_ctime;        // 属性变更时间 (Change)
    __le32  i_mtime;        // 内容修改时间 (Modify)
    __le32  i_dtime;        // 删除时间
    __le16  i_gid;          // 组ID
    __le16  i_links_count;  // 硬链接计数 ★★★
    __le32  i_blocks;       // 文件占用的块数
    __le32  i_flags;        // 文件标志
    __le32  i_block[15];    // 数据块指针数组 ★★★
};
4.3 查看 inode 信息
bash
stat test.c      # 查看完整 inode 元信息
ls -li test.c    # 仅查看 inode 号
4.4 文件三个时间戳
| 时间 | 含义 | 触发条件 |
|---|---|---|
| Access(atime) | 最后访问时间 | 读文件、执行文件 |
| Modify(mtime) | 内容修改时间 | 写入文件内容 |
| Change(ctime) | 属性变更时间 | 权限、所有者变更,甚至 mtime 变化也会触发 |
五、多级索引:inode 如何一步步找到数据块
好的,我给你一个精简、带高亮、复制到CSDN直接能用的版本。
五、多级索引:inode 如何找到数据块
inode 里有个关键的数组叫 i_block[15],一共 15 个指针,分成两部分干活:
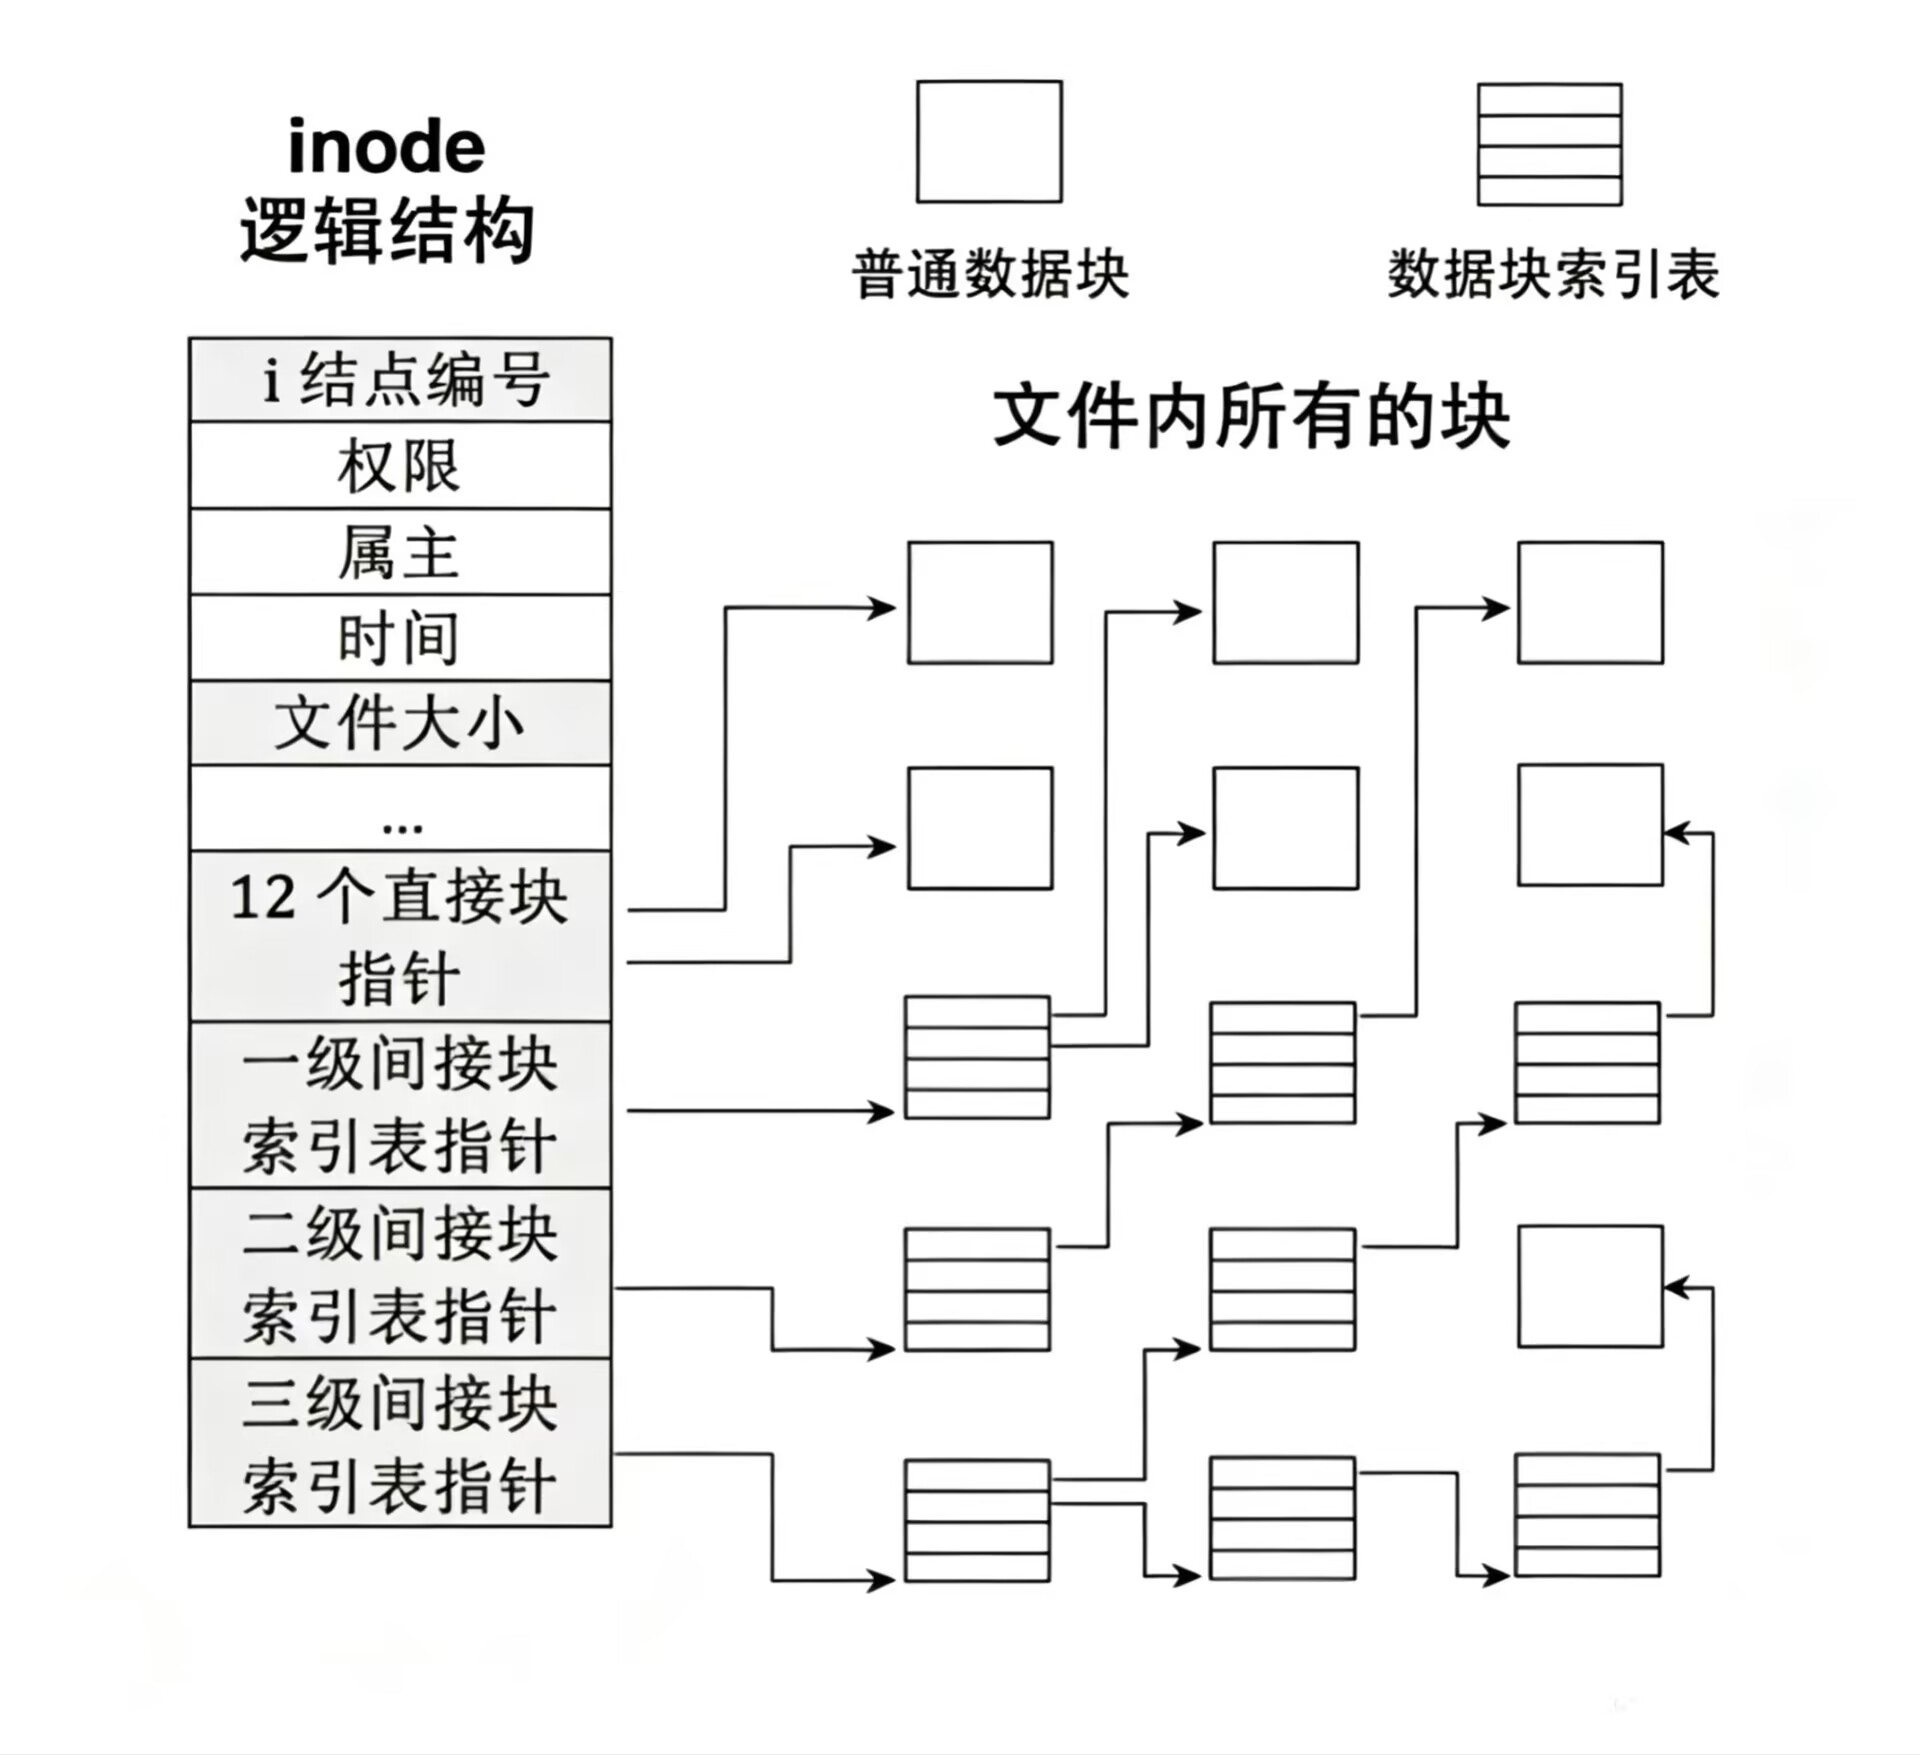
对照图片来看,就两条链路:
- 上面那条 :12 个直接指针,直连数据块,路径最短,速度最快。
- 下面那条 :3 个间接指针,一层层往下指,每一层都是装满指针的索引块,最终才指到数据块。
为什么要搞这么复杂?
一句话:小文件走捷径,大文件绕远路但能装得下。
大部分文件都不大,12 个直接块就够用,查找一次到位。偶尔遇到超大文件,再动用间接指针,牺牲一点速度,换来巨大容量。
能管多大?(以 4KB 块为例)
一个索引块能装 1024 个指针(4KB ÷ 4字节 = 1024),于是:
c
// 直接块:12个指针,一次到位
直接块   = 12 × 4KB            = 48KB

// 一级间接:1个索引块 → 1024个数据块
一级间接 = 1024 × 4KB          = 4MB

// 二级间接:套两层索引
二级间接 = 1024 × 1024 × 4KB   = 4GB

// 三级间接:套三层索引
三级间接 = 1024 × 1024 × 1024 × 4KB = 4TB
汇总如下:
| 指针类型 | 原理 | 最大容量 |
|---|---|---|
| 直接块 (12个) | 直连数据块 | 48 KB |
| 一级间接 | 1层索引表 | 4 MB |
| 二级间接 | 2层索引表 | 4 GB |
| 三级间接 | 3层索引表 | 4 TB |
六、Ext 文件系统架构:块组模型
6.1 整体布局
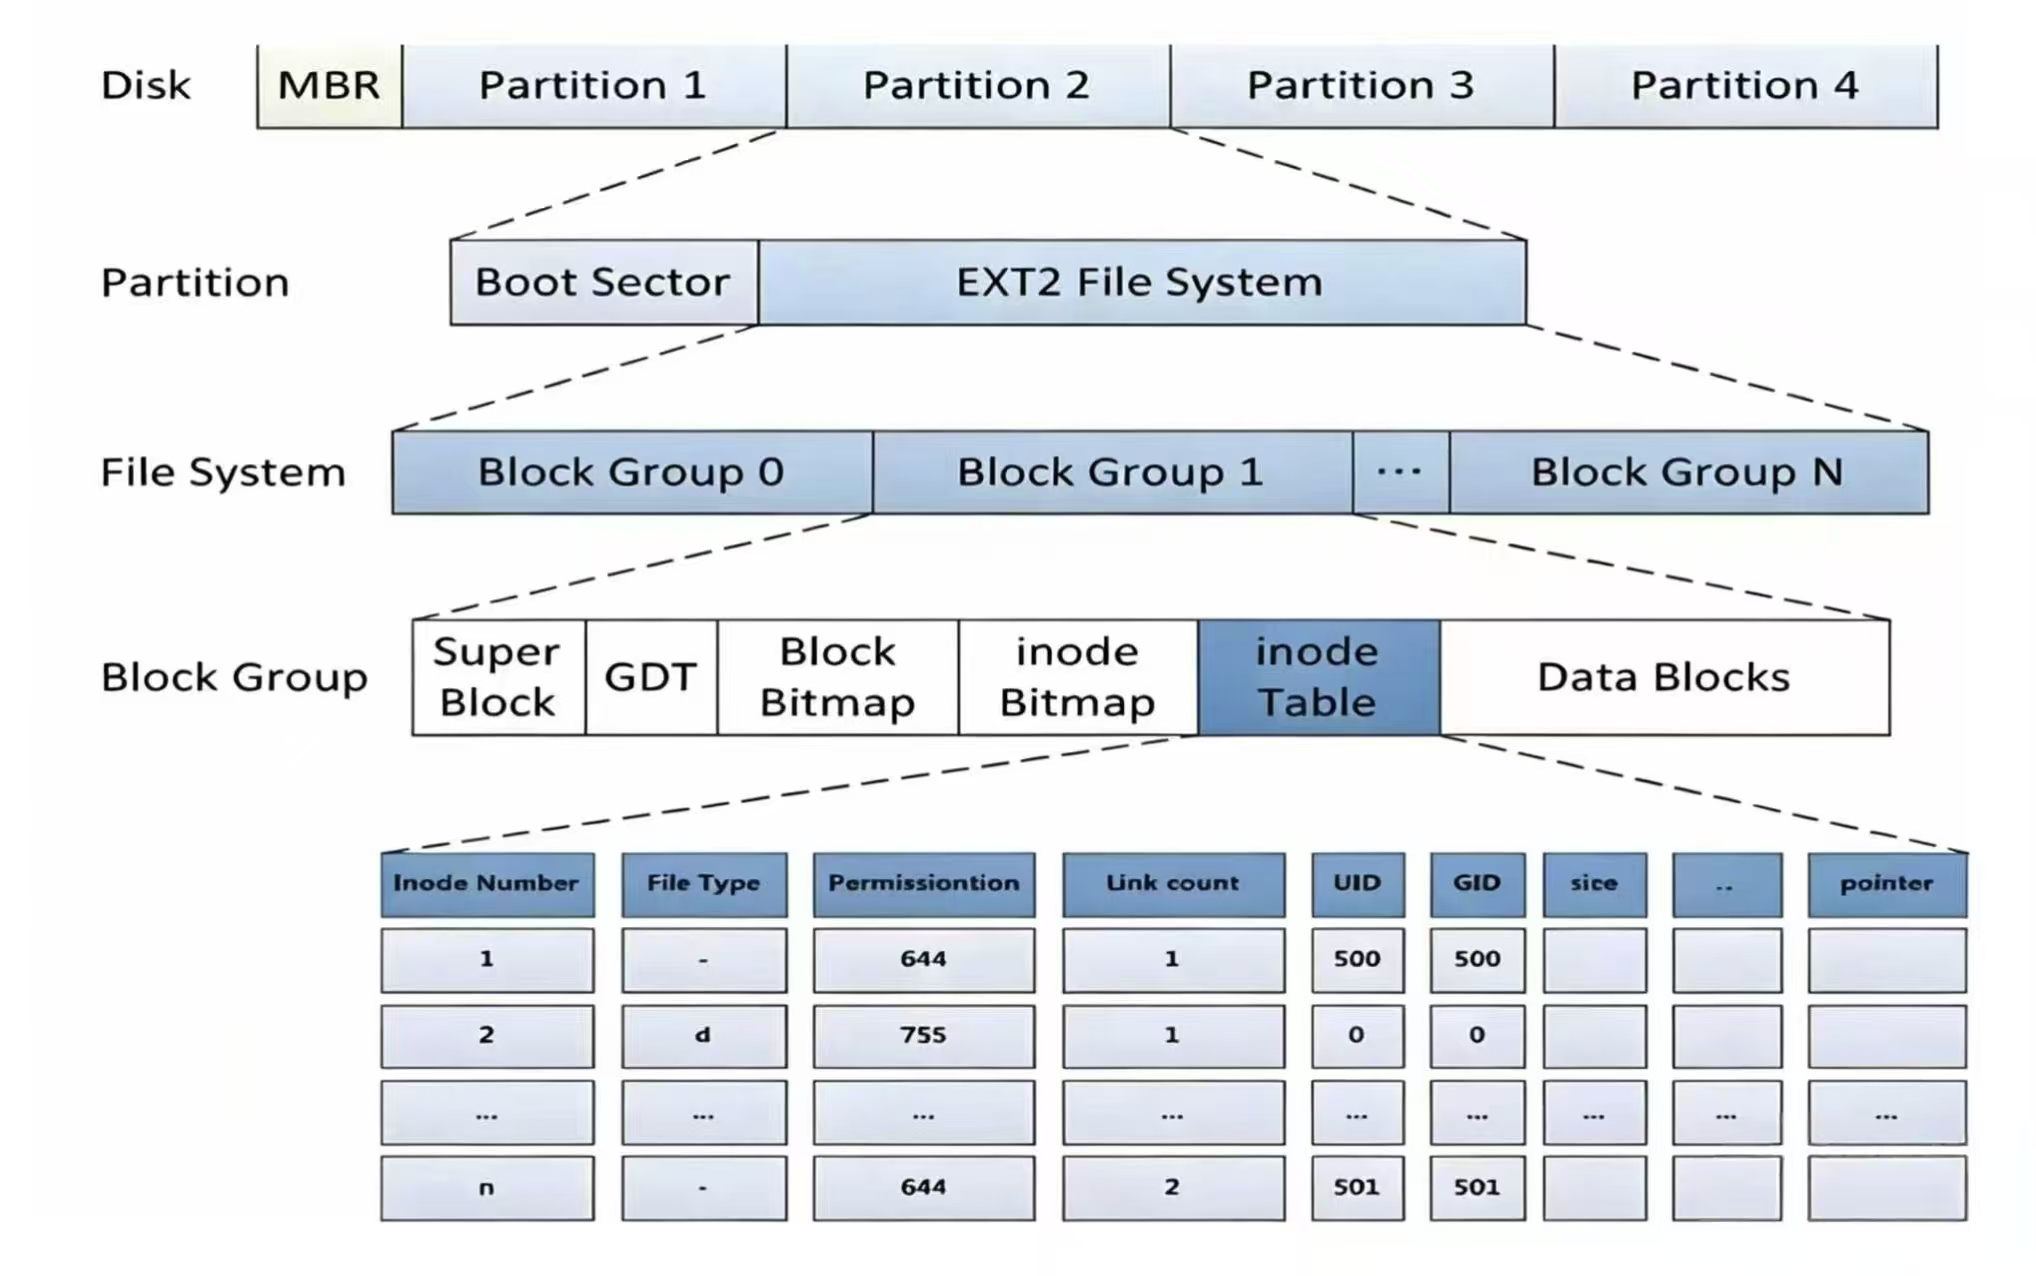
Ext2/3/4 将分区划分为多个等大小的块组(Block Group):
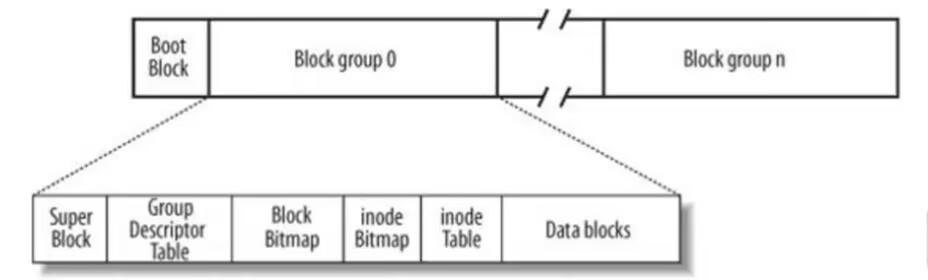
- Boot Block:固定 1KB,存放启动代码和分区表,文件系统不能修改。
6.2 单个块组的 6 大组成
每个块组的内部结构如下:
- 超级块(Super Block)
存放全局信息:块/inode 总量、大小、空闲量、挂载时间等。每个块组都有备份(第一个必须,后续可选),防止局部损坏。 - GDT(块组描述符表)
记录本组内位图、inode 表、数据块的起始位置及空闲计数。同样有备份。 - 块位图(Block Bitmap)
用位标记数据块占用情况(0空闲,1占用)。 - inode 位图(Inode Bitmap)
标记 inode 占用情况。 - inode 表(Inode Table)
该组所有 inode 的数组。 - 数据块(Data Blocks)
存放文件真实内容或目录内容。
⚠️ 注意:inode 编号和 block 号均以分区为单位,不可跨分区!
6.3 超级块代码片段
c
struct ext2_super_block {
    __le32  s_inodes_count;
    __le32  s_blocks_count;
    __le32  s_free_blocks_count;
    __le32  s_free_inodes_count;
    __le16  s_magic;             // 魔数 0xEF53
    // ... 更多字段
};
6.4 创建文件全过程(以 touch abc 为例)
当前目录下执行 touch abc,inode 号假设为 263466:
- 存储属性:找到一个空闲 inode(263466),写入文件类型、权限、时间戳等。
- 存储数据:(空文件暂不分配数据块)若有内容,找到空闲块写入。
- 记录分配:更新 inode 位图和块位图,在 inode 中记录块号列表。
- 添加目录项 :在当前目录的数据块中添加
(263466, "abc"),完成文件名与 inode 的绑定。
七、目录的本质:90% 的人理解错了
7.1 目录也是文件!
目录文件的数据块中存放的是"文件名 → inode号"的映射表。
磁盘上没有"目录"这个特殊概念,只有文件属性 + 文件内容。
7.2 C 代码验证
c
// readdir_demo.c
#include <stdio.h>
#include <string.h>
#include <stdlib.h>
#include <dirent.h>

int main(int argc, char *argv[]) {
    if (argc != 2) {
        fprintf(stderr, "Usage: %s <directory>\n", argv[0]);
        exit(EXIT_FAILURE);
    }

    DIR *dir = opendir(argv[1]);
    if (!dir) { perror("opendir"); exit(EXIT_FAILURE); }

    struct dirent *entry;
    while ((entry = readdir(dir)) != NULL) {
        if (strcmp(entry->d_name, ".") == 0 || strcmp(entry->d_name, "..") == 0)
            continue;
        printf("名称: %-20s inode号: %lu\n", entry->d_name, entry->d_ino);
    }

    closedir(dir);
    return 0;
}
bash
gcc readdir_demo.c -o readdir_demo
./readdir_demo /
ls -li /          # 对比 inode 号,完全一致
7.3 路径解析全过程
以访问 /home/user/test.c 为例:
- 从根目录
/开始(inode 号固定,通常为 2,开机即知)。 - 读根目录的数据块,找到
home对应的 inode。 - 跳转至
home的 inode,读其数据块,找到user的 inode。 - 进入
user目录,找到test.c的 inode,打开文件。
任何路径的解析都要从根目录逐级向下,路径的第一斜杠即根目录。
7.4 路径缓存(dentry)
每次都从根目录解析太慢。内核为每个打开的文件在内存中维护一个 dentry 结构,形成树形路径缓存。dentry 同时挂载在 LRU 链表 (用于淘汰)和哈希表(用于快速查找)中,极大加速重复访问。
c
struct dentry {
    atomic_t d_count;
    unsigned int d_flags;       /* protected by d_lock */
    spinlock_t d_lock;      /* per dentry lock */
    struct inode *d_inode;      /* Where the name belongs to - NULL is
                     * negative */
    /*
     * The next three fields are touched by __d_lookup.  Place them here
     * so they all fit in a cache line.
     */
    struct hlist_node d_hash;   /* lookup hash list */
    struct dentry *d_parent;    /* parent directory */
    struct qstr d_name;
    struct list_head d_lru;     /* LRU list */
    /*
     * d_child and d_rcu can share memory
     */
    union {
        struct list_head d_child;   /* child of parent list */
        struct rcu_head d_rcu;
    } d_u;
    struct list_head d_subdirs; /* our children */
    struct list_head d_alias;   /* inode alias list */
    unsigned long d_time;       /* used by d_revalidate */
    struct dentry_operations *d_op;
    struct super_block *d_sb;   /* The root of the dentry tree */
    void *d_fsdata;         /* fs-specific data */
#ifdef CONFIG_PROFILING
    struct dcookie_struct *d_cookie; /* cookie, if any */
#endif
int d_mounted;
unsigned char d_iname[DNAME_INLINE_LEN_MIN];
};
/* small names * 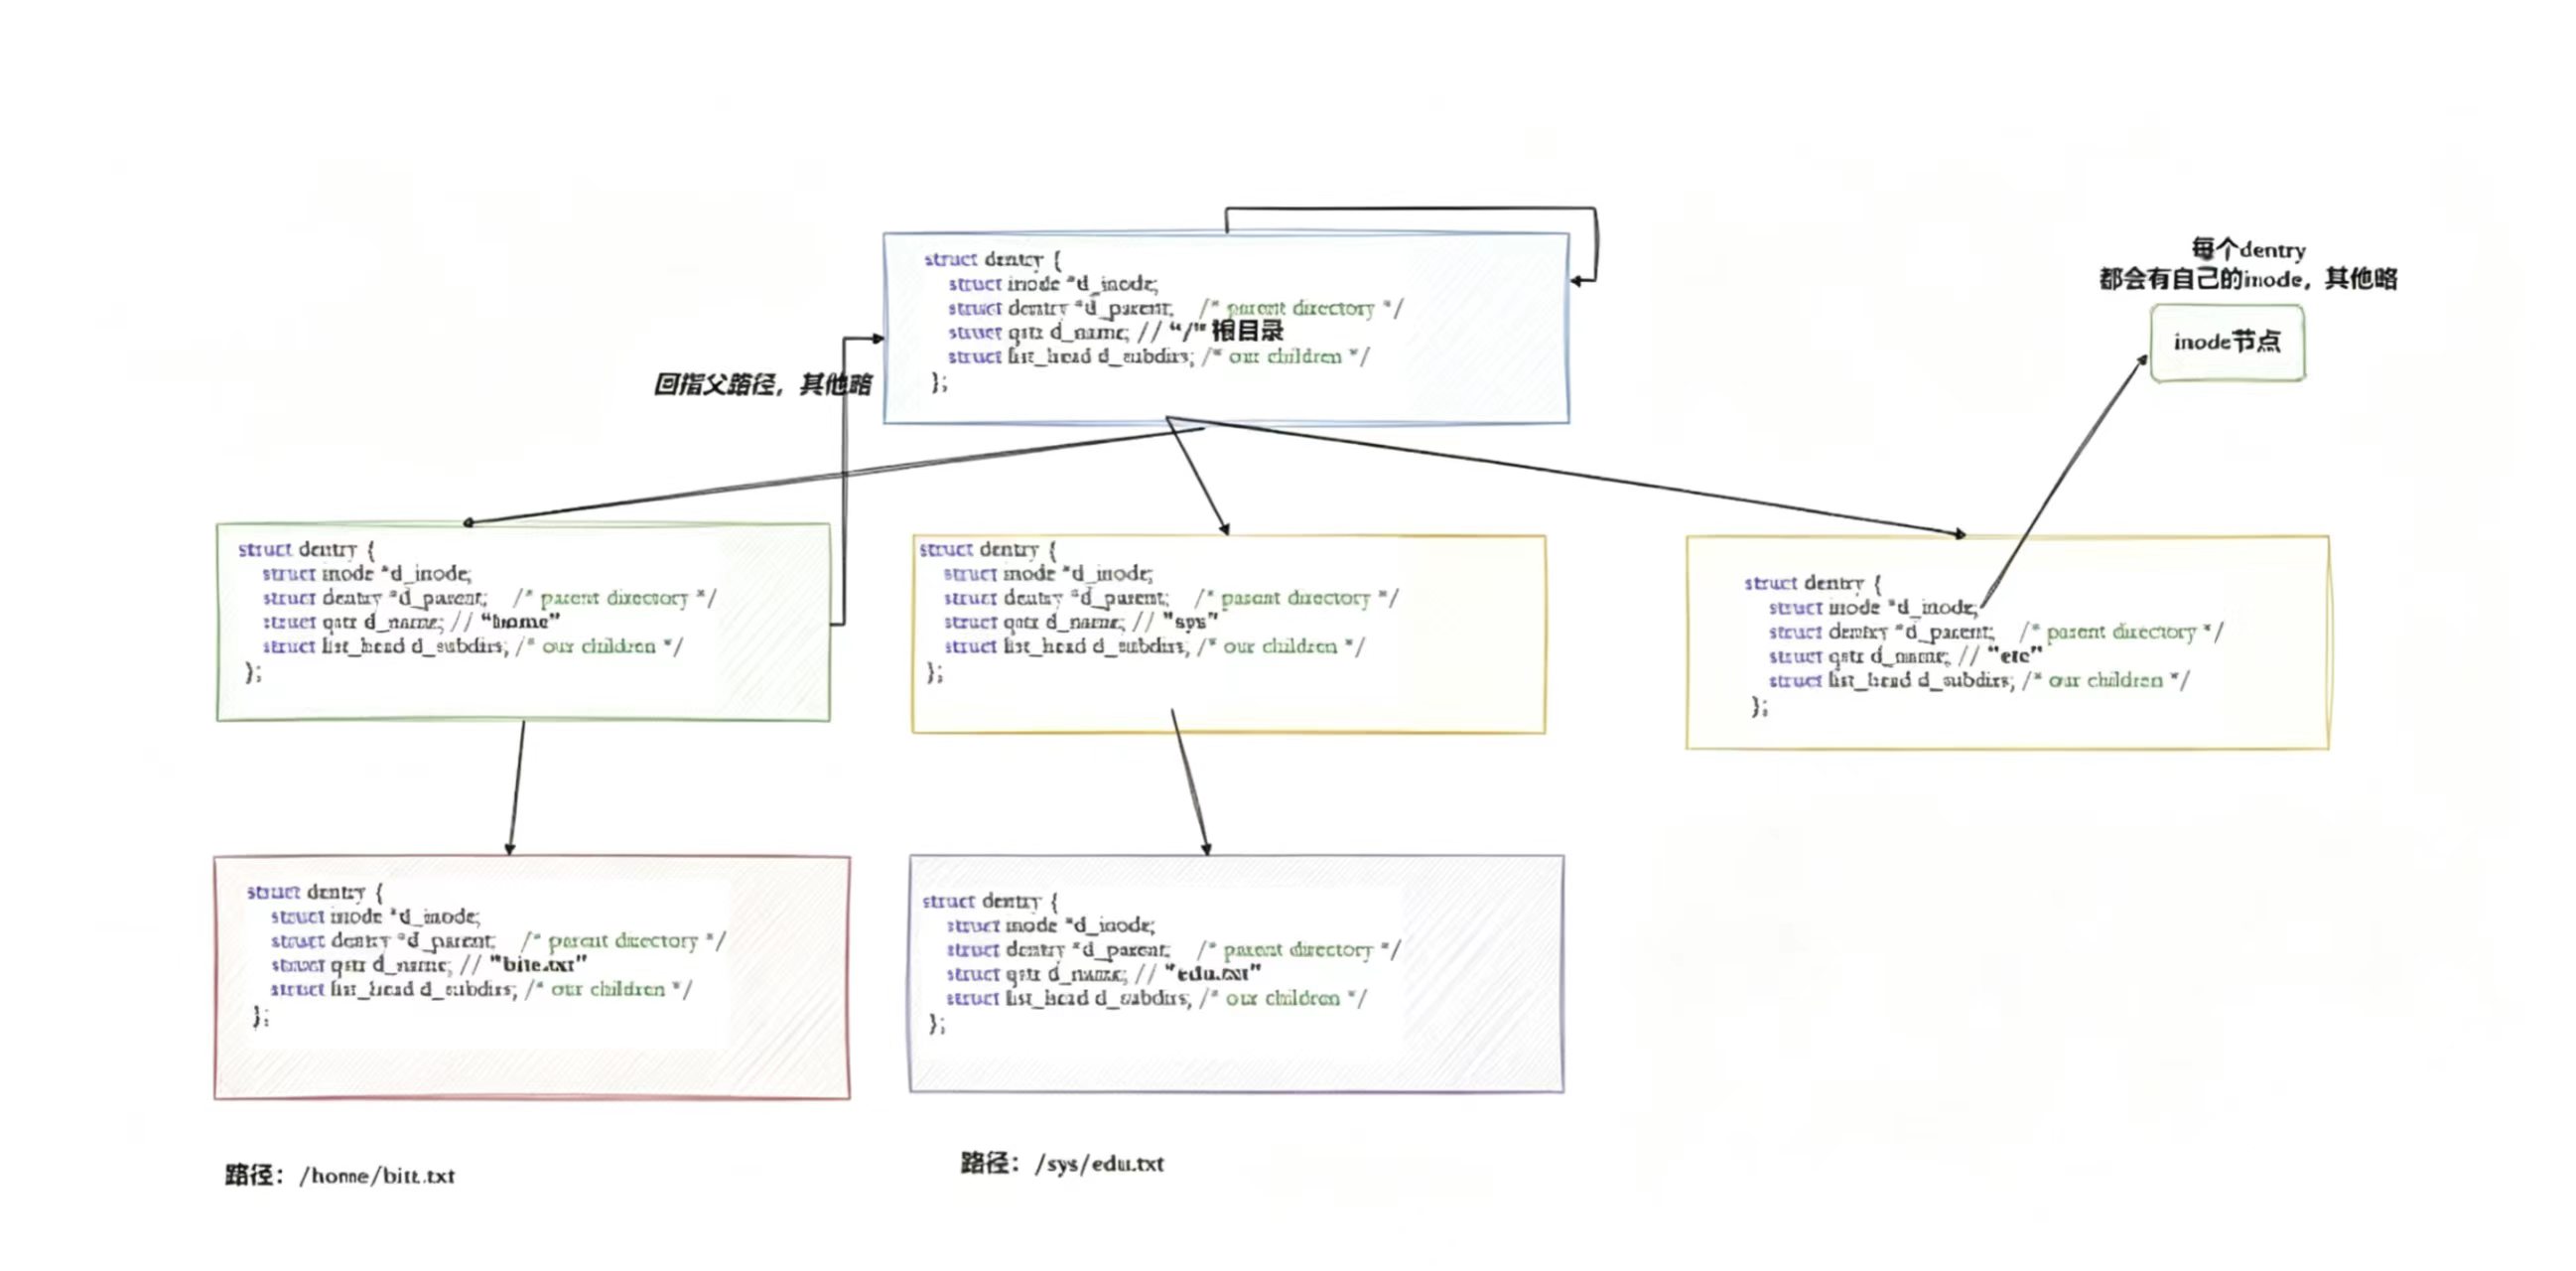
八、挂载(Mount):多分区统一成一棵树
8.1 挂载的本质
分区格式化后不能直接使用,必须挂载到现有目录树中的某个空目录(挂载点)上。挂载后访问该目录即访问该分区。
8.2 动手实验:用文件模拟分区挂载
bash
# 1. 创建 5MB 空镜像
dd if=/dev/zero of=./disk.img bs=1M count=5

# 2. 格式化为 Ext4
mkfs.ext4 disk.img

# 3. 创建挂载点
sudo mkdir -p /mnt/mydisk

# 4. 挂载
sudo mount -t ext4 ./disk.img /mnt/mydisk
df -h | grep mydisk

# 5. 卸载
sudo umount /mnt/mydisk
8.3 Loop 设备
/dev/loop0 ~ /dev/loop7 是回环设备,允许把普通文件当作块设备使用,实现像物理磁盘一样挂载 ISO、镜像文件。
bash
ls -l /dev/loop*九、文件系统核心原理全景总结
经过前面从物理磁盘到软硬链接的层层剖析,我们现在可以站在全局高度,把 Ext 文件系统的核心设计串成一条完整的逻辑链。
9.1 一张表看清核心概念演变
| 层次 | 核心概念 | 本质 | 关系 |
|---|---|---|---|
| 物理层 | 扇区(Sector) | 磁盘最小物理读写单元,512B | 物理基础 |
| 寻址层 | LBA | 扇区的一维线性地址 | CHS→LBA,固件自动转换 |
| 逻辑层 | 块(Block) | 文件系统最小读写单元,常见4KB | 块 = 8个扇区,格式化时确定 |
| 管理层 | 块组(Block Group) | 分区内多个等大的管理单元 | 每个块组独立管理所属 inode 和数据块 |
| 元数据层 | inode | 文件的"身份证",存属性和数据块指针 | 一个文件对应一个 inode,大小固定 |
| 数据层 | Data Block | 存放文件内容或目录内容 | inode 中 i_block[15] 指向这些块 |
| 目录层 | 目录文件 | 存"文件名→inode号"映射 | 目录也是文件,数据块存映射表 |
| 缓存层 | dentry | 内存中的路径缓存结构 | 树形组织,挂 LRU+Hash,加速路径解析 |
| 虚拟层 | 挂载(Mount) | 将分区根目录嫁接到目录树节点 | 实现多分区统一目录树 |
9.2 从磁盘到文件的全链路流程
第一步:物理寻址
- 磁盘物理上由盘片、磁头、柱面、扇区组成。
- 磁头共进退,所有盘面同一半径的磁道构成一个柱面。
- 一个磁道展开为一维扇区数组 → 一个柱面展开为二维数组(行=磁头/盘面,列=扇区) → 整个磁盘是多个柱面叠加的三维数组。
- 最终 OS 将所有扇区抽象为一维 LBA 线性地址数组,磁盘固件负责 LBA ↔ CHS 自动转换。
第二步:块与分区
- OS 按"块"(8个扇区,4KB)为最小单位进行读写。
- 磁盘被划分为多个分区,每个分区内部再划分为多个等大的块组。
第三步:文件系统格式化
- 格式化 = 向分区写入管理信息:超级块、GDT、块位图、inode位图、inode表等。
- 这些管理信息定义了如何在该分区内分配 inode 和数据块、如何找到文件。
第四步:文件创建与存储
- 文件 = 元属性(inode) + 数据内容(Data Block),两者分离存储。
- inode 固定大小(128/256B),存储权限、时间戳、硬链接计数、数据块指针数组
i_block[15]。 - 文件名不在 inode 中 ,而是存储在父目录的数据块里,形成"文件名→inode号"映射。
第五步:文件定位(路径解析)
- 访问
/home/user/test.txt时,从根/开始(inode固定),逐级读目录数据块,查找下一级 inode,直到目标文件。 - 内核用 dentry 树形结构在内存中缓存已解析路径,挂入 LRU(淘汰冷数据)和 Hash 表(快速查找)。
第六步:分区整合(挂载)
- 分区格式化后不能直接使用,必须 mount 到某个目录(挂载点)。
- 挂载后,该目录即成为访问该分区的入口,多个分区由此统一为一棵目录树。
9.3 关键设计思想的总结
① 分层抽象
- 物理层(扇区/磁道/柱面) → 寻址层(LBA) → 逻辑层(块) → 管理层(块组) → 元数据层(inode) → 缓存层(dentry) → 虚拟文件系统层(VFS)。
- 每一层屏蔽下层复杂性,上层只需关心本层接口。
② 分离原则
- 属性与内容分离:inode 存属性,Data Block 存内容。
- 文件名与 inode 分离:文件名在目录中,inode 独立编号。
- 这种分离让硬链接(多个文件名指向同一 inode)成为可能,也带来灵活性。
③ 局部性原理
- 块组设计让 inode 和对应的数据块尽量靠近,减少磁头寻道。
- 位图集中管理空闲资源,分配和回收效率高。
④ 索引灵活性
i_block[15]中 12 直接块 + 1/2/3 级间接块的设计,同时兼顾小文件的高效与大文件的容量。
⑤ 缓存加速
- dentry 路径缓存、inode 缓存、页缓存等多级缓存机制,大幅减少磁盘 I/O。
Ext 文件系统完整架构示意图:
十、硬链接与软链接:彻底弄懂
10.1 硬链接(Hard Link)
bash
touch original.txt
ln original.txt hardlink.txt
ls -li original.txt hardlink.txt
输出示例:
263466 -rw-r--r-- 2 user user 0 Jan 10 12:00 hardlink.txt
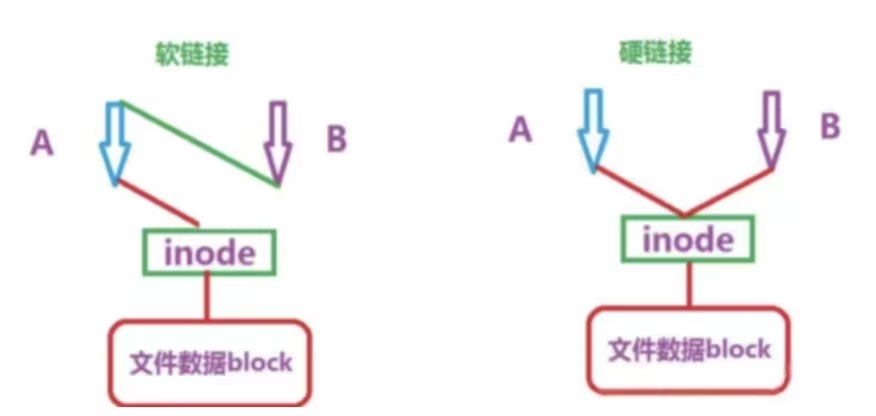
263466 -rw-r--r-- 2 user user 0 Jan 10 12:00 original.txt- 多个文件名指向同一个 inode,链接计数为 2。
- 不占用新 inode,只是目录中多了一条映射记录。
- 不能跨分区 、不能给目录创建 (
.和..由系统维护)。
10.2 软链接(Symbolic Link)
bash
ln -s original.txt softlink.txt
ls -li original.txt softlink.txt263466 -rw-r--r-- 1 user user 0 ... original.txt
261680 lrwxrwxrwx 1 user user 12 ... softlink.txt -> original.txt- 相当于 Windows 快捷方式,独立文件,有自己的 inode 和数据块。
- 数据块中存储的是目标文件路径(字符串)。
- 可跨分区、可链接目录。
- 源文件删除后,软链接变为"悬挂"状态(失效)。
10.3 对比总结表
| 特性 | 硬链接 | 软链接 |
|---|---|---|
| inode 号 | 相同 | 不同 |
| 跨文件系统 | 不可以 | 可以 |
| 链接目录 | 不可以 | 可以 |
| 源文件删除后 | 仍然可用(计数>0) | 失效(悬挂) |
| 本质 | 多个目录项指向同一 inode | 存放目标路径的独立文件 |
10.4 删除文件的真正逻辑
rm file 的执行流程:
- 在其父目录的数据块中删除
"file" → inode号的记录。 - 对应的 inode 中
i_links_count减 1。 - 若链接数降为 0 且无进程占用,则释放 inode 及所有数据块(在位图中标记为空闲)。
10.5 软硬链接的典型用途
- 硬链接 :文件备份、
.和..的实现。 - 软链接 :快捷方式、库版本管理(如
/usr/bin/python -> python3)。
十一、高频易错点与面试常考
- 扇区 ≠ 块:扇区 512B(物理),块常见 4KB(逻辑)。
- 文件名不在 inode 里:文件名存在目录的数据块中。
- 硬链接不能跨分区:inode 编号只在分区内唯一。
- 软链接是独立文件:有自己的 inode,存的是路径字符串。
- 访问文件需要路径上所有目录的 x 权限。
- "磁盘满"可能有两种 :
- 数据块满:
df -h查看。 - inode 耗尽:
df -i查看(每个文件消耗一个 inode)。
- 数据块满:
mv在同一分区内极快:仅修改目录项,不动实际数据。跨分区则是复制+删除。
十二、常用命令速查表
| 命令 | 功能 |
|---|---|
fdisk -l |
查看磁盘与分区 |
stat <file> |
查看文件完整 inode 信息 |
ls -i / ls -li |
查看 inode 号及详细信息 |
mkfs.ext4 /dev/sda1 |
格式化分区 |
mount /dev/sda1 /mnt |
挂载分区 |
umount /mnt |
卸载分区 |
ln file link |
创建硬链接 |
ln -s file link |
创建软链接 |
df -h |
查看磁盘空间使用 |
df -i |
查看 inode 使用情况 |
dumpe2fs /dev/sda1 |
查看文件系统详细信息 |
十三、总结
从扇区、磁道、柱面的三维物理结构,到拉直成一维 LBA 数组的逻辑抽象;从 Ext 的块组布局,到 inode 的多级索引;从目录本质的颠覆认知,到 dentry 路径缓存的加速机制;最后落地的挂载、软硬链接的实际使用------这篇博客带你从底层硬件到上层命令,全面吃透 Linux Ext 文件系统。
掌握这些,你将:
- 真正理解"磁盘满"和"inode 耗尽"的区别
- 能灵活运用硬链接、软链接管理文件
- 清楚
mount、格式化、分区的底层到底做了什么 - 在面试中对文件系统问题对答如流
如果本文对你有帮助,欢迎点赞、收藏、评论,你的支持是我持续输出的动力!