问题:
小表left join超大表,耗时要超1.5h,而且发生了FetchException导致任务多次重试之后挂掉的情况:
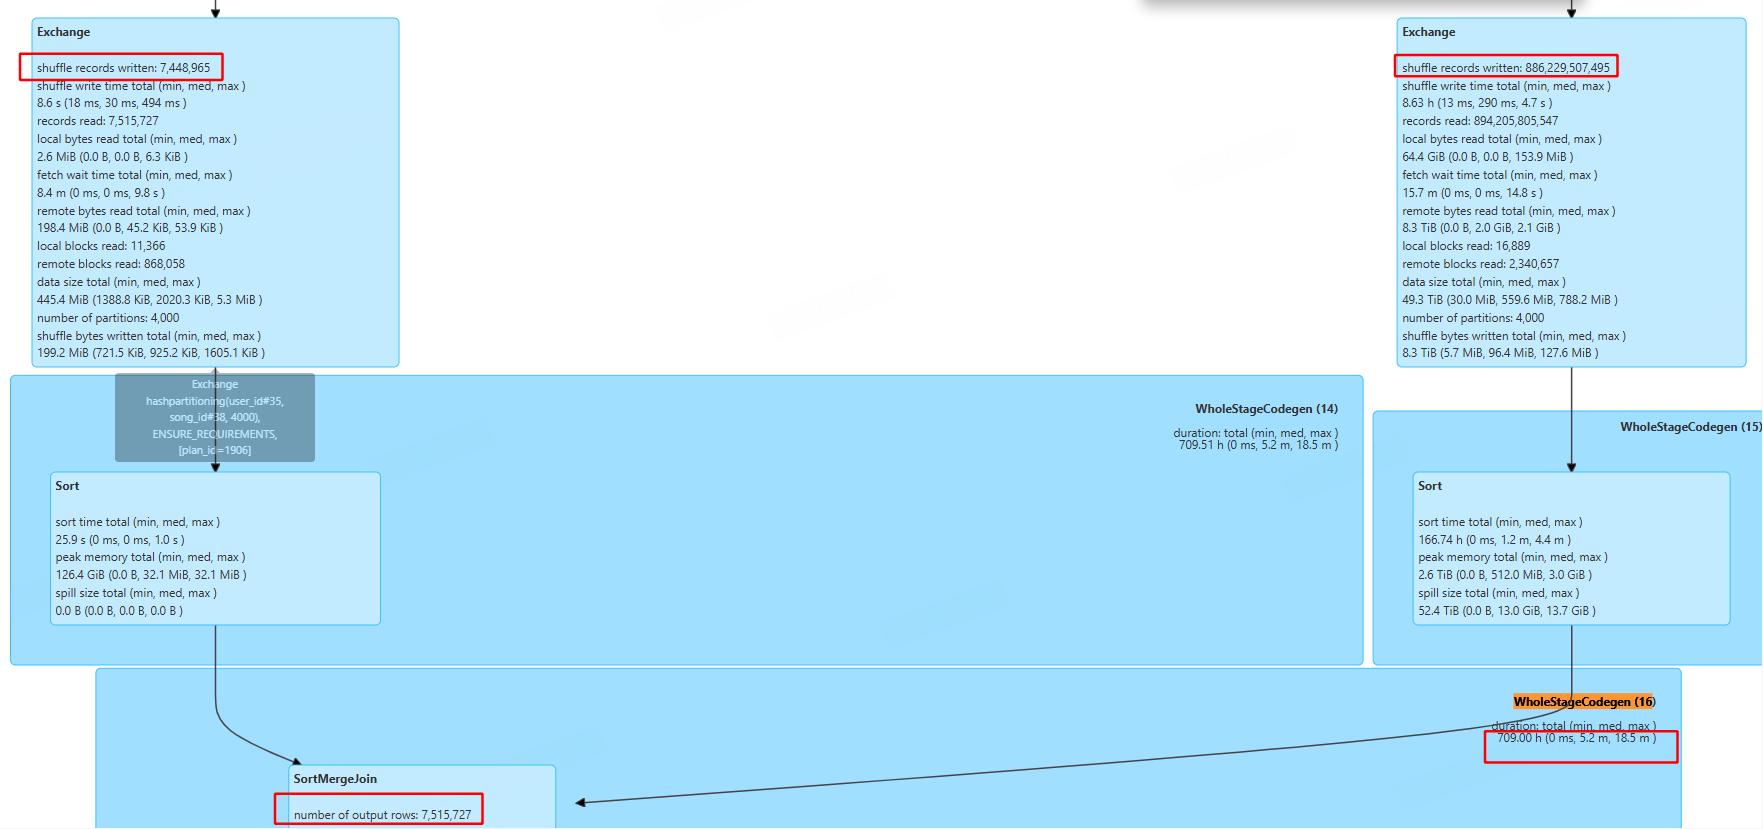
解决方案:
ai了一番之后,给出了一个靠谱的解决方案:Runtime BloomFilter:
修改前:
...
from table_small_xxx
LEFT JOIN (
            select user_id
            from table_xxx
            where dt='${etl_date}'
    ) t3 ON (t1.user_id=t3.user_id)

修改后:

SET spark.sql.runtimeFilter.bloomFilter.enabled=true;    --  总开关。是否启用 Runtime BloomFilter
SET spark.sql.runtimeFilter.bloomFilter.applicationSideScanSizeThreshold=10GB;    -- application side (大表) 必须 ≥ 这个阈值, 才考虑加 BF
SET spark.sql.runtimeFilter.bloomFilter.creationSideThreshold=1GB;    -- creation side (小表) 必须 ≤ 这个阈值, 才会去构建 BF,避免bf太大
SET spark.sql.runtimeFilter.semiJoinReduction.enabled=true;    -- 另一种运行时过滤策略,适合build side很小无须使用bloomfliter直接用类似in的查询方式(其实也可以不加)

...
from table_small_xxx
LEFT JOIN (
    SELECT t.user_id
    FROM table_xxx t
    LEFT SEMI JOIN (
        SELECT DISTINCT user_id
        FROM table_small_xxx
        WHERE dt='${etl_date}'
      ) s ON (t.user_id = s.user_id)
      WHERE t.dt='${etl_date}'
) t3 ON (t1.user_id=t3.user_id)
原理介绍:
a left join b 时,a是小表,b是超大表。 那么就先对a中的join条件构造bloomfilter,broadcast到各个executor上,把超大表中的数据先剔除掉,这样就不会shuffle大量数据了。
                   ┌────────────────────────────┐
                   │  Build Side (小的一边)       │
                   │  (creation side)            │
                   │  e.g. song_base_info 750万  │
                   └────────────┬────────────────┘
                                │ 1. 扫一遍, 把 join key 全部塞进 BF
                                ▼
                   ┌────────────────────────────┐
                   │     BloomFilter 数据结构     │
                   │  几 MB ~ 几十 MB 的 bitmap  │
                   └────────────┬────────────────┘
                                │ 2. 通过 Broadcast 分发到 tag 表 scan task
                                ▼
                   ┌────────────────────────────┐
                   │  Application Side (大的一边)│
                   │  e.g. tag 表 8862 亿行      │
                   │                             │
                   │  for each row in tag:        │
                   │    if BF.mightContain(key):  │
                   │      emit row  ← 1% 通过     │
                   │    else:                     │
                   │      skip      ← 99% 丢弃    │
                   └────────────┬────────────────┘
                                │ 3. 输出筛选后的小数据集
                                ▼
                       进入正常的 Join 阶段