DataNode启动源码
创建HttpServer
初始化DataNode Rpc服务
获取NameNode Rpc代理
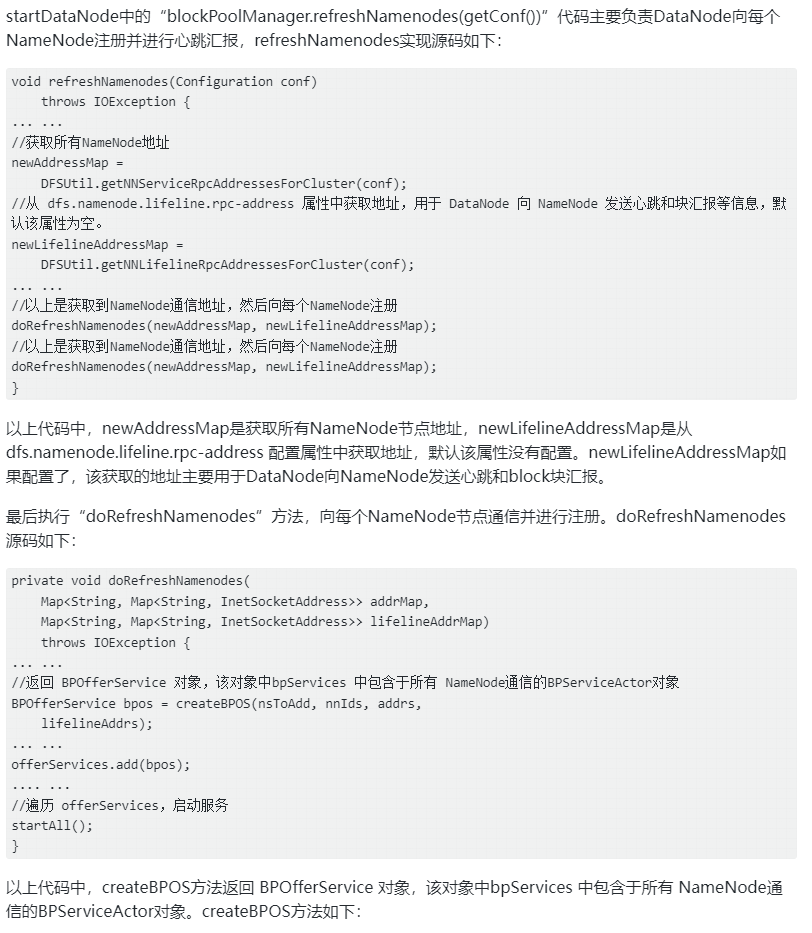
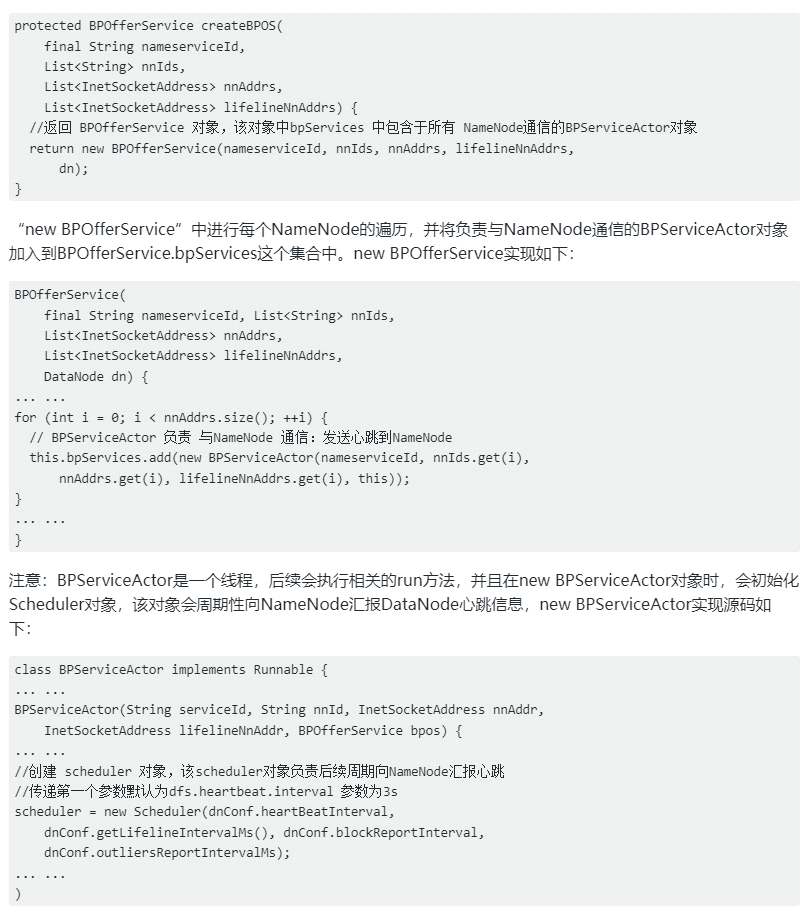
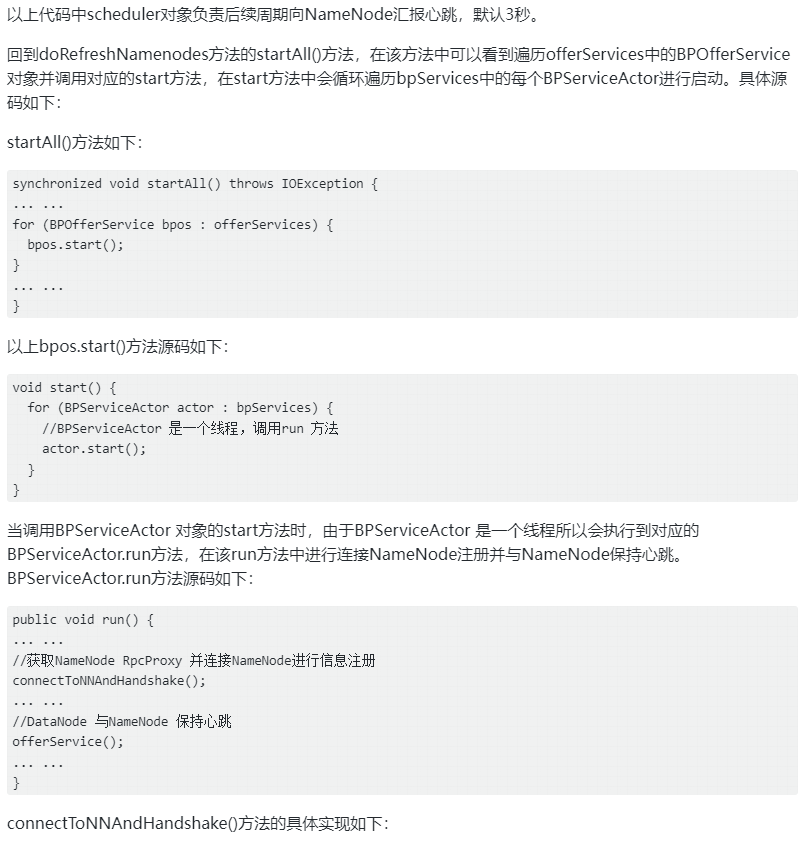
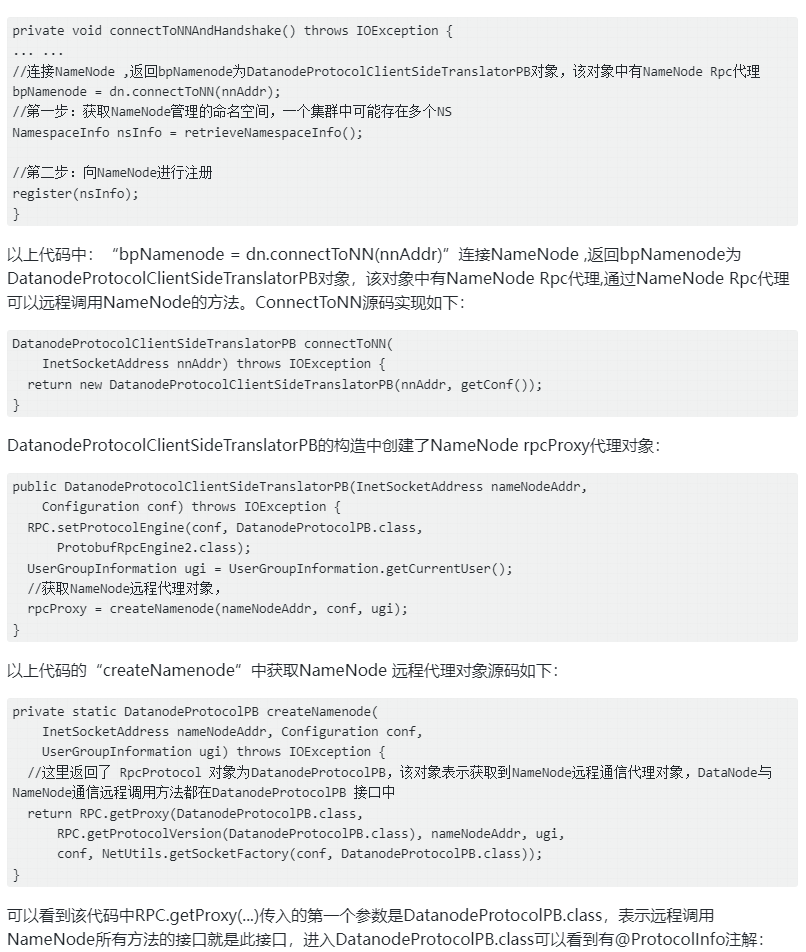
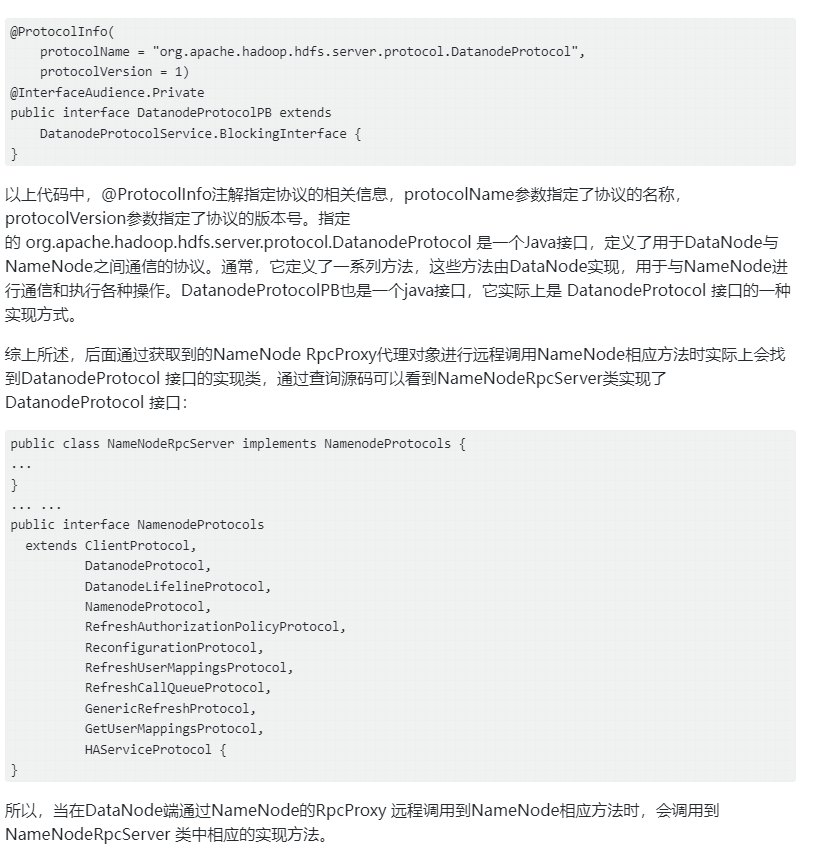
Datanode向NameNode注册
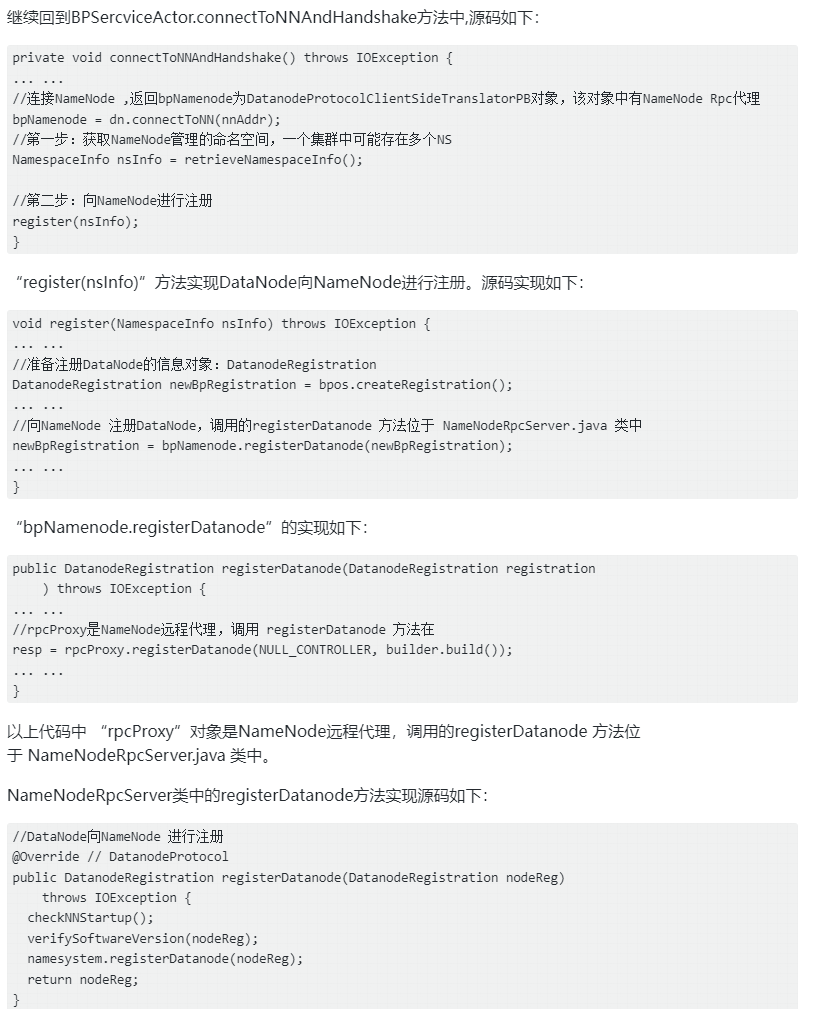
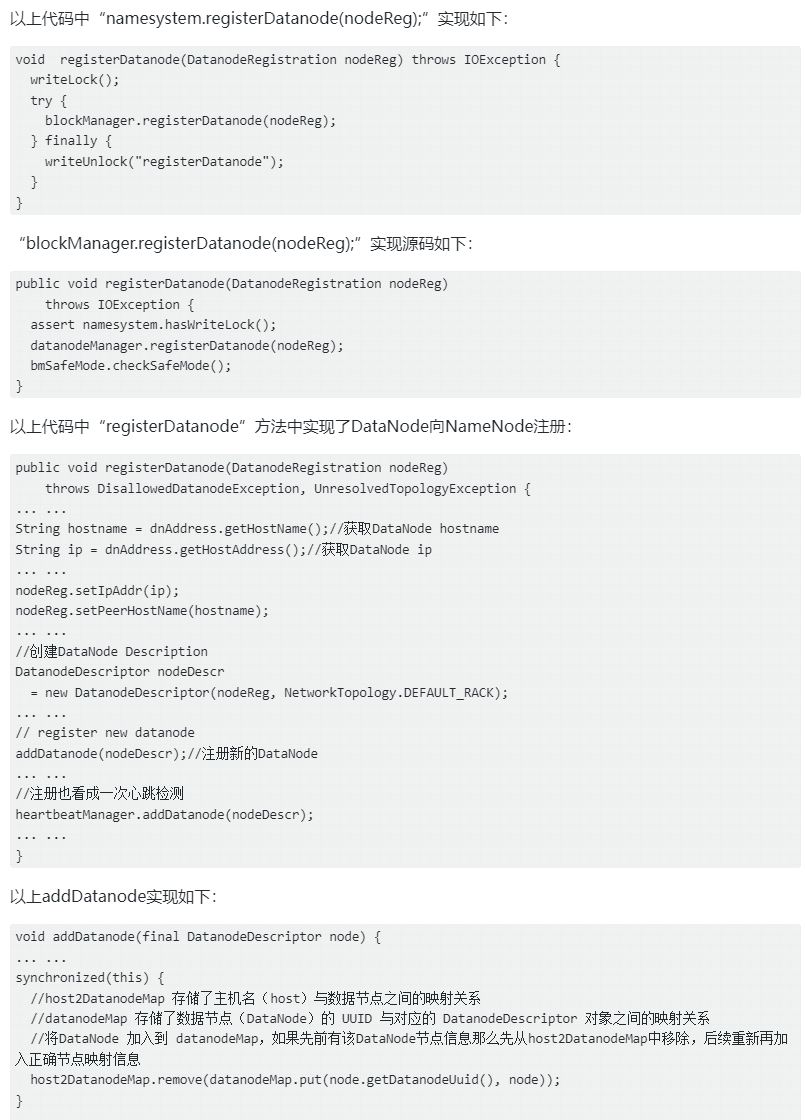
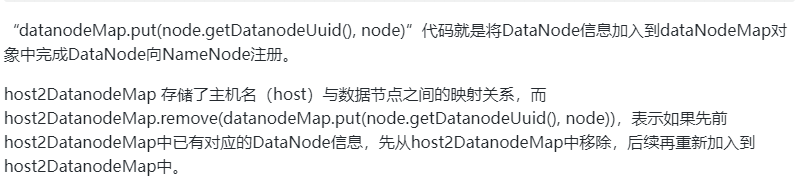
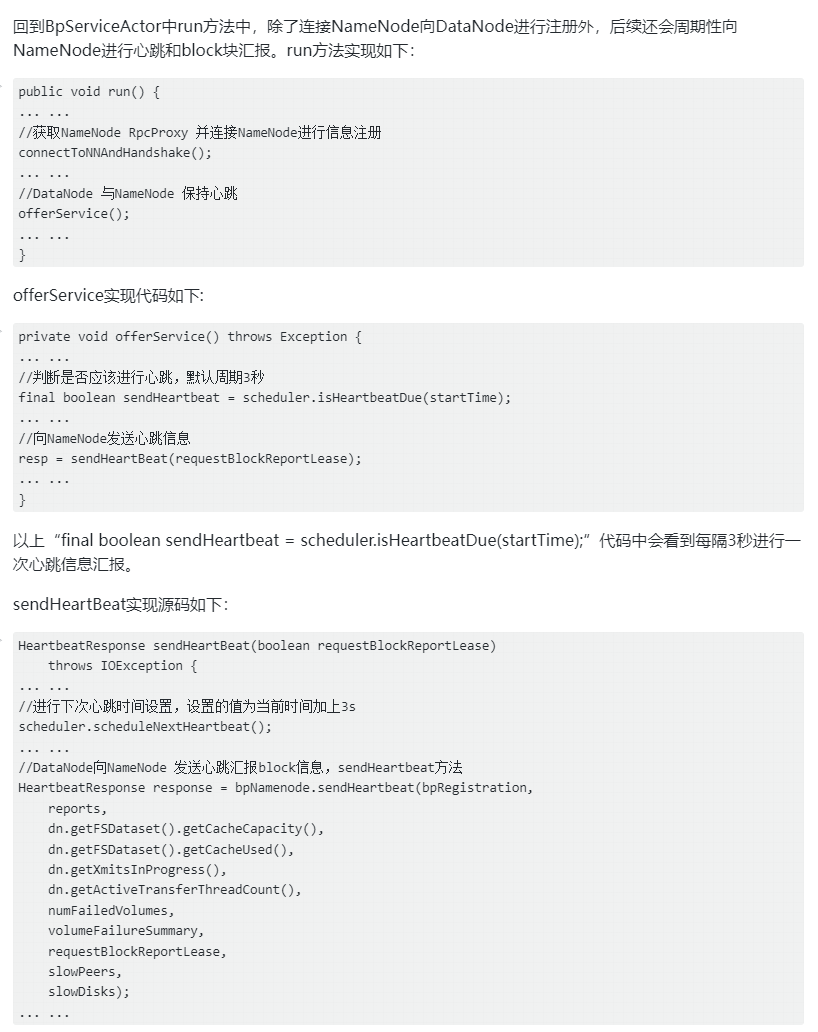
DataNode与NameNode周期心跳及block块汇报
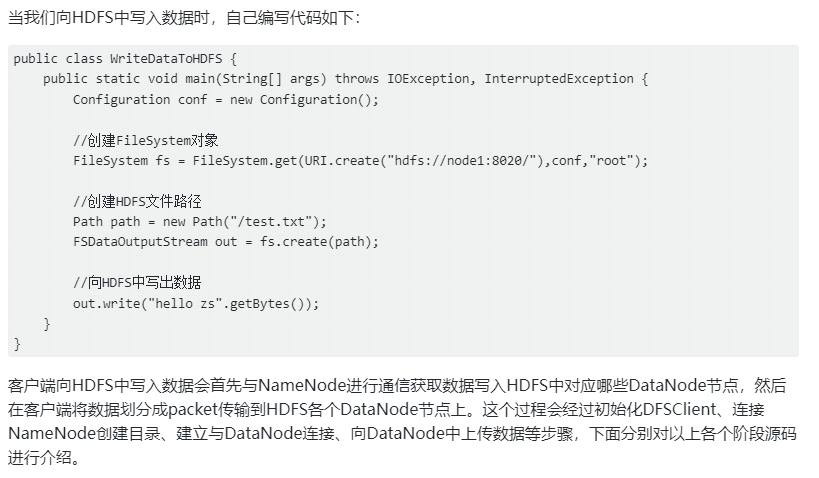
数据上传源码
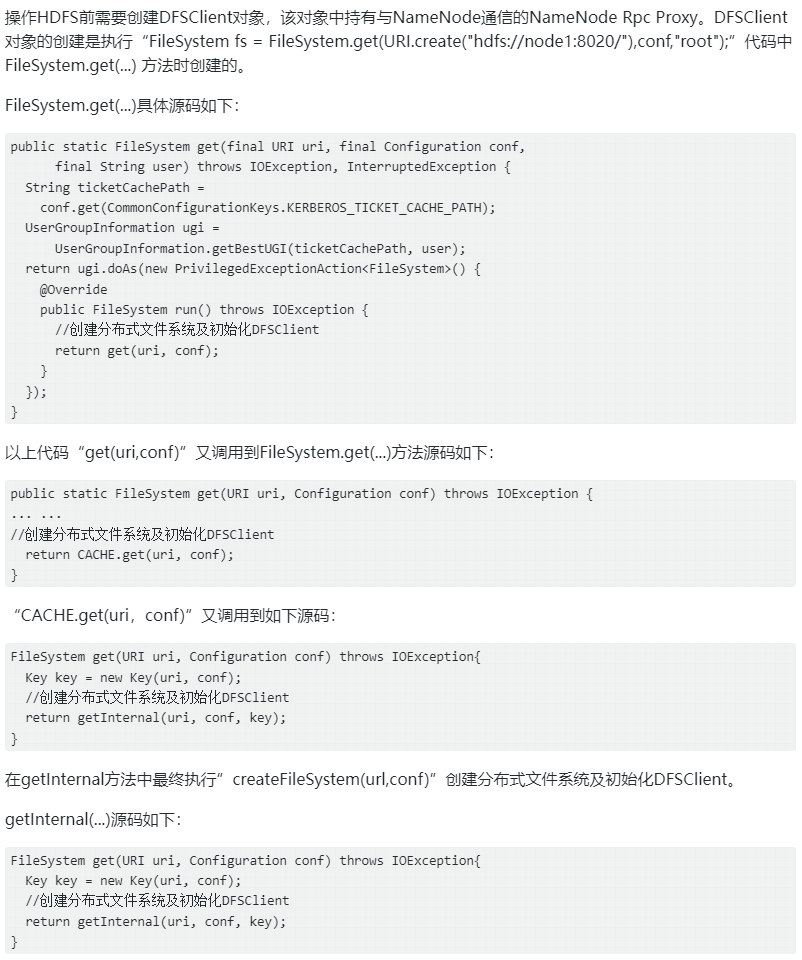
创建文件系统及初始化DFSClient
连接NN创建目录
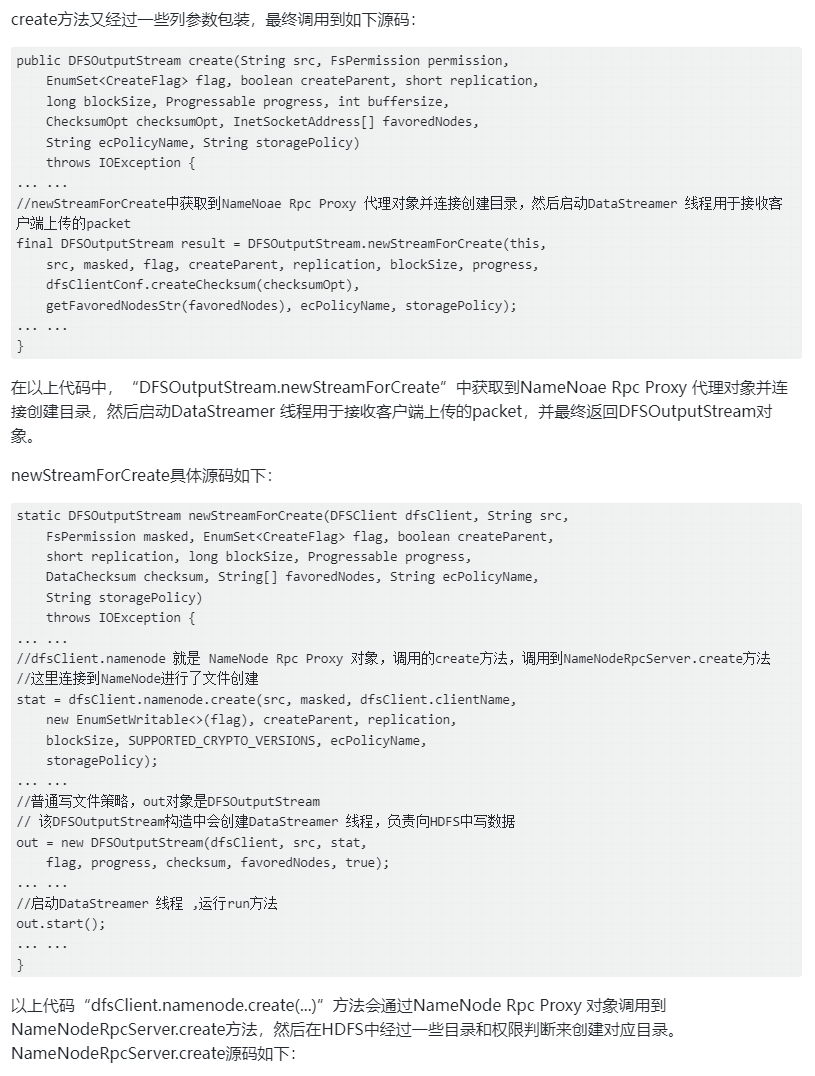
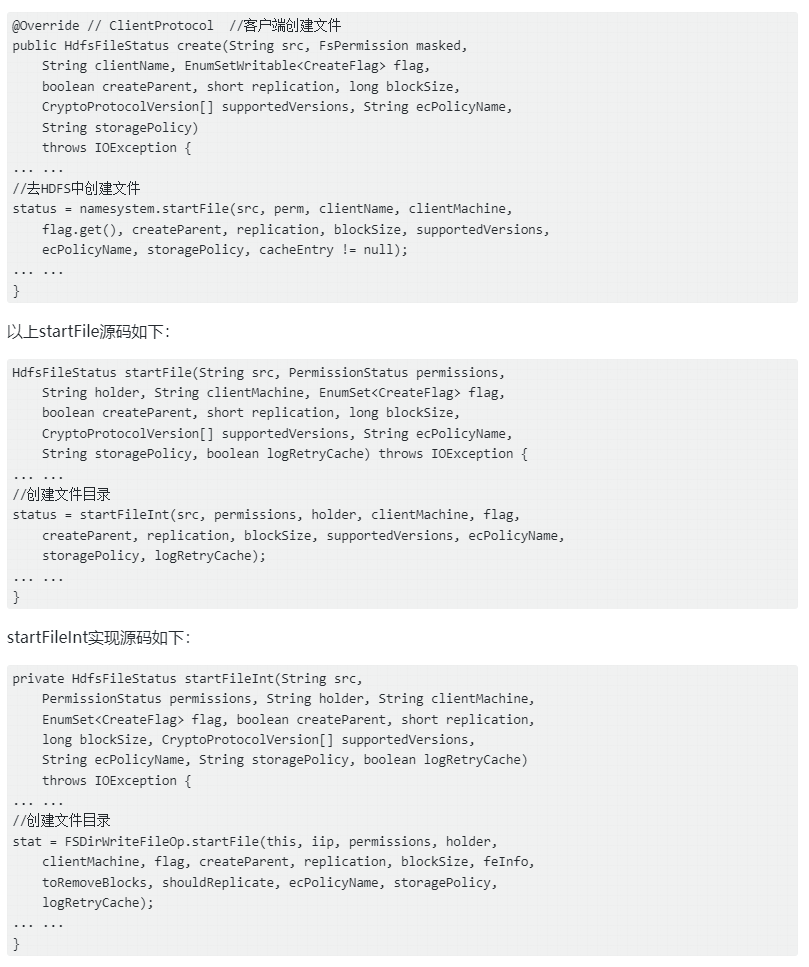
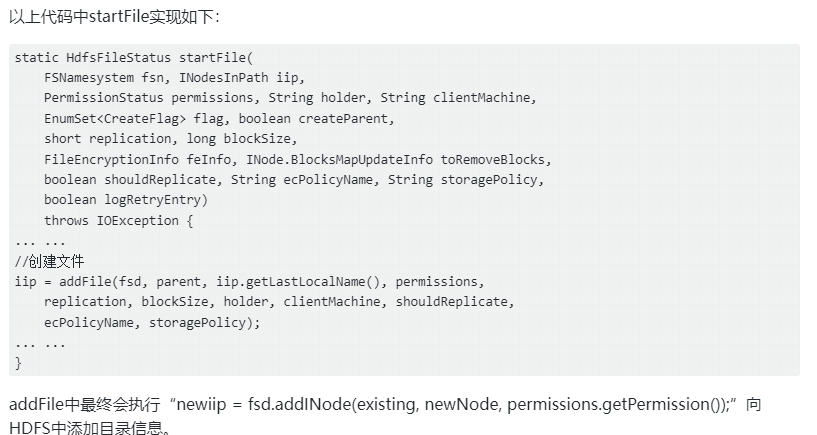
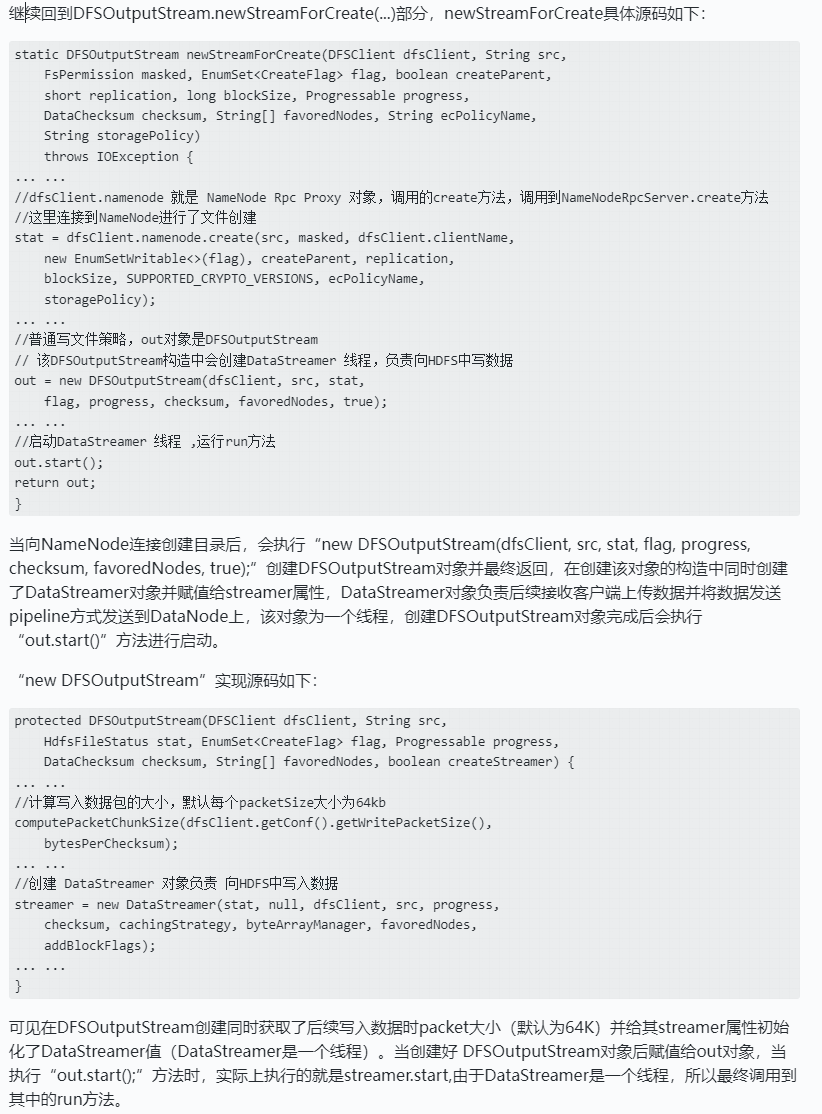
启动DataStreamer线程
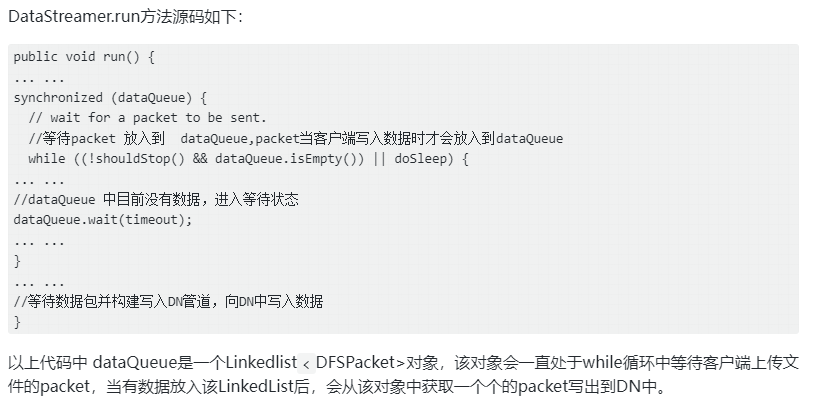
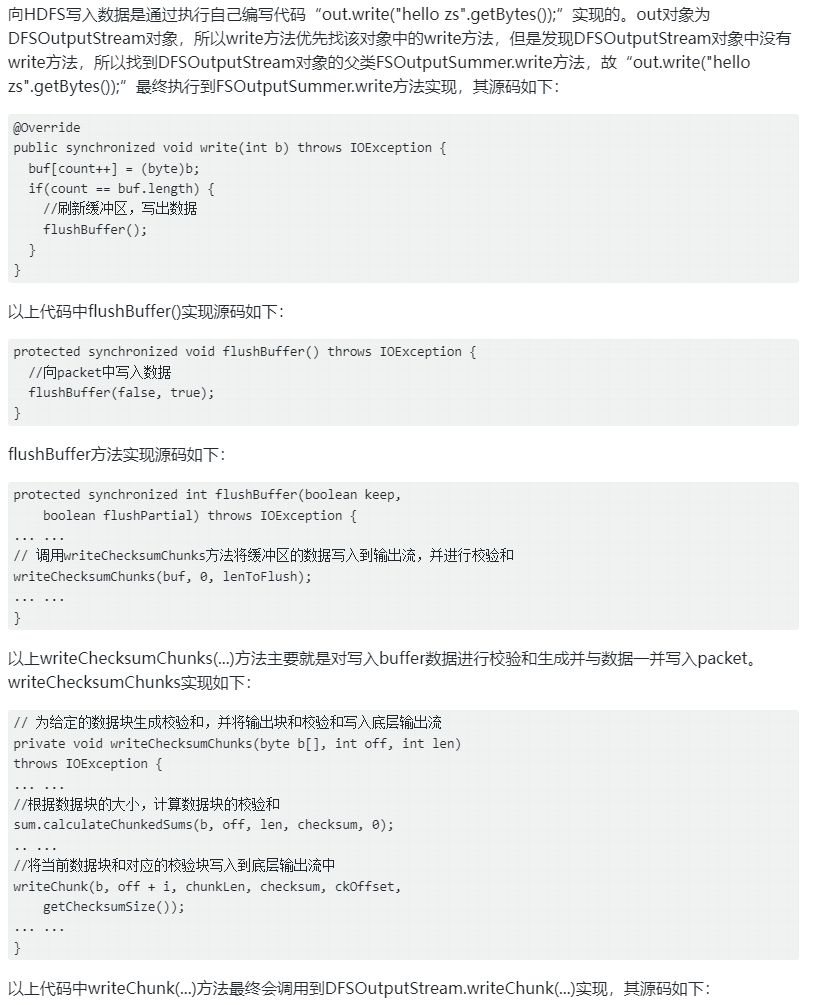
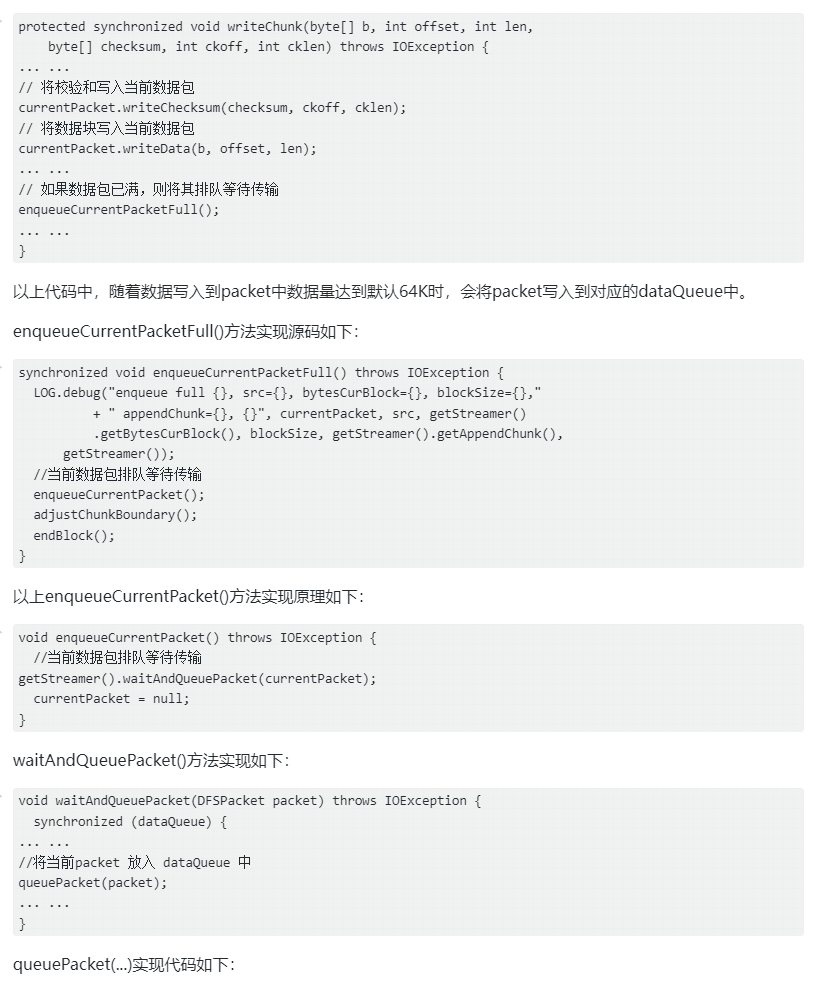
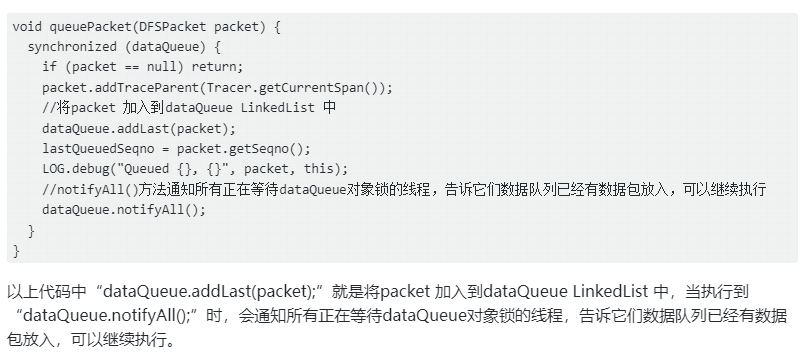
向dataQueue队列中写入packet
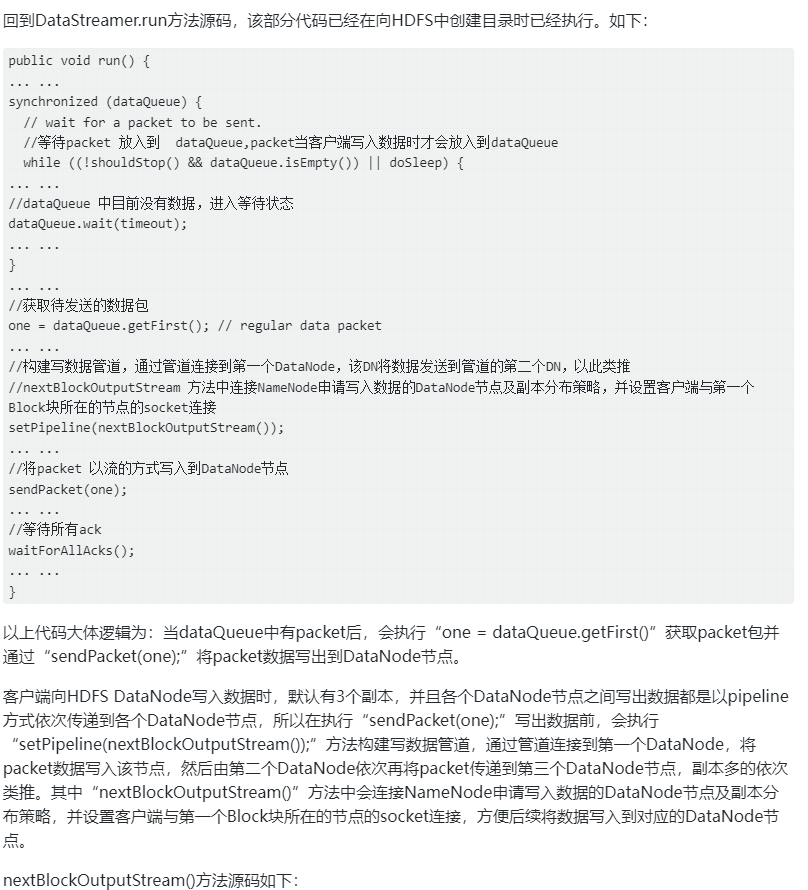
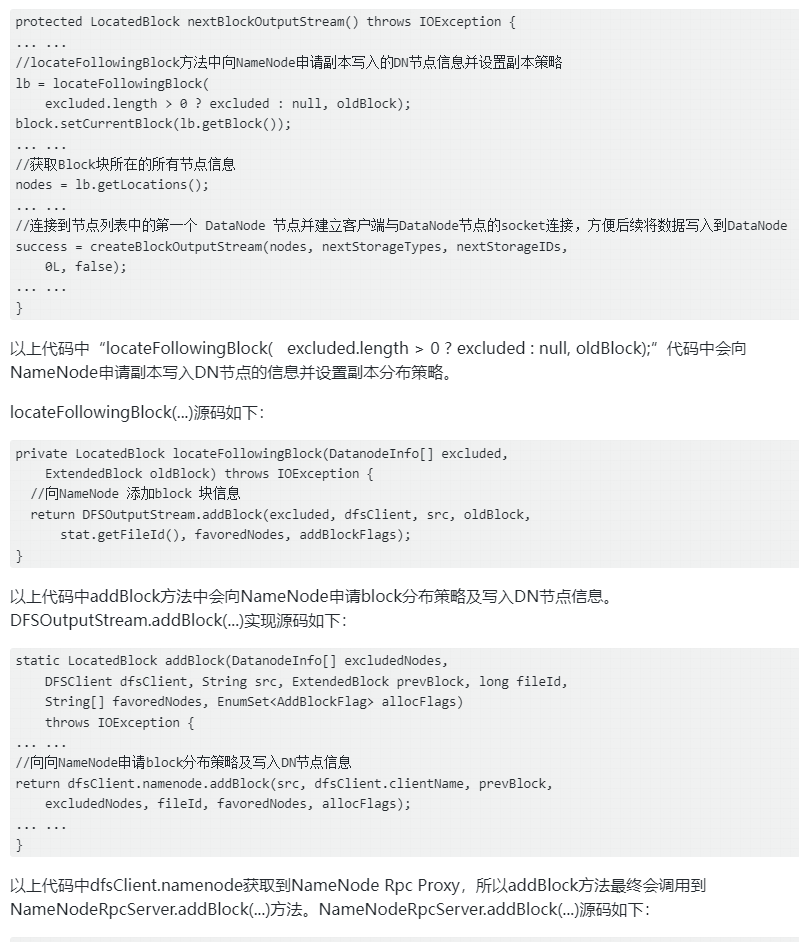
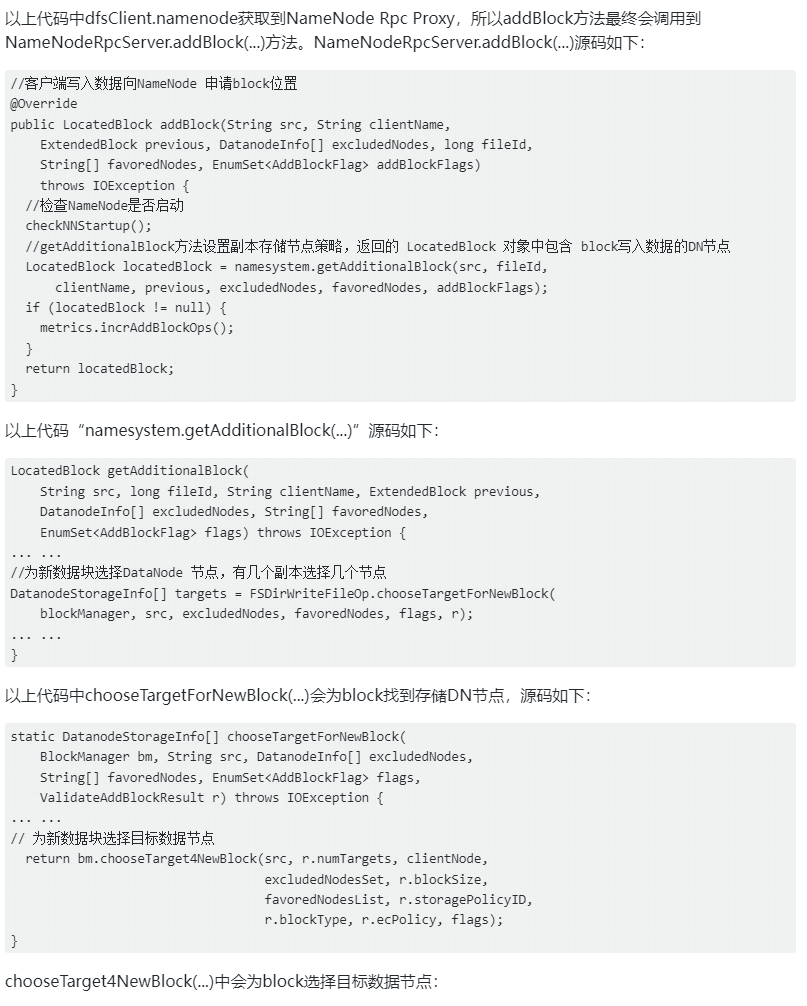
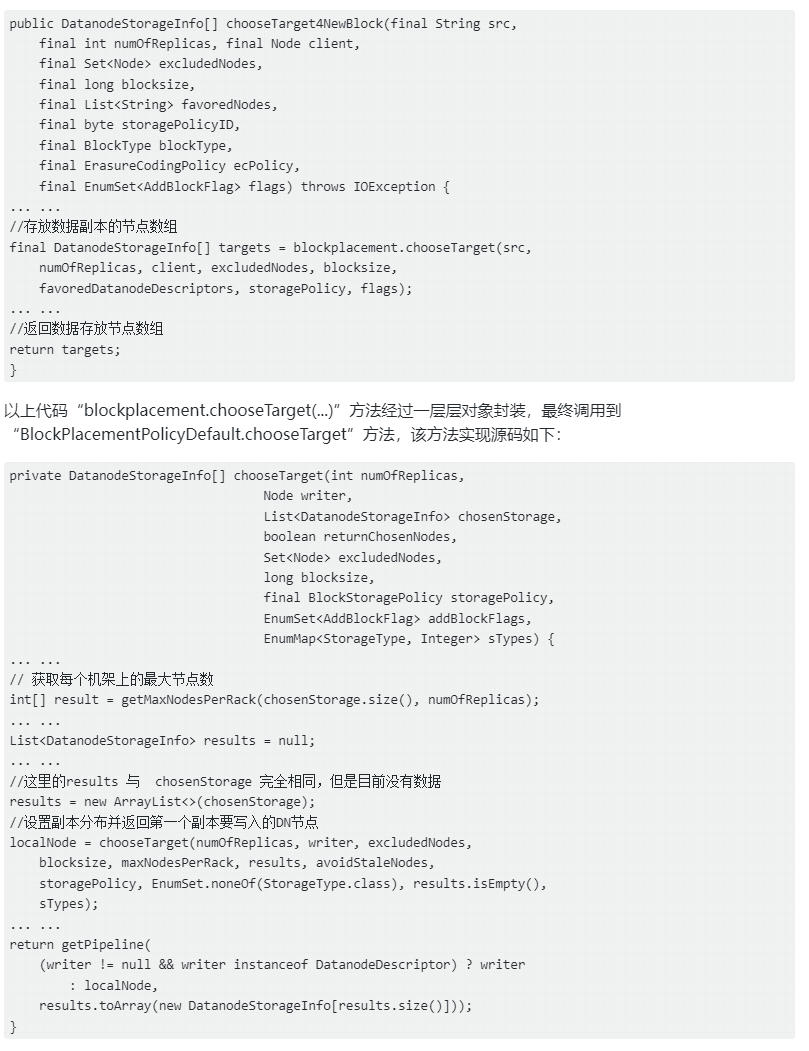
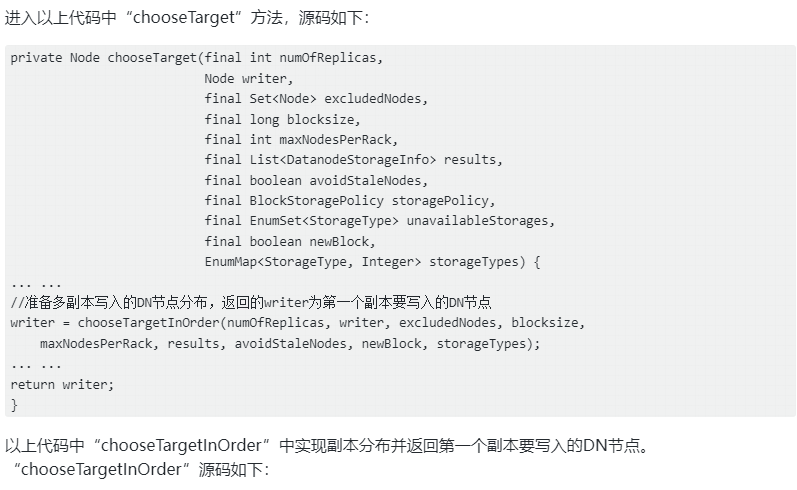
设置副本写入策略源码
java
protected Node chooseTargetInOrder(int numOfReplicas,
                               Node writer,
                               final Set<Node> excludedNodes,
                               final long blocksize,
                               final int maxNodesPerRack,
                               final List<DatanodeStorageInfo> results,
                               final boolean avoidStaleNodes,
                               final boolean newBlock,
                               EnumMap<StorageType, Integer> storageTypes)
                               throws NotEnoughReplicasException {
  // 计算结果列表的大小,默认初始 results 为0,result集合表示副本所在的节点
  final int numOfResults = results.size();
  // 如果结果列表为空
  if (numOfResults == 0) {
    // 选择本地节点作为第一个副本存储位置,并向result中加入节点
    DatanodeStorageInfo storageInfo = chooseLocalStorage(writer,
        excludedNodes, blocksize, maxNodesPerRack, results, avoidStaleNodes,
        storageTypes, true);

    //writer第一个副本要写出的DataNode节点
    writer = (storageInfo != null) ? storageInfo.getDatanodeDescriptor()
                                   : null;

    //减去一个副本后,如果为0则返回,writer,否则不返回,继续
    if (--numOfReplicas == 0) {
      return writer;
    }
  }
  //第一个副本所在DN节点
  final DatanodeDescriptor dn0 = results.get(0).getDatanodeDescriptor();

  if (numOfResults <= 1) {
    //选择远程机架存放第二个副本
    chooseRemoteRack(1, dn0, excludedNodes, blocksize, maxNodesPerRack,
        results, avoidStaleNodes, storageTypes);
    if (--numOfReplicas == 0) {
      //writer第一个副本要写出的DataNode节点
      return writer;
    }
  }

  if (numOfResults <= 2) {
    //第二个副本所在DN节点
    final DatanodeDescriptor dn1 = results.get(1).getDatanodeDescriptor();
    if (clusterMap.isOnSameRack(dn0, dn1)) {//如果dn0与dn1是同一机架,第三个副本选择不同机架
      chooseRemoteRack(1, dn0, excludedNodes, blocksize, maxNodesPerRack,
          results, avoidStaleNodes, storageTypes);
    } else if (newBlock){//如果是新块,选择与dn1 第二个副本所在节点相同的机架上放第三个副本
      chooseLocalRack(dn1, excludedNodes, blocksize, maxNodesPerRack,
          results, avoidStaleNodes, storageTypes);
    } else {//随机选择一台节点存储第3个副本
      chooseLocalRack(writer, excludedNodes, blocksize, maxNodesPerRack,
          results, avoidStaleNodes, storageTypes);
    }
    if (--numOfReplicas == 0) {
      //writer第一个副本要写出的DataNode节点
      return writer;
    }
  }
  //大于3个副本,随机选择节点存放副本
  chooseRandom(numOfReplicas, NodeBase.ROOT, excludedNodes, blocksize,
      maxNodesPerRack, results, avoidStaleNodes, storageTypes);
  //writer第一个副本要写出的DataNode节点
  return writer;
}
"chooseTargetInOrder"方法代码逻辑为block 副本找到存储节点的策略,然后返回block所在的第一个节点,首先第一个block存储在本机,第二个block存储在远程机架,第三个副本存储时先判断是否第一个副本和第二个副本是否在同一机架,如果在同一机架,那么第三个副本选择不同机架进行存储,否则选择与第二个副本相同机架的随机节点进行存储。最终该方法返回存储第一个副本的DataNode节点。
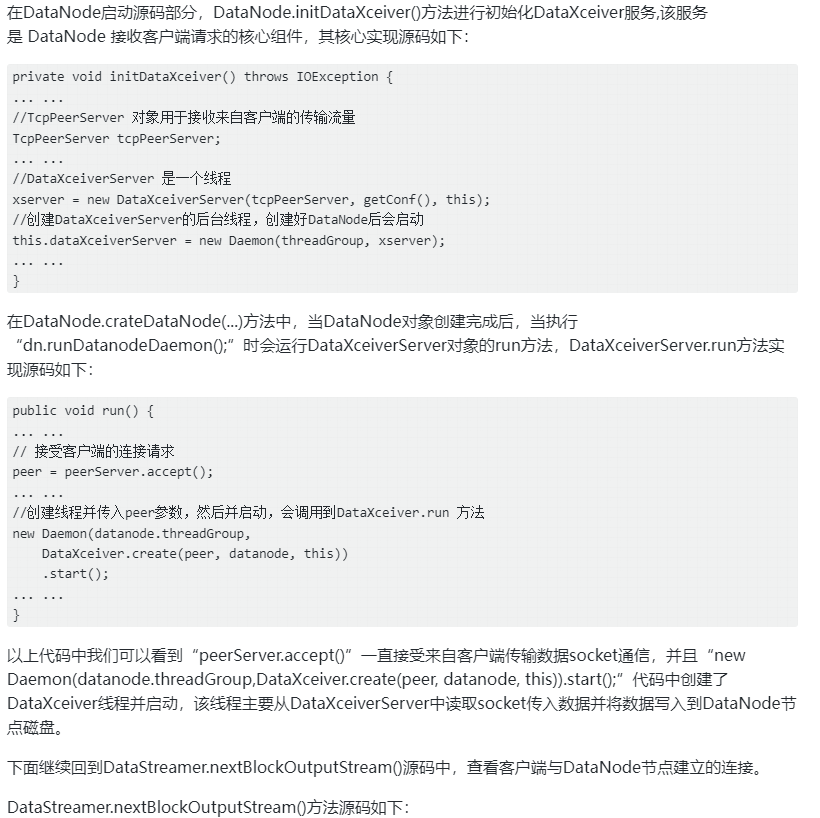
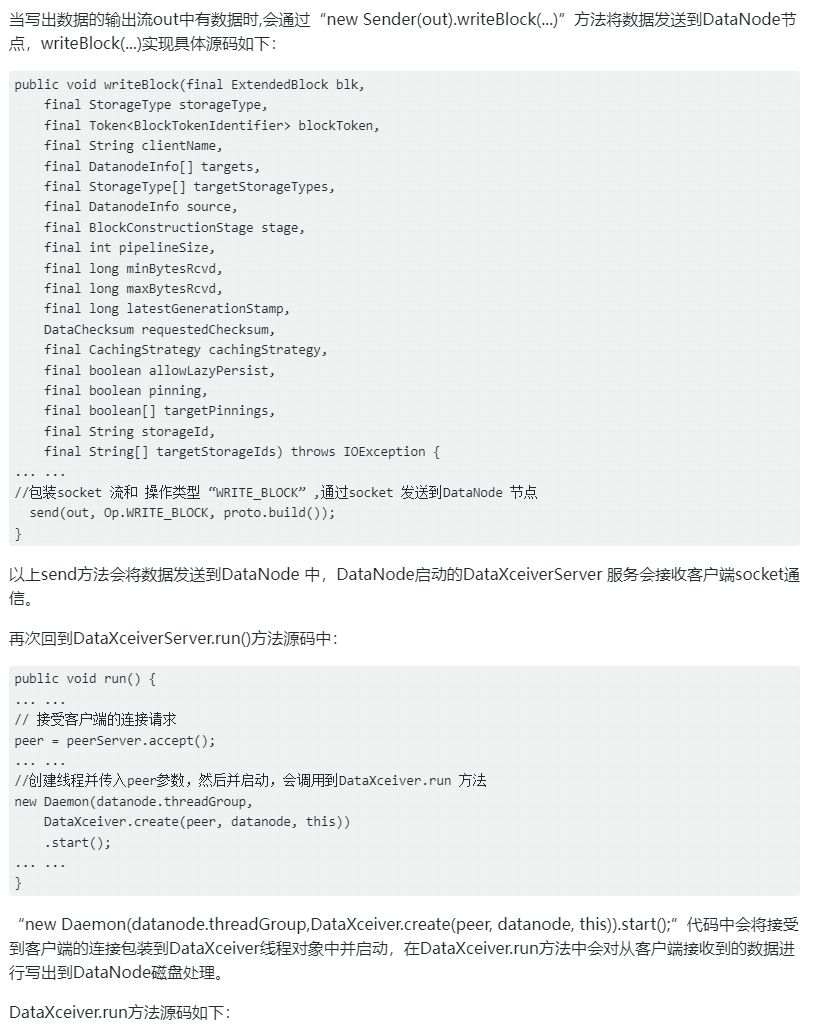
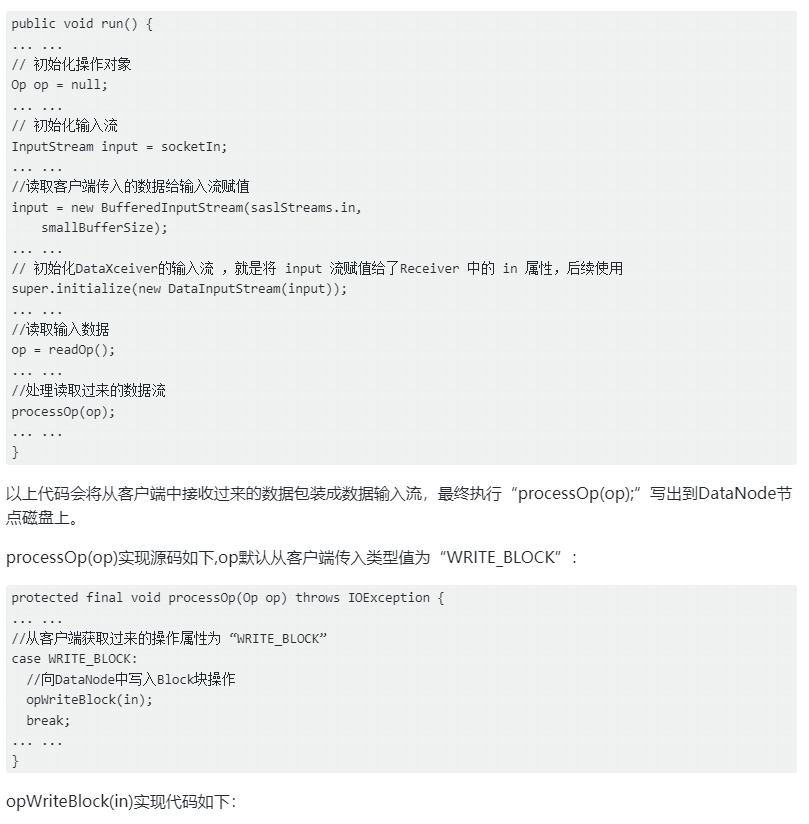
客户端与DataNode建立socket通信
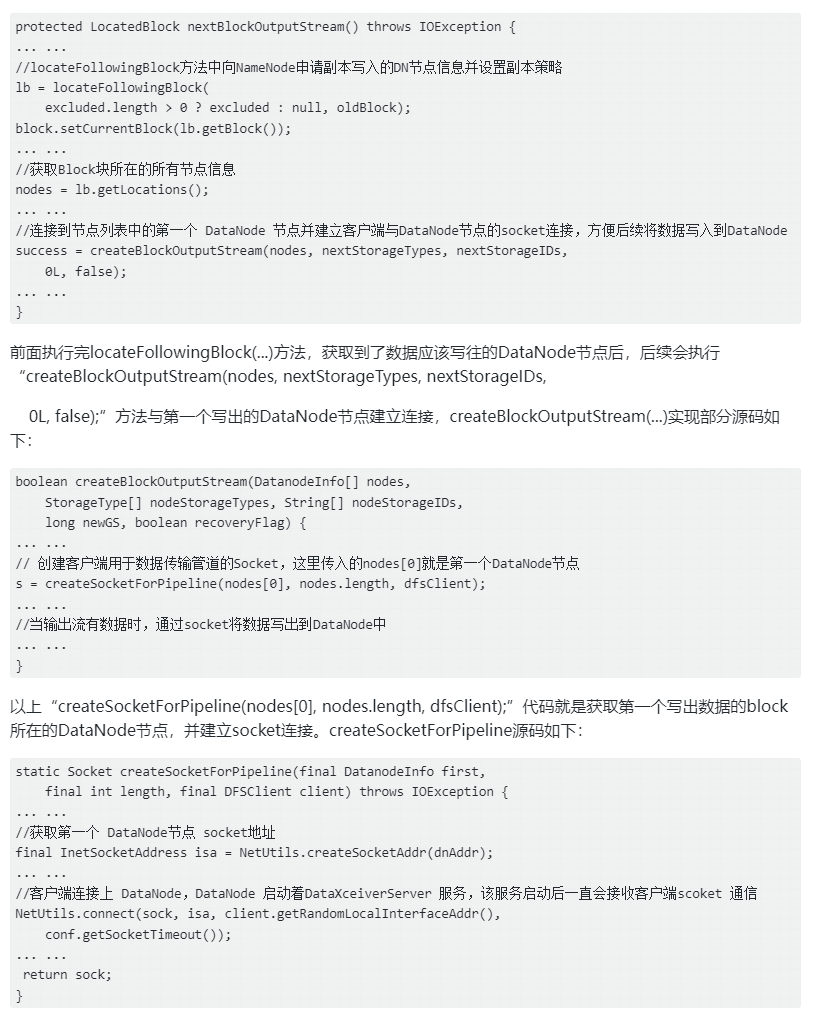
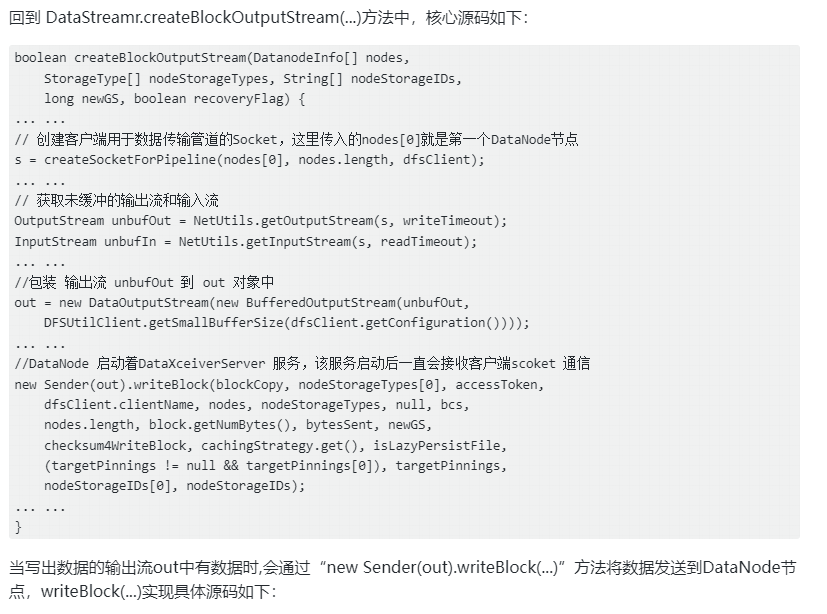
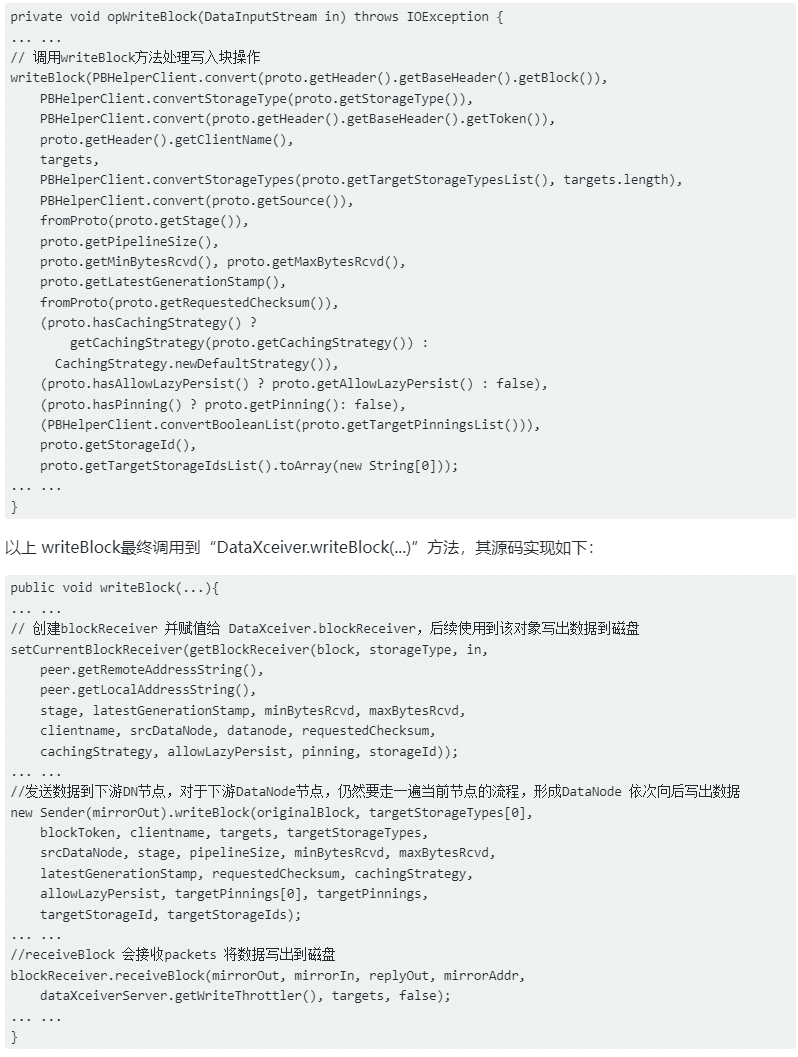
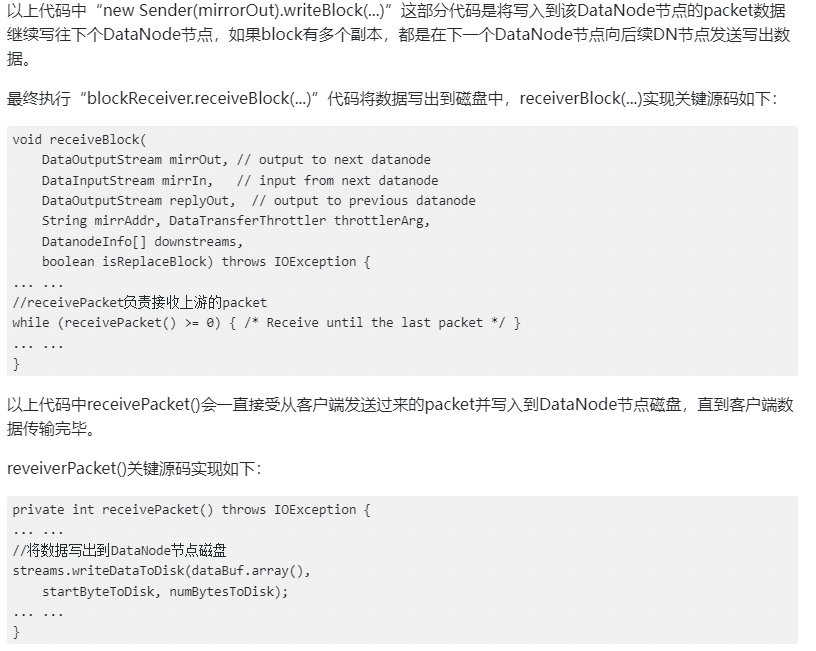
向Datanode中写入数据
数据读取源码
数据 从HDFS中读取数据代码如下:
java
public class ReadDataFromHDFS {
    public static void main(String[] args) throws IOException, InterruptedException {
        Configuration conf = new Configuration();

        //创建FileSystem对象
        FileSystem fs = FileSystem.get(URI.create("hdfs://node1:8020/"),conf,"root");

        //创建HDFS文件路径
        Path path = new Path("/test.txt");
        FSDataInputStream in = fs.open(path);


        //读取HDFS中数据
        BufferedReader br = new BufferedReader(new InputStreamReader(in));
        String newLine = "";
        while((newLine = br.readLine()) != null) {
            System.out.println(newLine);
        }

        //关闭流对象
        br.close();
        in.close();
    }
}
HDFS中数据读取源码相对简单,客户端从HDFS中获取文件数据时,首先会向NameNode获取文件相关的block信息,然后连接各个Datanode以流方式读取数据即可。
连接NameNode获取block信息
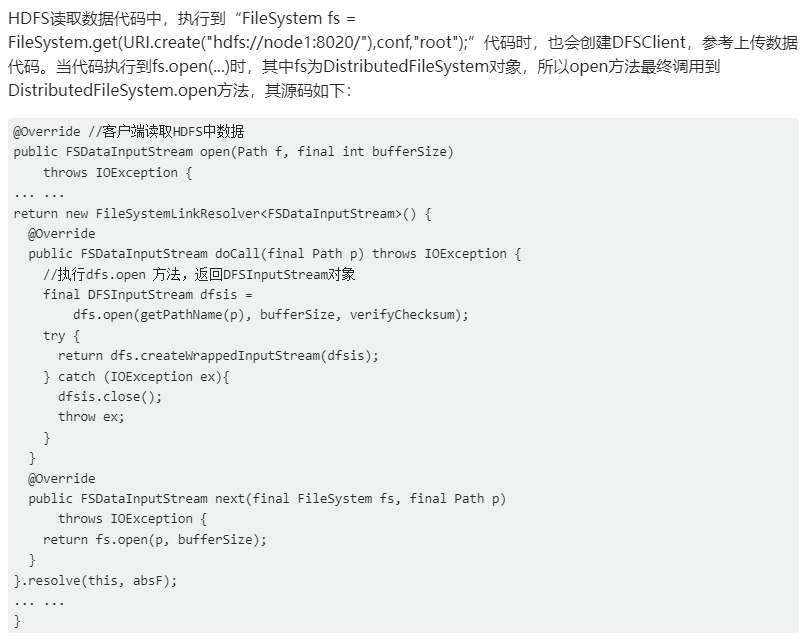
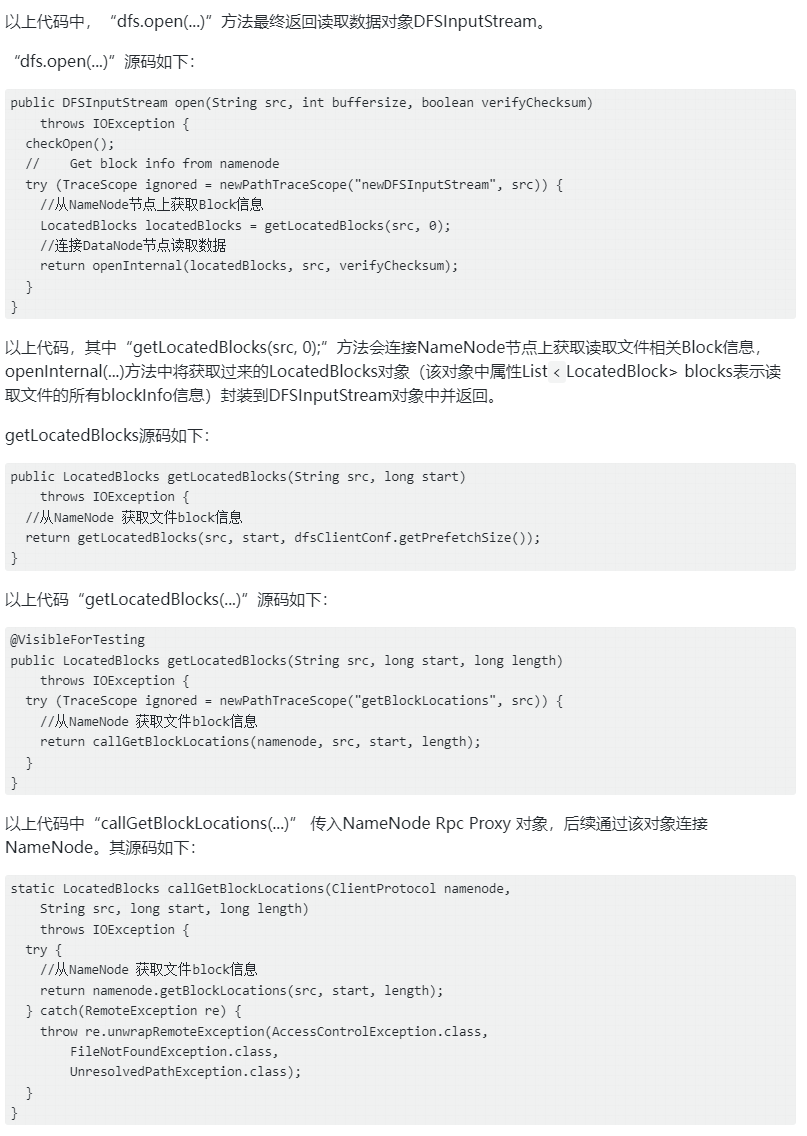
"namenode.getBlockLocations(src, start, length)"最终调用到NameNodeRpcServer.getBlockLocations(...)方法。
回到DFSClient.open()方法中,最终通过执行"return openInternal(locatedBlocks, src, verifyChecksum);"返回DFSInputStream对象。
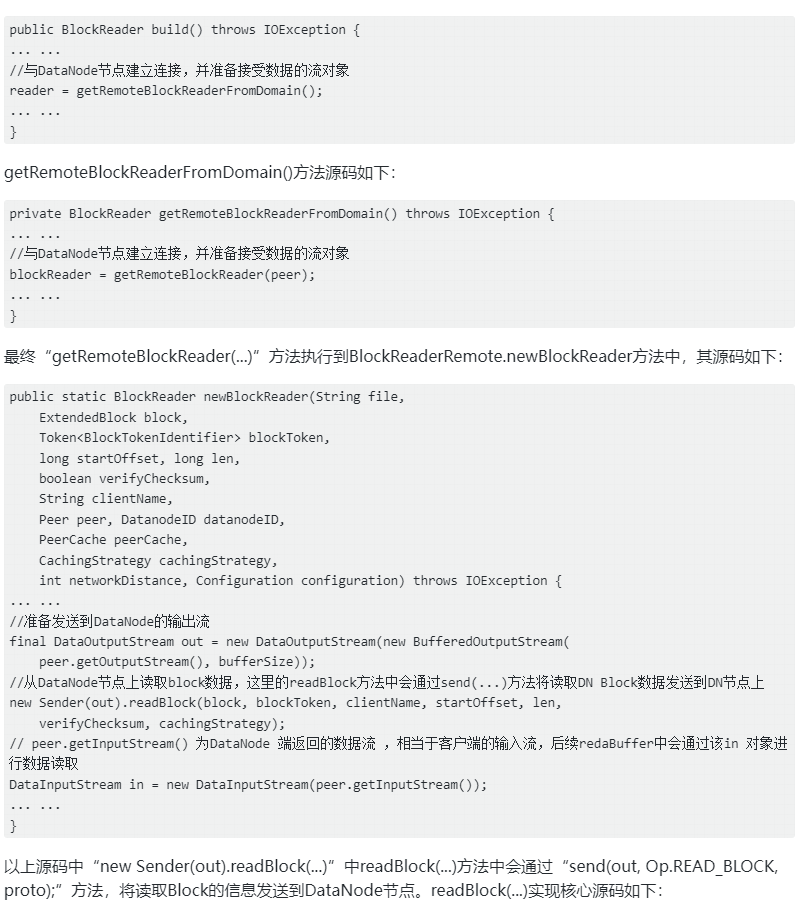
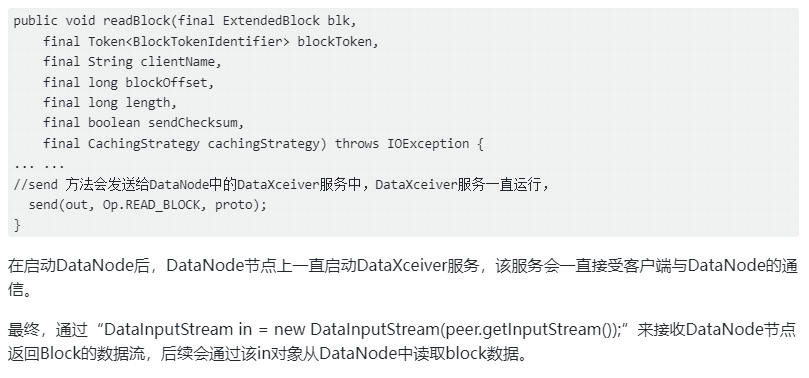
客户端通过socket连接DataNode
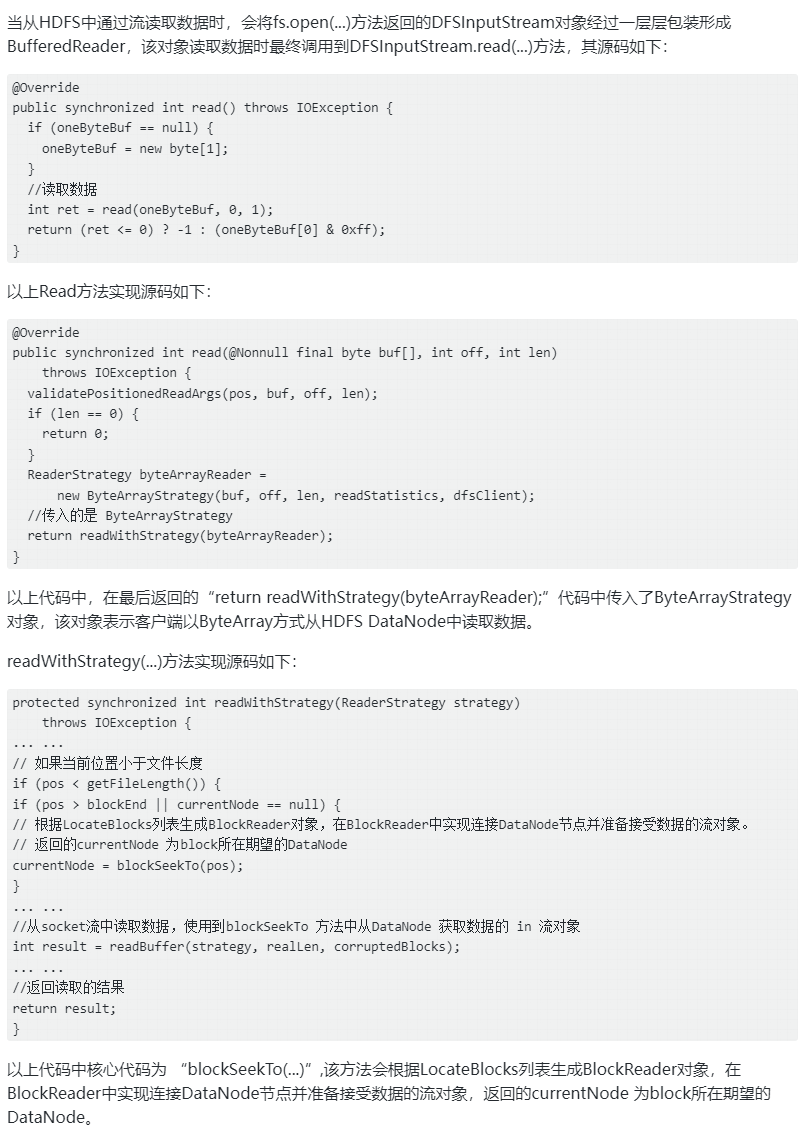
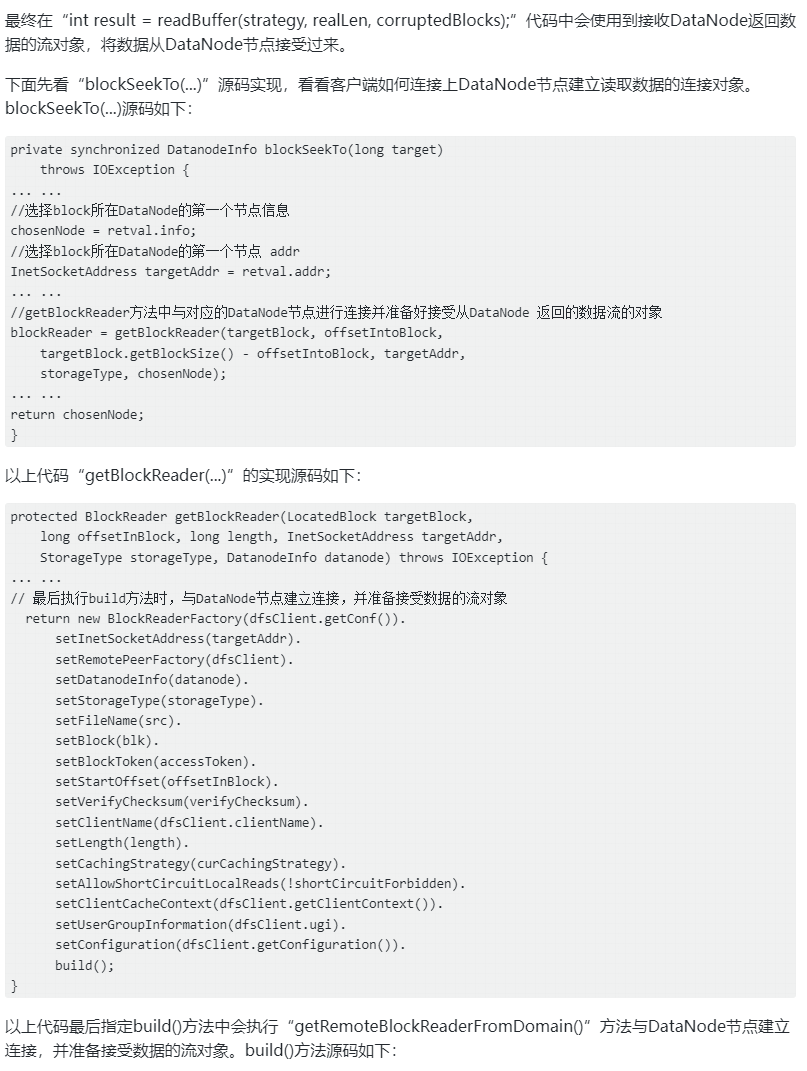
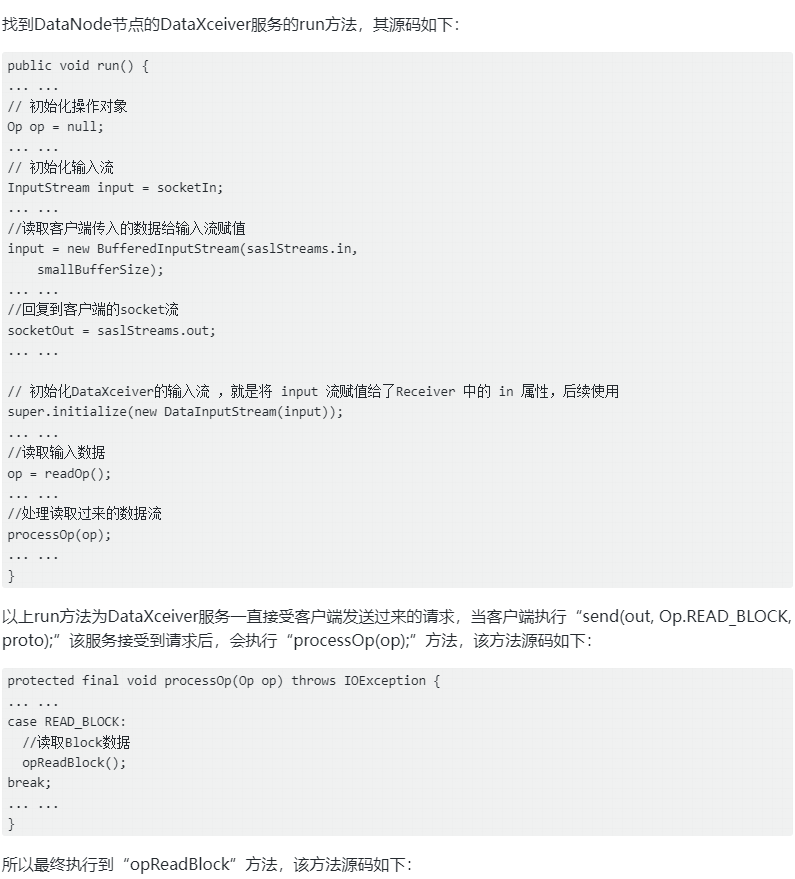
DataNode返回block数据流
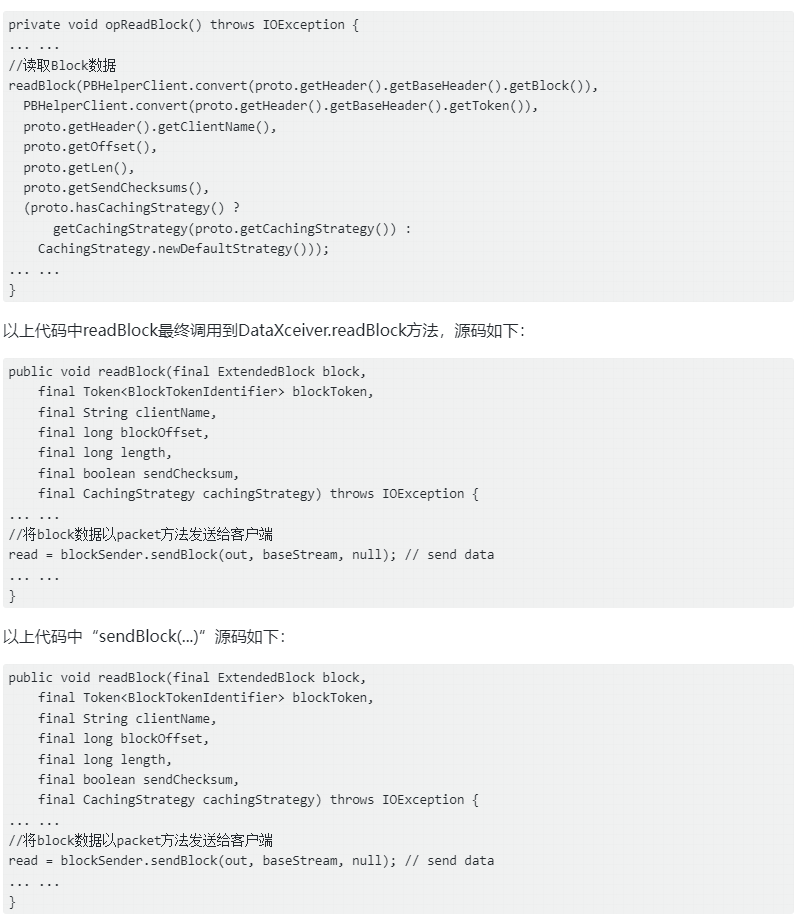
最终通过readBuffer(...)从DataNode中获取文件数据。