很多人一听"聚类"就开始背 K-means、肘部法、DBSCAN,但真正到了面试里,往往一开口就乱:有的人分不清聚类和分类,有的人只会说 K-means 的流程,却讲不清为什么 K 值难选;还有的人知道 DBSCAN 能找异常点,却说不明白它到底比 K-means 强在哪。其实,这一题的核心不是背名词,而是先建立一个清晰框架:聚类到底要解决什么问题、不同算法各自依赖什么假设、参数该怎么选、什么时候该换算法。
这篇文章就按面试最常见的追问顺序,把"聚类方法"从头讲清楚。你看完以后,至少能把下面这些问题讲顺:什么是聚类、聚类和分类有什么区别、K-means 怎么工作、K 怎么选、初始点为什么会影响结果、常用距离度量怎么选、DBSCAN 又是怎么回事。
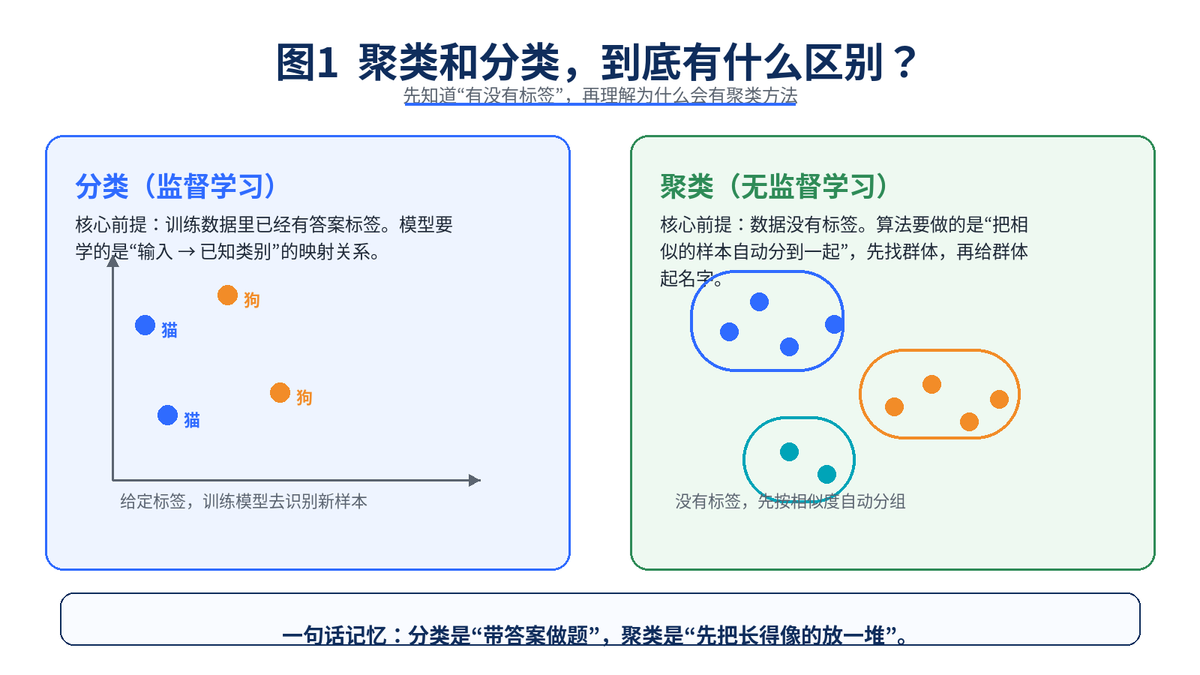
1. 什么是聚类?它和分类到底有什么区别?
1.1 聚类的本质:先分组,再理解人群
聚类,简单理解,就是把"看起来像一类"的样本自动放到一起。这里的"像不像",不是人眼拍脑袋判断,而是算法根据特征之间的距离、相似度或密度关系来判断。
它最典型的场景,是手里拿到一批没有标签的数据,但你又想先把人群、商品、文本、图片、轨迹按相似性做个归类。比如用户分群、商品分层、新闻主题发现、异常交易识别,很多时候第一步都不是"预测答案",而是"先把群体找出来"。
1.2 聚类和分类的区别
分类属于监督学习,前提是你已经知道答案标签。比如"这封邮件是垃圾邮件还是正常邮件",训练集里本来就有"垃圾/正常"的答案,模型做的是学会复现这个答案。
聚类属于无监督学习,数据里一开始没有标签。算法只能根据样本之间的相似性,把相近的样本归成一组。至于这组人到底叫"高价值客户""价格敏感用户"还是"夜间活跃人群",往往要在聚类之后,再结合业务去解释。
1.3 面试里最稳的一句话
如果面试官问"简述聚类和分类的区别",一个很稳的回答是:分类是带标签学习,目标是预测已知类别;聚类是不带标签分组,目标是发现数据内部结构。
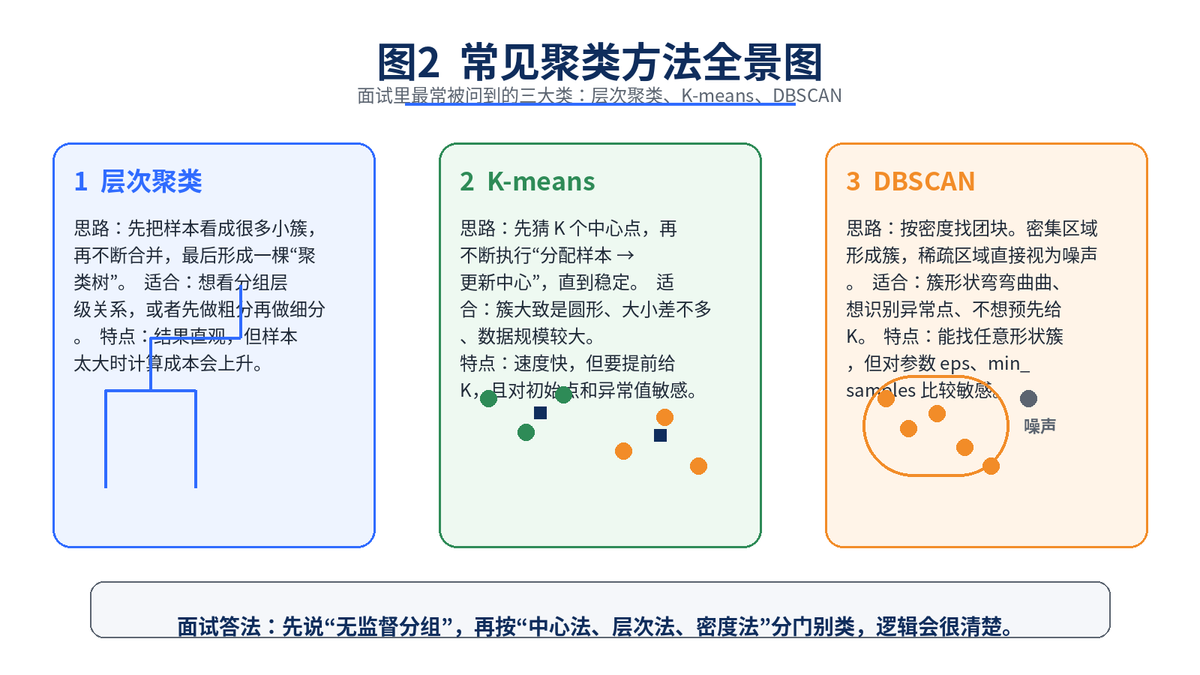
2. 聚类方法有哪些?先建立一张全景图
2.1 层次聚类:一步一步合并,最后长成一棵树
层次聚类可以理解成"从碎片到整体"的分组方式。最常见的是凝聚式层次聚类:一开始每个样本都是一个小簇,然后不断找最相近的两个簇合并,直到合并成若干个大簇,或者直接合成一棵完整的聚类树。scikit-learn 的 AgglomerativeClustering 文档就把它概括为"递归地合并样本簇,并使用 linkage distance 来衡量簇间距离"。
它的好处是直观,特别适合需要观察层级关系的时候。比如你不只是想知道"分成几类",还想看"哪两类最像、哪几类属于同一大类",层次聚类就很好用。缺点是数据一大,计算量通常比 K-means 更重。
2.2 K-means:围着中心点分组
K-means 是聚类里最常见、面试里最常考的一种方法。它的想法非常朴素:先给定 K 个中心,再让每个样本归到离自己最近的中心上,接着重新计算每个簇的中心,反复迭代,直到结果稳定。Google 的官方聚类课程把它概括成:通过最小化样本到所属簇中心的距离,把数据分成 K 个簇。
它的优点是快、简单、工程上常用;缺点是要先给 K,而且默认更适合大小差不多、形状比较"圆"的簇。
2.3 DBSCAN:哪里密集,哪里成团
DBSCAN 是密度聚类的代表。它不是靠中心点来分,而是靠"密不密"。如果某个区域点很多、足够拥挤,就从那里开始向周围扩张,形成一个簇;如果某些点周围很稀疏,就把它们当成噪声点。
它最大的亮点有两个:第一,不需要提前指定 K;第二,可以找到任意形状的簇。官方文档也明确指出,DBSCAN 能找到任意形状的簇,并把低密度区域的点识别为噪声。
2.4 面试时怎么讲这三类方法
一个清晰的讲法是:聚类方法大致可以分成三类------层次聚类看层级关系,K-means 看中心点分组,DBSCAN 看密度成团。然后再往下展开每种方法的假设、优点、限制和适用场景。
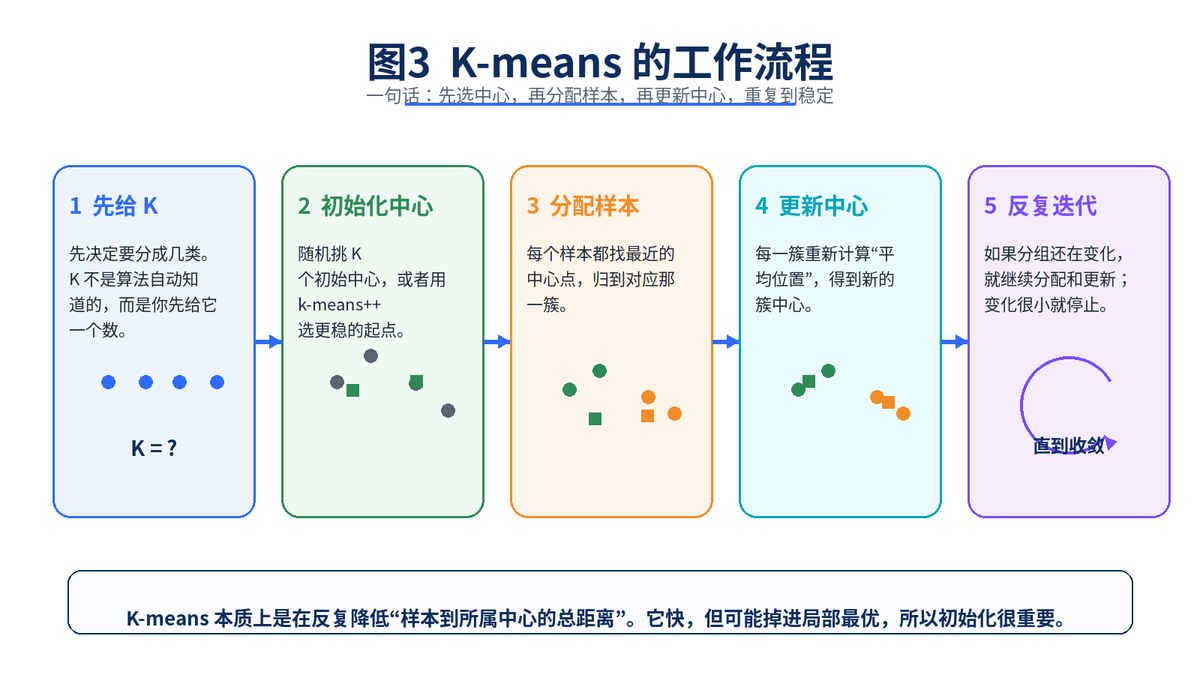
3. 什么是 K-means?原理到底是什么?
3.1 先给 K,再找 K 个中心
K-means 的第一步,不是"自动发现一切",而是你先告诉它:我希望分成 K 类。这个 K 就像你先给算法一个框架。比如用户运营里,你先假设可以分成 3 群、5 群或者 8 群,再让算法去试。
3.2 每个样本都归到最近的中心
算法拿到 K 个初始中心以后,会计算每个样本离哪个中心最近,然后把样本放进那个簇里。你可以把它想象成商场选最近门店、学生选最近考场,本质都是"就近分配"。
3.3 再重新计算每一簇的新中心
分配完以后,每个簇里的样本位置可能并不围绕原来的中心,所以算法会重新算一次"平均位置",这个平均位置就是新的中心。然后再用新的中心去重新分配样本。
3.4 反复做,直到结果基本不变
如果这一轮分完以后,样本分组几乎不再变化,或者误差下降已经很小,算法就停下来。这就是 K-means 的完整闭环:初始化中心、分配样本、更新中心、反复迭代,直到收敛。
3.5 K-means 的优点和短板
优点很明显:实现简单,速度快,扩展到大数据量也比较友好。Google 官方课程明确提到,K-means 的扩展性较好,适合较大的数据集。
但它也有几个硬伤:第一,要先给 K;第二,对初始中心敏感;第三,对离群点比较敏感;第四,默认更适合球状、凸状、大小相近的簇。要是数据天然是长条形、月牙形、密度差异很大的团块,K-means 往往就不太合适。
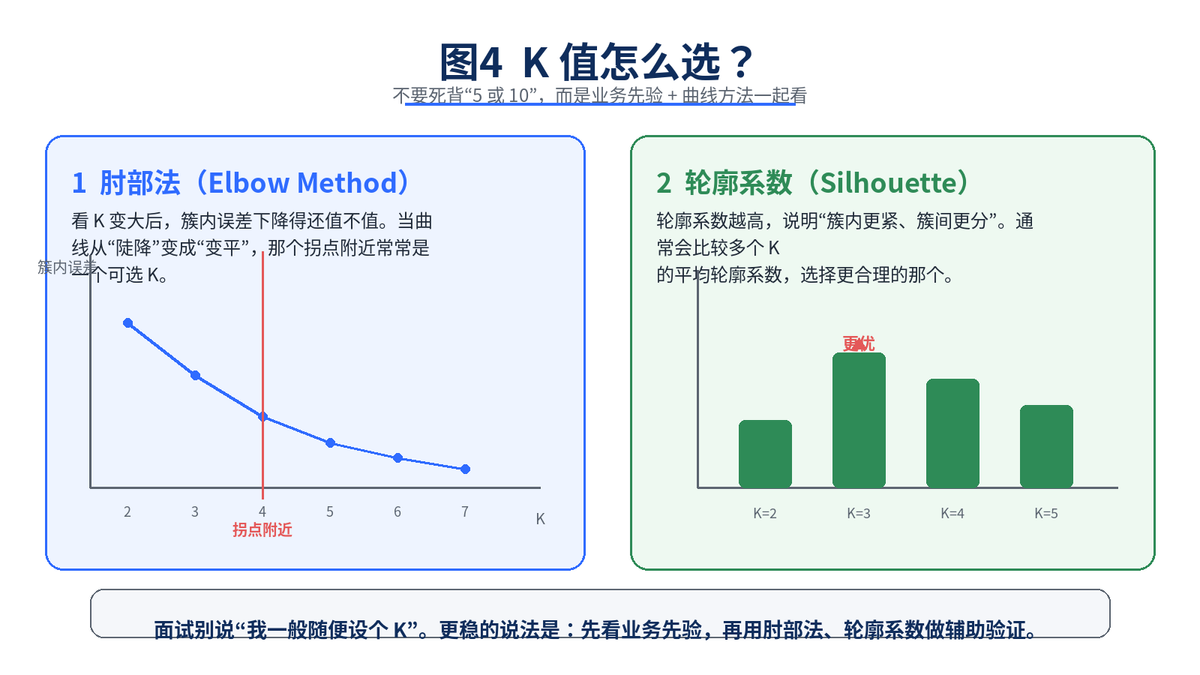
4. K-means 里的 K 一般怎么取?
4.1 先有业务,再有算法
很多人一上来就问"K 取几最好",这其实问得有点太抽象。K 不是从天上掉下来的,它往往先受业务约束。比如运营部门只打算做 4 套人群策略,那你就不会真的去考虑 17 群;再比如市场团队要做高、中、低三层客户分层,那 K=3 本身就有强业务先验。
4.2 肘部法:看误差下降是不是开始变慢
肘部法的思路很直观:随着 K 增大,簇会变得更细,簇内误差通常会下降。但 K 不可能无限加,因为 K 越大,模型越复杂,解释也越差。于是我们看曲线有没有一个明显"拐点",也就是从"降得很快"变成"继续加 K 收益有限"的位置。那个地方附近,常常是一个合理候选值。
4.3 轮廓系数:看簇内紧不紧、簇间分不分
轮廓系数本质上是在看两件事:同一簇里的样本是不是够近,不同簇之间是不是够远。scikit-learn 的 silhouette_score 文档指出,轮廓系数越高,通常表示簇内更紧密、簇间更分离。
所以,实践里经常会试几个不同的 K,然后比较平均轮廓系数。如果某个 K 既让簇内样本更像自己人,又和别的簇拉开距离,那它通常更可取。
4.4 别把 K 的选择神化
要注意,K 的选择没有万能答案。肘部法有时拐点不明显,轮廓系数也可能和业务解释不一致。所以更稳的说法不是"我总用某个固定 K",而是"我会结合业务先验、肘部法、轮廓系数和结果可解释性综合判断"。
5. K-means 的初始点为什么会影响结果?
5.1 因为 K-means 可能陷入局部最优
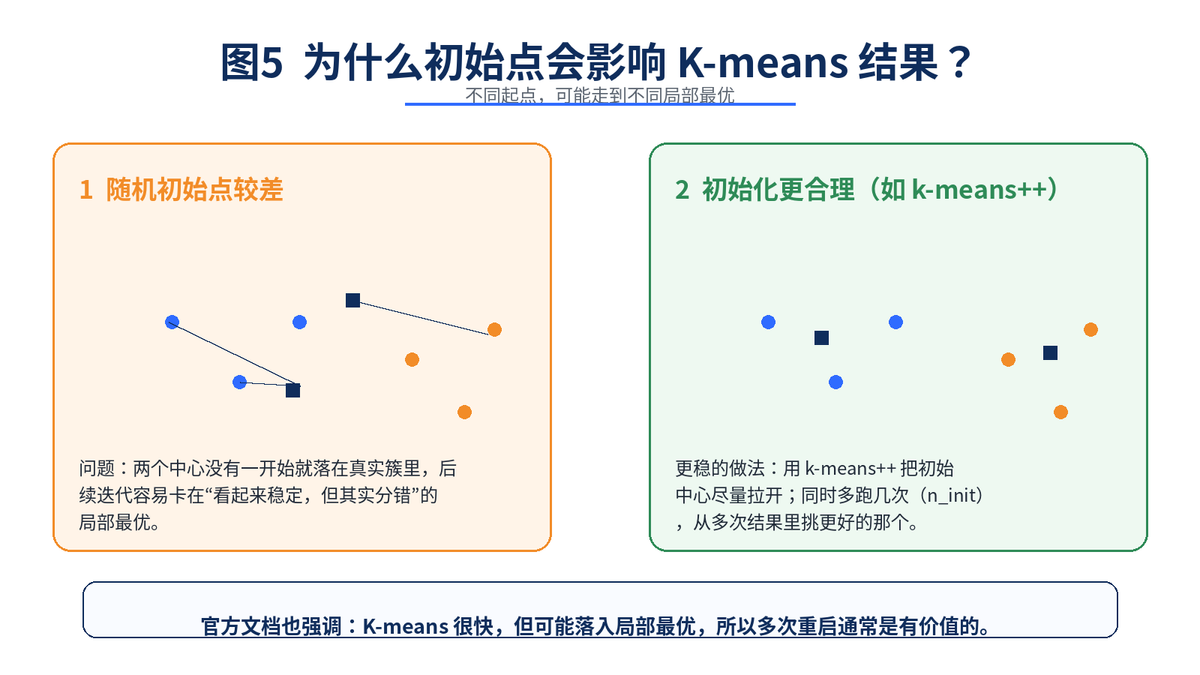
K-means 虽然会收敛,但它不一定收敛到全局最优。说白了就是:它会停下来,但不保证停在最好的位置。官方文档也提到,K-means 很快,但可能落入 local minima,也就是局部最优。
如果一开始选的中心点很差,比如两个中心都落在同一个真实簇附近,那后面的样本分配和中心更新,很可能一路都沿着错误方向走,最后稳定在一个不够好的结果上。
5.2 为什么 k-means++ 更稳
k-means++ 的核心想法,是让初始中心尽量分散一点,不要一上来就扎堆。这样选出来的起点,通常比完全随机更稳。scikit-learn 的 KMeans 文档也说明了 n_init 的意义:会用不同的初始中心多跑几次,再从多次结果里选最好的。
5.3 面试里怎么回答初始化问题
你可以这样说:初始点会影响 K-means 的收敛路径,进而影响最终结果,因为它可能掉进局部最优。常见改进方式是使用 k-means++ 初始化,并增加多次重启次数,从多次结果中挑更优解。
6. K-means 中常用的距离度量有哪些?
6.1 欧氏距离:最经典,也最符合 K-means 直觉
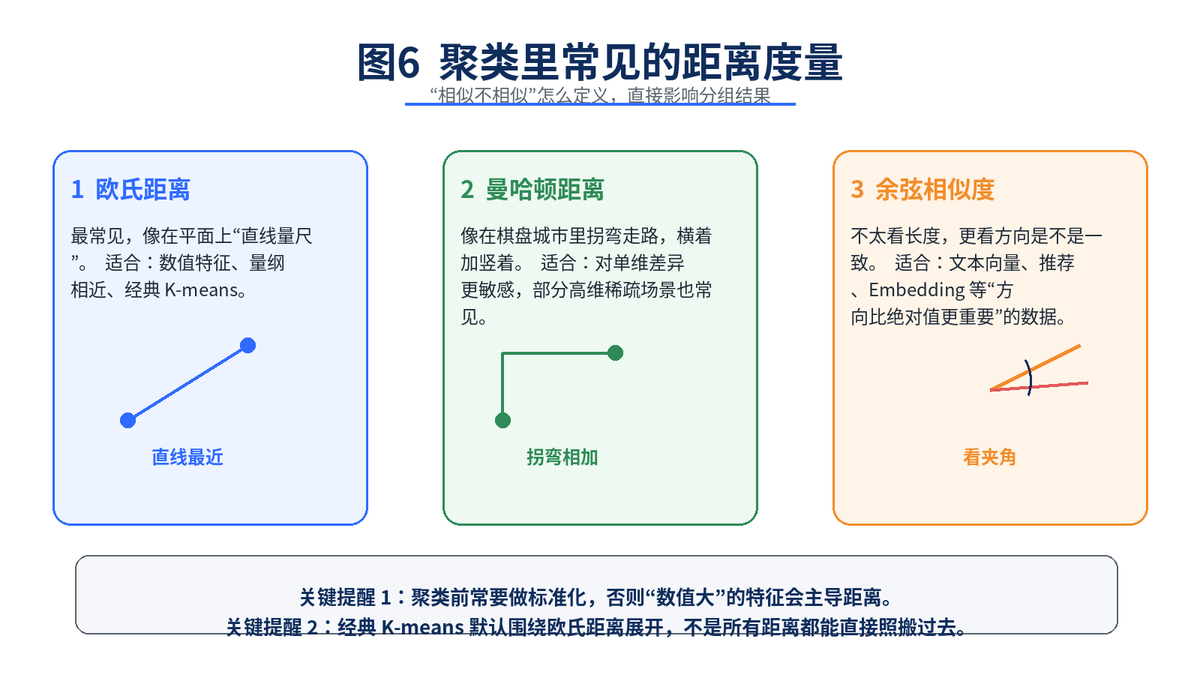
欧氏距离就是我们最熟悉的"直线距离"。在二维平面里,它就是两个点之间拉一条直线的长度。在经典 K-means 里,最常见、也最自然的距离度量就是欧氏距离。因为 K-means 的中心本质上是"均值",而均值和平方欧氏距离天然是配套的。
6.2 曼哈顿距离:横着走再竖着走
曼哈顿距离更像在棋盘城市里走路,先横着走一段,再竖着走一段,总长度就是距离。它对每个维度的偏差更直接,某些高维稀疏数据里会比欧氏距离更稳定。
6.3 余弦相似度:更看方向,而不是长度
余弦相似度常出现在文本向量、推荐系统和 Embedding 场景里。它不太关心向量有多长,而更关心两个向量是不是"朝着同一个方向"。比如两篇文章长短不同,但主题很接近,余弦相似度可能会更合适。
6.4 为什么聚类前常要做标准化
因为距离会被量纲支配。假设一个特征范围是 0 到 1,另一个特征范围是 0 到 100000,那后者在计算距离时会天然更有"话语权"。最终聚类结果看起来像是在用所有特征,实际上可能只被数值特别大的那几个特征主导。
所以面试里如果被问到"聚类前要不要做标准化",很稳的回答是:通常要做,尤其是在不同特征量纲差异很大时。
6.5 一个容易丢分的细节
很多人会说"距离度量有很多种,所以 K-means 可以随便换"。这个说法不够严谨。更准确的讲法是:聚类里常见距离度量很多,但经典 K-means 最自然地围绕欧氏距离展开;如果你真的想换相似度定义,往往就不再是最原教旨的 K-means 了。
7. 简述密度聚类算法 DBSCAN
7.1 它不围着中心转,而是围着"密度"转
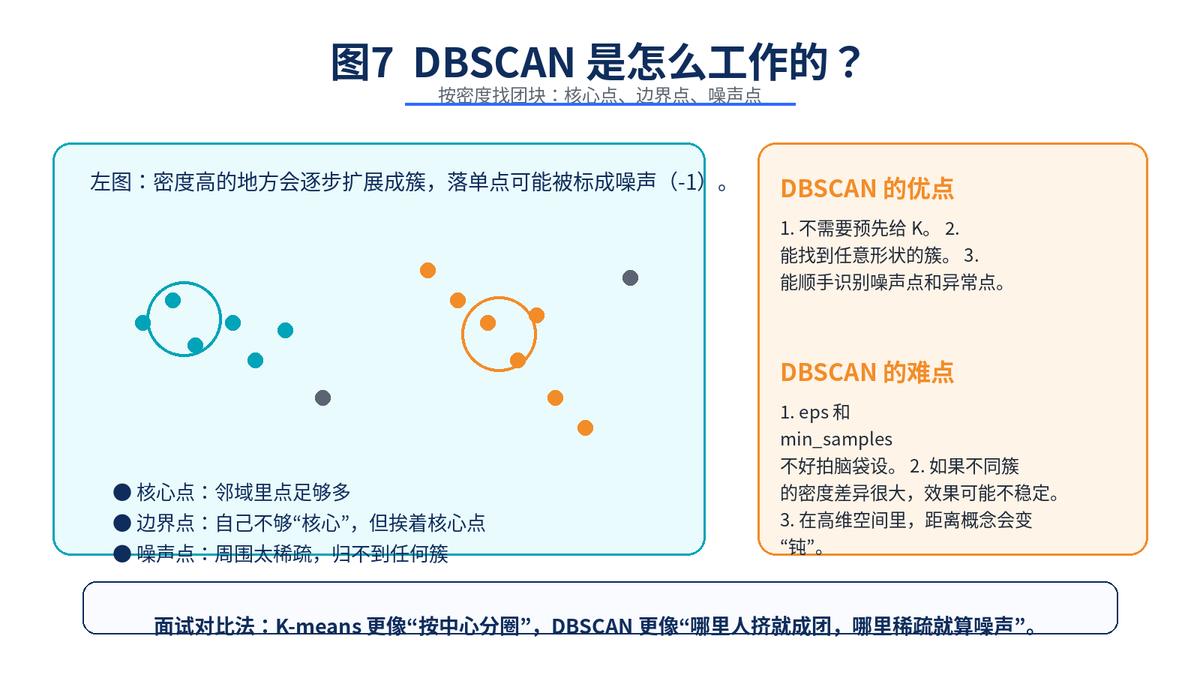
DBSCAN 的全称是 Density-Based Spatial Clustering of Applications with Noise。名字虽然长,但思想很朴素:一个地方如果点够密,就把它看作一个簇;如果某个点周围一直很稀,就把它当噪声。
7.2 核心点、边界点、噪声点怎么理解
你可以把一个点周围想象成一个小圈。如果这个小圈里邻居很多,它就是核心点;如果它自己邻居不够多,但挨着某个核心点,它就是边界点;如果它既不密集、也不靠近密集区域,那它就是噪声点。
7.3 DBSCAN 的优点
第一,不需要提前指定聚类个数;第二,能找到任意形状的簇,不像 K-means 那样更偏好球状簇;第三,可以顺手把异常点识别出来。官方文档明确提到,DBSCAN 尤其适合相似密度的数据簇,并且能识别噪声点。
7.4 DBSCAN 的难点
它也不是银弹。最常见的问题有两个:一是参数 eps 和 min_samples 不好定;二是如果不同簇的密度差异很大,它可能会顾此失彼。再加上高维空间里"距离"本身会变得不那么好用,所以 DBSCAN 在高维数据上也未必总是理想。
7.5 K-means 和 DBSCAN 怎么对比
可以这样记:K-means 是"按中心分圈",DBSCAN 是"按密度成团"。如果你知道要分成几类,而且数据分布比较规整、量大、想跑得快,K-means 往往更合适;如果你不知道该分几类,或者数据里有噪声、有不规则形状,DBSCAN 通常更值得一试。
8. 面试高分回答模板:聚类方法这道题,怎么讲最顺?
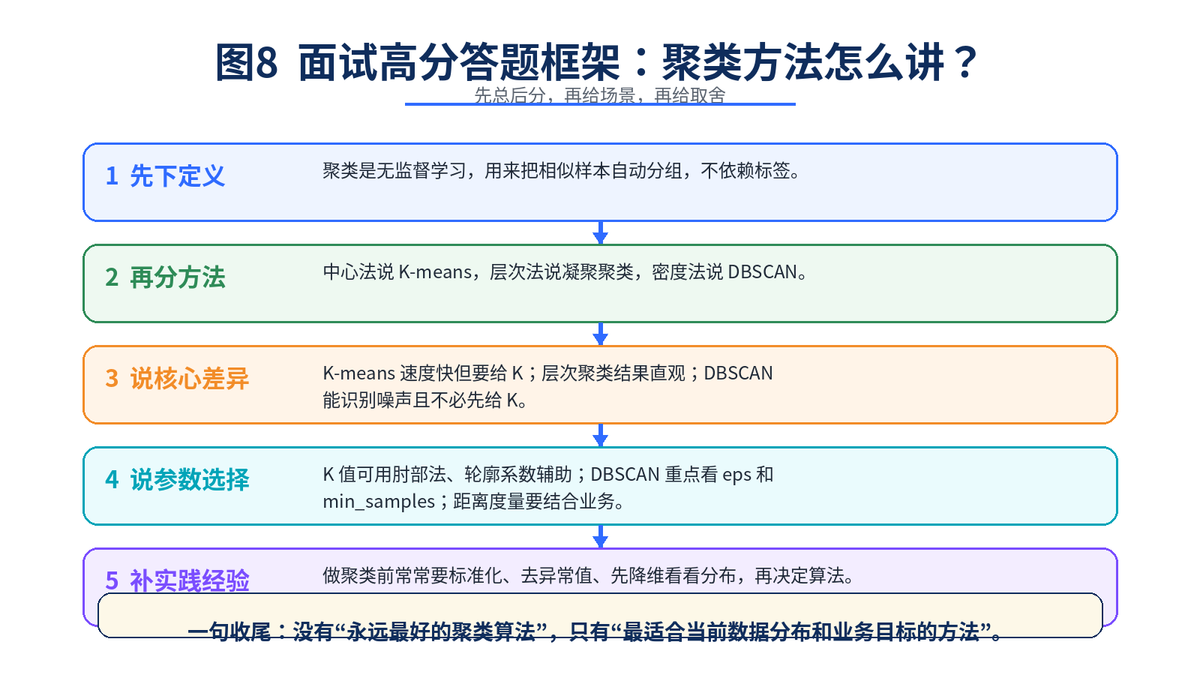
一个适合口头表达的版本可以这样说:
• 聚类是无监督学习,目标是在没有标签的情况下,把相似样本自动分到一起。
• 常见方法可以分为三类:层次聚类、中心法代表 K-means、密度法代表 DBSCAN。
• K-means 的核心是给定 K 个中心,反复执行样本分配和中心更新,直到收敛;它速度快,但要先给 K,对初始化和异常值敏感。
• K 的选择通常结合业务先验、肘部法、轮廓系数来综合判断,不存在一刀切答案。
• 初始点会影响 K-means 的结果,因为算法可能陷入局部最优,所以常用 k-means++ 和多次重启来增强稳定性。
• 距离度量会直接影响聚类结果,经典 K-means 更适合欧氏距离;聚类前通常需要标准化。
• DBSCAN 不需要预设 K,能识别任意形状簇和噪声点,但对参数和密度差异比较敏感。
9. 总结:别把聚类当成只会背 K-means 的题
很多人学聚类,只记住了"选 K、算中心、重复迭代",但真正拉开面试差距的,不是你会不会背流程,而是你能不能把"方法假设"和"适用场景"讲出来。
真正成熟的回答,应该至少包含四层意思:第一,聚类是无监督分组,不是分类;第二,方法可以按中心法、层次法、密度法来拆;第三,K-means 的关键问题是 K、初始化和距离度量;第四,DBSCAN 适合不规则形状和含噪声的数据。
你把这四层说清楚,再补一句"没有永远最好的聚类算法,只有更适合当前数据分布和业务目标的方法",这道题基本就稳了。