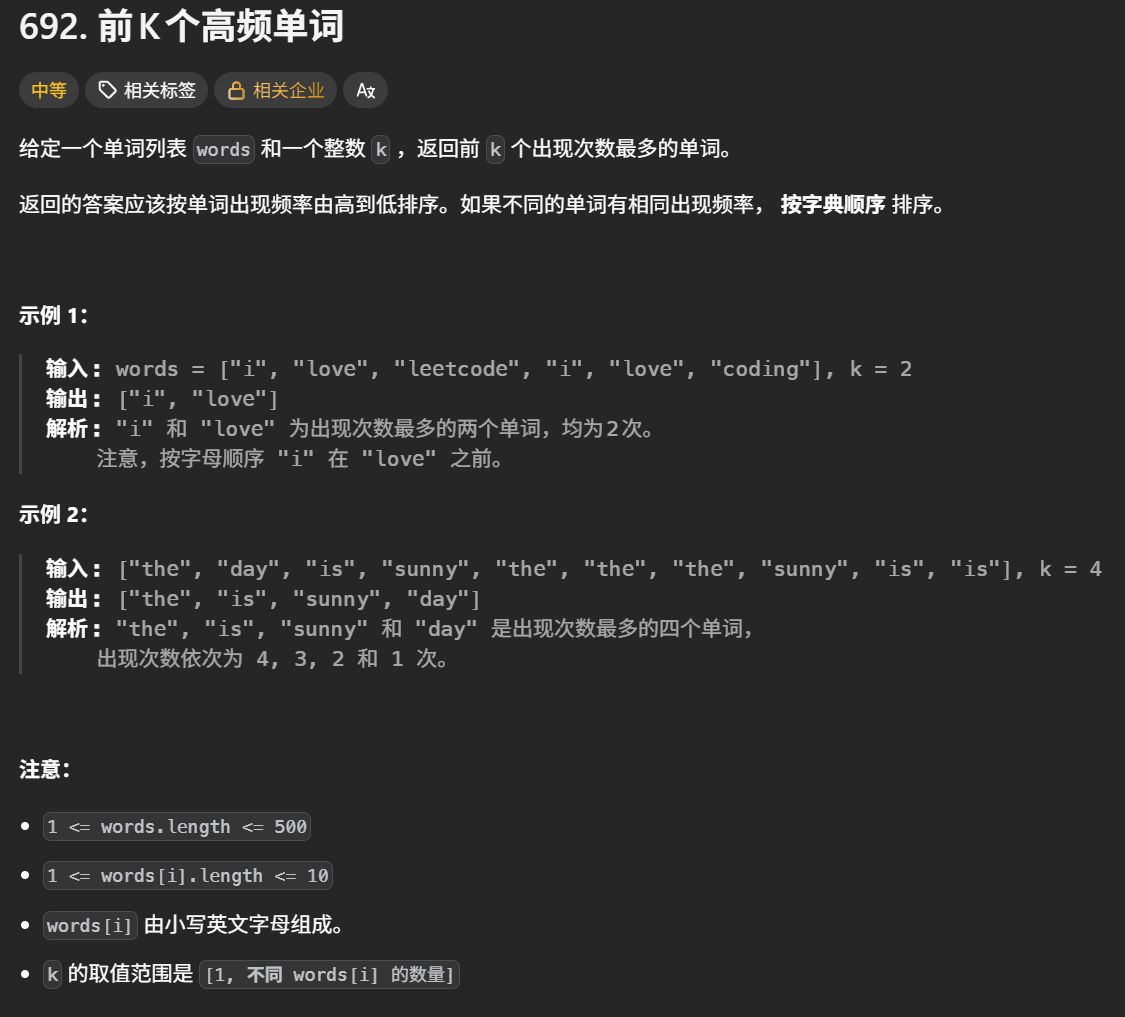
思路:在优先队列(堆)的基础上,增加了字典序大小的比较。使用哈希表 + 优先队列求解。
一、具体步骤:
1.使用哈希表来统计所有的词频。
2.构建大小为k的按照"词频升序 + (词频相同)字典序倒序"的优先队列:
(1)如果词频不相等,根据词频进行升序构建,保证堆顶元素是堆中词频最小的元素。
(2)如果词频相等,根据字典序的大小进行倒序构建,最终确保堆顶元素是堆中"词频最小 & 字典序最大"的元素。
3.对所有的元素进行遍历,尝试入堆:
(1)堆内元素不足K个时:直接入堆。
(2)词频大于堆顶元素时:将堆顶元素弹出,并将当前元素添加到堆中。
(3)词频小于堆顶元素时:当前元素不可能是前K大的元素,直接丢弃。
(4)词频等于堆顶元素时,根据当前元素与堆顶元素的字典序大小决定(如果字典序大小比堆顶元素要小则入堆)。
4.输出堆内元素,并翻转。
二、复杂度分析:
1.时间复杂度:
(1)使用哈希表统计词频,复杂度为O(n)。
(2)使用最多n个元素维护一个大小为k的堆,复杂度为O(nlogk)。
(3)输出答案的复杂度为O(k)(同时k <= n)。
因此整体的时间复杂度为O(nlogk)。
2.空间复杂度:O(n)。
HashMap里存放的数据是{单词String,词频Integer}。
heap里存放的数据是{词频Integer,单词String}。
附代码:
java
class Solution {
    public List<String> topKFrequent(String[] words, int k) {
        Map<String,Integer> map = new HashMap<>();
        // 词频统计
        for(String w : words){
            map.put(w,map.getOrDefault(w,0) + 1);
        }
        // 使用Object[]是为了不用定义新类就实现在一个数组内存放多种类型
        // 优先队列的初始容量为k,(a,b)是比较器,定义优先级规则
        PriorityQueue<Object[]> heap = new PriorityQueue<>(k,(a,b) -> {
            // 如果词频不同,按照词频升序排列(从小到大排)
            int c1 = (Integer)a[0],c2 = (Integer)b[0];
            if(c1 != c2){
                return c1 - c2;
            }
            // 如果词频相同,根据字典序倒序排列(从大到小排)
            String s1 = (String)a[1],s2 = (String)b[1];
            // s2.compareTo(s1) > 0表示s2 > s1,所以实现了倒序排列
            return s2.compareTo(s1);
        });
        for(String word : map.keySet()){
            int count = map.get(word);
            if(heap.size() < k){ // 不足k个,直接入堆
                heap.add(new Object[] {count,word});
            }else{
                Object[] peek = heap.peek();
                if(count > (Integer)peek[0]){ // 词频比堆顶元素大,弹出堆顶元素,当前元素入堆
                    heap.remove();
                    heap.add(new Object[]{count,word});
                }else if(count == (Integer)peek[0]){ // 词频与堆顶元素相同
                    String topWord = (String)peek[1];
                    if(word.compareTo(topWord) < 0){ // 且字典序大小比堆顶元素小,弹出堆顶元素,入堆
                        heap.remove();
                        heap.add(new Object[] {count,word});
                    }
                }
            }
        }
        List<String> ans = new ArrayList<>();
        while(!heap.isEmpty()){
            ans.add((String)heap.remove()[1]);
        }
        // 倒序收集,得到答案(词频从高到低排列,词频相同时字典序从低到高排列)
        // Collections.reverse()用于将List中的元素顺序反转(Collections是数组的工具箱,可以排序、反转、随机打乱、最大值、最小值、交换位置、全部填充、复制等)
        // 因为堆是最小堆,remove()出来的元素是优先级最低的元素
        Collections.reverse(ans);
        return ans;
    }
}
ACM模式:
java
import java.util.*;

class Solution {
    public List<String> topKFrequent(String[] words, int k) {
        Map<String, Integer> map = new HashMap<>();
        // 词频统计
        for (String w : words) {
            map.put(w, map.getOrDefault(w, 0) + 1);
        }

        // 使用Object[]是为了不用定义新类就实现在一个数组内存放多种类型
        // 优先队列的初始容量为k,(a,b)是比较器,定义优先级规则
        PriorityQueue<Object[]> heap = new PriorityQueue<>(k, (a, b) -> {
            // 如果词频不同,按照词频升序排列
            int c1 = (Integer) a[0], c2 = (Integer) b[0];
            if (c1 != c2) {
                return c1 - c2;
            }
            // 如果词频相同,根据字典序倒序排列
            String s1 = (String) a[1], s2 = (String) b[1];
            // s2.compareTo(s1) > 0表示s2 > s1,所以实现了倒序排列
            return s2.compareTo(s1);
        });

        for (String word : map.keySet()) {
            int count = map.get(word);
            if (heap.size() < k) { // 不足k个,直接入堆
                heap.add(new Object[]{count, word});
            } else {
                Object[] peek = heap.peek();
                if (count > (Integer) peek[0]) { // 词频比堆顶元素大,弹出堆顶元素,当前元素入堆
                    heap.remove();
                    heap.add(new Object[]{count, word});
                } else if (count == (Integer) peek[0]) { // 词频与堆顶元素相同
                    String topWord = (String) peek[1];
                    if (word.compareTo(topWord) < 0) { // 且字典序大小比堆顶元素小,弹出堆顶元素,入堆
                        heap.remove();
                        heap.add(new Object[]{count, word});
                    }
                }
            }
        }

        List<String> ans = new ArrayList<>();
        while (!heap.isEmpty()) {
            ans.add((String) heap.remove()[1]);
        }
        // 倒序收集,得到答案(词频从高到低排列,词频相同时字典序从低到高排列)
        Collections.reverse(ans);
        return ans;
    }
}

public class Main {
    public static void main(String[] args) {
        Scanner scanner = new Scanner(System.in);

        // 读取单词数组(一行,用空格分隔)
        String[] words = scanner.nextLine().split(" ");

        // 读取 k 值
        int k = scanner.nextInt();

        // 计算结果
        Solution solution = new Solution();
        List<String> result = solution.topKFrequent(words, k);

        // 输出结果(按照题目要求的格式)
        System.out.println(result);

        scanner.close();
    }
}