国家超算中心 htc 如果只有gpu资源 没有cpu资源 操作文件的时候会不会很卡呢
查看拥有的计算资源
bash
https://www.scnet.cn/ui/console/index.html#/my-product/basic-resources/computing-cesource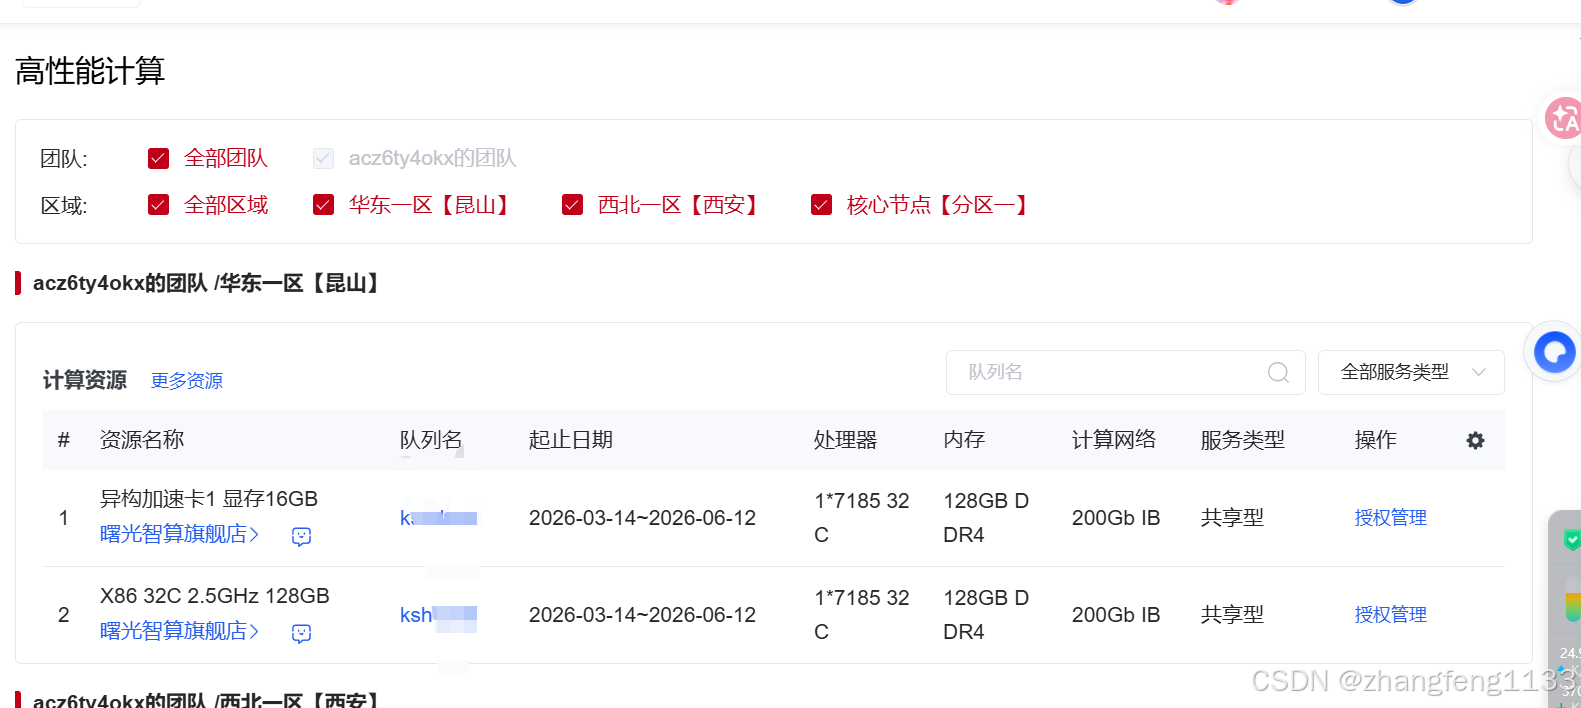
结论先说:只占用GPU、CPU核数给得极少,操作本地/共享文件一定会卡,尤其大模型数据集读写、小文件密集场景卡顿非常明显。
一、原因拆解
- 文件IO全靠CPU负责,GPU不接管磁盘读写
GPU只做张量运算、模型推理/训练;磁盘读文件、解压、遍历文件夹、open()、os.listdir、pandas读csv、图片加载全走CPU+内存,没有富余CPU核心,系统调度排队、IO阻塞。
- 你两套机器配置:
- kshdtest:32C CPU + 1张16G加速卡(异构卡机型)
- kshctest:纯X86 32C无GPU
若提交任务只申请GPU、不申请CPU核心,调度只分配零星CPU,文件读写瓶颈直接锁CPU。
- 超算HTC队列(Slurm/PBS类调度)资源绑定规则
HTC作业是CPU核、内存、GPU捆绑分配:只勾选GPU,调度默认仅分配1~2个CPU核、少量内存,文件多线程遍历、批量加载数据集瞬间占满CPU,IO等待飙升。 - IB高速网卡也要CPU驱动收发
200Gb IB互联的共享存储、并行文件系统(Lustre/DDN),数据从存储→内存仍靠CPU做协议解析,CPU不足再快的IB带宽也跑不满、读写卡顿。
二、两种资源场景卡顿区分
- 小文件海量场景(图片数据集、txt标注):最卡,频繁open/close消耗大量CPU系统调用;
- 大文件顺序读(单个几十GB bin/npy):轻微卡顿,瓶颈在CPU做数据预处理、从内存拷向GPU显存。
三、你现有队列优化方案(kshdtest/kshctest)
1. 提交作业强制绑定CPU+GPU,不要只申GPU
提交脚本同时申请:--cpus-per-task=4~8 --mem=16G --gres=gpu:1
32C整机共享机型,单任务拿4~8核是最优配比,预留CPU给IO。
2. 大模型训练优化规避文件卡顿
- 数据集提前预处理打包成二进制(lmdb/webdataset),减少小文件;
- 使用内存缓存:小数据集先load进CPU内存再喂GPU;
- 优先kshdtest队列(自带CPU+GPU一体),不要用纯X86 kshctest做训练。
3. 临时调试交互
交互式debug如果只开GPU无CPU:用screen+提前把文件拷到本地SSD,避开共享存储IO。
四、补充:什么时候只GPU不卡?
只有已经全部数据加载进显存,全程不再读磁盘文件的纯前向推理,才不会因为缺CPU卡顿;只要涉及文件操作必受CPU限制。
需要我帮你写一份适配曙光Slurm的提交脚本模板吗?