论文信息
| 项目 | 内容 |
|---|---|
| 标题 | CrossLMM: Decoupling Long Video Sequences from LMMs via Dual Cross-Attention Mechanisms |
| 作者 | Shilin Yan, Jiaming Han, Joey Tsai, Hongwei Xue, Rongyao Fang, Lingyi Hong, Ziyu Guo, Ray Zhang |
| 所属机构 | 阿里巴巴Accio团队,香港中文大学MMLab,清华大学 |
| arXiv编号 | 2505.17020 |
| 版本 | v1: 2025年5月22日提交;v2: 2025年12月21日修订 |
| DOI | 2505.17020 CrossLMM: Decoupling Long Video Sequences from LMMs via Dual Cross-Attention Mechanisms |
| 项目主页 | https://crosslmm.github.io |
| 代码仓库 | https://github.com/ysl1414/CrossLMM |
📌 本文声明
本文是对论文 CrossLMM: Decoupling Long Video Sequences from LMMs via Dual Cross-Attention Mechanisms(arXiv:2505.17020)的中文翻译与解读,内容仅供学习交流使用。
翻译和解读已力求准确,但如有疏漏,以英文原文为准。
本文中所涉及的模型、代码、数据等资源,其版权归原作者及所属机构所有。
本文不构成对任何模型或方法的推荐或背书。
如需引用,建议引用原始论文:
Yan, S., Han, J., Tsai, J., Xue, H., Fang, R., Hong, L., Guo, Z., & Zhang, R. (2025). CrossLMM: Decoupling Long Video Sequences from LMMs via Dual Cross-Attention Mechanisms. arXiv preprint arXiv:2505.17020.
摘要
翻译
大型多模态模型(LMMs)的出现显著增强了大型语言模型(LLMs)处理与解释多样化数据模态(如图像和视频)的能力。然而,随着输入复杂性的增加,特别是面对长视频序列时,所需令牌的数量急剧增长,导致计算成本呈二次方上升。这使得在保持性能完整性的前提下,高效压缩LMMs中的视频令牌,成为一个紧迫的研究挑战。本文提出CrossLMM,通过一种双交叉注意力机制将长视频序列从LMMs中解耦,在显著减少视觉令牌数量的同时,将性能下降降至最低。具体而言,我们首先通过一种简单但有效的池化方法,大幅减少来自预训练视觉编码器的令牌数量。然后,在LLM层内部,我们采用了一种视觉到视觉(V2V)的交叉注意力机制,其中池化后的视觉令牌作为查询,作用于原始视觉令牌集合(作为键和值)。该模块能够在更高效利用令牌的同时,保留细粒度的信息保真度。此外,我们引入了一种文本到视觉(T2V)的交叉注意力机制,文本令牌通过与原始视觉令牌的交互得到增强,丰富了文本令牌的视觉理解能力。全面的实证评估表明,尽管我们的方法使用的计算资源大幅减少,但在各种基于视频的LMM基准测试中,仍取得了具有竞争力的性能。
解读
摘要从三个层次概述了本研究。问题层 :长视频输入导致视觉令牌激增,LLM的注意力计算量与令牌数呈平方关系,计算成本增长显著。方法层 :作者提出将压缩后的表示与原始信息源解耦------压缩令牌负责与LLM进行主干交互以控制计算量,但可通过交叉注意力随时访问原始视觉令牌以补充信息。效果层:在每帧仅使用1、9或16个令牌的压缩条件下,模型在多个基准测试上取得了与使用数百个令牌相当的性能。其中"解耦"是全文的核心概念,指将"计算主路径"与"信息存储"分离。
1. 引言
翻译
大型多模态模型为大型语言模型增强了视觉感知能力,在图像-语言和视频-语言任务中表现出了卓越的能力。当代关于LMMs的研究主要采用一个中间模块(即投影器)将视觉令牌表示映射到LLM的嵌入空间,随后作为前缀内容输入到LLM中,如图1 (a) 所示。然而,输入模态的复杂性日益增加,特别是长视频序列,产生了大量的视觉令牌。这种令牌激增需要大量的计算资源,从而限制了此类模型在资源受限环境和长上下文场景中的适用性。因此,开发能够最大限度减少性能下降的高效视觉压缩方法已成为一项关键研究需求,受到了学术界和工业界的广泛关注。
在近期的文献中,出现了多种视觉令牌压缩方法,可分为以下两大范式:
-
LLM前的令牌合并,如图1 (b) 所示,主要是在输入LLM之前,通过语义相似性度量来压缩视觉令牌。然而,该方法存在显著局限:它无法充分识别与相关文本元素对应的视觉令牌,损害了空间关系,削弱了模型全面解读图像的能力。
-
LLM内的令牌剪枝,如图1 (c) 所示,在LLM的输入层内对视觉令牌进行系统性减少。该方法通常通过量化视觉与文本令牌间的注意力权重,随后剔除权重较低的令牌。虽然这种方法有效地揭示了多模态交互,但可能忽略视觉模态中的关键语义信息。此外,随着视觉令牌数量的减少,这两种方法都经历了显著的性能下降。
因此,一个值得研究的问题出现了:在显著减少视频令牌数量的同时,是否有可能保持具有竞争力的性能?
为了实现这一目标,我们引入了一种高效的架构,称为CrossLMM。其核心组件是一个双交叉注意力模块。在视觉领域,我们首先沿空间维度压缩来自视觉编码器的图像令牌,以减少输入到LLM的令牌数量。为了促进全面的图像信息捕获,我们在LLM层内部署了视觉-到-视觉(V2V)交叉注意力机制。该过程使得压缩后的视觉令牌(作为查询)与原始的长序列视觉表示(作为键和值)之间能够进行充分的交互。相应地,在文本领域,我们采用文本-到-视觉(T2V)交叉注意力机制,利用原始视觉令牌(作为键和值)中的多模态信息来增强文本令牌(作为查询)。这进一步用细粒度的视觉语义补充了文本生成过程。通过实施这种双交叉注意力机制,我们致力于在实现大幅令牌压缩的同时,保持原始视觉令牌的保真度,有效缓解性能恶化。
我们在广泛的视频多模态基准上评估了CrossLMM。我们的模型仅使用极少令牌(1、9或16个),在包括VideoMME和MLVU等多个视频评估任务中表现出有竞争力的性能。这些发现表明,通过实施我们的双交叉注意力模块并配合有限数量的视觉令牌,LMMs能够有效处理多样化的视觉任务。
我们的贡献可总结如下:
-
我们提出了CrossLMM,它通过双交叉注意力机制,将长视频序列有效地压缩为高效的表示形式。
-
我们提出了V2V和T2V交叉注意力层,分别为紧凑的视觉令牌和文本令牌提供来自原始视觉令牌的语义信息。
-
CrossLMM在仅使用极少视觉令牌的情况下,在各种视频理解基准测试中取得了具有竞争力或领先的性能,展示了其良好的效率。
解读
引言首先描述了LMMs的标准工作方式------视觉令牌通过投影器映射后作为前缀输入LLM。这一范式在图像任务中运作良好,但迁移到视频任务时面临显著挑战。作者将现有压缩方法归纳为两类并指出各自不足。令牌合并 的问题在于缺乏文本信息引导------它仅基于视觉相似度进行合并,可能将关键区域与无关背景合并。令牌剪枝的问题在于决策的不可逆性------如果剪枝决策有误,丢失的信息无法挽回。两类方法在压缩率提高时性能均显著下降,说明"丢弃信息"的策略存在根本局限。引言末尾提出的核心问题直接引出本文的解决方案:不丢弃原始信息,而是将压缩表示与原始信息解耦,让模型在需要时能够检索原始信息。
2. 相关工作
2.1 大型多模态模型
翻译
在大型数据集上训练的大型语言模型在文本理解和生成任务中展现出了卓越的能力,为开发多模态LLMs奠定了基础。在众多大型多模态模型中,LLaVA已成为主流架构,因其数据效率和简洁设计而受到重视。该方法采用投影器有效地连接视觉和语言模态,同时利用指令跟随数据集对投影器和LLM进行指令微调。近期的研究工作通过实施高分辨率视觉输入来提升模型性能。与此同时,基于视频的LLMs通过将视觉指令微调数据集扩展到视频模态而取得了进展。然而,高分辨率和视频输入产生的大量令牌带来了显著的计算挑战。因此,开发高效的视觉令牌压缩方法以解决这些限制,是一个迫切的需求。
解读
本节梳理了LMMs的发展路径------从LLaVA的基础架构,到高分辨率扩展,再到视频领域的延伸。作者指出一个趋势:无论是提高分辨率还是增加视频帧数,都导致令牌数量显著增加,这使得令牌压缩成为一个跨任务、跨模态的通用需求。
2.2 视觉令牌压缩
翻译
随着高分辨率图像和视频输入的出现,令牌数量大幅增加,通常超过文本令牌数量一至两个数量级。因此,视觉令牌的高效压缩已成为一个关键的研究挑战。先前解决该问题的方法可分为两个主要方向。第一类包括压缩视觉编码器生成的令牌或实现视觉模态高效投影的方法。例如,LLaMA-VID采用QFormer架构将视觉令牌压缩为最少两个令牌的表示。类似地,Deco在图像块级别实现了自适应池化。然而,这些方法缺乏与文本信息的集成以进行引导压缩。替代方法是在LLMs内部逐步减少视觉令牌,但这类方法常常损害视觉信息的语义完整性。因此,我们提出了一个双交叉注意力模块,同时更新与文本相关的视觉令牌和与视觉相关的文本令牌,从而在有效压缩视觉表示的同时,最大限度地减少信息损失。
解读
作者将现有压缩方法按压缩发生的阶段分类。第一类发生在编码器之后、LLM之前,其局限是缺乏文本信息引导------压缩决策没有考虑用户的具体问题。第二类发生在LLM内部,其局限是损害语义完整性------在LLM内部逐步丢弃令牌,可能丢弃对语义理解关键但对当前注意力权重不敏感的视觉信息。这两条批评分别对应本文两个模块的设计动机。
3. 方法
3.1 整体架构
翻译
在本节中,我们将阐述CrossLMM用于多模态视频理解的细节。我们首先在第3.1节描述整体流程,然后在第3.2节和第3.3节分别阐述所提出的视觉-到-视觉和文本-到-视觉交叉注意力机制的设计。
我们提出的方法,受当前主流架构LLaVA的启发,围绕三个核心组件构建,包括逐帧视觉编码器、视觉-语言投影器和大型语言模型,如图2所示。
视觉特征编码。 对于视觉特征提取,我们采用基于图像的编码器,而非基于视频的架构。该方法按顺序从各帧中提取特征。具体而言,我们利用预训练的SigLIP2视觉编码器进行视觉信息编码。我们的方法基于两个关键考量:1)图像编码器通常通过更大规模的训练具有更好的泛化能力;2)时间信息可以通过拼接多个帧表示来保留。给定一个输入视频-文本对,我们从视频片段中采样 T 帧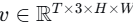 ,并应用视觉编码器提取图像特征。该过程可公式化为:
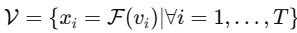
这里,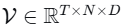 对应于 T 个输入帧的特征表示。视觉编码器
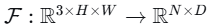 处理每个RGB帧
(空间分辨率为 H×W)以生成
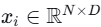 ,其中 NN 表示视觉令牌的数量,D 指定每个令牌的潜在嵌入维度。
初始令牌合并。 之后,在投影操作之前应用双线性池化算子 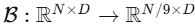 ,执行 3×3 局部块聚合。这将令牌网格从原始的 27×27(N=729)空间下采样到 3×3(N=9)分辨率,通过对空间相邻块进行无重叠融合,同时通过无参数的结构压缩保持特征维度 D。该架构通过结构性令牌聚合引入了具有几何意义的归纳偏置,同时保持了块间空间关系的完整性,这也提升了计算效率。
视觉-语言投影器。 跨模态投影模块 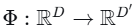 被设计为一个参数化的双层MLP,通过连续的非线性变换作用于视觉令牌
 。这种可学习的变换通过建立从视觉特征空间 V 到LLM文本嵌入流形 T 的映射,以及保持拓扑一致性的可微逆近似,实现了双向语义对齐。
大型语言模型。 架构建立在标准的仅解码器LLM基础上,并增加了分层跨模态集成方案。在每 K 个解码器层中,我们引入了双流注意力机制:
-
视觉-到-视觉: 位于文本自注意力之后,该模块计算式 (2):
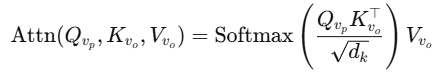
其中
 来源于高效的视觉表示(压缩令牌),
 由原始视觉令牌投影得到。这使得高效的视觉表示能够以文本为条件,从原始视觉令牌中获得细粒度的视觉引导精炼。
-
文本-到-视觉: 并行运作,建立式 (3):
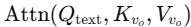
创建视觉条件下的文本特征更新。
这种交错集成策略通过交替的注意力方向实现了多轮跨模态融合,其中V2V提取与文本相关的视觉细节以夯实语言生成,而T2V则通过视觉相关的语言反馈来维持语义连贯性,形成一个耦合的注意力动态系统。V2V和T2V的详细内容分别在第3.2和3.3节中提供。
解读
作者选择图像编码器而非视频专用编码器,基于两点考量:图像编码器训练数据规模通常更大、视觉概念覆盖更广;视频时间连续性可通过帧序列拼接来建模。池化策略将每帧729个令牌压缩为9个,压缩率为1/81,采用无参数的结构压缩,在信息损失和计算节省之间取得平衡。V2V和T2V是每隔 KK 层插入的"旁路"模块而非替代原有自注意力,原始自注意力负责语言内部推理,新插入的交叉注意力负责跨模态信息检索,两者功能互补。
3.2 视觉-到-视觉(V2V)交叉注意力
翻译
为促进多模态和多帧特征融合,我们引入了V2V交叉注意力模块,用于从粗粒度到细粒度的文本条件视觉聚合。对于一个多模态视觉-语言模型,投影并池化后的视觉特征 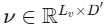 将与文本特征
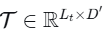 拼接后输入LLM,其中 D′ 是LLM的嵌入维度,
分别代表视觉和文本令牌的长度。如图3(a)所示,V2V模块将视觉特征 νν(池化并投影后)和文本特征 TT 作为输入
 ,其中 ⋅表示拼接。我们采用门控跨模态融合机制,使输入令牌逐步捕获多模态信息。过程包含两个阶段:自注意力处理和交叉注意力融合,公式化为:
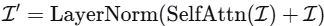
其中 TT 代表视觉和文本特征的整合表示。随后,我们提取粗粒度的文本条件视觉特征 T⋅;LvT⋅;Lv。为了获得更细粒度的视觉表示,我们将 T⋅;LvT⋅;Lv 作为查询令牌,如式 (5) 所示:
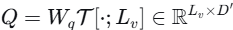
同时利用原始令牌作为键和值令牌,如式 (6):
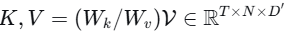
其中 和
表示线性投影矩阵。细粒度的视觉特征随后通过交叉注意力和门控机制获得,公式化为:
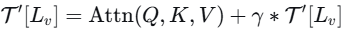
其中 是一个可学习的门控参数。通过这个过程,我们得到了一个从粗粒度到细粒度逐步抽象的分层文本条件视觉表示。
解读
V2V模块采用两阶段设计。第一阶段------自注意力融合:将池化视觉令牌与文本令牌拼接后通过自注意力,让压缩后的视觉信息与文本信息在同一个表示空间中进行交互。第二阶段------交叉注意力检索:从第一阶段的输出中提取视觉部分作为查询 QQ,但对 K,VK,V 使用原始视觉令牌,使压缩令牌先通过与文本的交互理解任务需求,然后去原始视觉令牌库中检索最相关的细粒度信息。"从粗到细"指池化后的9个令牌提供全局概要,交叉注意力从729个原始令牌中聚合局部细节。门控参数 γγ 初始化为0,新模块在训练初期相当于恒等映射,不改变原有LLM的输出。
3.3 文本-到-视觉(T2V)交叉注意力
翻译
为增强文本令牌的视觉理解能力,我们实施了一个T2V交叉注意力机制,促进文本令牌与原始视觉令牌间的交互。虽然在结构上与前述V2V模块并行,但T2V模块在互补方向上运作,通过视觉上下文转换文本令牌表示。数学公式遵循类似模式,如式 (8):
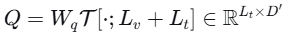
其中文本令牌作为查询,关注视觉信息。原始视觉令牌作为键和值令牌,如式 (9):
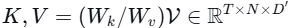
增强后的文本特征通过交叉注意力和可学习门控机制计算,如式 (10):
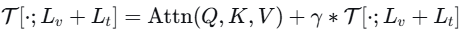
其中 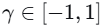 控制视觉语境化信息的影响。该机制通过提供信息的反向流动来补充V2V模块,产生视觉条件下的文本表示,捕获两种模态间的多层次语义关系。
解读
T2V与V2V在数学结构上对称,但信息流动方向不同。V2V是"视觉查视觉"------压缩视觉令牌查询原始视觉令牌;T2V是"文本查视觉"------文本令牌查询原始视觉令牌。如果只有V2V,文本令牌只能间接通过LLM自注意力关注压缩后的视觉令牌获取信息,但压缩令牌可能已丢失某些对回答至关重要的细节。T2V让文本令牌可以直接从原始视觉令牌中检索与问题相关的区域特征。作者将两者关系描述为"信息的双向循环",每一轮交互都可能改善另一种模态的表示质量。
4. 实验
4.1 实验设置
翻译
实施细节: CrossLMM使用SigLIP2作为视觉编码器。Qwen2.5-1.5B-Instruct作为CrossLMM-2B的LLM,Qwen2.5-7B-Instruct用于CrossLMM-7B。对于V2V模块,我们在LLM内每 K 层集成连接,T2V模块采用相同方法。在预训练阶段,学习率为×
,而在指令微调阶段,学习率调整为
×
,ViT组件使用
×
。我们的模型在预训练和指令微调阶段都仅训练一个周期。更多细节见补充材料。
评估基准: 为验证CrossLMM的通用能力,我们在五个视频理解基准上评估模型,涵盖短视频基准、长视频基准和综合基准。包括两个短视频基准:MVBench和Perception Test;两个长视频基准:LongVideoBench和MLVU;以及一个综合基准VideoMME,覆盖从分钟级到小时级的视频。
解读
作者选择1.5B和7B两个规模的LLM,分别对应轻量级验证和标准评测。预训练阶段LLM和视觉编码器均冻结,仅训练投影器和V2V模块,体现"最小扰动"原则。视觉编码器学习率(2e-6)显著低于其他组件,旨在防止微调过程中破坏编码器已习得的通用特征。两个阶段都仅训练1个epoch,表明作者倾向于轻量级训练,更多依赖现有预训练模型的泛化能力。
4.2 与最先进方法的比较
翻译
在本节中,我们将CrossLMM与最先进的LMMs进行比较,包括商业实现、开源小型LMMs、通用开源LMMs以及专用的开源长视频LMMs。
实验结果如表1所示,展示了视频理解模型领域的几个重要发现。CrossLMM展现了良好的效率-性能权衡。尽管每帧仅使用9个令牌------远少于竞争对手使用的64至676个令牌------CrossLMM在多个基准上取得了具有竞争力的性能。此外,使用7B参数和每帧16个令牌的CrossLMM超越了多个主流开源LMMs,同时保持了更低的内存和计算开销。这种效率在2B和7B两种模型规模下均得到一致体现,表明CrossLMM在平衡令牌效率和性能方面具有潜力。
解读
从表1数据来看,CrossLMM-7B(9令牌/帧)在VideoMME上达到62.6,高于LLaVA-OV-7B(58.2),后者使用196令牌/帧,令牌数减少约95%而性能提升约7.6%。使用ViT-G编码器的CrossLMM-7B(16令牌/帧)达到65.4,与Qwen2.5-VL-7B(65.1)相当,在令牌数相差一个数量级的条件下达到相近性能。商业模型的绝对性能仍显著领先,但考虑到其使用未公开规模的训练数据和计算资源,直接比较的意义有限。
4.3 效率分析
翻译
图4展示了CrossLMM与LLaVA-OV在不同帧数(32, 64, 128, 256)下的全面效率比较,分析聚焦于三个关键指标:CUDA内存消耗、计算复杂度和预填充时间。
内存效率。 如图4(a)所示,CrossLMM表现出显著的内存效率优势。在32帧时,CrossLMM仅需1,753MB的CUDA内存,比LLaVA-OV的4,858MB少63.9%。这一优势随帧数增加进一步扩大。在256帧时,CrossLMM仅消耗2,531MB,比LLaVA-OV的20,208MB减少了87.5%。值得注意的是,CrossLMM的内存消耗随帧数增长的幅度非常平缓,呈现亚线性增长模式,而LLaVA-OV则呈现近线性增长。
计算效率。 图4(b)展示了以TFLOPS衡量的计算需求。CrossLMM在所有帧数下均保持较低的计算复杂度。在32帧时,CrossLMM需要13.17 TFLOPS,比LLaVA-OV的57 TFLOPS少76.9%。这一优势在高帧数下持续存在,256帧时CrossLMM需要102.42 TFLOPS,相比LLaVA-OV的316.88 TFLOPS减少了67.7%。
处理时间效率。 图4(c)显示,CrossLMM在预填充处理速度上持续优于LLaVA-OV。32帧时,CrossLMM在335ms内完成处理,比LLaVA-OV的554.91ms快39.6%。256帧时,CrossLMM需1,975ms,而LLaVA-OV需3,978.83ms,减少了50.4%。
总体效率提升。 图4(d)总结了CrossLMM在所有测试帧数上的平均性能改进。最显著的提升在内存使用上,平均减少79.2%,其次是计算需求减少74.8%,处理时间减少48.7%。
解读
CrossLMM从32帧到256帧的显存增长约为1.44倍(1,753MB→2,531MB),而输入帧数增长了8倍。这种亚线性增长的原因在于:LLM主干处理的视觉令牌数量不随视频总帧数线性增长,V2V和T2V模块中存储原始令牌的键值缓存不参与LLM主干的平方复杂度自注意力计算。预填充阶段是LLM处理输入序列后生成第一个输出令牌的过程,对于长视频问答任务通常占总推理延迟的主要部分。
4.4 消融实验
翻译
在本节中,我们呈现了全面的消融实验以评估各组件的贡献。鉴于计算资源限制,我们采用CrossLMM-2B模型作为基础,使用1个令牌进行消融研究。在预训练阶段,我们使用包含375万图像-文本对和125万视频-文本对的平衡语料库,模态间保持1:1的恒定采样比。在指令微调阶段,我们使用LLaVA-Video 178K数据集优化模型性能。
视觉-到-视觉与文本-到-视觉模块: V2V模块专门设计用于从原始视觉令牌中捕获文本条件下的细粒度视觉特征。T2V模块则设计用于增强文本信息的视觉理解能力。如表2a所示,移除V2V或T2V模块会导致所有基准性能下降,直接证明了这两个模块在提取细粒度视觉信息和文本特征中的关键作用。
插入频率: 我们通过变化插入频率 KK 进行了系统的消融实验,结果如表2b所示。当 K=1(即最大插入频率)时,我们观察到性能显著低于我们提出的配置,主要原因是引入了过多参数,损害了原始LLM的固有能力。类似地,当 K=8 时,性能相比我们的方法仍然次优,表明在该插入频率下,细粒度视觉信息变得过于稀疏。
T2V激活阶段: 我们的实验设计包含三种T2V模块配置:(1)在预训练和指令微调阶段均不启用T2V模块;(2)在预训练和指令微调阶段均启用T2V模块;(3)在预训练阶段启用但指令微调阶段不启用。消融实验结果如表2c所示,得出两个重要发现。首先,在两个阶段都缺失T2V模块时,所有基准性能相比最优配置均有所下降,表明该模块在增强文本令牌的视觉表示方面具有有效性。其次,虽然仅在预训练阶段引入T2V模块产生了改进,但由于预训练数据中存在大量文本噪声,其有效性显著减弱。
解读
表2a显示,V2V单独使用带来约1.2-1.4分的提升,T2V单独使用仅带来约0.1-0.2分的提升。两者结合时性能最优,且协同增益高于各自增益之和。表2b显示,K=1时性能最低,作者归因于参数量过大损害了LLM的固有语言能力;K=8时性能次优,原因是跨模态交互不够充分。表2c显示,仅在预训练阶段启用T2V的性能低于仅在指令微调阶段启用,作者解释为预训练数据中存在的文本噪声可能导致模型学习到错误的关联模式。这一发现提示模块的引入时机应与数据质量相匹配。
5. 结论
翻译
我们提出了CrossLMM,它为长期制约LMMs处理长视频序列的计算效率问题提供了一个解决方案。我们的CrossLMM框架表明,通过审慎的令牌缩减策略和架构创新,可以在保持模型保真度的同时,显著提高计算效率。由V2V交叉注意力和T2V交叉注意力组成的双交叉注意力机制,构成了面向实际多模态系统令牌管理的方法论进步。
解读
结论指出本文的核心贡献在于从"令牌压缩"到"令牌管理"的范式转变------前者侧重于丢弃冗余信息,后者侧重于在压缩的同时保持信息的可访问性。"模型保真度"强调的是模型输出质量相对于原始全令牌模型的保持程度。
6. 实现细节(附录)
翻译
6.1. 训练策略与数据
训练策略: 不同于主流LMMs采用的复杂三或四阶段训练流程,我们采用简化的两阶段训练框架。
-
阶段一:视觉-语言预训练。 对齐视觉和语言表示。由于文本数据存在噪声,此阶段排除T2V模块,仅优化投影器和V2V模块,冻结视觉编码器和LLM。
-
阶段二:指令微调。 使用高效视觉令牌,端到端联合优化所有参数,执行视频问答、多项选择等任务。
训练数据: 完全使用公开数据。
-
预训练数据: 1500万图像-文本对(CapsFusion)+ 500万视频-文本对(InternVid),采样比1:1。
-
指令数据: 约300万样本,包括图像指令数据、短视频指令数据和长视频指令数据。
6.2. 超参数
详见附录表3。
解读
作者选择简化的两阶段方案,避免了三阶段或四阶段流程带来的复现门槛。"预训练阶段排除T2V"与表2c的消融实验结果一致,既避免了噪声数据的负面影响,也降低了预训练计算成本。预训练阶段可训练参数约4300万,占2B模型总参数的约2%,仅训练1个epoch,有利于学术复现和实际应用。
7. 更多实验(附录)
翻译
7.1. 消融研究(续)
预训练数据量分析(表4): 增加预训练数据量(从1000万到2000万)持续提升性能,表明更多数据有助于学习更好的跨模态表征。
视觉编码器可训练性分析(表5): 解冻视觉编码器进行训练,在所有基准上均优于冻结策略。
7.2. 计算效率分析(表6)
CrossLMM-2B随帧数增加,显存呈亚线性增长(32帧715.61MB 到 256帧1490.25MB),计算量和预填充时间呈近线性增长。
解读
预训练数据量从10M增加到20M,VideoMME提升1.1个百分点。解冻视觉编码器带来2.4个百分点的提升,说明针对视频任务的编码器适应是有益的。表6的显存数据验证了亚线性增长特征,TFLOPS和预填充时间与帧数近似成正比。
8. 局限性与未来工作
翻译
尽管CrossLMM在视频理解上表现良好,但一个重要未来方向是将其框架扩展到2D图像和3D点云理解。这对处理高分辨率图像和大规模3D场景至关重要,在这类场景中,在LLM内捕获细粒度空间细节同时保持处理效率仍然具有挑战性。
解读
作者承认当前工作限于视频,扩展到2D图像和3D点云是自然的下一步。高分辨率图像和大规模3D场景中的细粒度空间细节对理解至关重要,但处理这些细节又需要大量令牌,与效率目标存在矛盾。
9. 更广泛的影响
翻译
CrossLMM提高了大型多模态模型处理视频的效率,可能促进其在智能监控、医疗保健和教育等现实应用中的更广泛采用。然而,此类技术易得性的提高也引发了潜在的伦理问题,包括隐私风险和恶意滥用风险。作者鼓励负责任地开发和部署这些系统。
解读
作者在伦理声明中承认技术可能带来积极影响和负面后果,符合当前AI研究论文的伦理声明规范。
综合总结
CrossLMM的核心方法可以概括为"压缩-检索分离"的架构范式。下表汇总了其主要技术要素:
| 方面 | 具体方法 | 效果 |
|---|---|---|
| 令牌压缩 | 3×3 池化(729→9/帧) | 视觉令牌数减少81倍 |
| 视觉精炼 | V2V交叉注意力 | 压缩令牌可检索原始令牌的细粒度信息 |
| 文本增强 | T2V交叉注意力 | 文本令牌可直接查询原始视觉特征 |
| 架构集成 | 每隔 K 层插入DCAL | 在参数增长与跨模态融合深度之间取得平衡 |
| 训练策略 | 预训练阶段排除T2V | 避免噪声数据中的错误关联 |
该工作为解决长视频LMMs的计算效率问题提供了一个方法参考。其核心思路------使用交叉注意力将视觉信息作为可检索的外部知识库而非全部塞入上下文序列------对于更广泛的多模态架构设计可能具有借鉴意义。