OCR材料信息提取工具
功能说明
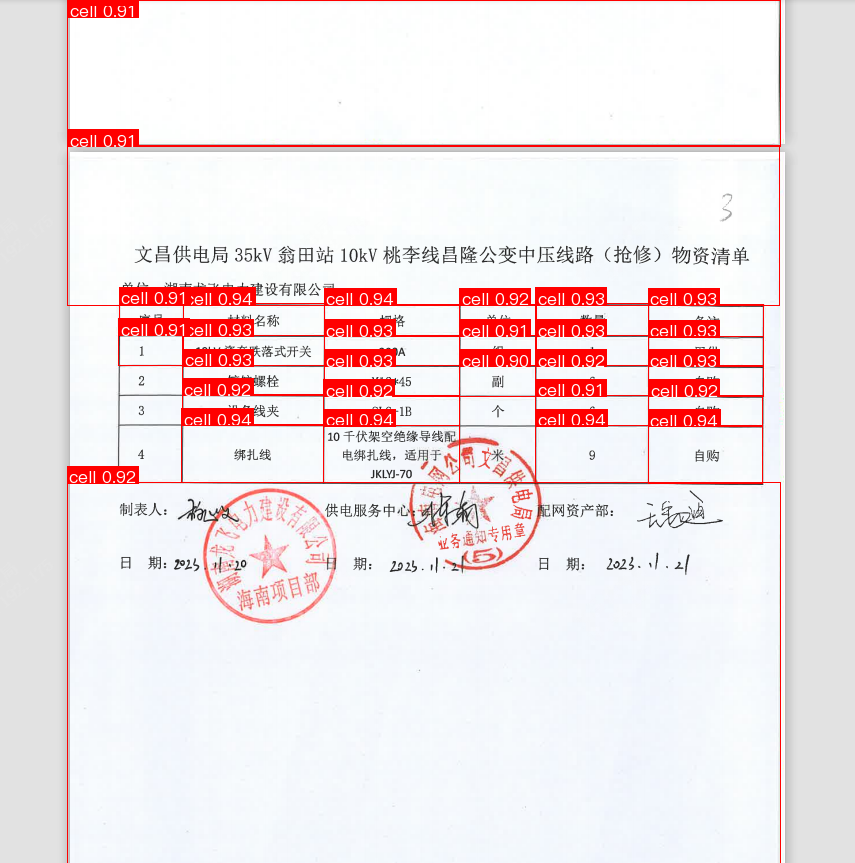
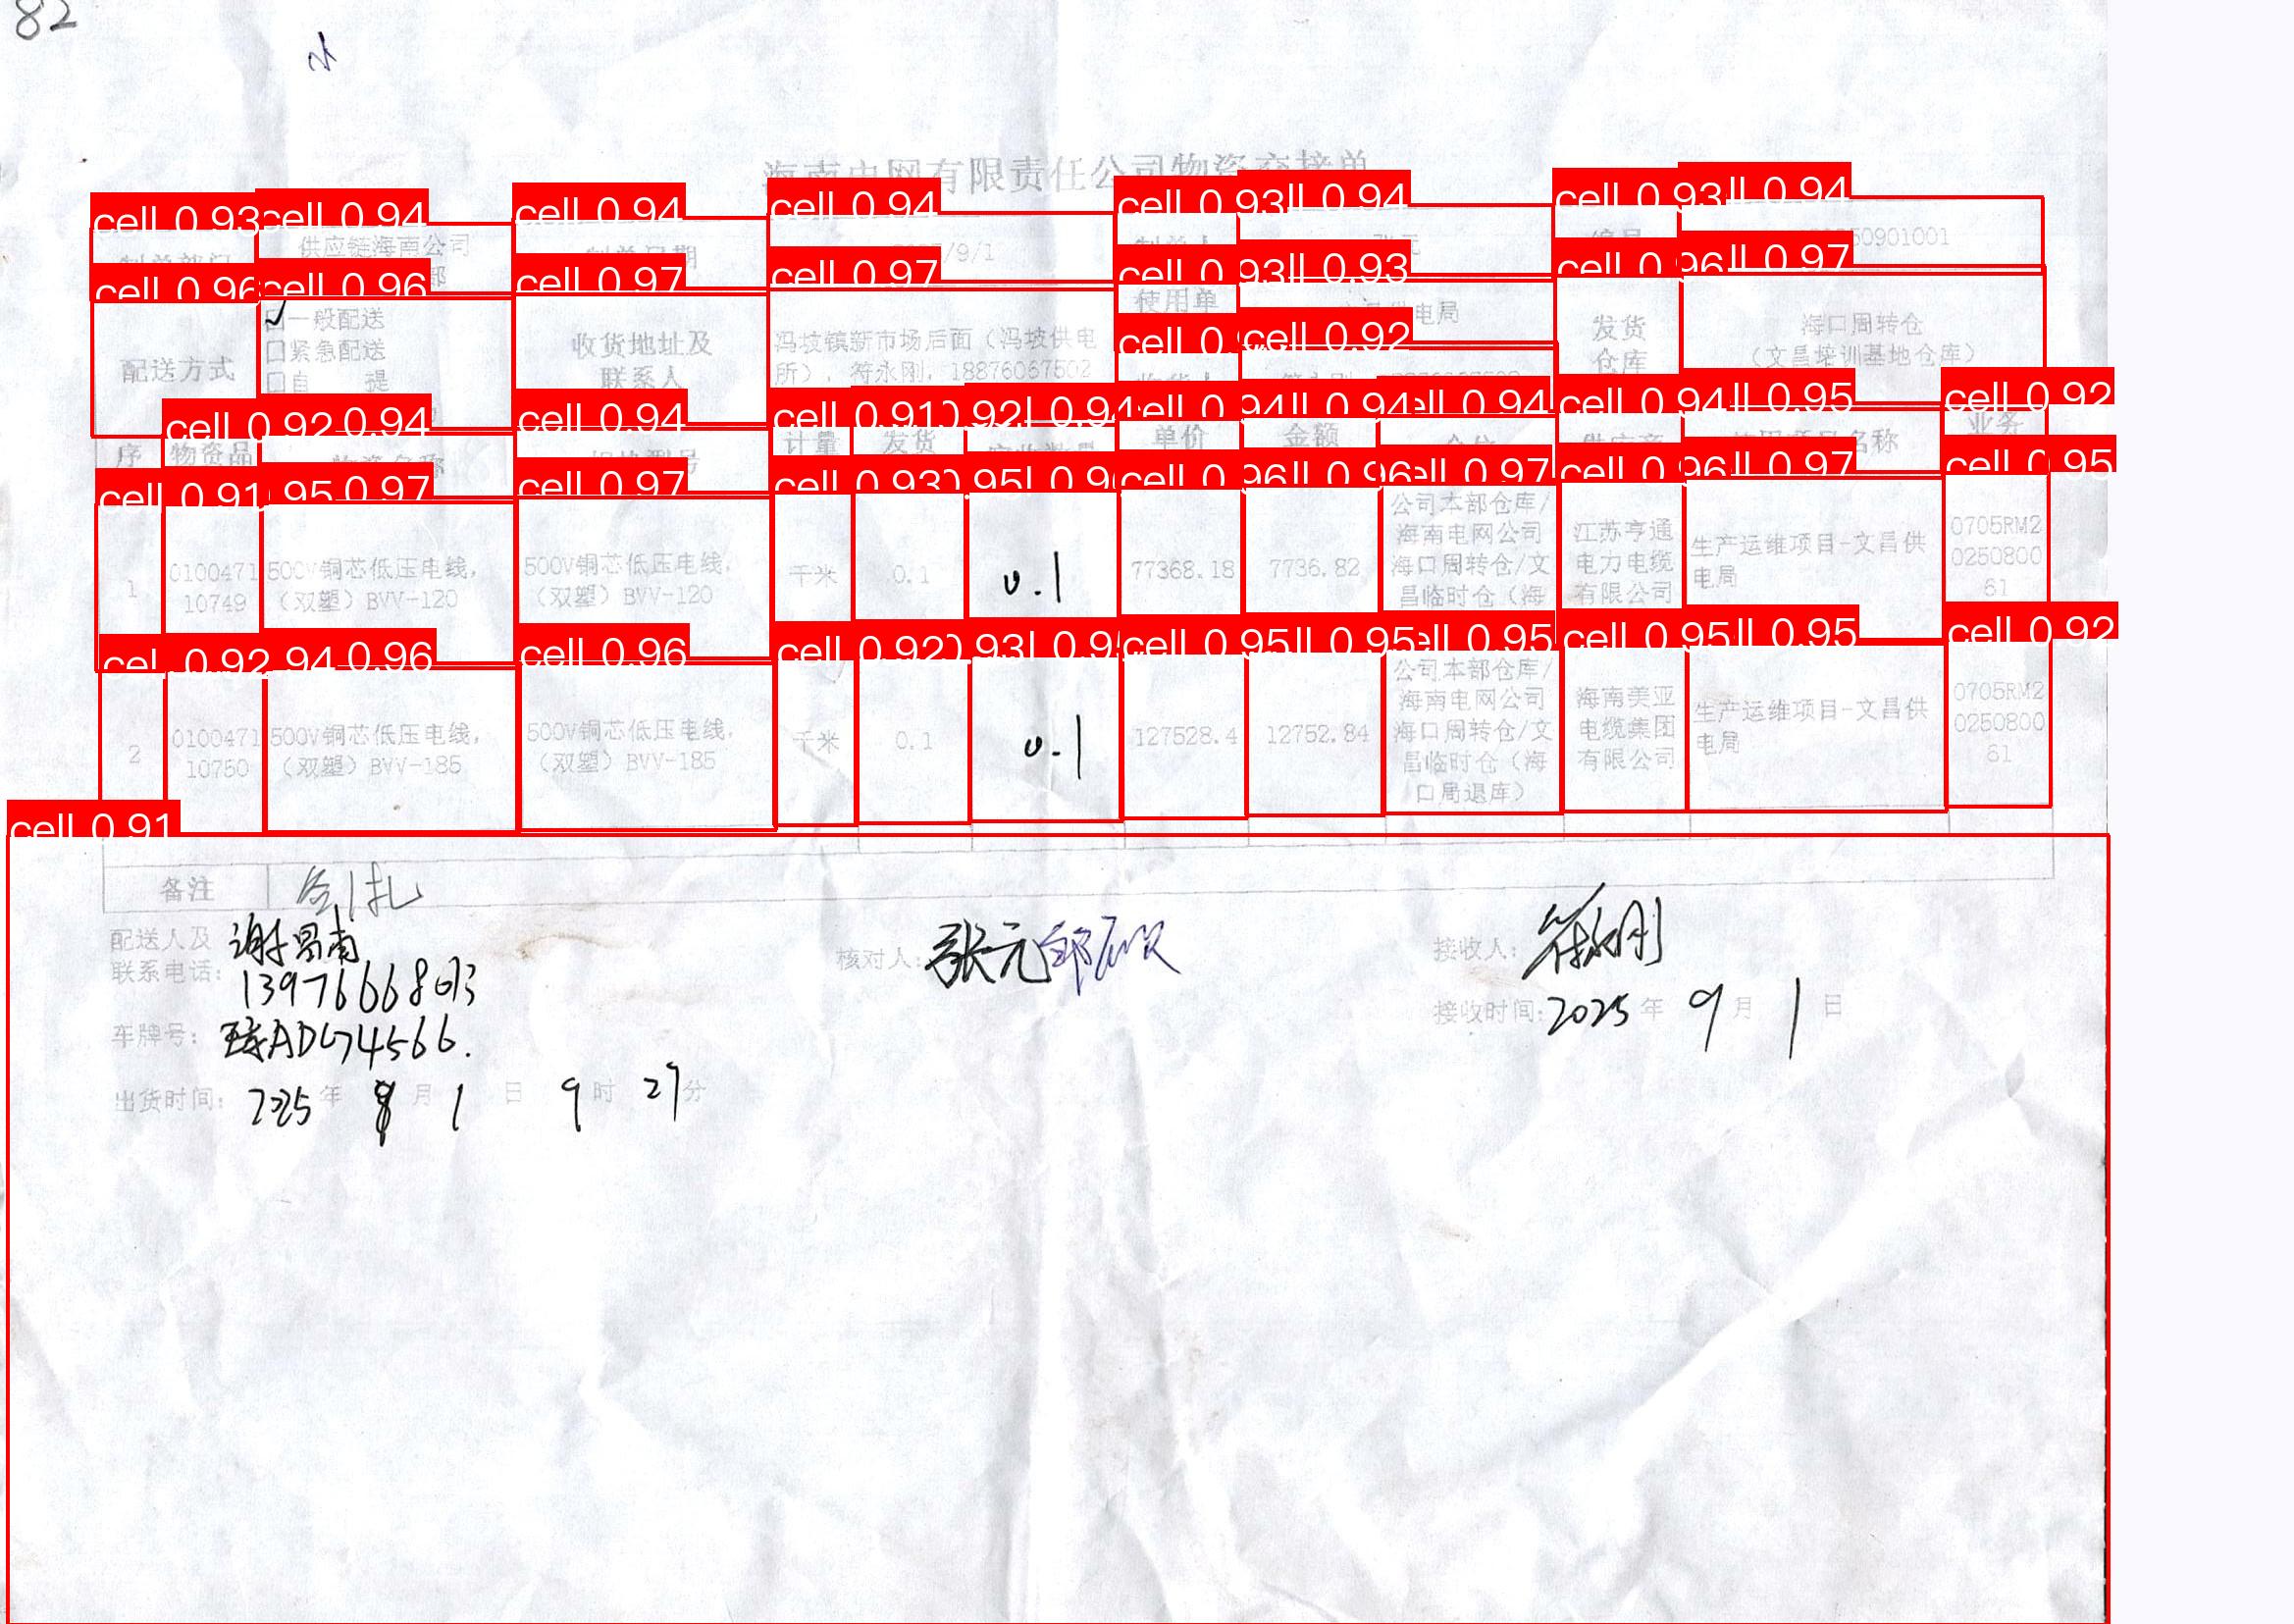
本工具可以从图片(JPG、PNG等)和PDF文件中自动识别并提取以下信息:
- 材料名称
- 规格/型号
- 数量
- 单位
提取的结果会自动保存到Excel文件中。
安装步骤
1. 安装Python依赖
bash
pip install -r requirements.txt注意:首次运行时,PaddleOCR会自动下载中文识别模型,可能需要几分钟时间。
2. 运行脚本
bash
python ocr_to_excel.py输出文件
运行完成后,会在当前目录生成 材料清单.xlsx 文件,包含以下列:
- 来源文件:原始文件名
- 材料名称:识别出的材料名称
- 规格:材料规格/型号
- 数量:材料数量
- 单位:计量单位
支持的文件格式
- 图片格式:JPG, JPEG, PNG, BMP, TIFF
- 文档格式:PDF
处理的目录
脚本会自动处理以下两个目录中的所有文件:
d://急救包(1)d://2023年第18批
注意事项
- 确保图片清晰度足够,文字可辨认
- OCR识别准确率受图片质量影响,建议处理后检查结果
- 首次运行会下载模型文件,请确保网络连接正常
- 如果识别效果不理想,可能需要调整图片对比度或分辨率
故障排除
如果遇到安装问题
如果PaddleOCR安装失败,可以尝试使用CPU版本:
bash
pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple
pip install paddleocr
如果识别结果不理想
- 检查原始文件是否清晰
- 对于扫描PDF,确保分辨率至少300dpi
- 可以手动调整识别参数(在代码中修改PaddleOCR初始化参数)