多模态文档解析后处理开源模型:MinerU-Popo方案思路提升RAG性能

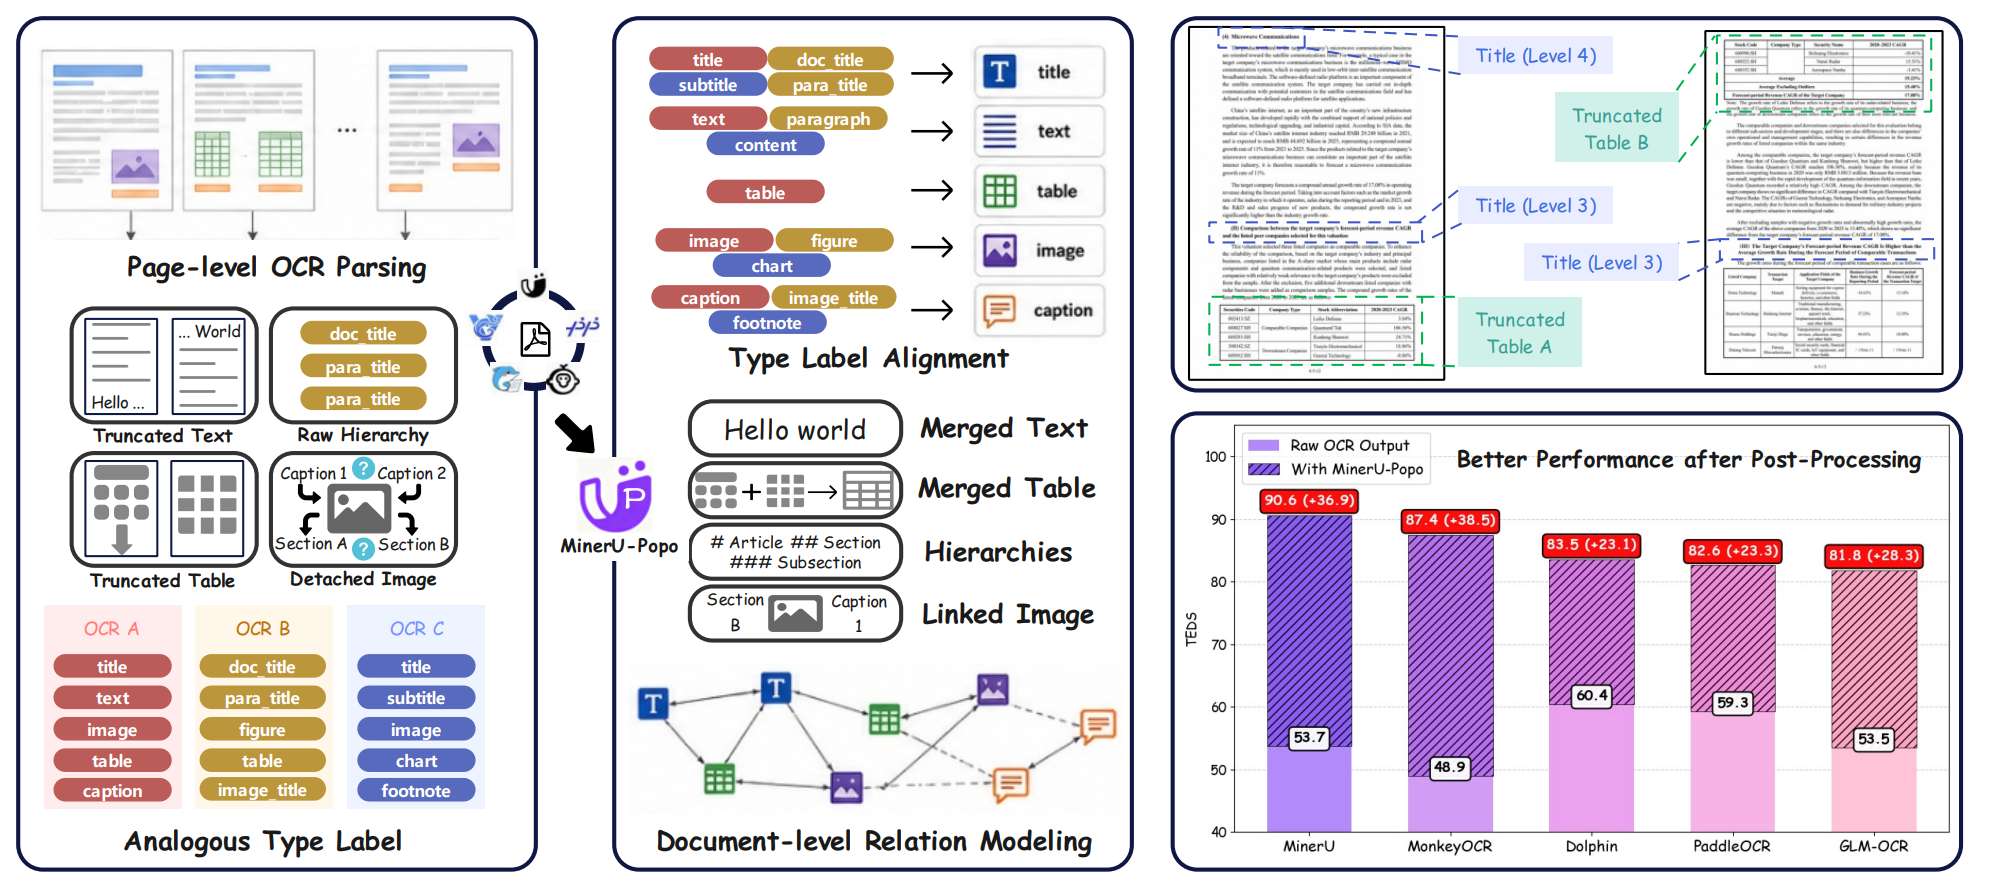
目前各类的文档解析方案(VLM-OCR)都是基于【单页】文档进行解析,输出每页文字、表格、图片+坐标框,但存在4类跨页缺点:

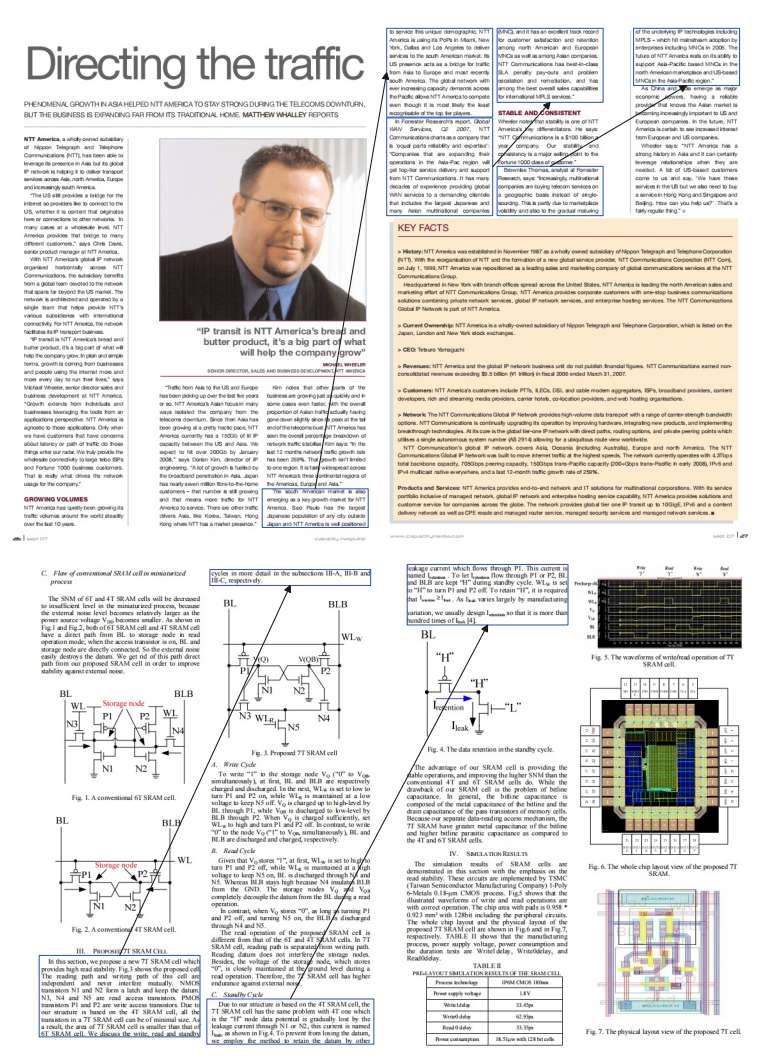
  1. 段落跨页被分页切割、文本断裂;
  2. 大表格分页拆分,上下表身割裂;
  3. 多级标题(一级/二级/三级标题)层级混乱、从属关系丢失;
  4. 插图和对应正文分离,图文无法绑定。

在RAG场景,需要全书/文档连贯的文档级结构化数据 。

MinerU-Popo是一个后处理方案,在不改动原有VLM-OCR模型后对文档级结构进行重构。
方法架构
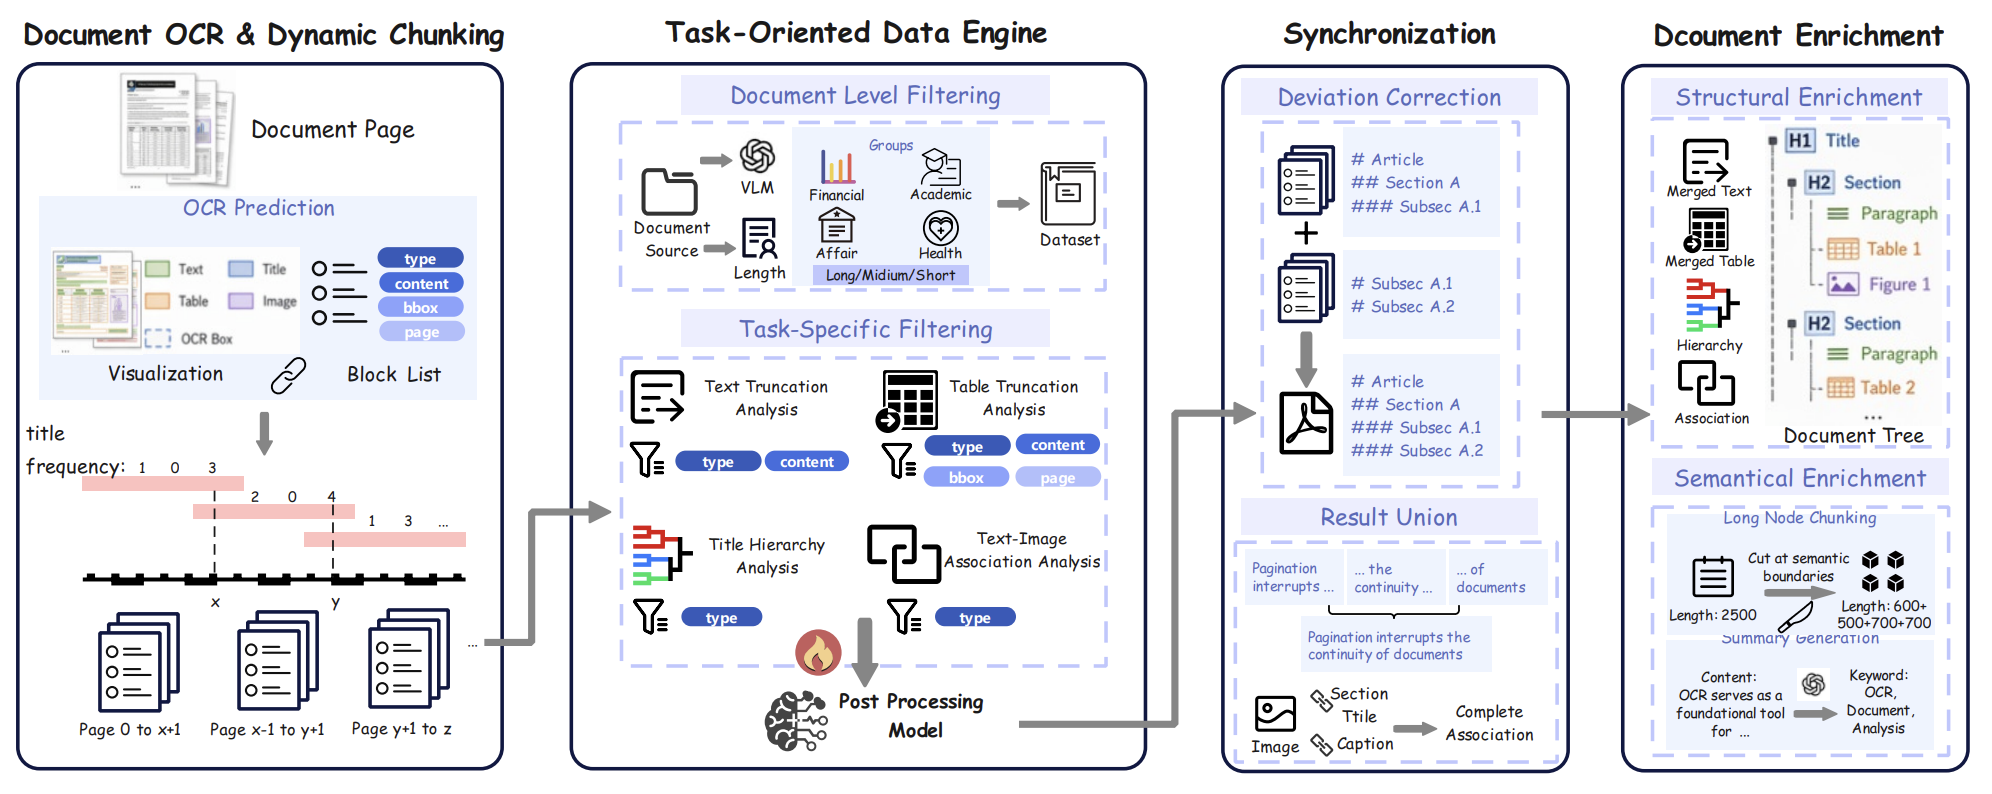
整体方案针对4类跨页缺点基于Qwen3-VL-4B构造4个任务各自独立数据集进行微调。对于【跨页文本截断、表格截断】,定义成二分类任务;
对于【标题层级重构】,定义成开放层级(1、2、3...n)预测;
【图文关联匹配(图片和图注 / 正文描述分散在不同页面,绑定图文)】,预测文字与其关联的图像或表格。
最终四项任务全部跑完后,所有零散页面元素被组装为文档树结构 :

全书(H0)→一级标题H1→二级H2→(段落/完整表格/绑定图片),直接适配RAG知识库入库。

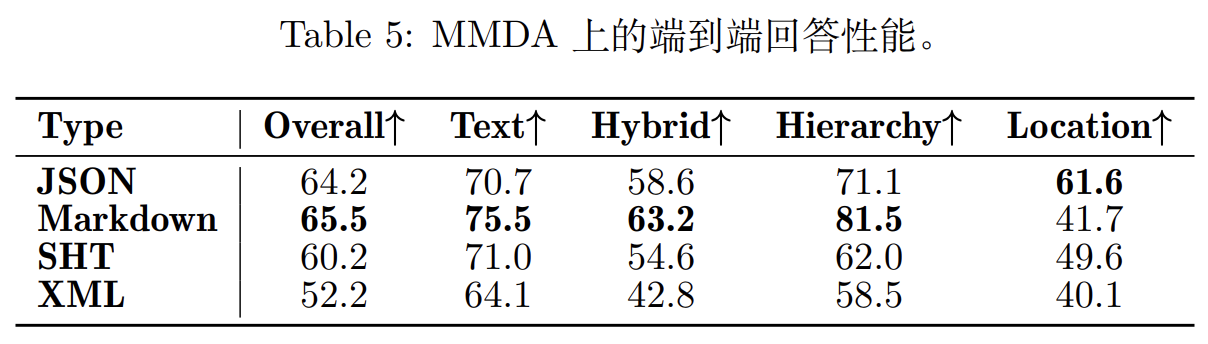
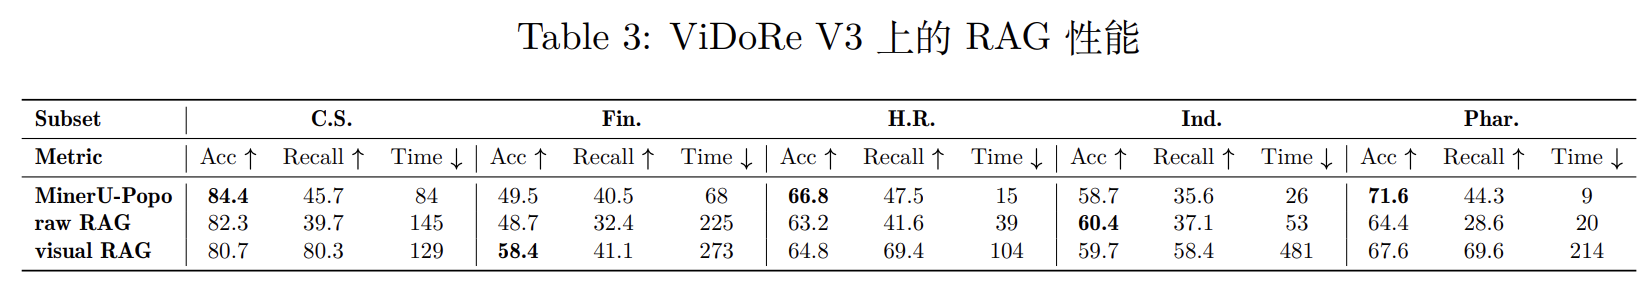
实验评测
参考文献

MinerU-Popo: Universal Post-Processing Model for Structured Document Parsing,https://arxiv.org/abs/2605.24973

往期相关

多模态文档解析的开源项目模型技术方案都在《文档智能专栏》,如:

...

相关推荐
天天代码码天天11 小时前
不依赖 CUDA:C++ 如何用 Vulkan 跑神经网络?从 Vulkan API 到一次完整 PP-OCR GPU 推理
人工智能
threerocks11 小时前
「全语录+省流版」邵艾伦 × 孙宇晨:聊风口、聊个人IP、聊年轻人如何抓住 AI 时代的机会
人工智能
风巽·剑染春水11 小时前
【扩散模型原理】(六)A Unified and Systematic Lens on Diffusion Models(2)
人工智能·生成模型·diffusion·扩散模型
杨航 AI11 小时前
Agent+模型 评测榜单网站:详细设计
人工智能
诚小纯11 小时前
跑了 21 次只有 1 次透明:聊聊一个生图 API 的"透明继承"机制
人工智能·github
镜子AI11 小时前
教培机构AI推荐系统实战:概念漂移检测算法——为什么“去年有效的推荐今年可能失效“
人工智能·算法
用户29914221968011 小时前
GitHub 热榜项目:日榜(2026-10-09)
人工智能·开源·github
AliCloudROS11 小时前
计算巢Agent部署:免费试用,降低企业 AI 应用探索门槛
人工智能
组工部管理能手李哥11 小时前
政务办公场景下,私有化知识库+智能体方案的技术实践与思考
大数据·人工智能
俊哥V11 小时前
每日 AI 研究简报 · 2026-10-08
人工智能·ai