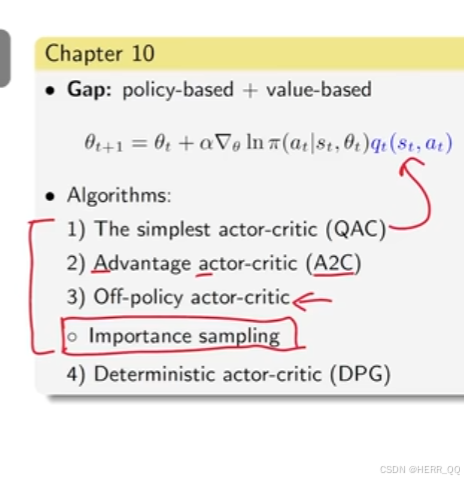
视频资源
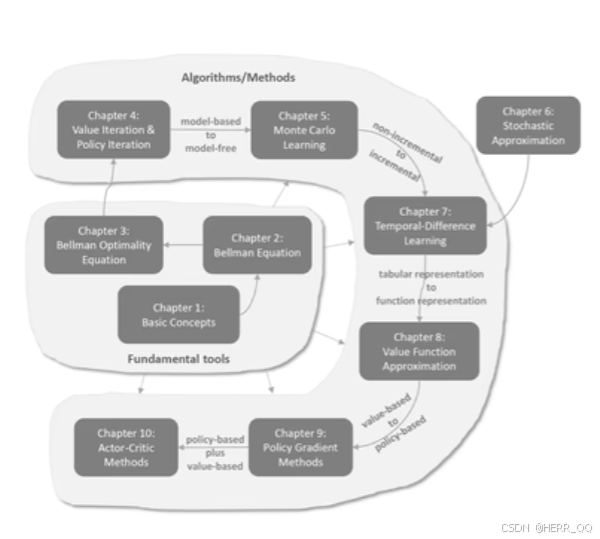
以下所有PPT的截图都来自于老师课件,可在视频链接中获取
Chapter 1
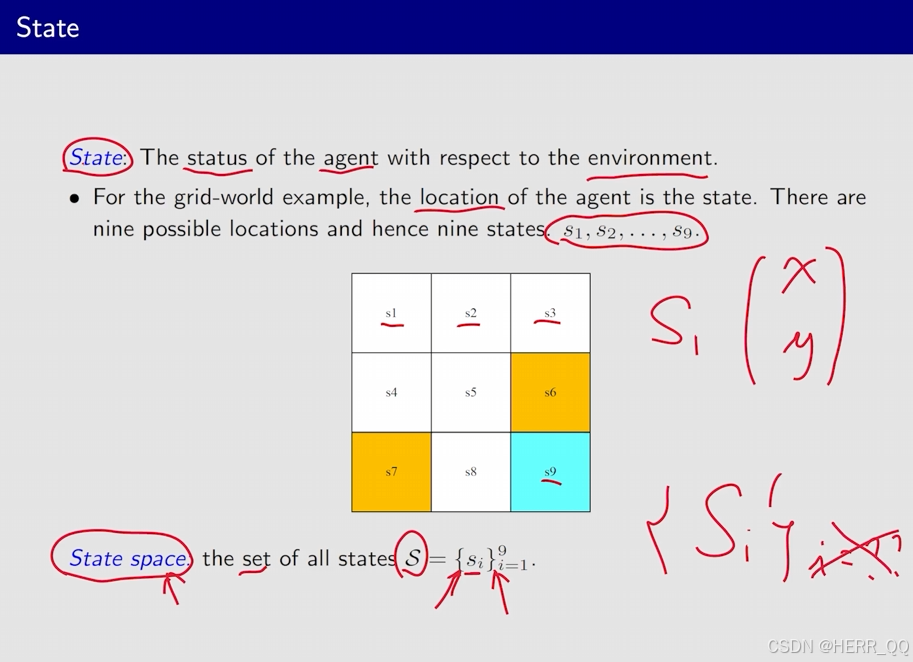
- state state space
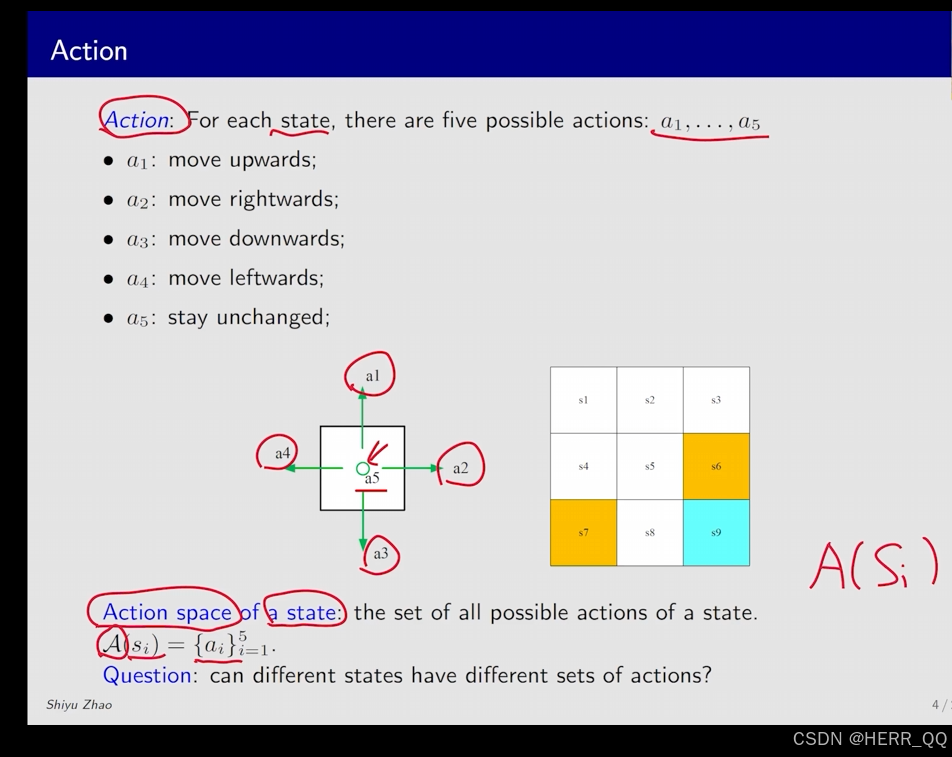
- action
action space of a state
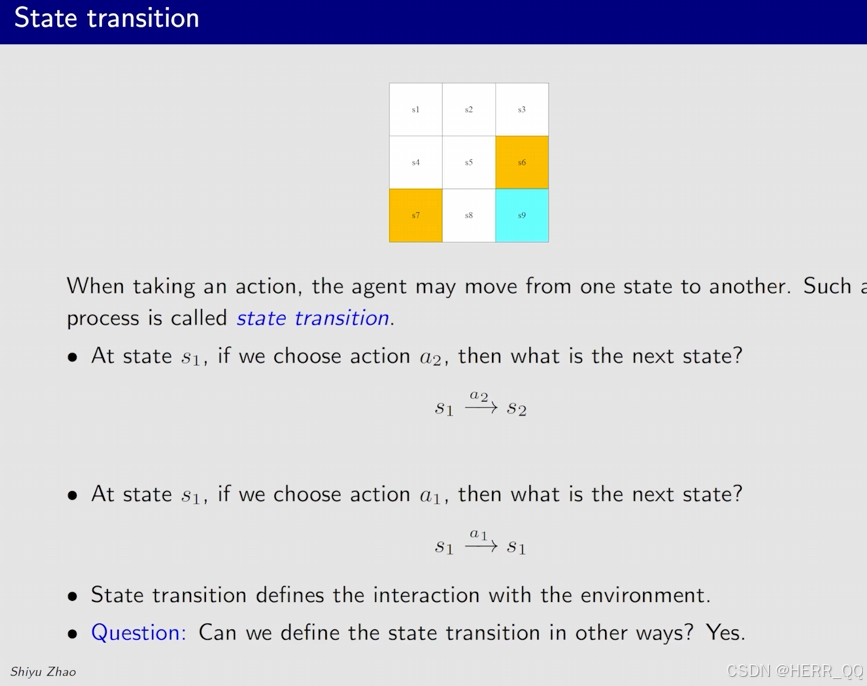
- state transition
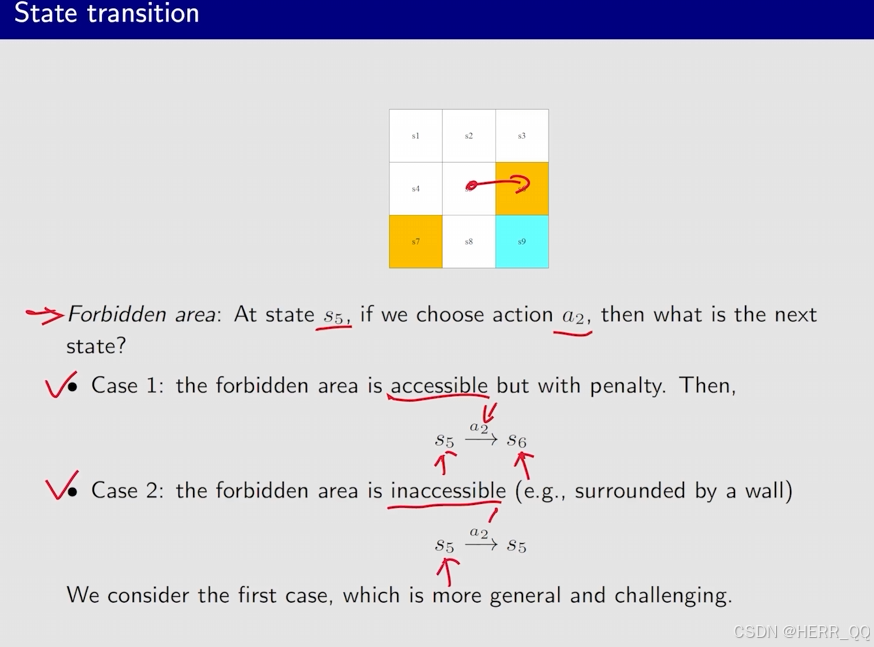
Q: penalty 设置的不合理 是不是训练结果就不理想了 和cost function 设置异曲同工?
是的,penalty(正则化惩罚项)设置不合理确实会导致训练结果不理想,这和代价函数(cost function)设计不当的影响是异曲同工甚至相辅相成的:一方面,如果 penalty 的类型(L1/L2)或系数 λ 选得不合适,比如 λ 过大容易欠拟合、λ 过小无法抑制过拟合,都会让模型在验证集上的泛化效果变差;另一方面,cost function 若不能正确衡量任务目标(如分类用均方误差、正负样本严重失衡未加权等),同样会使优化方向偏离最优解。二者本质都是在影响目标函数(total loss = cost function + penalty)的形貌与优化路径------cost function 引导模型去拟合数据分布,penalty 约束模型复杂度防止过拟合,任一方设计失当都会让最终学到的参数并非真正"最优",从而导致训练或泛化结果不理想。
Case 1 可能虽然惩罚 但是整体更近
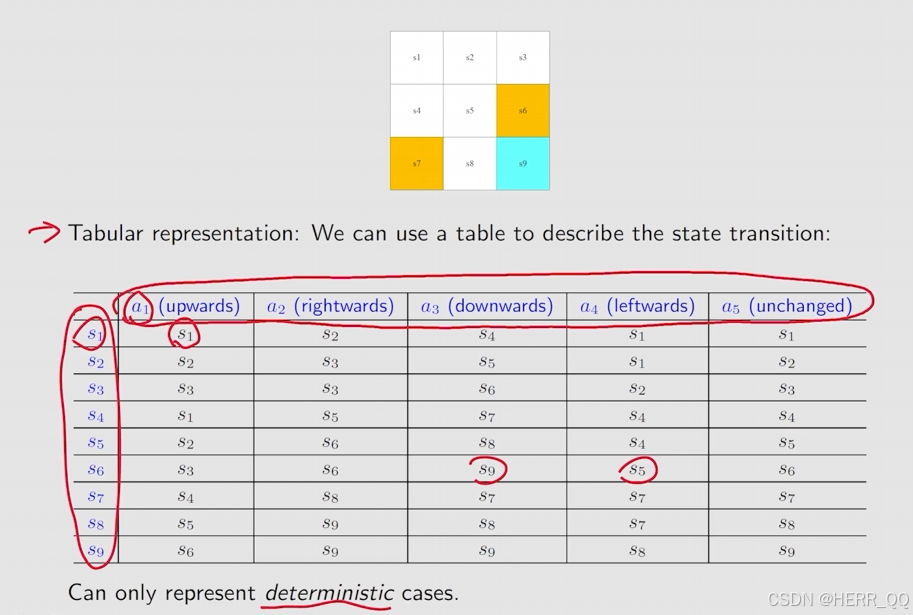
比较受限,只能表示确定的情况,实际可能一个状态transit到不同的情况
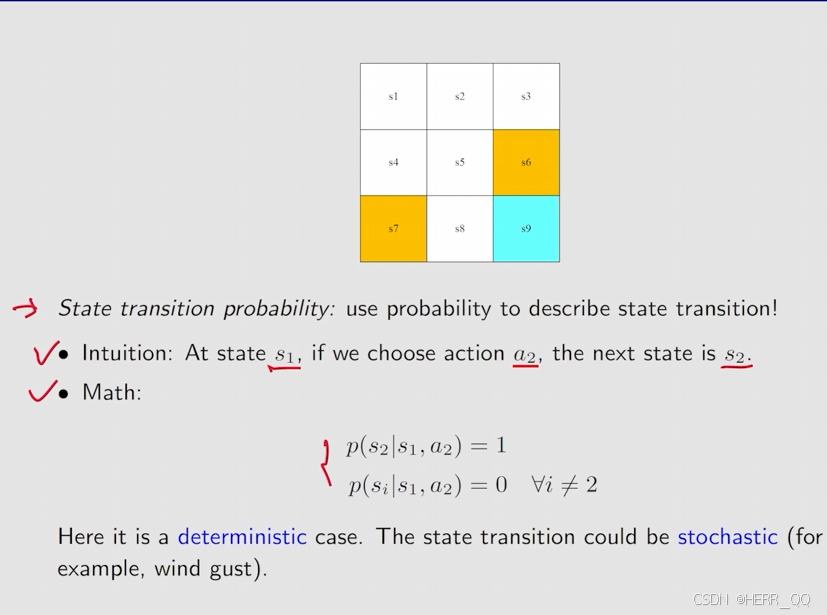
现在状态是s1 我采取a2的行动 跳到s2 的概率是1
如果是 stochastic 情况 可能各自是0.5
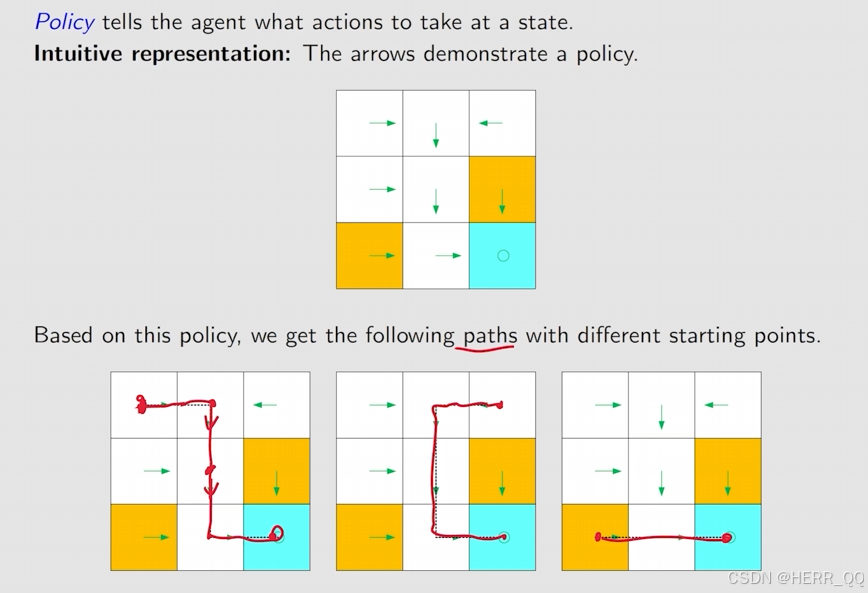
- policy
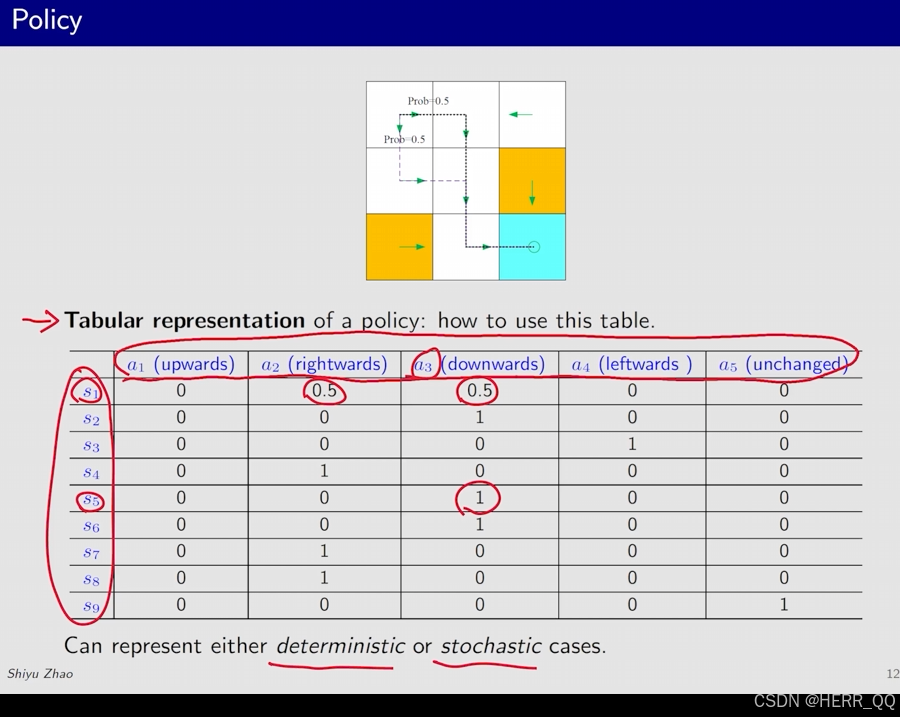
用箭头来表示
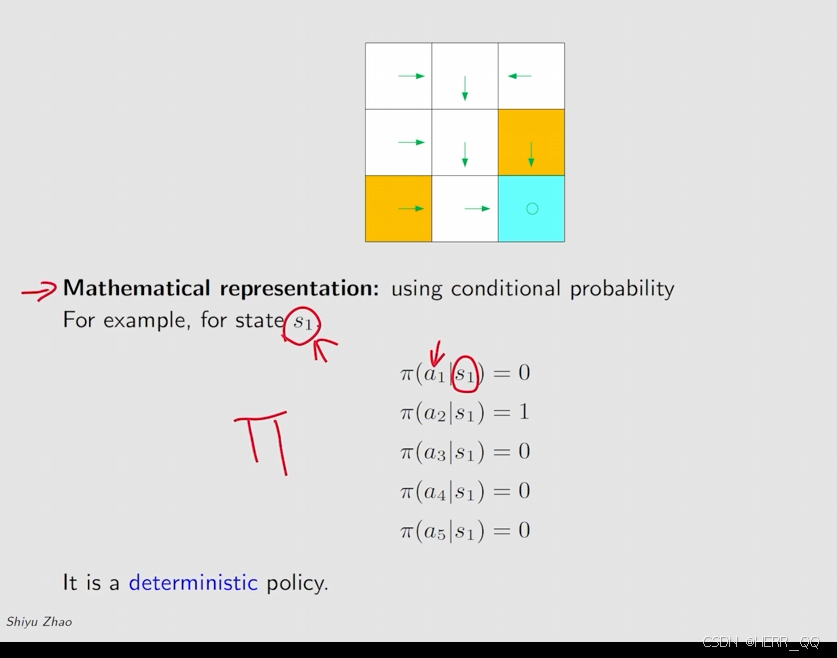
复杂情况则使用数学方式表达 pi 是条件概率,在状态S1下采取a1的概率为x
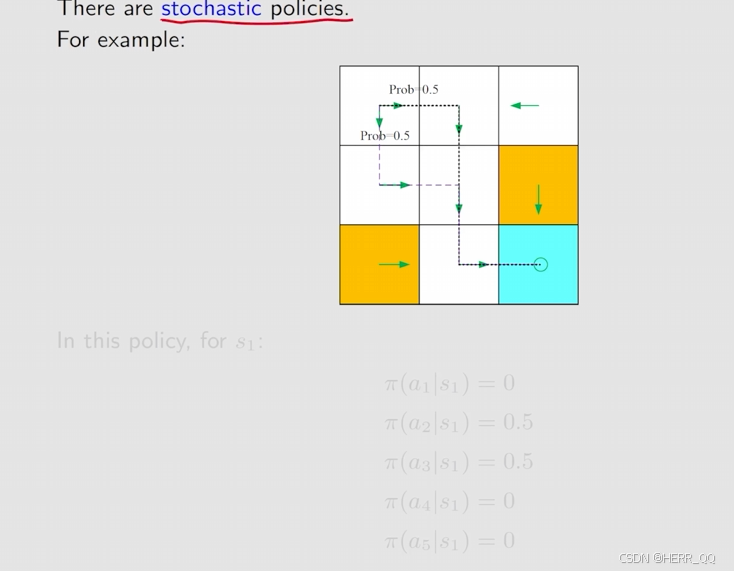
也分为 deterministic 和stochastic 情况
表格形式也可以表达
- reward
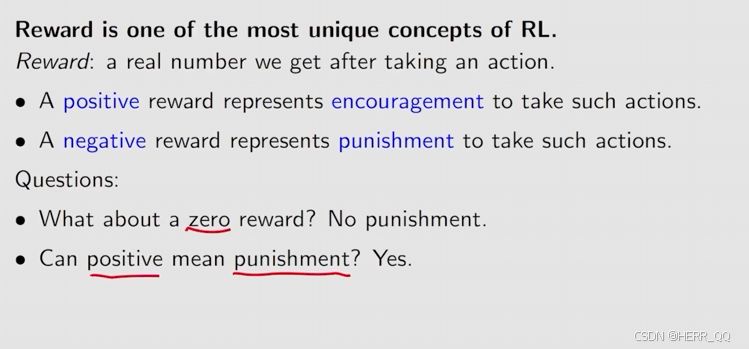
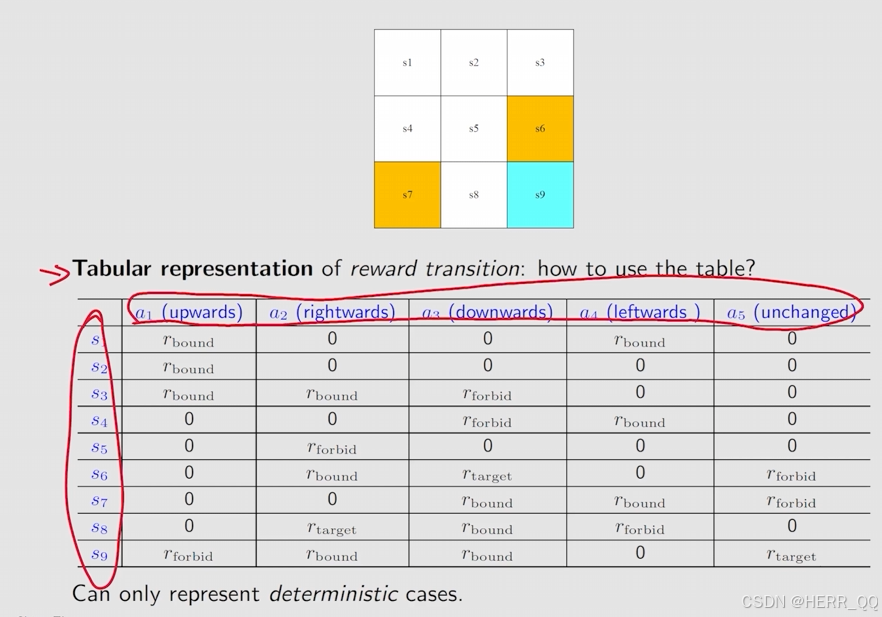
Q一般reward 我要怎么设计才合理 是不是和penalty要一样 怎么在实际中调整我的惩罚和奖励
在实际调 reward 时,核心是先保证"信号干净、尺度一致",再慢慢平衡奖励和惩罚,而不是追求数学对称。你可以先把 reward 拆成三部分:完成主目标的稀疏大奖励(比如任务成功给 +1)、过程小奖励(如接近目标给 +0.01)、以及行为惩罚(如每步 -0.001、撞墙 -0.1)。惩罚不要和奖励硬对齐,而是用来"压掉坏行为、拉长探索时间",比如步数惩罚是为了鼓励高效策略,违反约束的惩罚要明显大于单步收益,避免模型学会"靠犯错刷分"。实际调参时,先用只有 reward 的简化环境看能否学到基础行为,再逐步加入 penalty,观察 reward curve:如果 early stopping 太早、策略很保守,就减小 penalty 或给更多过程奖励;如果疯狂试探边界、频繁违规,就适当加大对应惩罚。最后记得做 reward scaling,把总 reward 控制在相近量级(比如 -1,1 或 -10,10),避免某一块主导梯度,这样训练会更稳、调参也更直观
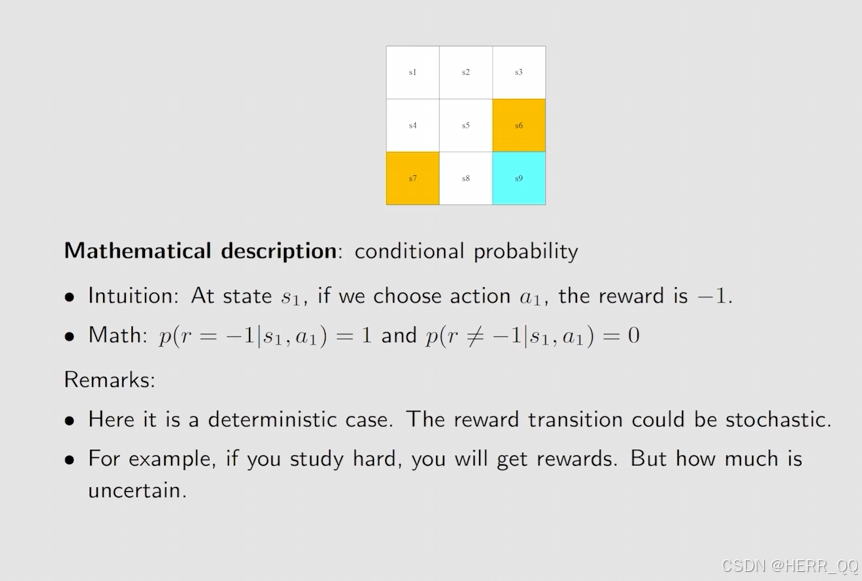
reward 形式也可以是随机的
- trajectory and return
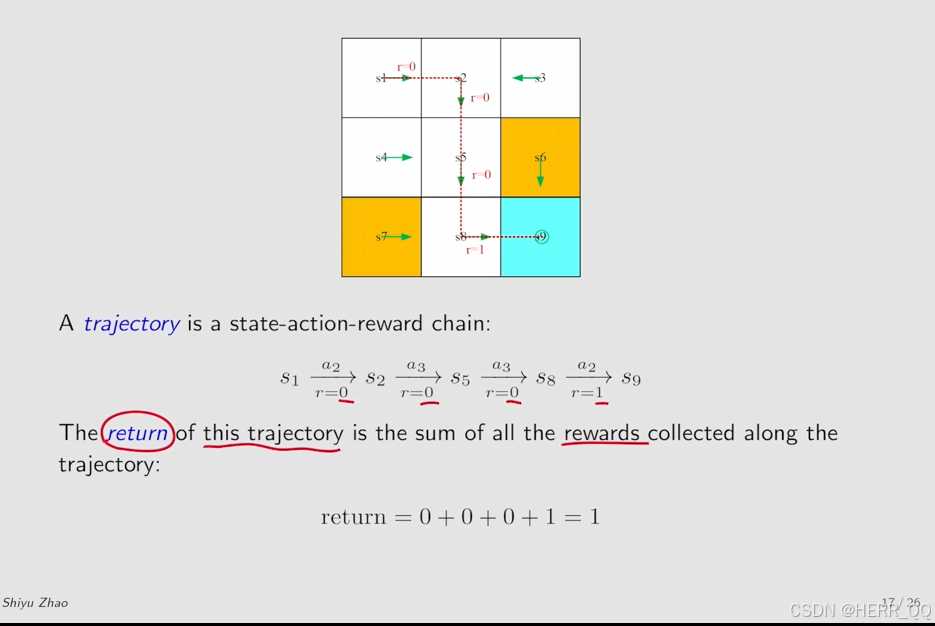
return 是一个总的reward
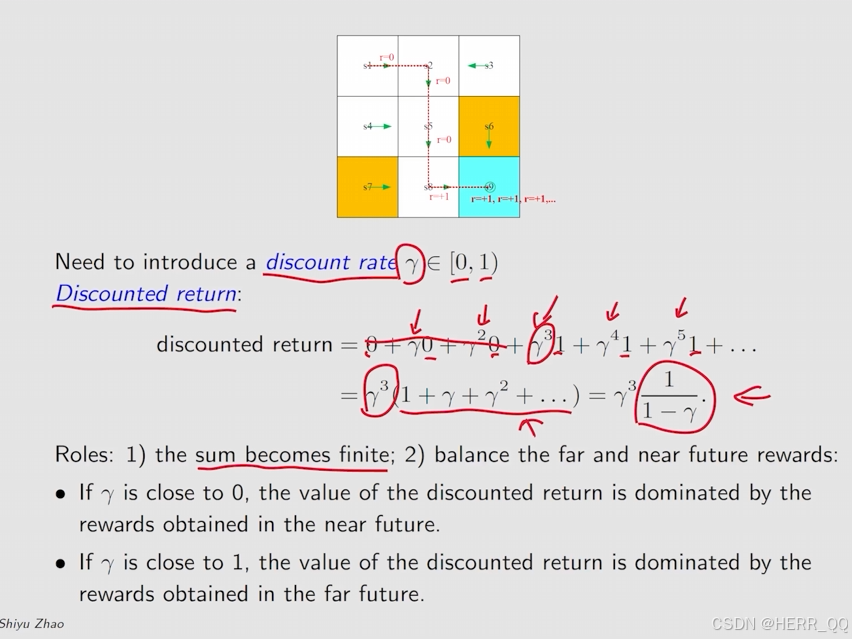
防止在变大的sum值引入折扣率 等比数列公式以及由于 折扣率小于1 最后化简
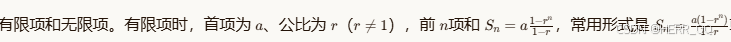
- episode
对于有terminal state的trial 我们称为episode 反之 continuing tasks
对于二者 我们可以统一处理
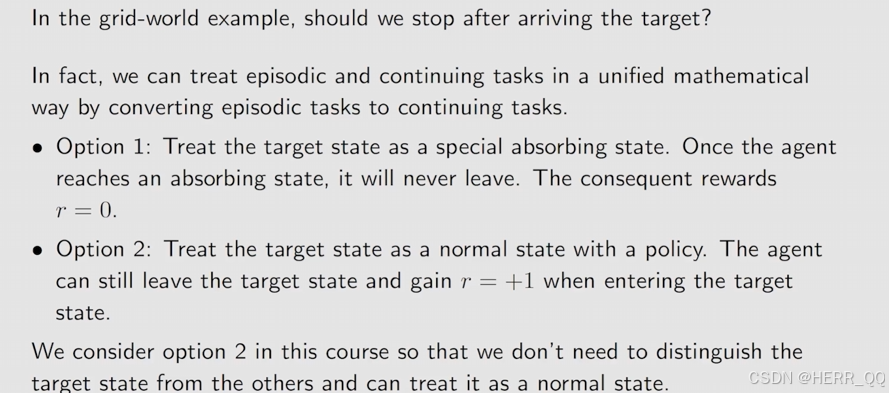
使用case 2 的话 就不用区分 target state了 和其他normal state一样
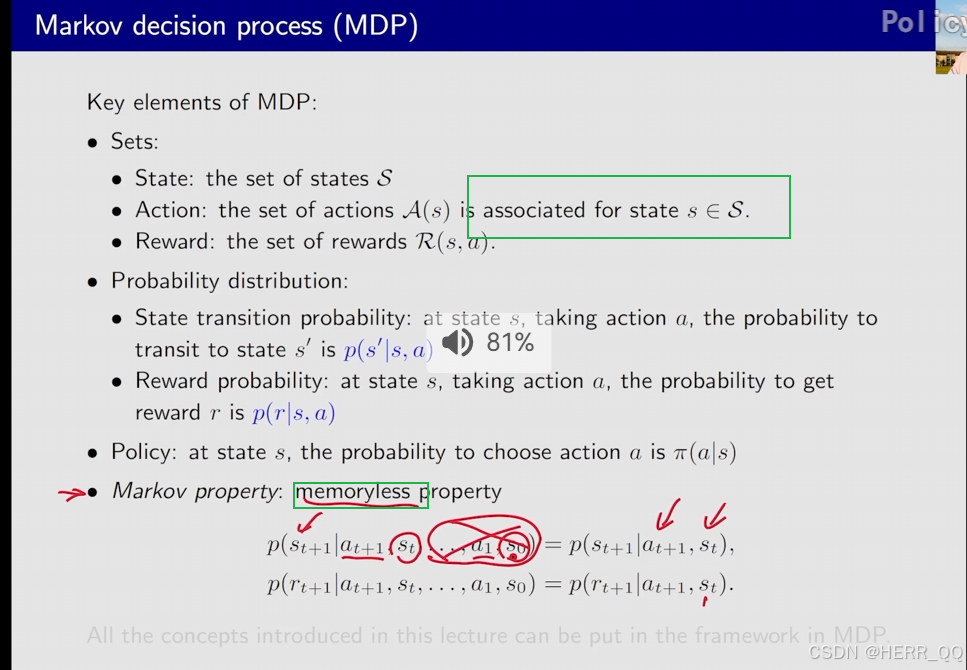
- MDP
历史无关性
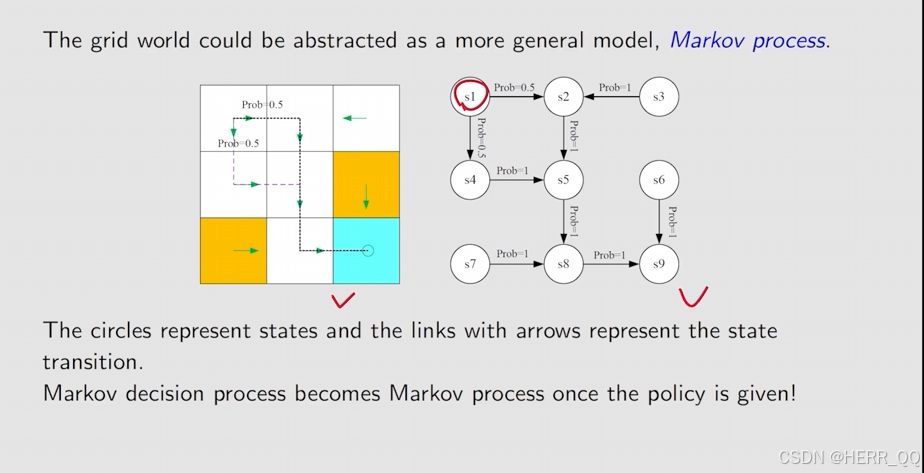
如果policy 确定了 那么就编程马尔科夫过程
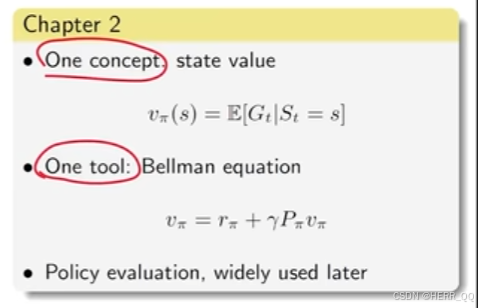
Chapter 2
Chapter 3
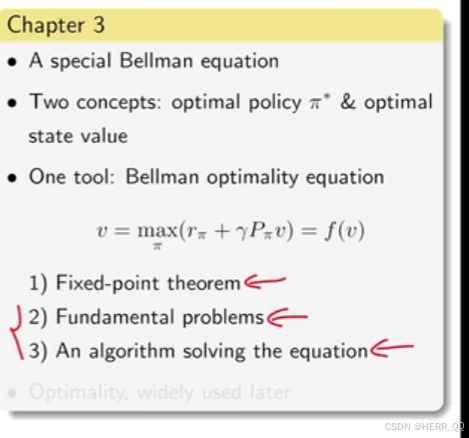
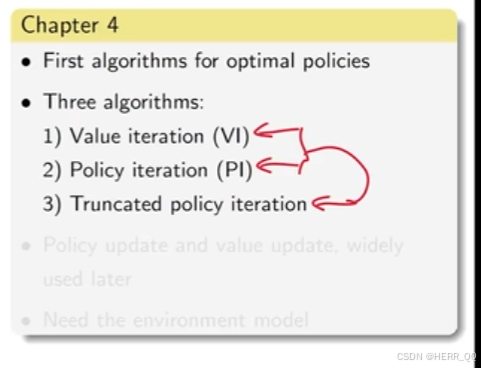
Chapter 4
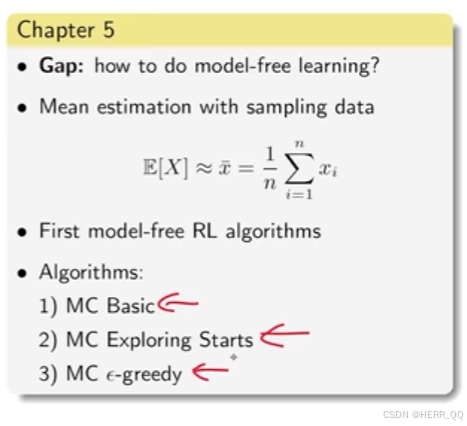
Chapter 5
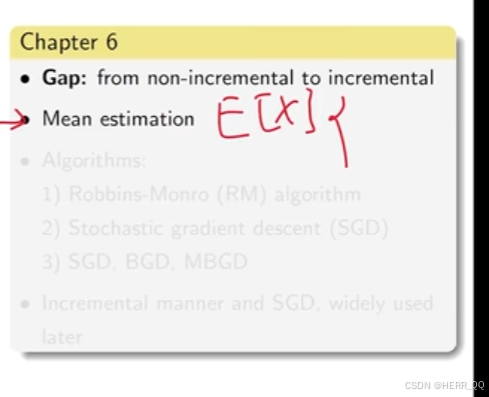
Chapter 6
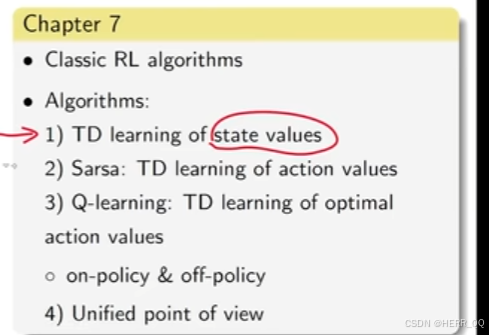
Chapter 7
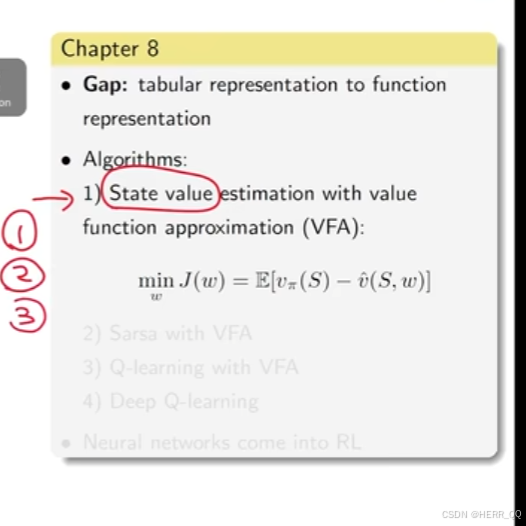
chapter 8
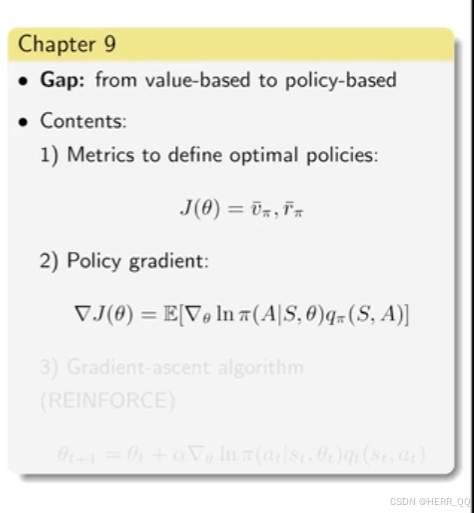
chatpter 9
Chapter10