OpenMP学习1------超算习堂
一、for循环并行
运用预编译命令:
c
#pragma omp parallel for
	for(......)
	{
		/* Content */
	}
1.1、举个实例,对比性能
cpp
#include <omp.h>
#include <cstdio>
#include <cstdlib>//用到rand()函数
#include <ctime>   //用到clock()函数

const int maxn = 1e8;

int main()
{
	int begintime, endtime;
	printf("It is use parallel compute:\n");

	begintime = clock();	//计时开始
#pragma omp parallel for
	for (int i = 0; i < maxn; ++i);
	endtime = clock();	//计时结束
	printf("\n\nRunning Time:%dms\n", endtime - begintime);


	printf("\n\n\nIt is not use parallel compute:\n");
	begintime = clock();	//计时开始
	for (int i = 0; i < maxn; ++i);
	endtime = clock();	//计时结束
	printf("\n\nRunning Time:%dms\n", endtime - begintime);
	return 0;
}
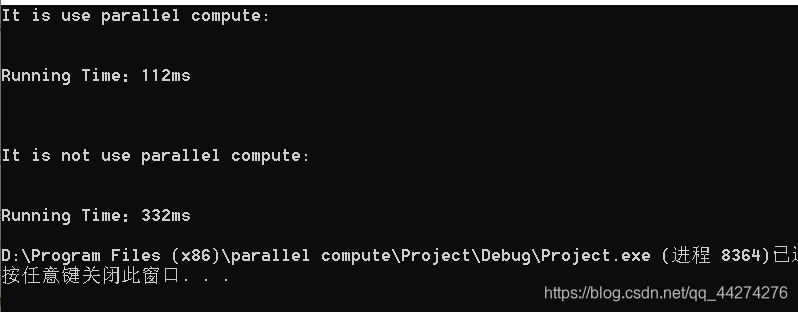
性能差距如下:
二、控制参与计算的线程数
cpp
#include <omp.h>
#include <cstdio>
#include <cstdlib>//用到rand()函数
#include <ctime>   //用到clock()函数

const int maxn = 1e8;

int main()
{
	int begintime, endtime;
	int nthreads;
	printf("It is use parallel compute:\n\n\n");
#pragma omp parallel
	nthreads = omp_get_num_threads();
	printf("Now, it is %d threads\n", nthreads);
	begintime = clock();	//计时开始
#pragma omp parallel for
	for (int i = 0; i < maxn; ++i);
	endtime = clock();	//计时结束
	printf("\nRunning Time:%dms\n", endtime - begintime);

#pragma omp parallel
	nthreads = 12;
	omp_set_num_threads(nthreads);
	printf("\nNow, it is %d threads\n", nthreads);
	begintime = clock();	//计时开始
#pragma omp parallel for
	for (int i = 0; i < maxn; ++i);
	endtime = clock();	//计时结束
	printf("\nRunning Time:%dms\n", endtime - begintime);

	printf("\nIt is not use parallel compute:\n");
	begintime = clock();	//计时开始
	for (int i = 0; i < maxn; ++i);
	endtime = clock();	//计时结束
	printf("\nRunning Time:%dms\n", endtime - begintime);
	return 0;
}
修改之前的那一份代码,首先用函数:
cpp
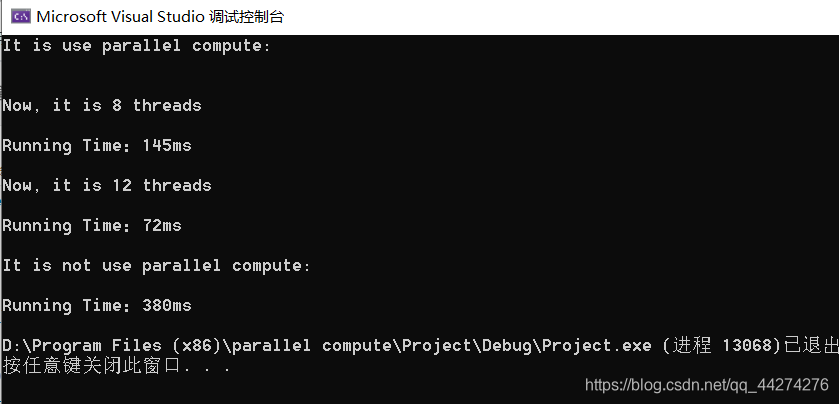
int nthreads = omp_get_num_threads();获知当前并行计算的的线程数,我这边默认的线程数是 8 个线程。需要注意的是,omp的函数接口,一定要写在并行区域内,也就是宏指令内!!!
看看效果:
提出一个思考:
如果我设置的并行线程数只有 1 ,那么它和串行计算相比较,效率结果会如何呢??
实验一下:
cpp
#pragma omp parallel
	nthreads = 1;
	omp_set_num_threads(nthreads);
	printf("\nNow, it is %d threads\n", nthreads);
	begintime = clock();	//计时开始
#pragma omp parallel for
	for (int i = 0; i < maxn; ++i);
	endtime = clock();	//计时结束
	printf("\nRunning Time:%dms\n", endtime - begintime);

	printf("\nIt is not use parallel compute:\n");
	begintime = clock();	//计时开始
	for (int i = 0; i < maxn; ++i);
	endtime = clock();	//计时结束
	printf("\nRunning Time:%dms\n", endtime - begintime);
看看结果:
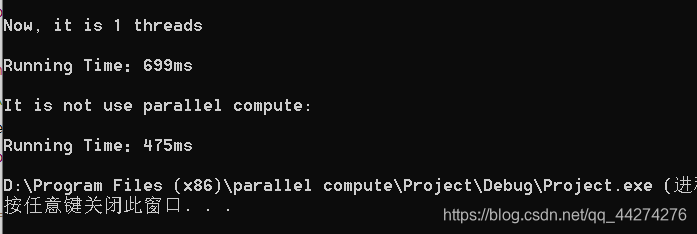
可以看到:单线程的并行计算要比串行计算慢了近1倍!!!为什么呢?
其实不难理解,但线程非但没有进行计算任务的分配(就他一个光杆司令,没法分配),但是宏指令下的还是并行,所以线程间不起作用的并行过程拖延了时间!!导致了上述的结果。
三、OpenMP的并行计算模式
OpenMP和之前我们学习的MPI有着较大的区别,那就是计算模式:
MPI:核心是不共享内存,并行计算依赖于消息传递,只有消息传递各个进程间才能共享数据。只有共享数据才能做到并行计算。因此,MPI的计算模式是所有进程运行同样的程序,这个程度都是一样的,也都是完整的。如何确定消息的收发方依赖于进程的秩。
OpenMP:核心是插入并行语句块,各个线程间共享内存。依赖private和shared指令来区分各个线程在并行区计算的数据是否共享。然后需要等待并行计算区的语句全都执行完,然后一定会回到串行程序,直到程序运行结束。