机器学习决策树里,基尼系数(Gini Index)是一个用来衡量数据"纯度"(或者说"混乱程度")的指标。它的核心思想是:从一个数据集中随机抽取两个样本,它们属于不同类别的概率。
1. 直观理解:基尼系数越小越好
基尼系数= 0:意味着数据集最"纯"。随机抽两个样本,它们一定属于同一类别(概率为0,即不会抽到不同类)。比如一个盒子里全是红球。
基尼系数= 0.5(在二分类中最大):意味着数据集最"混乱"。随机抽两个样本,有一半的概率抽到不同类别。比如盒子里红球和蓝球各占一半。
决策树分支的目标,就是通过不断划分,让分支后的子节点基尼系数尽可能小(即更纯)。
2. 数学计算公式
对于一个包含K 个类别(K 类分类问题)的数据集,基尼系数的计算公式为:
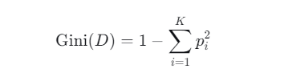
其中p_i 表示数据集中第 i 个类别样本所占的比例。
3. 举个简单的计算例子
假设有一个数据集,里面只有两种标签:好瓜和坏瓜。
情况一:纯数据集
有10 个好瓜,0 个坏瓜。
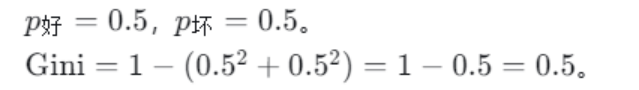
结论:基尼系数为0,纯度最高。
情况二:平衡数据集
有5 个好瓜,5 个坏瓜。
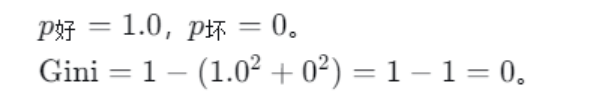
结论:基尼系数为0.5,混乱程度达到最大值。
4. 决策树如何使用它?(回顾上一题)
决策树在选择"用哪个特征来划分"时,流程如下:
-
计算父节点的基尼系数(作为参照)。
-
尝试用特征A划分:划分后产生两个子节点,计算每个子节点的基尼系数,然后按子节点样本量占父节点的比例进行加权平均,得到特征A划分后的总体基尼系数。
-
尝试用特征B划分:同上,计算总体基尼系数。
-
做选择:比较所有特征,选择那个划分后总体基尼系数最小的特征作为当前节点的分支特征。因为这意味着它能让数据变得最"纯"(也就是"基尼增益"最大)。
-
基尼系数 vs 信息熵(简单补充)
你可能也会遇到"信息熵"这个概念,它也是衡量纯度的指标。两者的区别是:
基尼系数:计算量稍小(不需要计算对数),效率略高,因此在CART 决策树(scikit-learn 默认)中被广泛使用。
信息熵:计算稍复杂,两者在大部分场景下表现相近。
基尼系数在决策树中就是一个"纯度打分器",分数越低,数据分类越清晰,也就是想要的分支效果。
文章至此。