PPO 超参数消融实验记录:batch_size / clip_range / gae_lambda / lr 谁才是真·关键?
实验环境:PPO / Pendulum-v1
总步数:3M steps
每组实验均跑通完整曲线,监控 train/loss、value_loss、episode/reward 三项。
实验设置
| 实验组 | 变量 | 取值 |
|---|---|---|
| batch_size 对照 | batch_size | 32 / 64 / 128 |
| clip_range 对照 | clip_range | 0.1 / 0.2 / 0.4 |
| gae_lambda 对照 | gae_lambda | 0.9 / 0.99 |
| learning_rate 对照 | lr | 1e-5 / 1e-4 / 1e-2 |
基线其他超参保持一致(n_steps=2048, n_epochs=10, gamma=0.99 等)。
一、batch_size:稳定梯度的基石
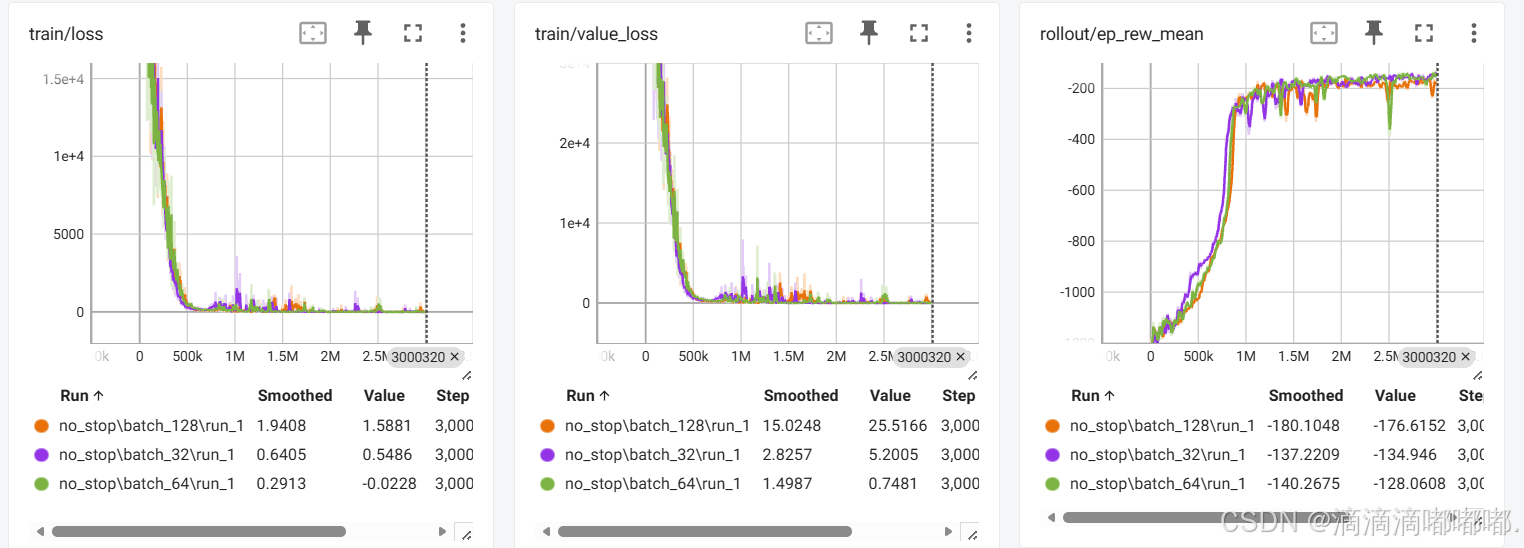
观察:
- batch_64 综合最优(loss ≈ 0.29,reward ≈ -140)
- batch_32 梯度方差大,收敛慢;batch_128 虽 loss 低但 reward 反而最差(-180)
解读:
batch 不是越大越好。64 在梯度稳定性与探索随机性之间取得平衡;128 的梯度过"平",容易陷入局部最优,reward 上不去。
**结论:batch_size = 64 **
二、clip_range:PPO 的"安全锁"
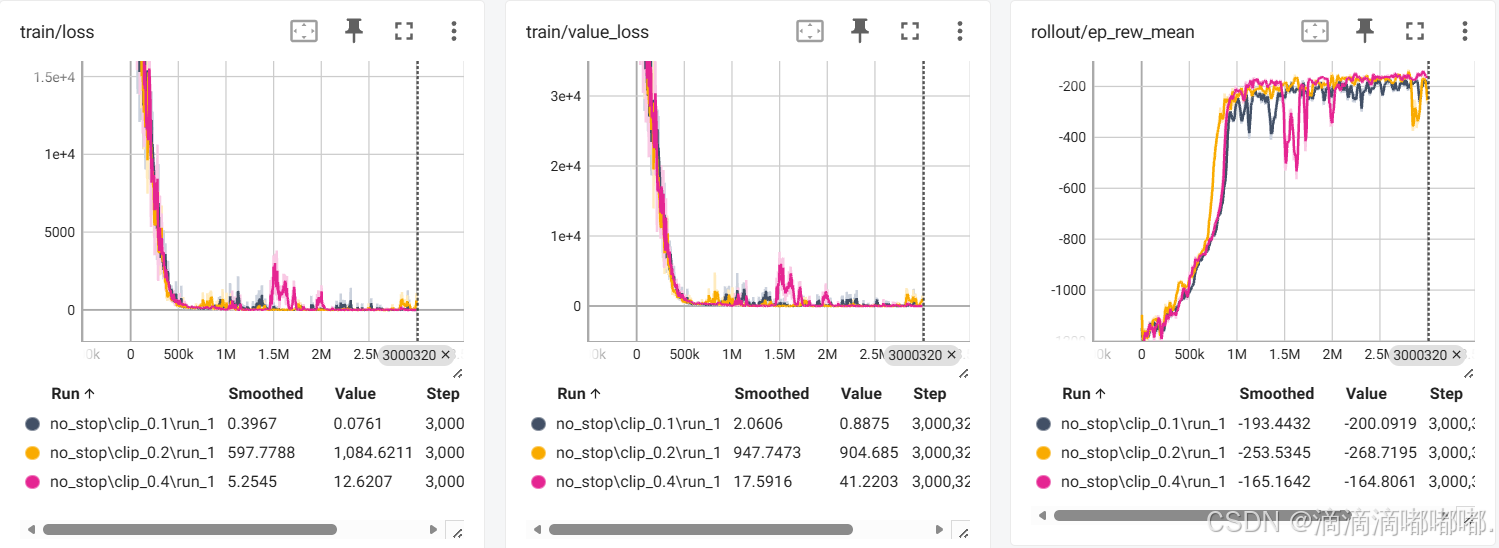
观察:
- clip_0.1 全程平稳,reward 最高(-140)
- clip_0.2 / 0.4 在 1M steps 后 loss 飙到 1000+,reward 断崖(0.2 掉到 -193)
解读:
clip 过大 → 策略更新无约束 → 偶然高回报动作被放大 → 破坏已学策略 → 退化震荡。0.1 保守但稳,符合 PPO "信任域" 的设计初衷。
结论:clip_range = 0.1 (比默认 0.2 还小,值得记下来)
三、gae_lambda:偏差 vs 方差的 trade-off
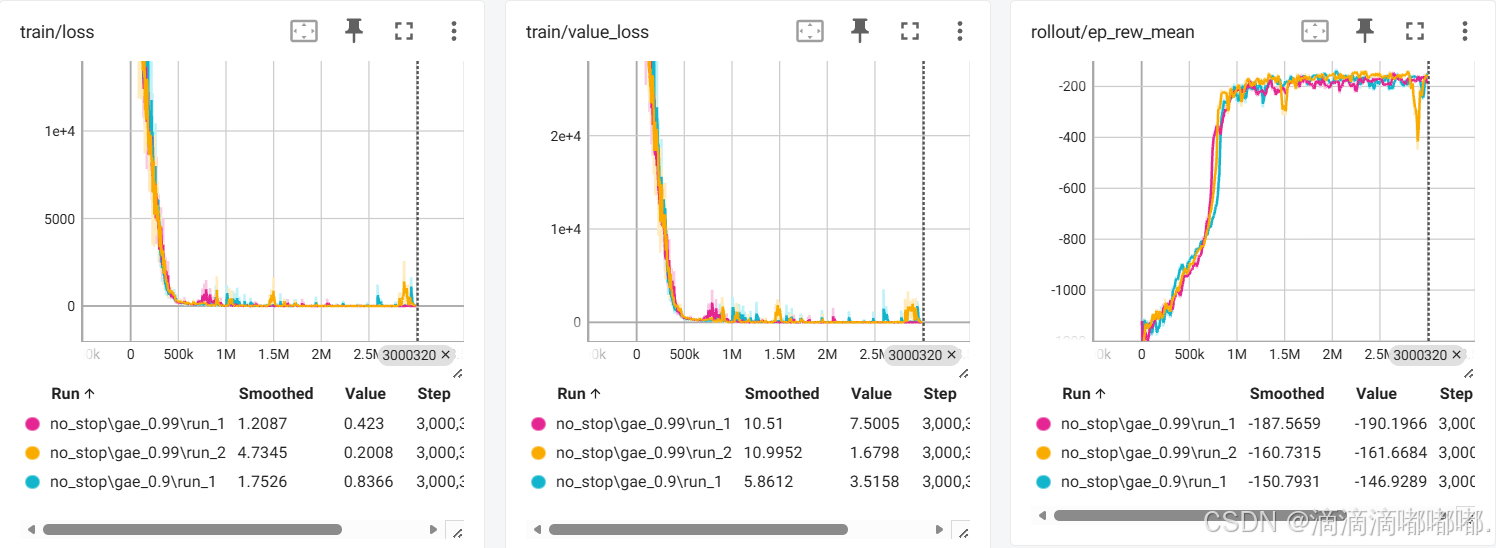
| 取值 | 偏向 | 表现 |
|---|---|---|
| 0.9 | TD(低方差,高偏差) | 曲线平滑,reward ≈ -150 |
| 0.99 | MC(低偏差,高方差) | 毛刺多,但 reward ≈ -187,上限更高 |
解读:
0.99 敢看长远,bias 低,最终分数更高;0.9 虽稳但容易停在次优。如果你嫌 0.99 毛刺多,折中取 0.95 是业界金线。
结论:gae_lambda = 0.99(或 0.95 折中)
四、learning_rate:最容易翻车的参数
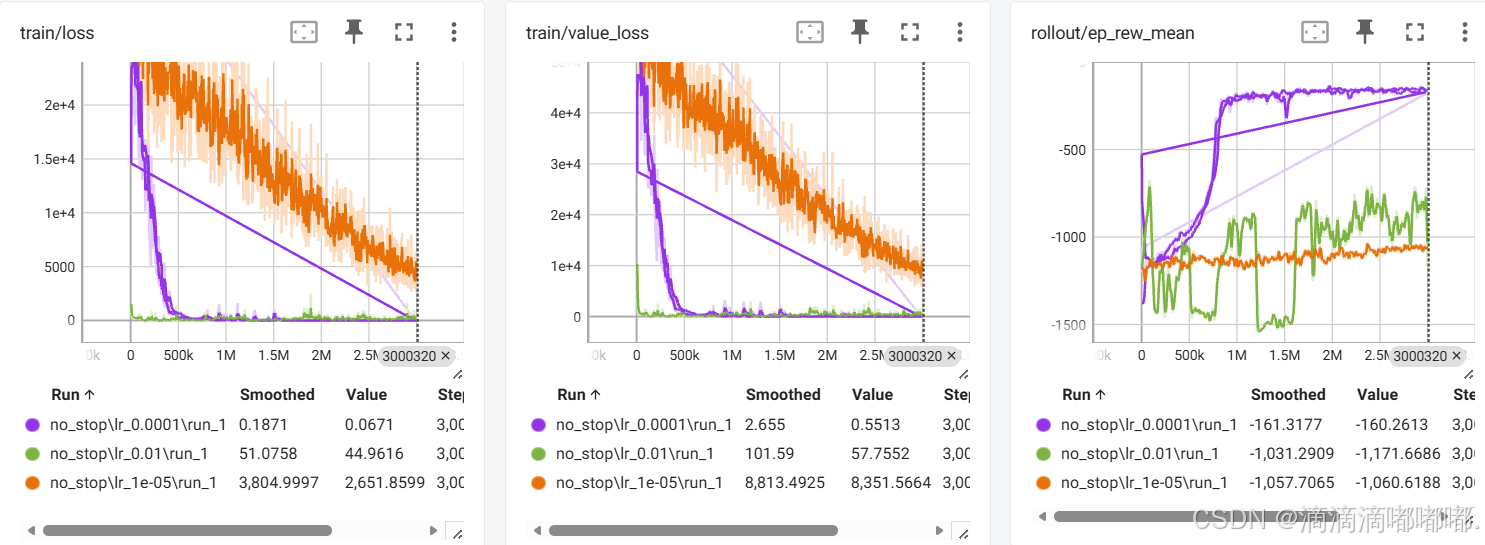
翻车现场:
- lr=1e-2:reward 断崖到 -1000 以下,loss 剧烈震荡 → 训练崩溃
- lr=1e-5:曲线平滑但 3M steps 还没爬起来,loss 仍几千 → 效率灾难
- lr=1e-4:平滑收敛,reward ≈ -161,综合最佳
解读:
RL 里 lr 比监督学习更敏感,PPO 官方推荐 3e-4,这次 1e-4 更适配本环境。
**结论:lr = 1e-4 **
五、综合最优配置
| 超参 | 推荐值 | 理由 |
|---|---|---|
| batch_size | 64 | 梯度稳 + reward 高 |
| clip_range | 0.1 | 比默认 0.2 更稳,不退化 |
| gae_lambda | 0.99(或 0.95) | 上限更高 |
| learning_rate | 1e-4 | 避坑 1e-2 崩溃 & 1e-5 太慢 |
一些碎碎念
💡 这次实验最有意思的发现是 clip_0.1 比默认的 0.2 好------很多教程抄 Stable Baselines3 默认 0.2 就完事了,但小环境里 0.2 反而会后期震荡。超参没有"永远正确",还是得自己扫一遍。
⚠️ value_loss 后期尖峰记得留意,如果伴随 reward 掉,可以查下是不是 env 有异常 transition,或者把 value_clip 也开起来。