用通俗的语言来解释 GBDT 算法是一个有挑战性的事情。尤其是对 GBDT 中先用1号树模型去拟合Y值,得到了残差E值,然后再用2号树模型去拟合E值,最后把1号模型和2号模型相加得到之中的Y值估计值。说起来容易,解释起来很有难度。
这里,尝试使用一个最简单的例子去解释上面所说的 GBDT 算法原理。
先给出数据,前三个(性别、地区、年龄)都是特征变量X,最后的生活成本是标签变量Y。
|----|----|----|-------|
| 性别 | 地区 | 年龄 | 生活成本Y |
| 男 | 城市 | 老年 | 440 |
| 男 | 乡村 | 老年 | 320 |
| 女 | 城市 | 老年 | 220 |
| 女 | 乡村 | 老年 | 120 |
| 男 | 城市 | 青年 | 360 |
| 男 | 乡村 | 青年 | 280 |
| 女 | 城市 | 青年 | 180 |
| 女 | 乡村 | 青年 | 80 |
(一)1号树模型的构建
为了解释 GBDT 原理,我们限制树模型的深度只能是2层(即代码中的超参数 max_depth=2)。这是因为,在我这个简单的示例中,如果树模型的深度允许是3层的话,一棵1号树模型就搞定了这个问题,此时 GBDT模型的结果就是 决策树 模型的结果,此时就不用解释 GBDT 了。
在树模型的深度只能是2层的限制下,咱们手动计算一下1号树模型的结果,过程如下:
GBDT 模型采用的是 最小化残差平方和 (squared error)的准则,来确定分支的。这个例子中就3个特征变量,(性别、地区、年龄),你自己算一下,并很容易算出首先采用 "性别"作为分裂,因为采用"性别"作分裂的残差平方和是 25600,是最小的。(采用"地区"作分裂的残差平方和是 85600,采用"年龄"作分裂的残差平方和是 100600. PS:个人手算,可能不对,但是不影响"性别"分裂 SE 最小的结论)这就是树模型的第一层。
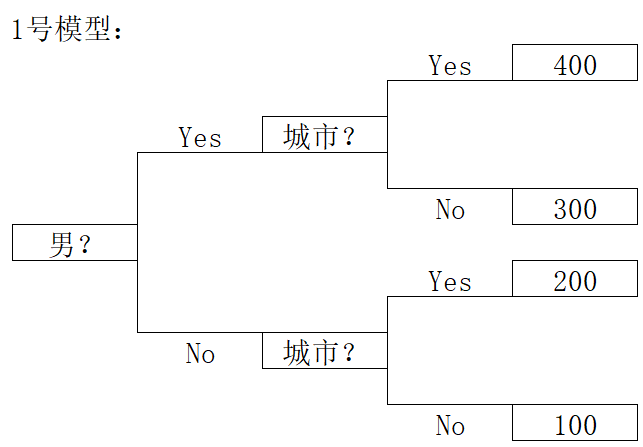
因为深度是2层,我们需要做出 2 层。同样是根据最小化残差平方和 (squared error)的准则,可以判断出,第2层分裂采用 "地区"特征进行。
于是我们得到 1 号树模型如下:
(二)2号树模型的构建
1号模型整完后,我们得到的残差E 如下图:
|----|----|----|-------|---------|------|
| 性别 | 地区 | 年龄 | 生活成本Y | 1号模型预测值 | 残差值E |
| 男 | 城市 | 老年 | 440 | 400 | 40 |
| 男 | 乡村 | 老年 | 320 | 300 | 20 |
| 女 | 城市 | 老年 | 220 | 200 | 20 |
| 女 | 乡村 | 老年 | 120 | 100 | 20 |
| 男 | 城市 | 青年 | 360 | 400 | -40 |
| 男 | 乡村 | 青年 | 280 | 300 | -20 |
| 女 | 城市 | 青年 | 180 | 200 | -20 |
| 女 | 乡村 | 青年 | 80 | 100 | -20 |
我们同样是用一个深度为2的树模型,去拟合残差值E。
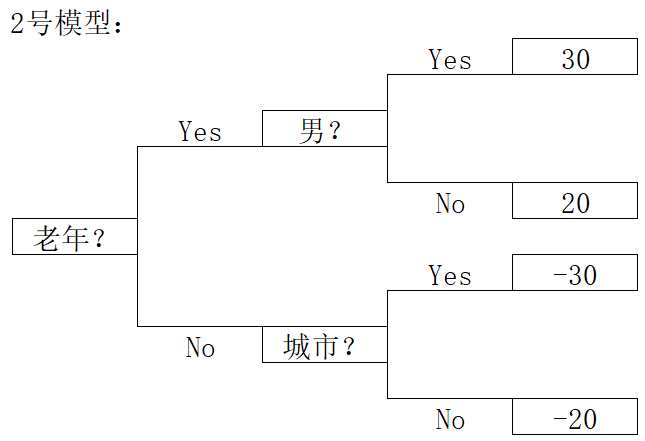
同样是采用 最小化残差平方和 (squared error)的准则,来确定分支的。这个例子中就3个特征变量,(性别、地区、年龄),你自己算一下,并很容易算出首先采用 "年龄"作为分裂,因为采用"年龄"作分裂的残差平方和是 600,是最小的。然后,采用"性别"或者"地区"作分裂的残差平方和都是 5600 ,可以计算,二者在下一层的分裂是没有差异的。随后,第二层我们对老年分支采用选"性别"做分裂,对青年分支选用"地区"做分裂。(这样做是因为 sklearn 是这样选的)
于是我们得到 2 号树模型如下:
(三)1号模型+2号树模型的结果
有了 1号模型和2号模型后,我们就可以对生活成本Y进行最终的预测,它就是两个模型的预测值之和,见下表。
|----|----|----|-------|---------|------|------------|-----------|
| 性别 | 地区 | 年龄 | 生活成本Y | 1号模型预测值 | 残差值E | 2号模型残差E预测值 | 生活成本Y的预测值 |
| 男 | 城市 | 老年 | 440 | 400 | 40 | 30 | 430 |
| 男 | 乡村 | 老年 | 320 | 300 | 20 | 30 | 330 |
| 女 | 城市 | 老年 | 220 | 200 | 20 | 20 | 220 |
| 女 | 乡村 | 老年 | 120 | 100 | 20 | 20 | 120 |
| 男 | 城市 | 青年 | 360 | 400 | -40 | -30 | 370 |
| 男 | 乡村 | 青年 | 280 | 300 | -20 | -20 | 280 |
| 女 | 城市 | 青年 | 180 | 200 | -20 | -30 | 170 |
| 女 | 乡村 | 青年 | 80 | 100 | -20 | -20 | 80 |
(四)python sklearn的验证代码
上面的理论推导,可以使用 python 中的 sklearn 验证一下。
前期的一堆非重要代码就略去了,只把关键的一句如下:
est = GradientBoostingRegressor( n_estimators=1, learning_rate=1, \
      max_depth=3, random_state=0, loss='squared_error' ).fit(x, y)
PyCharm跑完的结果对比如下:
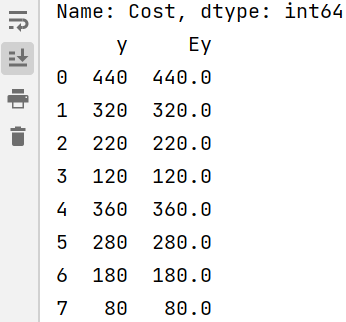
当然,目前的拟合结果在第0、1、4、6行依然有残差,这个可以通过代码中的超参 n_estimators 和 max_depth 的改变进行优化。比如, 让 n_estimators=1 和 max_depth=3,你立马就可以得到一个完美的决策树模型。你也可以保持 max_depth=2 但让 n_estimators=3,对残差继续加一个3号模型进行拟合,从而进一步让预测值靠近样本值。n_estimators=3的算法原理和 n_estimators=3 是一样的,因此在这里也就不再赘述了。能够理解n_estimators=2 的场景,已经就可以理解 GBDT 的算法原理了。
以上,就是对 GBDT 算法原理的手动解释。