每次新模型一发布,我点开宣传页第一眼就是扫那一排数字。MMLU 90+、GPQA 登顶、HumanEval 行业领先...... 各家都把自己的分数摆得明明白白,清一色的 "业界第一梯队"。
说句实话,最开始我完全是懵的。这些字母组合到底啥意思?分数高就代表这个模型干啥都厉害吗?为啥同一个模型,A 家说它推理最强,B 家又说自己代码能力碾压? 直到我把这些 benchmark 挨个扒了一遍,才搞懂这里面的门道 ------ 说白了,这就是大模型的 "高考",但比高考鸡贼多了。
Benchmark 到底是个啥?
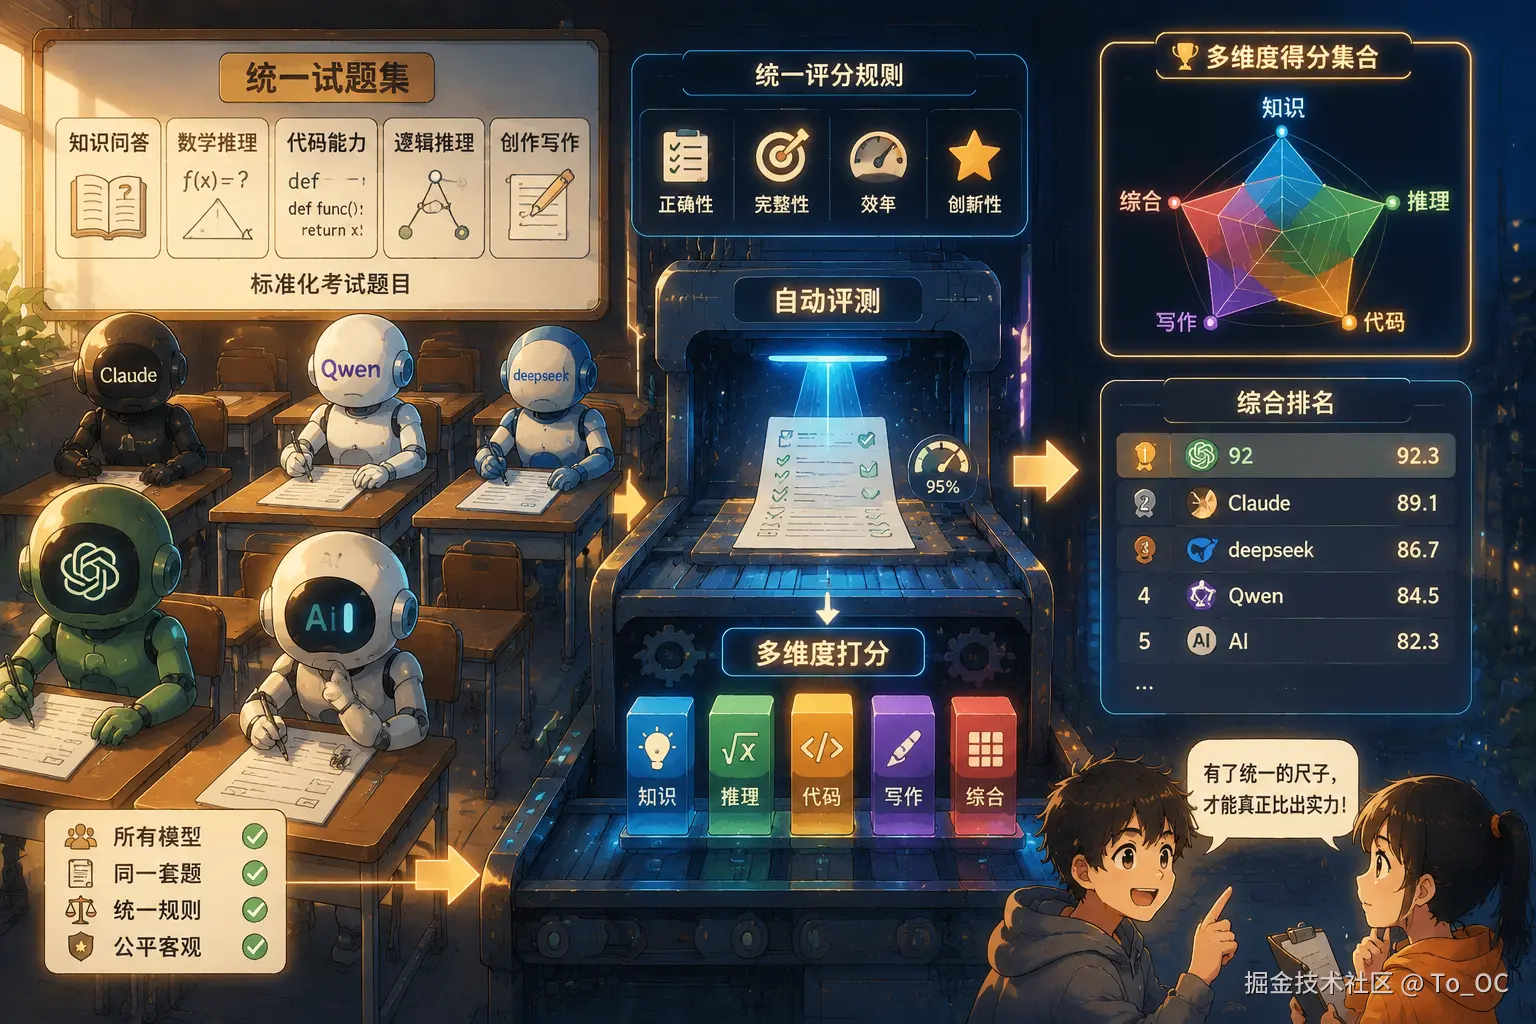
先掰扯最基础的:benchmark 本质上就是一套标准化的考试题。
给所有大模型做同一套题,统一打分规则,最后出来一个多维度的分数集合。就像我们上学时的全省统考,大家做同一张卷子,才能相对客观地比出高低。
为啥非得搞这玩意儿?现在大模型太多了,GPT、Claude、DeepSeek、Qwen...... 数都数不过来。你说你强,我说我厉害,总不能全靠嘴说吧?总得有个统一的尺子。 而且大模型的能力本来就是多维度的。有的懂的多,有的会推理,有的写代码顺手,单说 "好不好用" 太主观了。benchmark 就是把这些模糊的能力拆成一个个具体科目,挨个量化考核。
这些常见跑分项,到底在考什么?
我最头疼的就是一堆英文缩写,记不住也搞不懂。后来我把它们挨个对应成 "考试科目",一下就清晰了。
MMLU:最通用的 "文理综合卷"
MMLU 全称是 Massive Multitask Language Understanding,翻译过来挺绕的,你就把它当成大模型的 "文理综合考试" 就行。
这套题一共覆盖 57 个学科,从初中历史到大学医学,啥领域都有,全是选择题。它考的不是深度钻研能力,就是知识广度 ------ 看你脑子里装的东西够不够多,涉猎够不够广。
一般宣传页里第一个放的基本都是它,因为最通用,认知度最高。但说实话,这个分数高,只能说明这模型 "见多识广",真要解决复杂逻辑问题,还得看别的科目成绩。
GPQA Diamond:专门考 "真推理" 的难题卷
如果说 MMLU 考的是知识面,GPQA 考的就是纯纯的硬核推理能力。
它全称是 Graduate-Level Google-Proof Q&A,全是研究生级别的题目,物理、化学、生物这些理科为主。难到什么程度?名字里就写了 Google-Proof------ 就是你拿去搜谷歌,都很难直接找到现成答案。
为啥要出这么偏的题?就是防 "背答案"。有些模型训练的时候把题库都吃进去了,考分高纯粹是因为见过原题,不是真会推理。GPQA 这种搜都搜不到的题,才能考出来模型是不是真的能一步步思考。 我现在判断一个模型的推理水平,基本先扫一眼这个分数。这个分高的,处理复杂逻辑题一般不会太差。
HumanEval & SWE-bench:程序员最该看的代码卷
咱们写代码的,最关心的肯定是模型写代码行不行。这方面有两套很经典的卷子。
一个是 HumanEval,164 道编程题,让模型写函数,看能不能跑通所有测试用例。这个比较基础,相当于考你代码基础功扎不扎实。 另一个就狠了,SWE-bench。不是让你写小题,是直接拿真实 GitHub 项目里的真实 bug,让模型去定位修复。这就相当于不考期末测验,直接拉去公司做真实项目需求,更贴近实际工作场景。
踩过的坑 我之前踩过一个实打实的坑:看某模型 HumanEval 分数很高,就拿来写复杂业务代码,结果一塌糊涂。后来才发现,HumanEval 都是单函数的小题,真到多文件联动、有上下文的项目场景,还是 SWE-bench 的参考价值更高。
MATH / AIME:数学推理的试金石
数学能力其实是最能体现模型推理水平的科目之一。
MATH 就是竞赛级的数学题,AIME 更直接,就是美国数学邀请赛的原题。这类题不是靠背诵能解决的,必须一步步推导,中间哪一步逻辑错了,结果就完全不对。
很多人说大模型做数学是 "瞎蒙",其实看 AIME 的分数就能大概判断。能把 AIME 考好的模型,逻辑链条一般都比较完整,处理需要分步推导的问题会靠谱很多。
C-Eval:中文语境的专属考卷
前面说的那些基本都是英文为主的基准测试,放到中文场景里,其实会有偏差。
C-Eval 就是专门针对中文做的,覆盖 52 个学科,分四个难度等级。从日常常识到专业知识,都是中文语境下的题目。 如果你主要用模型处理中文任务,比如写文案、做中文文档、处理国内的业务问题,别光盯着 MMLU,C-Eval 的分数其实参考价值更高。
跑分表里的小心思:别被 "第一" 晃了眼
聊完这些科目,就得说说我后来才发现的门道 ------ 厂商的跑分宣传,其实都有小心机。
每次新模型发布,都会放一大堆 benchmark 数据,但你仔细看就会发现:每家重点突出的项都不一样。 有的模型知识广度强,就把 MMLU 放最大最显眼的位置;有的推理厉害,就把 GPQA 标成 "全球第一";有的代码见长,就主打 HumanEval 排名。
你要是只看他放出来的那几个数字,很容易觉得这模型天下无敌。但真去翻全量榜单,可能别的科目拉胯得不行。 说白了就是:单项第一 ≠ 整体最强。可能只是这门考试刚好考到它的强项上了。偏科的学生,总有一门能考年级第一,但你不能说他就是年级第一的学生。
跑分到底有啥用?是门槛,不是排行榜
搞懂这些之后,我现在看 benchmark 的心态完全变了。
它最有用的地方,是当 "门槛",不是当 "排行榜"。 一个模型如果连主流的 benchmark 都考得一塌糊涂,那大概率能力不行,直接可以 pass,不用浪费时间去试。这是用来筛下限的。
但反过来,分数高,也不代表它就一定适合你。 因为 benchmark 考的都是标准化场景,而我们真实的业务需求千奇百怪。有的场景需要超长上下文,有的需要精准调用工具,有的对响应速度要求极高,这些都不是纸面跑分能体现的。
我的习惯 我现在选模型的流程很固定:先拿主流 benchmark 筛掉一批分数太差的,剩下的候选,全部拿自己真实的业务需求去跑几轮。跑十次真实场景,比看一百次跑分都管用。
最后说两句
其实扒完一圈下来,我最大的感受就是:别迷信跑分。
benchmark 是个好东西,它给了我们一个相对客观的参考标尺,不用再盲人摸象一样挨个试。但它也只是个标尺,不是标准答案。
你要是问我记住了啥核心的,大概就是这三点: 第一,不同的 benchmark 考的是完全不同的能力,别拿一张卷子的分数给模型下定义。 第二,厂商宣传的 "第一" 看看就好,多翻几个维度的分数,才能看到模型的真实水平。 第三,跑分决定下限,实际体验决定上限。选模型最终还是要落到自己的使用场景里。
对了,你们平时选模型最看重哪项跑分?或者有没有踩过 "跑分很高但实际很难用" 的坑?评论区聊聊,我也想看看大家的经验。