目录
- [1 向量数据库基础](#1 向量数据库基础)
-
- [1 Milvus 架构介绍](#1 Milvus 架构介绍)
- [2 Milvus 数据结构](#2 Milvus 数据结构)
- [3 索引类型](#3 索引类型)
-
- [3.1 稠密向量 HNSW 索引](#3.1 稠密向量 HNSW 索引)
- [3.2 稀疏向量 倒排索引](#3.2 稀疏向量 倒排索引)
- [4 Milvus 部署](#4 Milvus 部署)
- [5 Collection 创建完整代码](#5 Collection 创建完整代码)
- [6 数据插入](#6 数据插入)
- [7 三大检索方式](#7 三大检索方式)
-
- [7.1 稠密向量单路检索](#7.1 稠密向量单路检索)
- [7.2 稀疏向量单路检索](#7.2 稀疏向量单路检索)
- [7.3 混合检索(RRF 重排序,最优方案)](#7.3 混合检索(RRF 重排序,最优方案))
- [7.4 标量过滤检索](#7.4 标量过滤检索)
- [8 完整 RAG 生成链路](#8 完整 RAG 生成链路)
- [9 本章小结](#9 本章小结)
1 向量数据库基础
普通数据库只能精确匹配,向量数据库专门做相似度模糊搜索,存储文本 / 图片多维向量。 常用向量库:Milvus、FAISS、Chroma、Pgvector、Redis
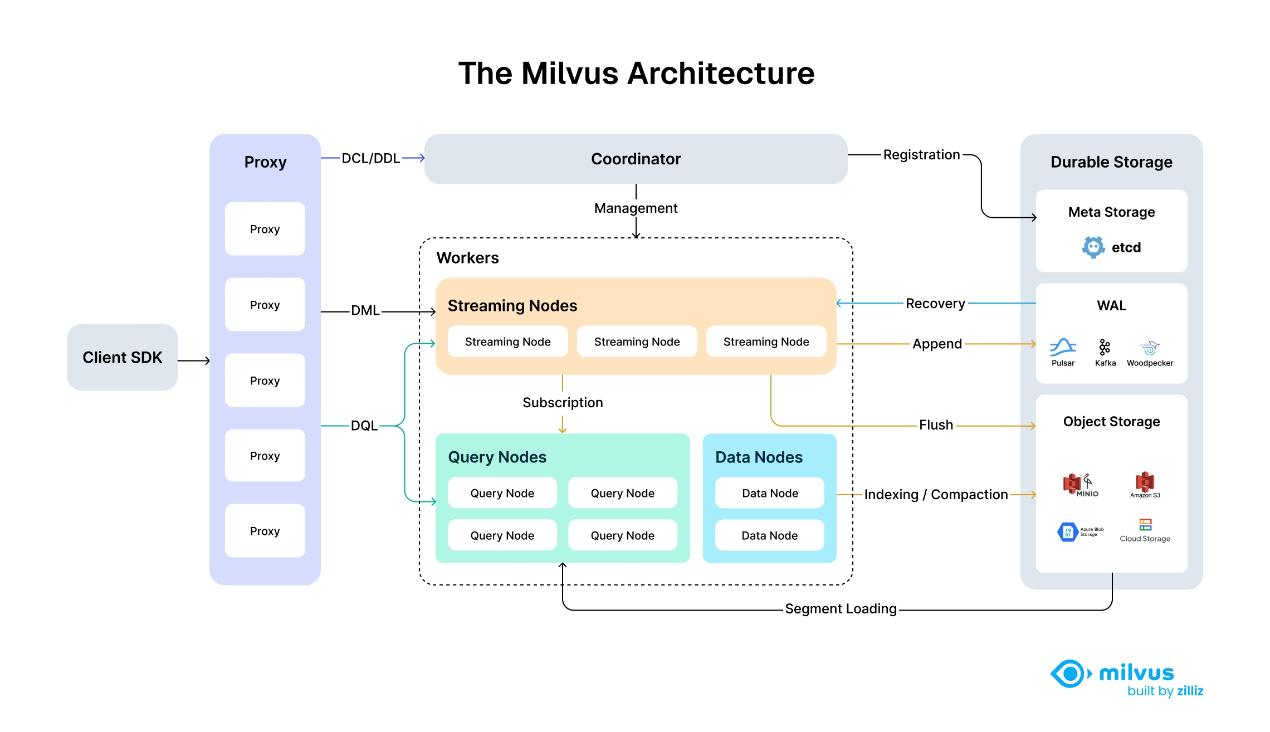
1 Milvus 架构介绍
分层组件:Proxy、Coordinator、Query/Data 节点、持久存储,支持单机 / 分布式,亿级向量稳定检索
2 Milvus 数据结构
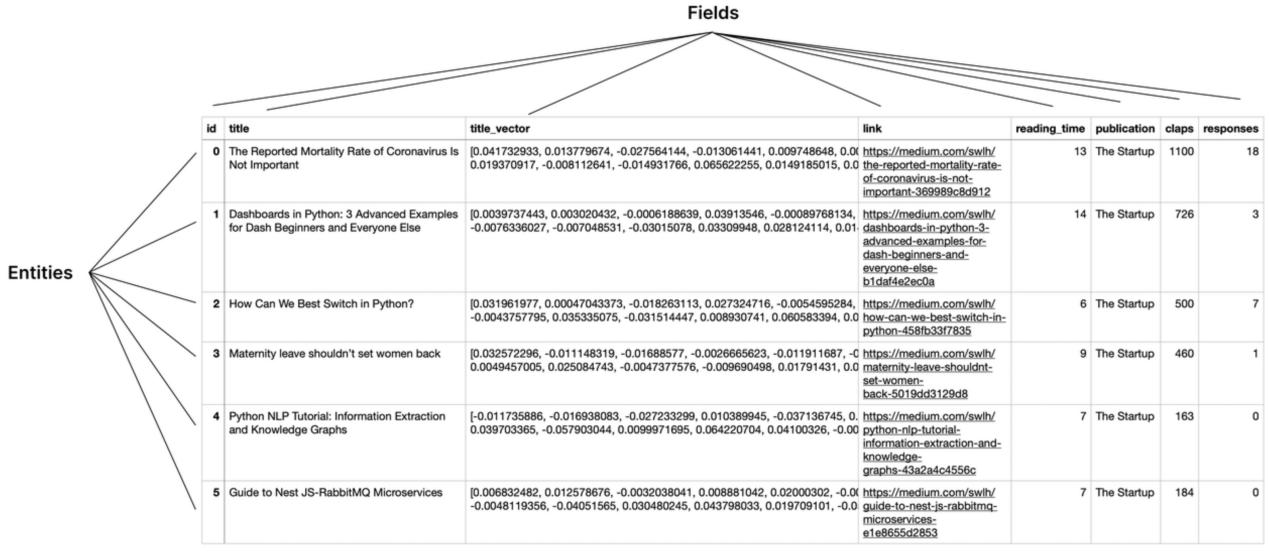
层级:数据库 → Collection(表)→ Entity(行)
字段分类: 1 稠密 FLOAT_VECTOR:BGE 常规语义向量 2 稀疏 SPARSE_FLOAT_VECTOR:关键词权重向量(BGE-M3) 3 标量字段:文本、数字、JSON,用于过滤
3 索引类型
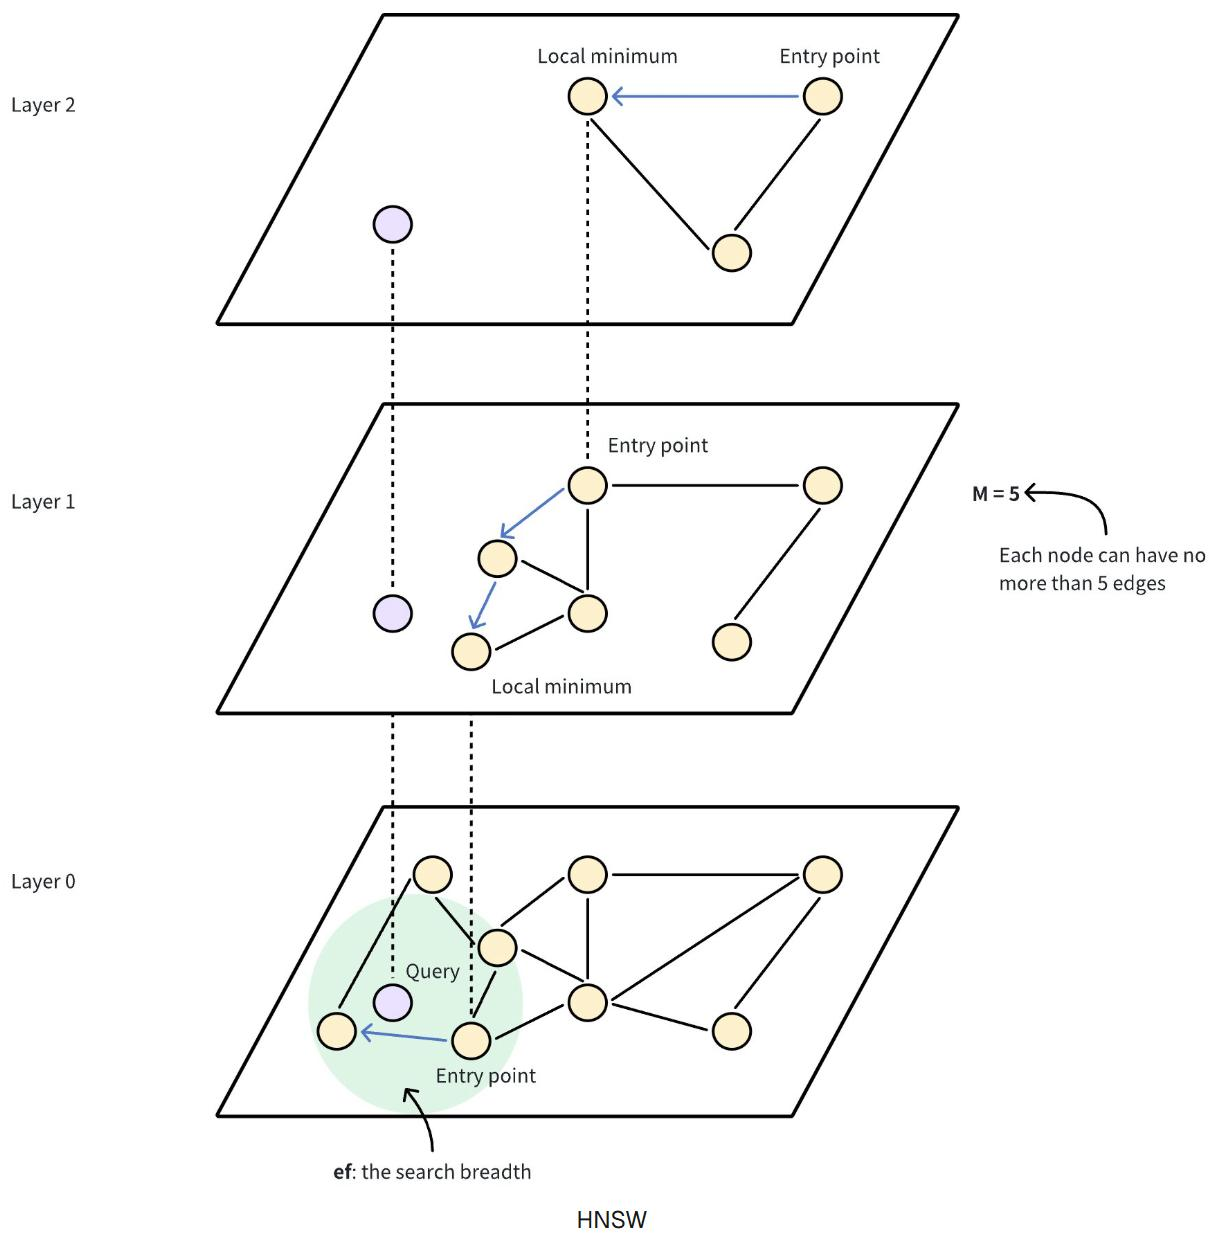
3.1 稠密向量 HNSW 索引
分层导航图,检索速度快、精度高,生产首选
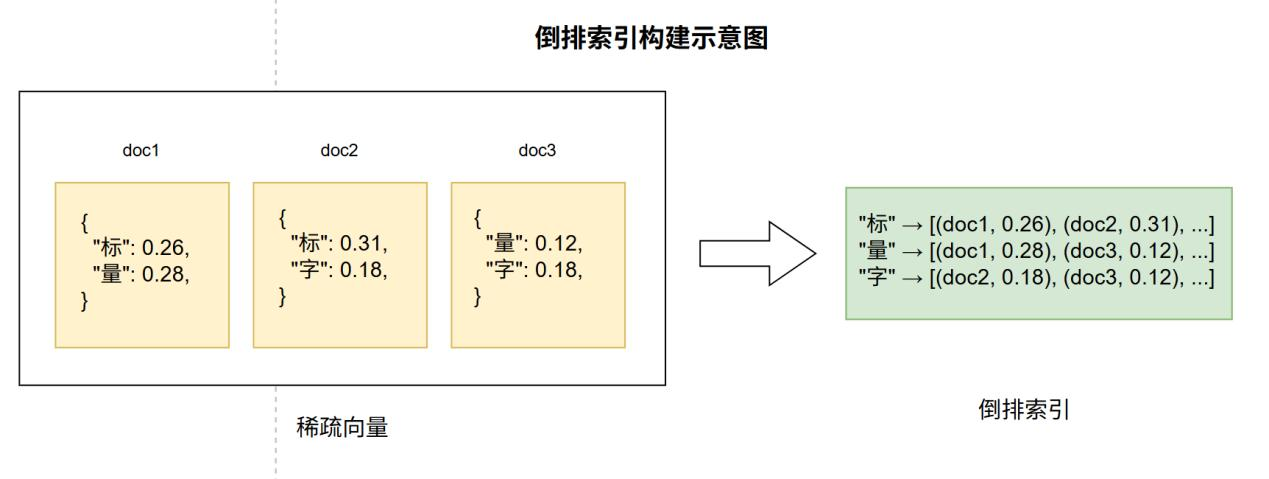
3.2 稀疏向量 倒排索引
基于词权重匹配,类似 ES 全文检索
4 Milvus 部署
1 Milvus Lite:pip 本地轻量化,仅测试 2 Standalone:Docker 单机部署(课程使用) 3 Distributed:K8s 分布式生产 Docker 启动命令:
python
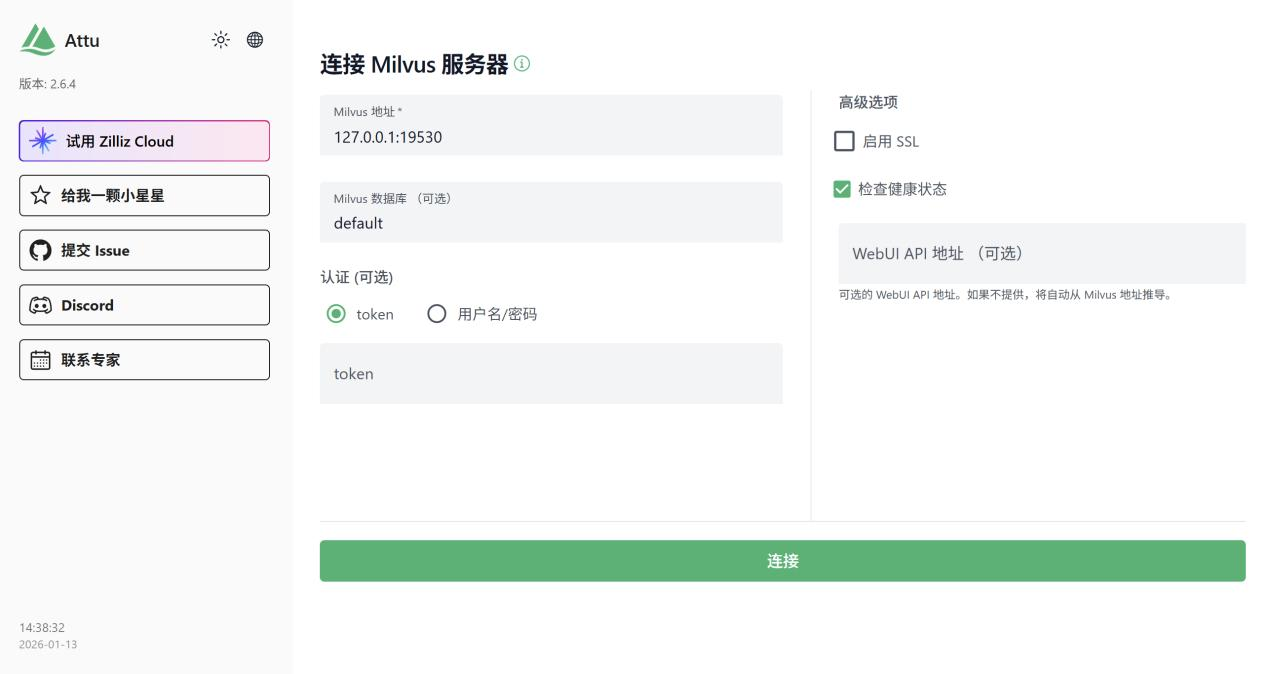
bash standalone_embed.sh start图形客户端 Attu 可视化管理向量库
5 Collection 创建完整代码
python
from pymilvus import MilvusClient,DataType
client = MilvusClient("http://localhost:19530")
# 1 构建Schema
schema = client.create_schema(auto_id=True)
schema.add_field("id",DataType.INT64,is_primary=True)
schema.add_field("vector",DataType.FLOAT_VECTOR,dim=768)
schema.add_field("sparse_vector",DataType.SPARSE_FLOAT_VECTOR)
schema.add_field("text",DataType.VARCHAR,max_length=2000)
schema.add_field("meta",DataType.JSON)
# 2 索引参数
index_params = client.prepare_index_params()
index_params.add_index("vector","HNSW","L2")
index_params.add_index("sparse_vector","SPARSE_INVERTED_INDEX","IP")
# 3 创建集合
client.create_collection("demo",schema=schema,index_params=index_params)
6 数据插入
切片文本 → 生成稠密 / 稀疏向量 → 组装字典批量插入 Collection
7 三大检索方式
7.1 稠密向量单路检索
纯语义相似度匹配,适合长文本语义匹配
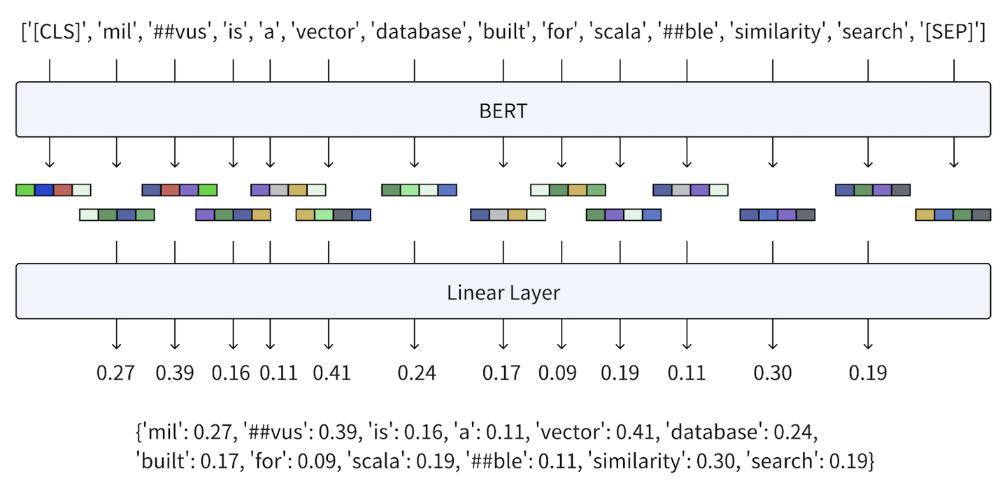
7.2 稀疏向量单路检索
关键词精准匹配,适合专有名词、行业术语
7.3 混合检索(RRF 重排序,最优方案)
稠密 + 稀疏两路召回,RRF 算法融合打分,兼顾语义与关键词
python
# 混合检索核心代码
from pymilvus import AnnSearchRequest,RRFRanker
dense_req = AnnSearchRequest(data=dense_vec,anns_field="vector",param={"metric_type":"L2"},limit=5)
sparse_req = AnnSearchRequest(data=sparse_vec,anns_field="sparse_vector",param={"metric_type":"IP"},limit=5)
res = client.hybrid_search("demo",[dense_req,sparse_vec],ranker=RRFRanker(k=60),limit=5)
7.4 标量过滤检索
基于 metadata、文本字段精确过滤,缩小检索范围
8 完整 RAG 生成链路
1 用户问题 → 生成稠密 + 稀疏向量 2 Milvus 混合检索 top5 相似文档 3 检索文本拼接上下文送入 Prompt 4 LLM 结合参考资料生成答案
9 本章小结
1 Milvus 支持稠密 / 稀疏双向量,混合检索 RRF 提升召回精度 2 HNSW 适合稠密向量,倒排索引适配稀疏关键词向量 3 完整 RAG 链路:加载切片→嵌入入库→混合检索→LLM 问答