这份指南,写给所有不想在GDB里迷路的开发者。我们不讲虚的,只聚焦最常用、最管用的调试指令。从启动程序、附加进程,一路到查看寄存器状态,全部用表格和实战案例串联起来,帮你快速搭起一套属于自己的高效调试工作流。好,直接上车。
目录
[1.1 调试前置条件------Debug与Release模式](#1.1 调试前置条件——Debug与Release模式)
[1.2 调试信息生成------ -g选项的作用](#1.2 调试信息生成—— -g选项的作用)
[1.3 如何判断程序是否支持调试](#1.3 如何判断程序是否支持调试)
[2.1 GDB启动与退出](#2.1 GDB启动与退出)
[2.2 源码查看------list指令](#2.2 源码查看——list指令)
[2.3 断点管理------Breakpoint机制](#2.3 断点管理——Breakpoint机制)
[2.3.1 设置断点的多种方式](#2.3.1 设置断点的多种方式)
[2.3.2 查看、删除与启用断点](#2.3.2 查看、删除与启用断点)
[2.4 程序状态查看](#2.4 程序状态查看)
[2.4.1 查看调用栈:backtrace(bt)](#2.4.1 查看调用栈:backtrace(bt))
[2.5 执行流控制------逐步掌控程序运行](#2.5 执行流控制——逐步掌控程序运行)
[2.6 变量监视与数据分析](#2.6 变量监视与数据分析)
[2.6.1 打印变量与内存数据](#2.6.1 打印变量与内存数据)
[2.6.2 实时监控变量变化](#2.6.2 实时监控变量变化)
[2.7 进阶执行控制------until跳转执行](#2.7 进阶执行控制——until跳转执行)
[3.1 CGDB------让GDB拥有可视化体验](#3.1 CGDB——让GDB拥有可视化体验)
[3.1.1 CGDB安装与配置](#3.1.1 CGDB安装与配置)
[3.1.2 界面操作与模式切换](#3.1.2 界面操作与模式切换)
[3.1.3 源码同步显示优势](#3.1.3 源码同步显示优势)
[3.2 watch变量监控------追踪数据变化过程](#3.2 watch变量监控——追踪数据变化过程)
[3.3 set var------动态修改程序运行状态](#3.3 set var——动态修改程序运行状态)
[3.4 条件断点------精准捕获目标场景](#3.4 条件断点——精准捕获目标场景)
[3.4.1 创建断点时添加条件](#3.4.1 创建断点时添加条件)
[3.4.2 修改已有断点条件](#3.4.2 修改已有断点条件)
[3.5 GDB常用快捷操作补充](#3.5 GDB常用快捷操作补充)
[3.6 GDB调试命令速查表](#3.6 GDB调试命令速查表)
一、调试环境准备------开启程序调试的大门
1.1 调试前置条件------Debug与Release模式
Linux下用gcc/g++编译,默认产出的是Release版本。编译器会开启优化,顺带把符号表一并砍掉------没了符号表,GDB就找不到二进制指令和源代码之间的对应关系,断点打不上,变量看不了,调试无从谈起。
-
Release:追求运行效率,体积小,不可调试。
-
Debug:包含完整调试符号,体积稍大,但允许逐行跟踪、随心所欲地下断点。
调试之前,先确认自己手里拿的是Debug版本。这一步没做对,后面所有操作都是白费力气。
1.2 调试信息生成------ -g选项的作用
想让程序带上调试信息,编译时必须显式加上-g参数。
手动编译,直接跟在gcc后面:
bash
gcc -g main.c -o processbar用 Makefile 管理项目,把-g写进编译选项变量里,一次配置全局生效:
bash
CC = gcc
CFLAGS = -g -Wall    # -g 统一放在这里

processbar: main.o
	$(CC) $(CFLAGS) -o $@ $^
这样make出来的每一个.o文件和最终可执行程序,都会自动携带调试符号。养成把-g写进Makefile的习惯,省得每次调试都要回头重新编译。
1.3 如何判断程序是否支持调试
除了直觉上"Debug版本体积更大"这种粗糙判断,最可靠的做法是用readelf直接查看ELF文件的段信息。readelf是专门解析Linux下可执行文件格式的工具,调试信息有没有、存在哪,它一清二楚。
bash
readelf -S processbar | grep -i debug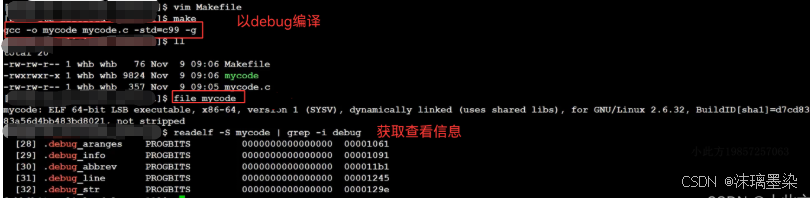
如果输出里出现了.debug_info、.debug_line、.debug_abbrev等字段,就说明调试符号已经稳稳当当地嵌入进去了。反之,如果这条命令输出为空,那你手里拿的八成是Release版本,GDB也无能为力,赶紧回去检查编译选项,补上-g再重新编译。
二、GDB核心操作------掌控程序执行流程
2.1 GDB启动与退出
- **进入:**gdb bin_file,其中bin_file是你编译好的Debug版可执行文件。
- **退出:**输入quit或直接按Ctrl + D,两种方式等效,选你顺手的那一个。
2.2 源码查看------list指令
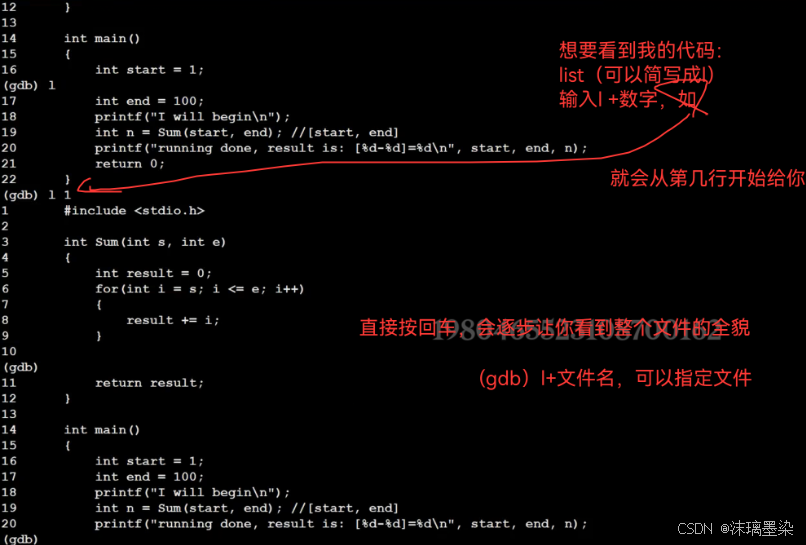
调试不能闭着眼睛调。list(缩写 l)是你在GDB里最常用的"眼睛",随时帮你翻开源代码。
- **l:**默认列出当前执行行附近的代码。刚启动GDB时,会从main函数开始显示。
- **l 行号:**从指定行号开始,向下展开一段源码。
- **l 文件名:行号:**跨文件调试时,精准定位到目标文件的指定行。
- **l 函数名:**直接跳到某个函数的开头,不必记行号。
一个实用技巧:第一次敲完l之后,连续按回车键,GDB会自动翻页,把接下来的代码一屏一屏推到你面前。这比反复敲 l 高效得多,建议直接形成肌肉记忆。
2.3 断点管理------Breakpoint机制
断点是调试的灵魂。它让狂奔的程序在你指定的位置"急刹车",把那一刻的变量、寄存器、调用栈全部冻结下来,供你仔细检查。
2.3.1 设置断点的多种方式
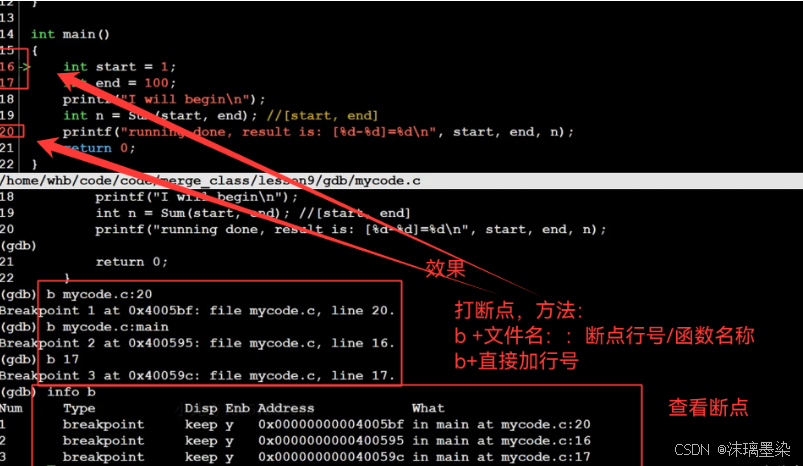
- **b 行号:**在当前文件的指定行设断点,比如b 10,程序执行到第10行就会停下来。
- b 函数名:在函数入口处设断点,比如b main或b Sum。程序一进入该函数即触发,适合快速定位函数是否被调用。
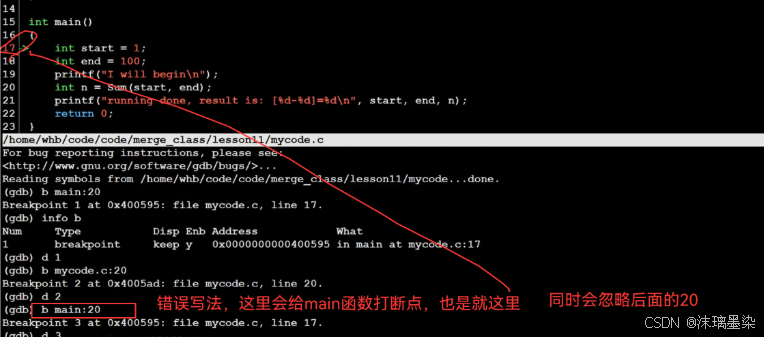
- b 文件名:行号:多文件工程中,精确指定目标文件的某一行,如b mycode.c:20。跨文件调试的必备操作。
避坑指南:有一个新手高频错误值得单独拎出来------b main:20 这种写法是错误的。GDB 会把 main: 整体解析成一个函数名(实际上不存在),后面的 20 直接被忽略。正确做法是:想给 main.c 的第 20 行打断点,必须写成 b main.c:20,文件名和行号之间用点号加后缀区分。把这条记牢,省得在 GDB 里反复撞墙。

2.3.2 查看、删除与启用断点
断点打好之后,真正的管理才刚刚开始,哪些还留着,哪些该撤掉,哪些暂时不用但以后还要,这些操作全围绕一个核心概念展开:断点编号。
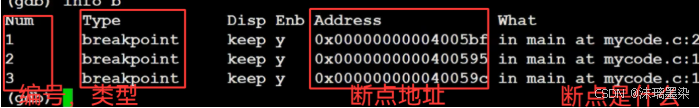
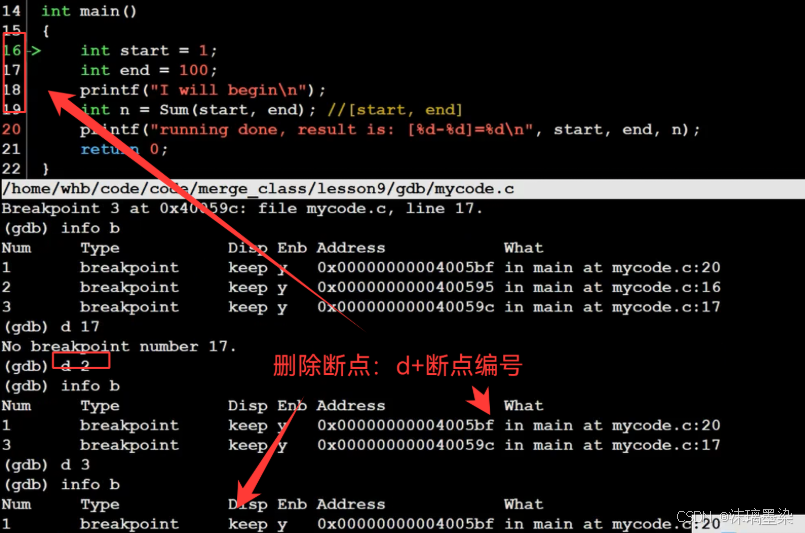
- info b:列出当前所有断点的详细信息,包括编号、位置、状态等,是断点管理的总控制台。
- Num(编号):每个断点的唯一ID,后续一切操作都靠它来指定目标。
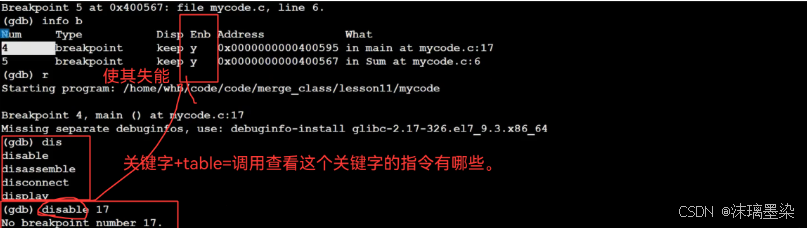
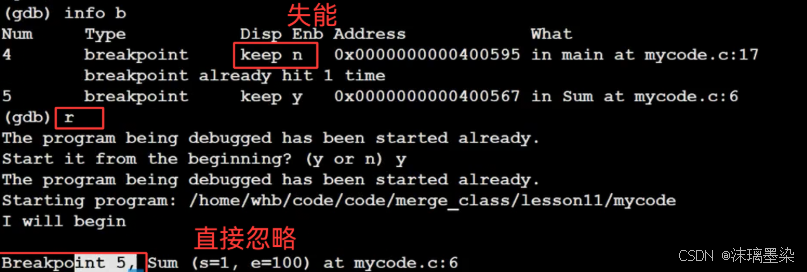
- Enb(使能状态):y表示断点生效中,程序跑到这会停;n表示断点被暂时搁置,位置保留但不会触发。
具体操作命令很直白:
- d 编号:删除指定断点,比如d 2就是把2号断点彻底移除。
- disable 编号:暂时停用某个断点。断点位置仍在,只是程序跑过此处时不会停下。
- enable 编号:重新激活被停用的断点。这里值得强调一句,disable不是删除,它只是让断点暂时"休眠"。调试时怀疑某个断点暂时用不上、但后面可能还要,就disable掉,别急着d。
一个关键逻辑必须记住:GDB里,只有打新断点时需要行号;一旦断点生成,后续所有操作都只认编号。 别对着一个已有断点反复敲行号,GDB不会理你。
注意事项:
- 断点编号在单次调试会话中是持续递增的。如果你删掉了2号断点再新建一个,新断点的编号会是4(假设之前已经有3号),而不是复用已删除的2号。这是GDB的计数机制,不是bug。
- 如果你确实想让编号重新从1开始排,退出GDB再重新进来,编号就会重置。这是最简单也是最干净的做法。
2.4 程序状态查看
2.4.1 查看调用栈:backtrace(bt)
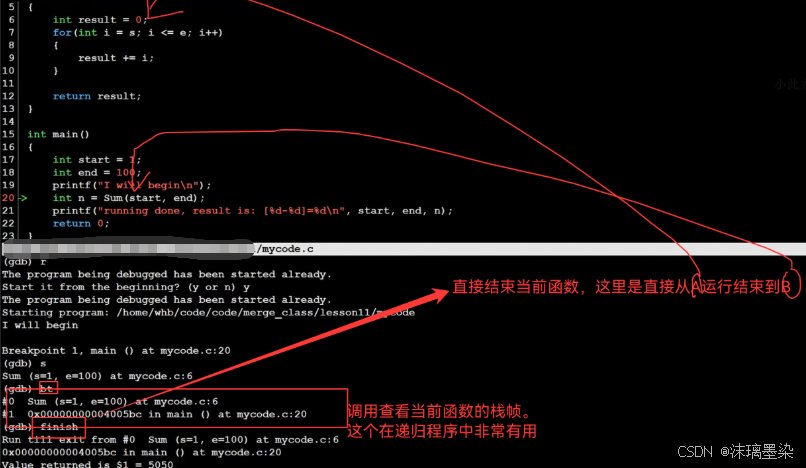
程序崩溃时,最想知道的一件事是:它是怎么一步步走到这个"案发现场"的。bt(backtrace)就是用来回答这个问题的。
- bt:打印当前调用堆栈的全部栈帧。从最底层的main开始,一层层往上,直到当前正在执行的函数,完整的调用链路一览无余。
它不仅告诉你"谁调用了谁",还会把每一层传递的参数值都列出来。排查递归深度过深、回调链条断裂、多层嵌套中参数被意外篡改这类问题时,bt是不可替代的第一手线索,不用靠猜,堆栈自己会说话。
2.5 执行流控制------逐步掌控程序运行
断点让程序"定格",而执行流控制决定"定格"之后怎么走。GDB提供了从逐行踱步到大步跨越的全套命令,不同场景用不同节奏,调试效率才能拉满。
- r(run):从头启动程序,遇到第一个断点自动刹停。如果还没打任何断点,程序会一路跑到结束。
- n(next):逐过程执行。把函数调用当作一个整体,一次跨过去,不进入函数内部。相当于 Visual Studio 里的F10。
- s(step):逐语句执行。遇到函数调用会一头扎进去,停在函数内部的第一行。相当于 F11。想看某个函数内部执行细节时用它。
- c(continue):继续运行,直到下一个断点或程序结束。当前这段代码已经确认没问题,想快速跳到后面的断点继续查,直接c。
- finish:执行完当前函数并返回调用处。这个命令在一种场景下尤其实用------你手快用 s 误入了一个无关紧要的库函数(比如 printf、strlen),又不想在里面一步步走完。finish 直接把你从"别人的地盘"拽回当前行,干净利落。
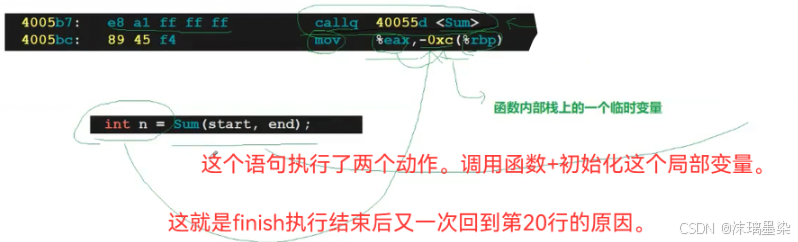
finish的一个微妙细节:像int n = Sum(start, end) 这样一行代码,背后实际拆成了"调用Sum函数"和"将返回值赋给n"两个子动作。finish执行完Sum并返回后,会停在当前行,等着把返回值写进n才算彻底收工。所以你打完finish后看到程序仍然停在同一行,不要惊讶,它不是在偷懒,而是那半拍的赋值还没做完。
2.6 变量监视与数据分析
调试不是蒙眼狂奔。程序停下来的那一刻,你最大的欲望就是问一句:"现在这些变量到底都等于多少?"GDB给了你两条路,一条是主动出击,一条是坐享其成。
2.6.1 打印变量与内存数据
p(print):最直接的侦察兵。p变量名 查看某个变量的当前值,p表达式 还能当场帮你算一个结果出来,比如p a+b、p 1<<10,甚至p strlen(str)。临时起意想看什么,直接敲p就行。
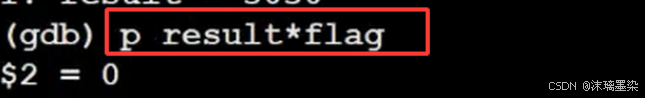
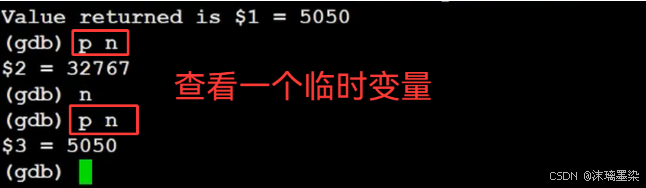
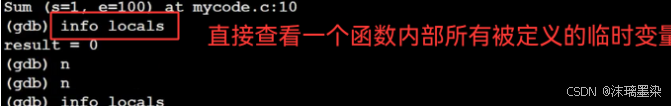
info locals:效率玩家的最爱。这个命令会把你当前函数栈帧内所有局部变量一口气全列出来,附带各自的当前值,不需要一个变量一个变量地手动p。刚进一个新函数、想快速掌握当前上下文的变量状态时,先敲一下info locals,比逐个打p高效得多。
2.6.2 实时监控变量变化
p是一次性的侦察兵,想看一次就完事。但有些变量是你从头到尾都在盯的------比如循环控制变量、状态标志位、某个频繁被修改的指针。这时候p就太累了,每走一步都要手动敲一遍。你需要的是"监视窗口"。
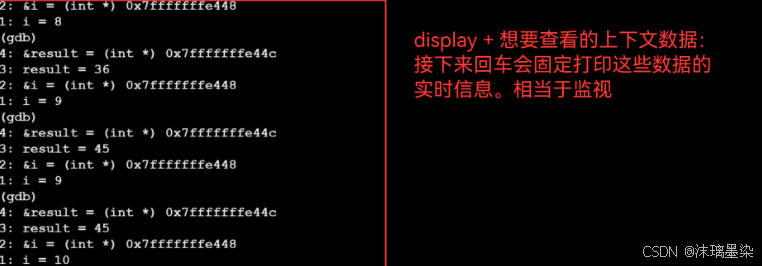
- display 变量名:开启常显示模式。设置之后,每次执行n或s,GDB都会自动在屏幕上刷新这个变量的当前值和内存地址,像一块固定的监视面板,始终追着目标数据跑。
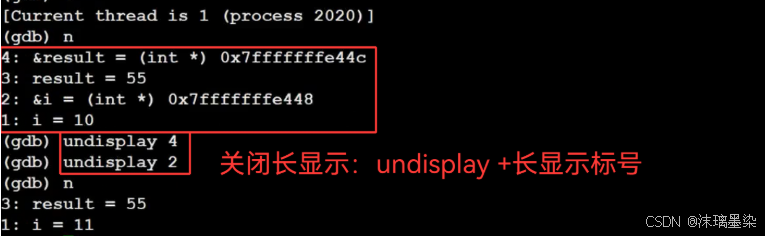
- undisplay 编号:关闭常显示。这里有一个极易踩坑的细节,必须用display自动生成的编号来关闭,写变量名没用。 第一次执行display时,GDB会在输出里标明它的编号,后续用 undisplay 编号精准关掉对应那一项。
2.7 进阶执行控制------until跳转执行
调试中最磨人的场景之一,是面对一个循环。你知道bug在循环后几行才触发,但用n一步步走完几十上百次迭代简直要命;临时打个断点又嫌太费周章,用完还得回头删。这时候until就是那个恰到好处的选项。
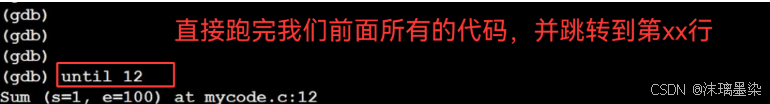
- until 行号:让程序从当前位置一口气跑到目标行再停下,中间所有代码包括循环体全部自动执行完毕。它相当于一个"一次性临时断点",用完即走,不留痕迹。
理解until的关键在于:它只管"目标行",不关心中间跳了多少层、绕了多少圈。循环跑了多少遍、中间调了多少层函数,它都不在乎只要目标行没到,它就继续跑。这种"局部跨越式"的跳转,跟c的"全局继续"和finish的"跳出当前函数"正好互补,把执行流控制的颗粒度又细化了一档。当你面对一个循环在某个特定迭代之后才出错,而又不想在循环入口反复按n时,until是让效率翻倍的快捷键。
三、GDB高级调试技巧------定位复杂程序问题
3.1 CGDB------让GDB拥有可视化体验
原生的GDB功能强大,但操作全靠命令行,看代码得反复敲list,时间一长难免觉得割裂。CGDB的出现,就是专门来解决这个痛点的,它在GDB上面套了一层轻量级图形界面,把终端一分为二:上半屏是代码窗口,下半屏 GDB命令窗口。语法高亮、当前行指示、分屏同步滚动,用起来几乎有IDE调试器的直观感,却没有IDE的臃肿启动时间。
3.1.1 CGDB安装与配置
一条命令搞定:
bash
# Ubuntu/Debian
sudo apt-get install -y cgdb

# CentOS/Fedora
sudo yum install -y cgdb
3.1.2 界面操作与模式切换
CGDB启动后,焦点默认在下方的GDB命令窗口。关键在于两种模式的自由切换:
- Esc------进入代码模式:焦点切到上方的代码窗口。此时你可以用 Vim 快捷键(j、k、Ctrl+f、Ctrl+b 等)上下翻页浏览代码,用 / 进行关键字搜索,甚至直接按空格键在当前行打断点或取消断点,跟IDE里点行号左侧如出一辙。
- i------回到命令模式:焦点切回下方的命令窗口,继续输入标准的GDB指令(b、r、n、p 等)。想执行什么命令,跟裸GDB完全一样,没有学习成本。
3.1.3 源码同步显示优势
- 实时高亮跟踪:程序运行时,上方的代码窗口会用一个醒目的箭头和高亮色标出当前正在执行的行。执行流走到哪,指示跟到哪,再也不用靠脑补。
- 彻底告别频繁list:调试过程中想看上下文,只需Esc切到代码窗口,上下翻动即可,完全不干扰下方的命令输入。这个改进直接让调试效率翻倍。
- 多文件自动切换:跨文件调试时,当程序执行流从main.c跳进tool.c,上方的代码窗口会自动刷新为新源文件的内容,始终保持"所见即所调"的视图连贯性,这在多模块项目中是巨大便利。
3.2 watch变量监控------追踪数据变化过程
调试时有一种情况很让人抓狂:你心里清楚某个变量不该被改动,但它莫名其妙就变了。谁改的?在哪一行改的?什么时候改的?watch就是专门用来抓这种"幕后黑手"的。
- 用法:watch 变量名/表达式。设置之后,程序继续运行,GDB会在后台死死盯着这个变量。
- 原理:当被监视的变量值发生变化时,程序会自动刹停,GDB会在屏幕上清清楚楚地打印出旧值 和新值,并指示是哪一行代码触发了这次修改。
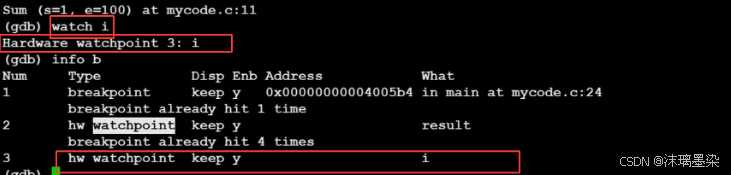
这里需要和前面讲的display做一个区分:
- display是"每走一步都汇报",不管你关心的变量变没变,它都会刷新一遍值,适合持续追踪。
- watch是"只有出事才报警",变量不变它就保持沉默,一旦被修改立刻中断程序通知你,适合排查"谁在背后动了我的数据"这类问题。
3.3 set var------动态修改程序运行状态
调试时最让人憋屈的一种情况是:明明怀疑某个分支有问题,但程序偏偏每次都不进那个分支;或者你想看看某个特殊值下程序的表现,却要改代码、重新编译、重新跑,一套流程下来,几分钟就没了。set var就是专门来解决这个麻烦的。
- 用法:set var 变量名=值。在程序暂停时直接修改变量的值,立刻生效。
- 典型场景:程序停在if(n == 0) 这一行,你知道正常流程会进if分支,但你想验证else分支的逻辑是否正确。这时候不需要改源码,直接敲set var n=1,GDB当场把n的值改掉,然后你继续执行程序就会乖乖走进else分支,就像它本来就是那样一样。
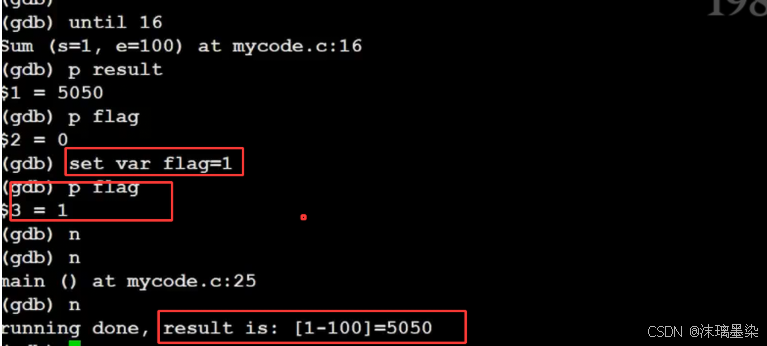
set var的核心价值在于:**它把"改代码→重编译→重运行"这个漫长循环压缩成了一秒钟。你可以反复修改同一个变量、测试不同取值下的分支走向,一个断点配合多次set var,就能把整个函数的逻辑路径全部遍历一遍。**这在排查条件分支bug、验证边界情况、模拟极端输入时,效率提升是数量级的。
有一点需要留意:set var改的是程序当前运行状态中的值,源文件和二进制文件都不会被修改。一旦程序退出重跑,所有的改动就消失了。这种临时性既是它的优势(不留痕迹),也是它的边界,它只适合调试期快速验证,不能替代真正的代码修正。
3.4 条件断点------精准捕获目标场景
普通断点有个致命弱点:只要程序跑到这一行,它就无条件刹停。在大型循环或高频调用的函数里,这种"步步都停"的行为会让调试变成灾难,你不得不反复按c跳过成百上千次无关的迭代,手酸心累,调试的耐心也在一次次无意义的停顿中耗尽。
条件断点,就是为解决这个痛点而生的。它允许你在断点上附加一条过滤规则,只有当规则成立时,程序才刹停;否则视而不见,继续飞奔。
3.4.1 创建断点时添加条件
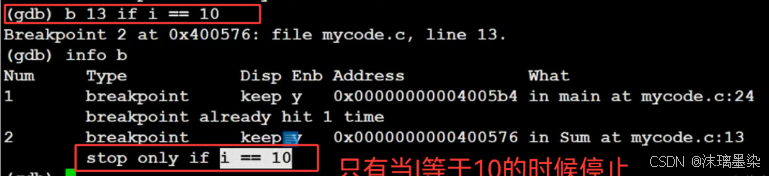
这是最常用、也最简洁的方式。在打新断点的那一刻,就把条件一并写好,一气呵成。
- 设置方法:b 行号/函数名 if 条件表达式
- 示例:b 15 if i == 50
- 效果:程序每次经过第15行时,GDB都会自动计算i的当前值。如果i不等于50,程序不停,继续跑;只有当i恰好等于50时,断点才真正触发,程序应声刹停。
3.4.2 修改已有断点条件
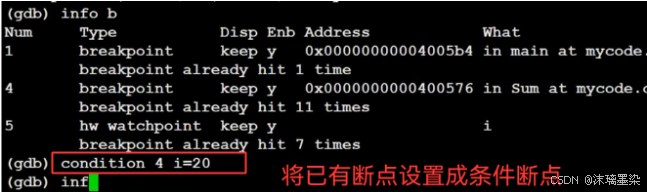
有时候你已经打好了断点,跑起来才发现它停得太频繁,这时候不用删掉重来直接在原断点上补一条条件就行。
- **设置方法:**condition 断点编号 条件表达式
- 操作步骤:
- 先敲 info b,找到目标断点的编号(比如是 2 号)。
- 输入 condition 2 i == 100,回车。
- **效果:**从此2号断点不再是"无条件触发",它只会在i等于100时才刹停程序。一个普通断点,瞬间升级为精准狙击手。
- **取消条件:**如果后续想让它恢复成普通断点,输入condition 断点编号,后面不跟任何条件,GDB就会清除该断点的过滤规则,它又变回那个"每经过必停"的原始模式。
这两种方式各有适用场景:新建时顺手加条件用方式一,断点已经跑起来才想起要过滤用方式二。两者配合,让你对断点的控制粒度从"哪一行停"精细到"哪一行、在什么条件下停"。
3.5 GDB常用快捷操作补充
两个能显著提升GDB操作流畅度的小技巧,虽不起眼,但一旦养成习惯就离不开。
- **Tab自动补全:**输入指令前缀(比如dis)后按一下Tab键,GDB会立刻列出所有以dis开头的可用指令disable、display、disassemble等等。既能防拼写错误,又能快速确认想用的指令全名。记不全命令没关系,Tab会帮你补全。
- **回车重复执行:**直接敲回车,GDB会自动重放上一条指令。这在连续n(逐过程)或连续 l(翻源码)时尤其顺手,第一次敲完n,后续只需要反复按回车,程序就一步步往前走,节奏流畅不被打断。调试过程中的"一路回车",往往是效率最高的工作流。
3.6 GDB调试命令速查表
以下表格汇集了GDB调试中最核心、使用频率最高的命令。建议保存下来,调试时随手翻阅,不必每次临时去查文档。
| 命令 | 简写 | 功能描述 |
|---|---|---|
| list | l | 显示当前位置附近的源码,默认 10 行,连续回车自动翻页 |
| list n | l n | 从第 n 行开始显示源码 |
| list func | l func | 显示指定函数的完整源码 |
| run | r | 启动程序,遇到第一个断点自动停下 |
| next | n | 逐过程执行:一行一行往下走,不进入函数内部 |
| step | s | 逐语句执行:遇到函数调用会深入函数内部继续跟踪 |
| break n | b n | 在当前文件第n行设置断点 |
| break func | b func | 在指定函数入口处设置断点 |
| break file:n | b file:n | 在指定源文件的第n行设置断点(跨文件调试用) |
| info break | i b | 查看所有断点的编号、位置、启用状态等详细信息 |
| delete num | d num | 删除指定编号的断点 |
| disable num | dis num | 暂时停用指定断点,位置保留但不触发 |
| enable num | ena num | 重新启用被停用的断点 |
| print expr | p expr | 打印变量值或计算表达式结果 |
| display var | display | 开启常显示模式,每执行一步自动打印该变量的值 |
| undisplay id | undisplay | 取消指定编号的常显示追踪(编号由display生成) |
| until n | u n | 一口气跑到第n行才停下,常用于跳出循环 |
| finish | finish | 执行完当前函数并返回到调用点之后 |
| continue | c | 继续运行,直到下一个断点或程序结束 |
| set var v=val | set var | 在调试过程中动态修改变量的值 |
| backtrace | bt | 打印当前完整的函数调用堆栈 |
| info locals | i locals | 一键查看当前函数内所有局部变量的值 |
| watch var | watch | 设置监视点,变量值一旦发生变化程序立刻刹停 |
| quit | q | 退出GDB |
| (Enter) | --- | 重复执行上一条命令,连续n或l时效率极高 |
| (Tab) | --- | 命令自动补全,按两下列出所有可选匹配项 |
感谢看到这里的每一位读者。如果这份指南对你有帮助,欢迎点赞、收藏、关注三连支持。下篇见。