《AI 知识卡片》第 15 期 · 三元组把病灶分开,优化才不是盲人摸象
假如,你给自己的 Agent 接了一个 RAG 知识库,问了一个知识库相关的问题,它答错了。接下来你会怎么处理?
你可能会这样做:改提示词、换个更强的模型、把 chunk_size 从 500 调到 800、把 top_k 从 3 加到 5。改完再问一遍,没问题就收工了。
问题是你压根不知道是哪一步坏了,也不知道这次改动是真的有效,还是碰巧。下次换个问题,可能又崩。
这里错误可以出在两个完全不同的地方------可能是检索压根没把该给的资料捞回来,也可能是资料给对了、生成时自己跑偏了。
评估要解决的就是这件事,哪一步不正常,测量一下就知道,而不是全靠"再问一遍试试"。
RAG 三元组
RAG 有个很好用的评估框架,叫 RAG 三元组(RAG Triad) 。它的思路是:一次问答里其实只有三样东西------问题、检索到的上下文、最终的答案,那就两两之间各查一遍。
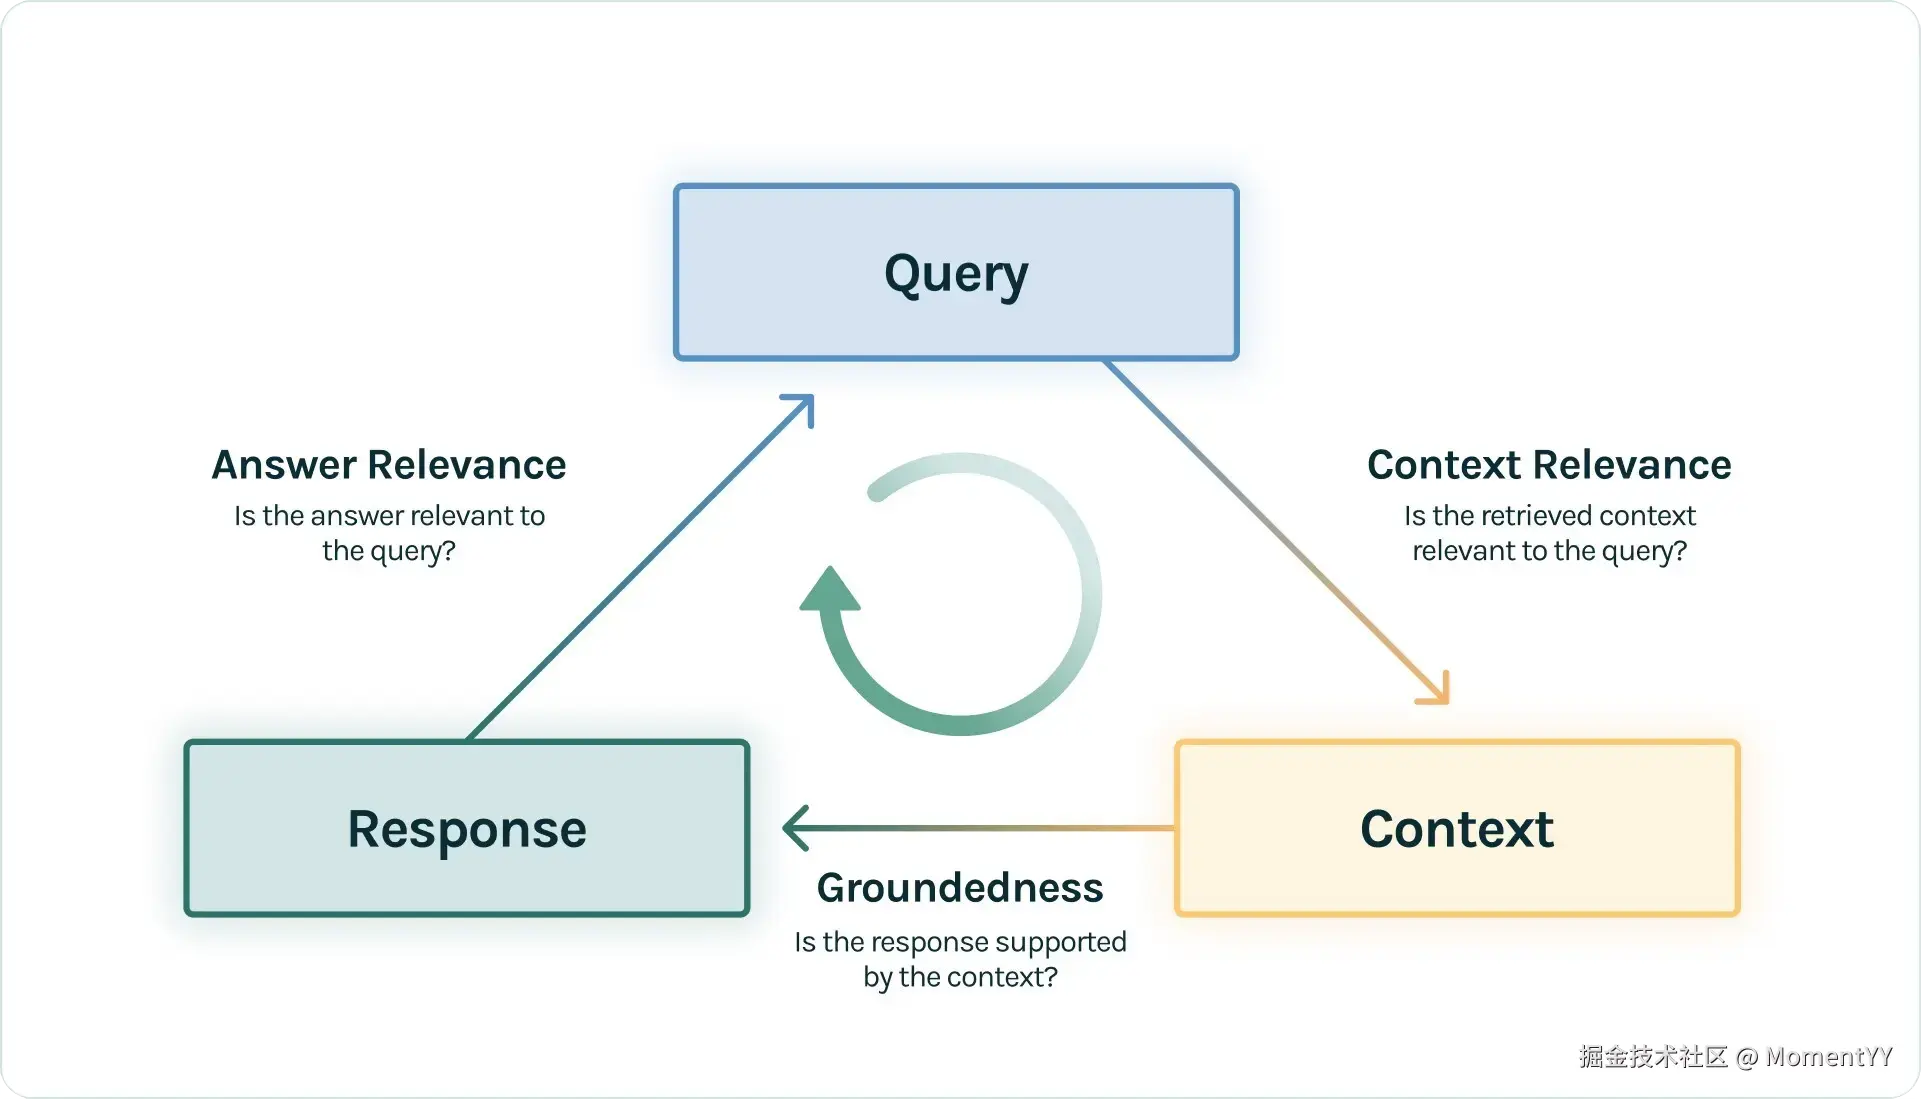
三条边,对应三个指标:
| 指标 | 查的是 | 说明 |
|---|---|---|
| 上下文相关性(Context Relevance) | 问题 ↔ 上下文 | 捞回来的资料,跟问题有关吗 |
| 忠实度(Groundedness) | 上下文 ↔ 答案 | 答案是照着资料说的,还是自己编的 |
| 答案相关性(Answer Relevance) | 问题 ↔ 答案 | 有没有真正回答用户的问题 |
这三个指标能直接定位病因:
- 上下文相关性低 → 检索坏了,后面再强的模型也救不回来;
- 忠实度低 → 生成在瞎说,资料明明给了它,它自由发挥;
- 答案相关性低 → 答非所问,或者只答了一半;
忠实度和答案相关性最容易混 ,看一个例子:用户问"法国在哪里,首都是哪里? ",答案是"法国在西欧"。这句话完全出自资料,忠实度很高,但它只答了一半,答案相关性很低。
一个查有没有瞎说 ,一个查有没有答到点。分开看,才知道该去修提示词还是修检索。
检索评估
这里直接沿用信息检索那套指标就行。使用之前,得先有一份标注数据集:一批问题,以及每个问题真正相关的文档是哪些。常用的有三个:
- Precision@k :捞回来的前 k 条里,有多少是真相关的------衡量准,高就说明噪声少;
- Recall@k :该找到的相关文档,找回来了多少------衡量全,高就说明没漏;
- MRR:第一条正确答案排在第几位------只关心"一击命中"的场景特别适合;
这里有个躲不过的权衡:准和全,通常只能挑一个 。把 top_k 调小、门槛调高,准了但容易漏;调大、放宽,全了但杂质进来。先用大 k 保证不漏,再用重排把准捞回来。
生成评估
生成这一环没有标准答案可比,现在主流做法是用一个中立的、能力强的模型来当裁判。
以忠实度为例,裁判的活儿干得挺细:先把答案拆成一条条独立的断言 ,然后拿着上下文逐条核对------这条有依据、这条没有,最后算被证实的比例。这个分数因此有了具体含义:它等于答案里有多少比例是有据可查的。
另一条老路是看词面重叠:拿生成的答案和参考答案比 n-gram,ROUGE 偏向查"该说的说全了没",BLEU 偏向查"说出来的对不对",METEOR 想两边平衡。它们客观、便宜、可复现,缺点是压根不懂语义------换个说法表达同一个意思,分数就掉下去了。
实践里的组合:便宜的先筛,贵的精评。用词汇重叠和检索指标做大批量回归,挑出可疑的样本再交给 LLM 裁判细看。
指标比较
评估最实际的价值,是让两个方案能被摆在一起比。
打个比方:同一批问题下,句子窗口检索的忠实度 53.3%、相关性 66.7%,而常规分块只有 0.0% 和 6.7%。"小块检索更准"这个大家都听过的说法,到这里才第一次变成了具体的数字。
对于常规分 0.0% 这种极端值别急着当结论 。它更可能说明那批测试问题或者那套配置本身有问题,而不是"分块差了一百倍"。评估会告诉你哪儿不对,但它自己也可能不对------测试集太小、问题太偏、裁判模型有偏见,都会把分数带跑。
工具方面记住三个定位:
| 工具 | 擅长 |
|---|---|
| RAGAS | 不需要人工标准答案,适合快速对比不同 RAG 策略 |
| LlamaIndex Evaluation | 嵌在开发流程里,改完一个组件立刻验一遍 |
| Phoenix | 生产环境的可观测性:追踪每一次调用,事后诊断 Bad Case |
一句话总结
答错了别急着改提示词------先分清是检索没捞对 ,还是生成在瞎说 ,还是压根没答到点 。三元组的意义不在于打出漂亮的分数,而在于让每次优化都能说清自己改进了什么。