文章目录
- 前言
- 零、论文基本信息
- 一、背景与问题
-
- [1. 固定记忆粒度并不适合所有问题](#1. 固定记忆粒度并不适合所有问题)
- [2. 长期记忆不是只写不改的数据库](#2. 长期记忆不是只写不改的数据库)
- [3. 一个 Agent 同时管理所有 Memory 操作并不一定合理](#3. 一个 Agent 同时管理所有 Memory 操作并不一定合理)
- 二、相关工作
-
- [1. Agent 长期记忆](#1. Agent 长期记忆)
- [2. Multi-Agent System](#2. Multi-Agent System)
- [3. AMA 的定位](#3. AMA 的定位)
- 三、方法总览
- 四、Constructor:构建多粒度记忆
-
- [1. 为什么需要同时保存多种记忆?](#1. 为什么需要同时保存多种记忆?)
- [2. 事实抽取](#2. 事实抽取)
- [3. Raw Text Memory:原始文本记忆](#3. Raw Text Memory:原始文本记忆)
- [4. Fact Knowledge Memory:事实知识记忆](#4. Fact Knowledge Memory:事实知识记忆)
- [5. Episode Memory:情节记忆](#5. Episode Memory:情节记忆)
- [6. 三种粒度并不是简单的"短中长期"](#6. 三种粒度并不是简单的“短中长期”)
- 五、Retriever:根据问题动态选择记忆粒度
- 六、Judge:不是检索到就直接使用
-
- [1. 设计动机](#1. 设计动机)
- [2. 第一阶段:Relevance Assessment](#2. 第一阶段:Relevance Assessment)
- [3. 第二阶段:Conflict Detection](#3. 第二阶段:Conflict Detection)
- 七、Refresher:处理长期记忆冲突
-
- [1. 为什么需要独立的 Refresher?](#1. 为什么需要独立的 Refresher?)
- [2. Delete](#2. Delete)
-
- 情况一:用户明确要求忘记
- [情况二:冲突 Memory 已经超过最大保留期限](#情况二:冲突 Memory 已经超过最大保留期限)
- [3. Update](#3. Update)
- 八、一个完整案例
- 九、实验设置
-
- [1. 数据集](#1. 数据集)
- [2. 对比方法](#2. 对比方法)
- [3. Backbone](#3. Backbone)
- 十、主要实验结果
-
- [1. LoCoMo](#1. LoCoMo)
- [2. LongMemEvals](#2. LongMemEvals)
- 十一、消融实验
-
- [1. 三种 Memory 是否都有必要?](#1. 三种 Memory 是否都有必要?)
- [2. Refresher 有多重要?](#2. Refresher 有多重要?)
- 十二、效率分析
- 十三、检索轮数应该设置多少?
- [十四、与已有 Agent Memory 方法的对比](#十四、与已有 Agent Memory 方法的对比)
- 十五、局限性与未来方向
-
- [1. 方法限制](#1. 方法限制)
-
- [多 Agent 增加推理开销](#多 Agent 增加推理开销)
- [强依赖 Backbone 推理能力](#强依赖 Backbone 推理能力)
- [Routing Rule 仍然比较人工](#Routing Rule 仍然比较人工)
- [2. 时间推理仍然不是强项](#2. 时间推理仍然不是强项)
- [3. Memory 更新主要依赖 LLM 逻辑判断](#3. Memory 更新主要依赖 LLM 逻辑判断)
- [4. 工程复杂度比较高](#4. 工程复杂度比较高)
- 十六、我的理解和启发
-
- [1. AMA 最重要的不是 Multi-Agent,而是 Memory Responsibility Separation](#1. AMA 最重要的不是 Multi-Agent,而是 Memory Responsibility Separation)
- [2. 不应该问"Agent 应该使用哪种 Memory",而应该问"这个问题需要哪种 Memory"](#2. 不应该问“Agent 应该使用哪种 Memory”,而应该问“这个问题需要哪种 Memory”)
- [3. Judge 这一层非常值得加入实际 Agent](#3. Judge 这一层非常值得加入实际 Agent)
- [4. Memory Retrieval 应该允许失败](#4. Memory Retrieval 应该允许失败)
- [5. Retry 一定要有预算](#5. Retry 一定要有预算)
- [6. 长期记忆必须有"读路径"和"写路径"](#6. 长期记忆必须有“读路径”和“写路径”)
-
- [Read Path](#Read Path)
- [Write Path](#Write Path)
- [7. 可以如何用到自己的 Agent Framework 中](#7. 可以如何用到自己的 Agent Framework 中)
-
- [Raw Archive](#Raw Archive)
- [Fact Store](#Fact Store)
- [Episode Store](#Episode Store)
- 十七、总结
- 参考资料
前言
随着 LLM Agent 从短对话逐渐走向长期陪伴、个性化助手和复杂多轮任务,Agent 需要保存的历史信息越来越多。
这些历史信息并不是完全同质的。
有些问题只需要知道一个非常具体的事实:
"我之前说过自己用的是哪款 Fitbit?"
有些问题需要回看原始表述:
"我当时具体是怎么描述这个问题的?"
还有一些问题则需要理解一段时间内发生了什么:
"我最近的健身习惯发生了什么变化?"
这三类问题需要的记忆粒度完全不同。
如果系统始终只保存和检索固定长度的文本块,就容易出现两个极端:
- 记忆块太细:虽然细节完整,但一个完整事件被拆散,跨步骤关系难以恢复;
- 记忆块太粗:虽然上下文完整,但大量无关内容也会一起进入上下文,增加 Token 消耗和推理噪声。
更麻烦的是,长期记忆还会持续变化。
例如:
text
1 月:
用户使用 Fitbit Charge 5

↓

6 月:
用户说自己已经换成 Apple Watch
如果系统只是不断追加记忆,那么数据库中最终可能同时存在:
text
用户使用 Fitbit Charge 5
用户使用 Apple Watch
这两条记忆单独看都曾经正确,但如果不处理时间变化和逻辑冲突,未来回答:
"用户现在使用什么手表?"
Agent 就可能召回错误的旧状态。
因此,长期记忆系统真正面临的是两个相互关联的问题:
第一,面对不同任务,应该以什么粒度读取记忆?
第二,随着信息不断变化,如何避免错误、过期和相互矛盾的记忆持续积累?
现有很多 Agent Memory 方法通常使用单一控制器,同时承担:
- 记忆构建;
- 记忆检索;
- 记忆判断;
- 记忆更新。
随着记忆系统变复杂,一个 Agent 同时承担这些职责容易让不同目标纠缠在一起。
AMA 的思路是:
把长期记忆管理本身拆成一个多 Agent 协作系统。
AMA 全称为 Adaptive Memory via Multi-Agent Collaboration。
它设置了四个专门负责不同记忆操作的 Agent:
text
Constructor
负责构建不同粒度的记忆

↓

Retriever
判断当前问题需要什么粒度的记忆,并负责召回

↓

Judge
检查召回结果是否相关、是否存在逻辑冲突

↓

Refresher
针对冲突记忆执行更新或删除
与此同时,AMA 不再只维护一种记忆,而是同时维护:
text
Raw Text Memory
原始文本记忆

Fact Knowledge Memory
事实知识记忆

Episode Memory
情节记忆
不同问题进入系统后,由 Retriever 动态判断应该访问哪一层记忆。
如果召回内容不够相关,Judge 会要求 Retriever 重新检索;如果发现新信息和旧记忆存在冲突,Judge 会进一步激活 Refresher 修改已有记忆。
因此,我认为 AMA 真正值得关注的并不是简单地:
"用了四个 Agent。"
而是它把长期记忆系统中的两个核心能力放在了一起:
自适应记忆粒度选择 + 主动长期一致性维护。
论文发表于 Findings of ACL 2026。AMA 将记忆生命周期拆分为 Constructor、Retriever、Judge 和 Refresher 四个角色,并通过 Raw Text、Fact Knowledge 和 Episode 三种粒度支持动态检索。
零、论文基本信息
- 论文名称:AMA: Adaptive Memory via Multi-Agent Collaboration
- 发表平台:Findings of ACL 2026
- 代码仓库:截至本文整理时,论文与 ACL Anthology 页面未提供官方代码仓库
- 作者信息:Weiquan Huang、Zixuan Wang、Hehai Lin、Sudong Wang、Bo Xu、Qian Li、Beier Zhu、Linyi Yang、Chengwei Qin;作者来自香港科技大学(广州)、山东大学、南洋理工大学和南方科技大学。
一、背景与问题
1. 固定记忆粒度并不适合所有问题
很多长期记忆系统都会先把历史信息切分成固定长度的 Chunk,再通过向量相似度进行检索。
例如:
text
历史对话
    ↓
固定切块
    ↓
Embedding
    ↓
Vector Database
    ↓
Top-K Retrieval
这种方法实现简单,但隐含了一个假设:
不同问题需要的信息粒度大致相同。
实际并非如此。
假设历史对话中包含:
text
用户:
我去年买了一块 Fitbit Inspire HR,
最近开始每天晚上跑步,
但是我发现睡眠统计似乎越来越不准。
如果问题是:
用户使用什么设备?
最合理的记忆是:
text
用户使用 Fitbit Inspire HR。这属于原子事实。
如果问题是:
用户原话是怎么描述睡眠问题的?
则应该直接查看:
text
最近开始每天晚上跑步,
但是我发现睡眠统计似乎越来越不准。这需要原始文本。
如果问题是:
总结一下用户最近的健康与运动情况。
则需要把多轮对话放到一起理解,更适合使用情节级摘要。
因此,同一段历史实际上存在多种合理表示。
论文将固定粒度带来的问题概括为一种"粒度错配":
text
粒度过细
→ 信息碎片化
→ 逻辑依赖被拆散

粒度过粗
→ 无关内容增加
→ 上下文噪声和 Token 成本上升
AMA 的目标不是找到一个"最佳固定粒度",而是:
根据当前问题,动态选择合适的记忆粒度。
这一问题正是论文 Figure 1 所强调的核心动机:静态方法要么粒度过粗、引入噪声,要么粒度过细、造成信息损失;AMA 则根据任务需求动态选择记忆形式。
为了直观理解这个区别,可以先看论文 Figure 1。
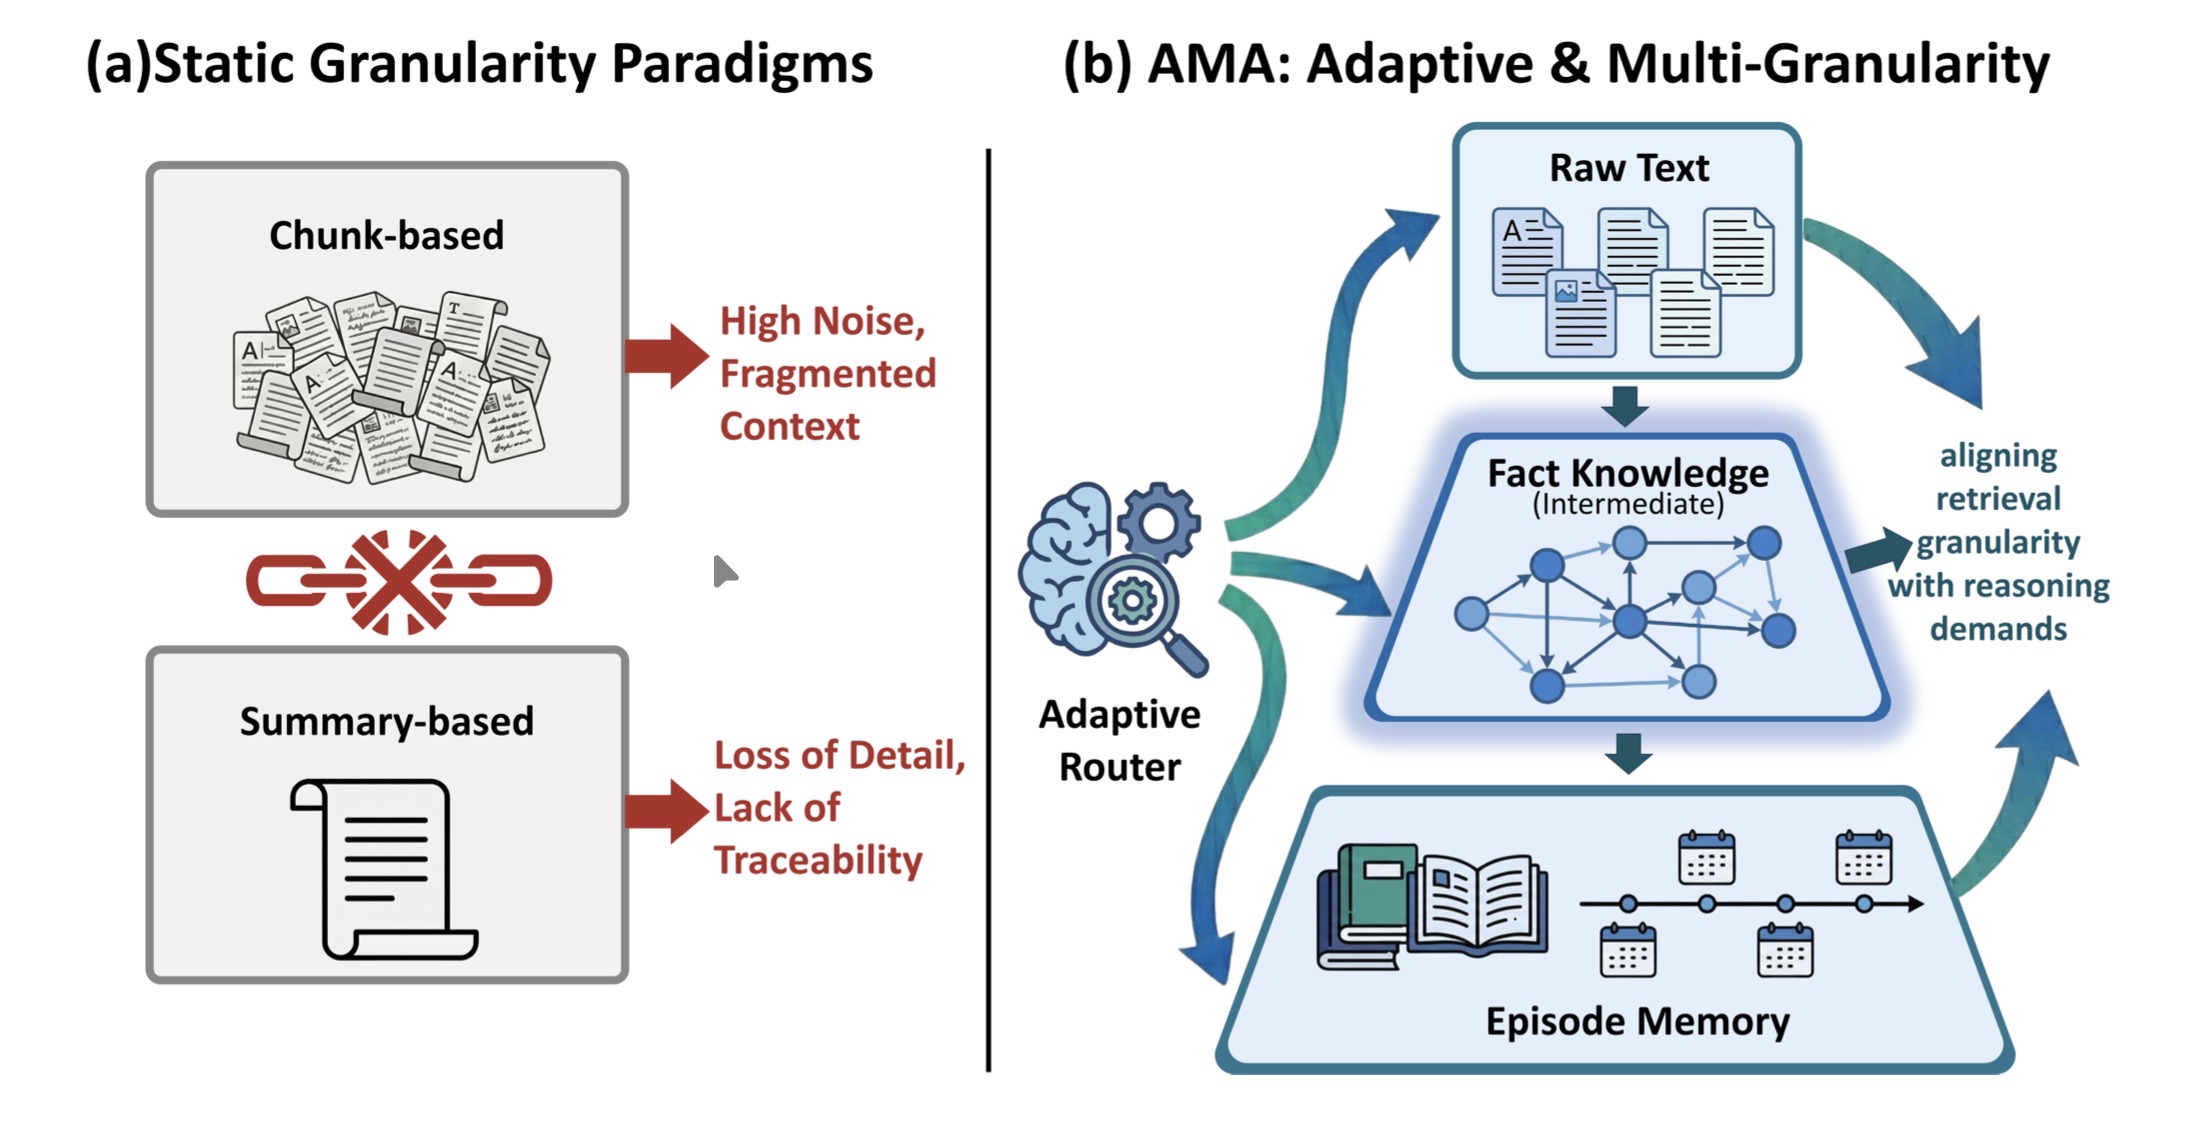
图源:论文 Figure 1。
Figure 1 对比了固定粒度记忆和 AMA 的自适应记忆机制。固定粒度方法很难同时兼顾细节与整体语义,而 AMA 根据当前推理需求选择不同粒度的记忆。
2. 长期记忆不是只写不改的数据库
另一个问题是:
Memory 会过期。
假设用户先说:
text
我现在住在上海。几个月后又说:
text
我已经搬到北京了。如果系统只做 ADD:
text
Memory 1:
用户住在上海。

Memory 2:
用户住在北京。
两条记录会同时存在。
检索时,一旦旧记录因为语义相似被召回,就可能造成错误回答。
因此,长期记忆系统必须区分:
text
新增事实
≠
状态变化
用户搬家并不是:
"增加一个北京地址事实。"
更准确的理解是:
"用户当前位置发生了更新。"
这要求记忆系统具备:
- 冲突检测;
- 过时信息识别;
- 精确更新;
- 必要时删除。
AMA 认为,单纯依赖不断累积记忆和粗粒度重写,会让冗余、冲突和错误随着长期交互持续增加。
3. 一个 Agent 同时管理所有 Memory 操作并不一定合理
很多 Agentic Memory 方法已经开始让 LLM 自主决定:
- 写什么;
- 检索什么;
- 更新什么。
但通常仍然由一个控制器完成。
AMA 认为:
text
Memory Construction
Memory Retrieval
Memory Verification
Memory Update
这些任务的目标并不完全一致。
例如:
Retriever 的目标是:
尽可能找到有用信息。
Judge 的目标则是:
尽可能排除不相关或冲突信息。
Refresher 的目标又变成:
精确修改 Memory Store。
如果全部塞进一个统一 Prompt:
text
请理解输入
→ 判断要查什么
→ 检索
→ 判断结果
→ 找冲突
→ 更新数据库
→ 生成回答
任务会越来越复杂。
因此 AMA 采用角色分工:
text
Constructor:负责记

Retriever:负责找

Judge:负责审

Refresher:负责改
这里的 Multi-Agent 不是为了"多几个模型一起讨论",而是:
将 Memory Lifecycle 中不同性质的决策显式解耦。
论文明确将 AMA 与多数单一控制器式 Agent Memory 区分开,并指出多角色分工可以避免检索、验证和维护目标纠缠。
二、相关工作
AMA 的相关工作主要可以分为两条路线。
1. Agent 长期记忆
早期长期记忆方法通常直接保存历史对话。
后续逐渐出现更加结构化的方法。
例如:
- MemGPT:通过类似操作系统分页机制,在上下文与外部存储之间移动记忆;
- Mem0:将长期记忆抽象为独立 Memory Layer,并进行事实级更新;
- A-MEM:使用类似 Zettelkasten 的动态链接组织记忆;
- Zep:通过时间感知知识图管理长期事实;
- Nemori:将长期对话组织为具有语义结构的情节记忆。
这些方法逐渐从:
text
完整历史发展到:
text
结构化长期记忆但 AMA 认为仍然存在两个不足:
- 检索粒度通常仍然比较固定;
- 长期一致性维护不足。
特别是:
即使一个系统同时保存多个层级的信息,如果运行时不知道什么时候该查哪一层,多粒度结构本身也不会自动转化成更好的推理。
论文将 Mem0、Nemori 和 Zep 等工作作为重要的 Agent Memory 前序路线,并指出这些方法在不同抽象层级之间缺乏显式的自适应协调机制。
2. Multi-Agent System
另一个相关方向是多智能体系统。
多 Agent 常通过角色分工提高复杂任务中的:
- 可靠性;
- 专业化;
- 过程验证;
- 协同决策。
例如,在软件工程任务中,可以分别设置:
text
Planner
Coder
Reviewer
Tester
每个 Agent 负责不同职责。
AMA 把这种思想应用到了 Memory System:
text
传统 MAS:
多个 Agent 协作解决任务

AMA:
多个 Agent 协作管理 Memory
与普通 Multi-Agent 最大区别是:
AMA 中四个 Agent 的协作对象不是外部任务,而是 Memory Lifecycle 本身。
论文还提到 MIRIX 也采用专业化 Agent 进行记忆组织,但作者没有将其加入实验基线,因为实验阶段官方实现尚未公开;AMA 进一步强调长期一致性检查和更新机制。
3. AMA 的定位
可以把几种代表方法简单理解为:
| 方法 | 核心思想 | 主要解决的问题 |
|---|---|---|
| Mem0 | 事实级 ADD / UPDATE / DELETE | 记忆如何维护 |
| A-MEM | 动态关联和演化 | 记忆如何形成关系 |
| Zep | 时间知识图 | 如何表示随时间变化的实体关系 |
| Nemori | 自组织情节记忆 | 如何形成高层语义结构 |
| AMA | 多粒度 Memory + 多 Agent 协作 | 如何根据问题动态选择粒度并维护一致性 |
AMA 的核心增量不是单独提出一种新的 Memory Representation。
而是:
把"存什么粒度、查什么粒度、结果是否可靠、旧记忆是否要更新"连接成一个可反馈的多 Agent Memory Pipeline。
三、方法总览
为了理解 AMA 的整体结构,可以先看论文 Figure 2。
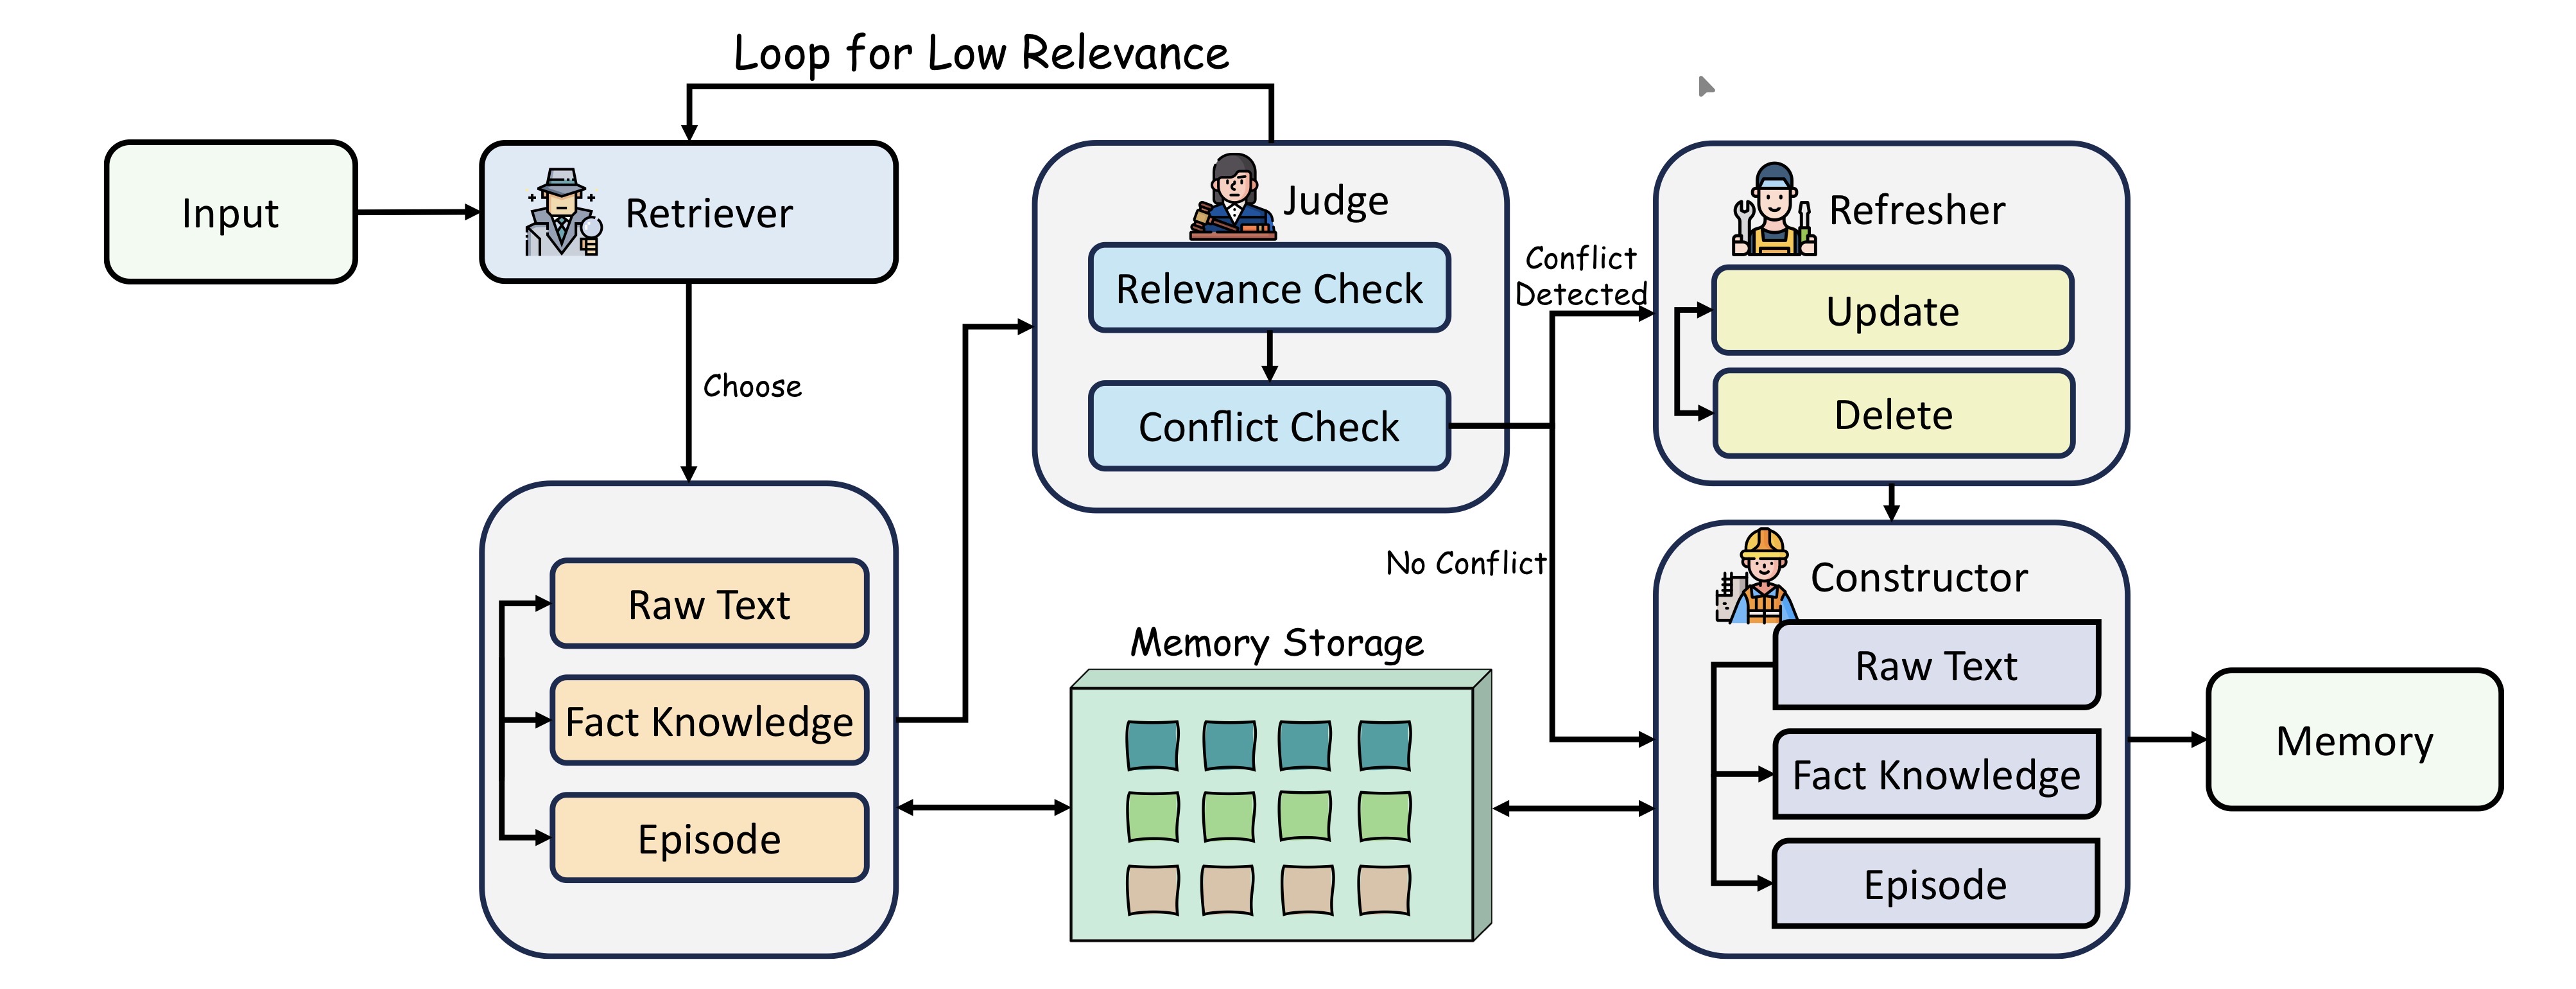
图源:论文 Figure 2。
Figure 2 展示了 AMA 的完整工作流:Retriever 根据输入选择不同粒度的记忆,Judge 对结果进行相关性和冲突检查;相关性不足时重新检索,检测到冲突时调用 Refresher;经过验证的信息最终由 Constructor 整理进入不同记忆层。
AMA 包含四个 Agent:
text
                当前输入
                   ↓
               Retriever
                   ↓
       选择合适的 Memory Granularity
                   ↓
                 Judge
              ↙          ↘
       相关性不足          发现冲突
          ↓                  ↓
      Retriever          Refresher
      再次检索            更新 / 删除
              ↘          ↙
             验证后的 Memory
                    ↓
               Constructor
                    ↓
          Multi-Granularity Memory
这里需要注意一个顺序问题。
从系统持续运行的角度看:
- Constructor 负责不断构建 Memory;
- Retriever 负责查询 Memory;
- Judge 验证召回结果;
- Refresher 修复冲突。
而论文描述一次查询流程时,是从 Retriever 开始:
text
Retriever
→ Judge
→ Refresher(如果冲突)
→ Constructor
这四个角色构成了一个闭环,而不是简单的顺序 Pipeline。
四、Constructor:构建多粒度记忆
1. 为什么需要同时保存多种记忆?
AMA 不试图寻找一个统一的最佳 Memory Granularity。
它直接维护三种:
text
Raw Text Memory
原始文本

Fact Knowledge Memory
事实知识

Episode Memory
情节记忆
这三种 Memory 分别解决:
text
细节
↓
Raw Text

具体事实
↓
Fact Knowledge

跨轮次整体语义
↓
Episode
Constructor 根据当前输入、上下文窗口和已经过冲突检查的历史记忆,生成这些不同粒度的表示。
为了观察三个粒度如何从一段对话中同时产生,可以看论文 Figure 3。
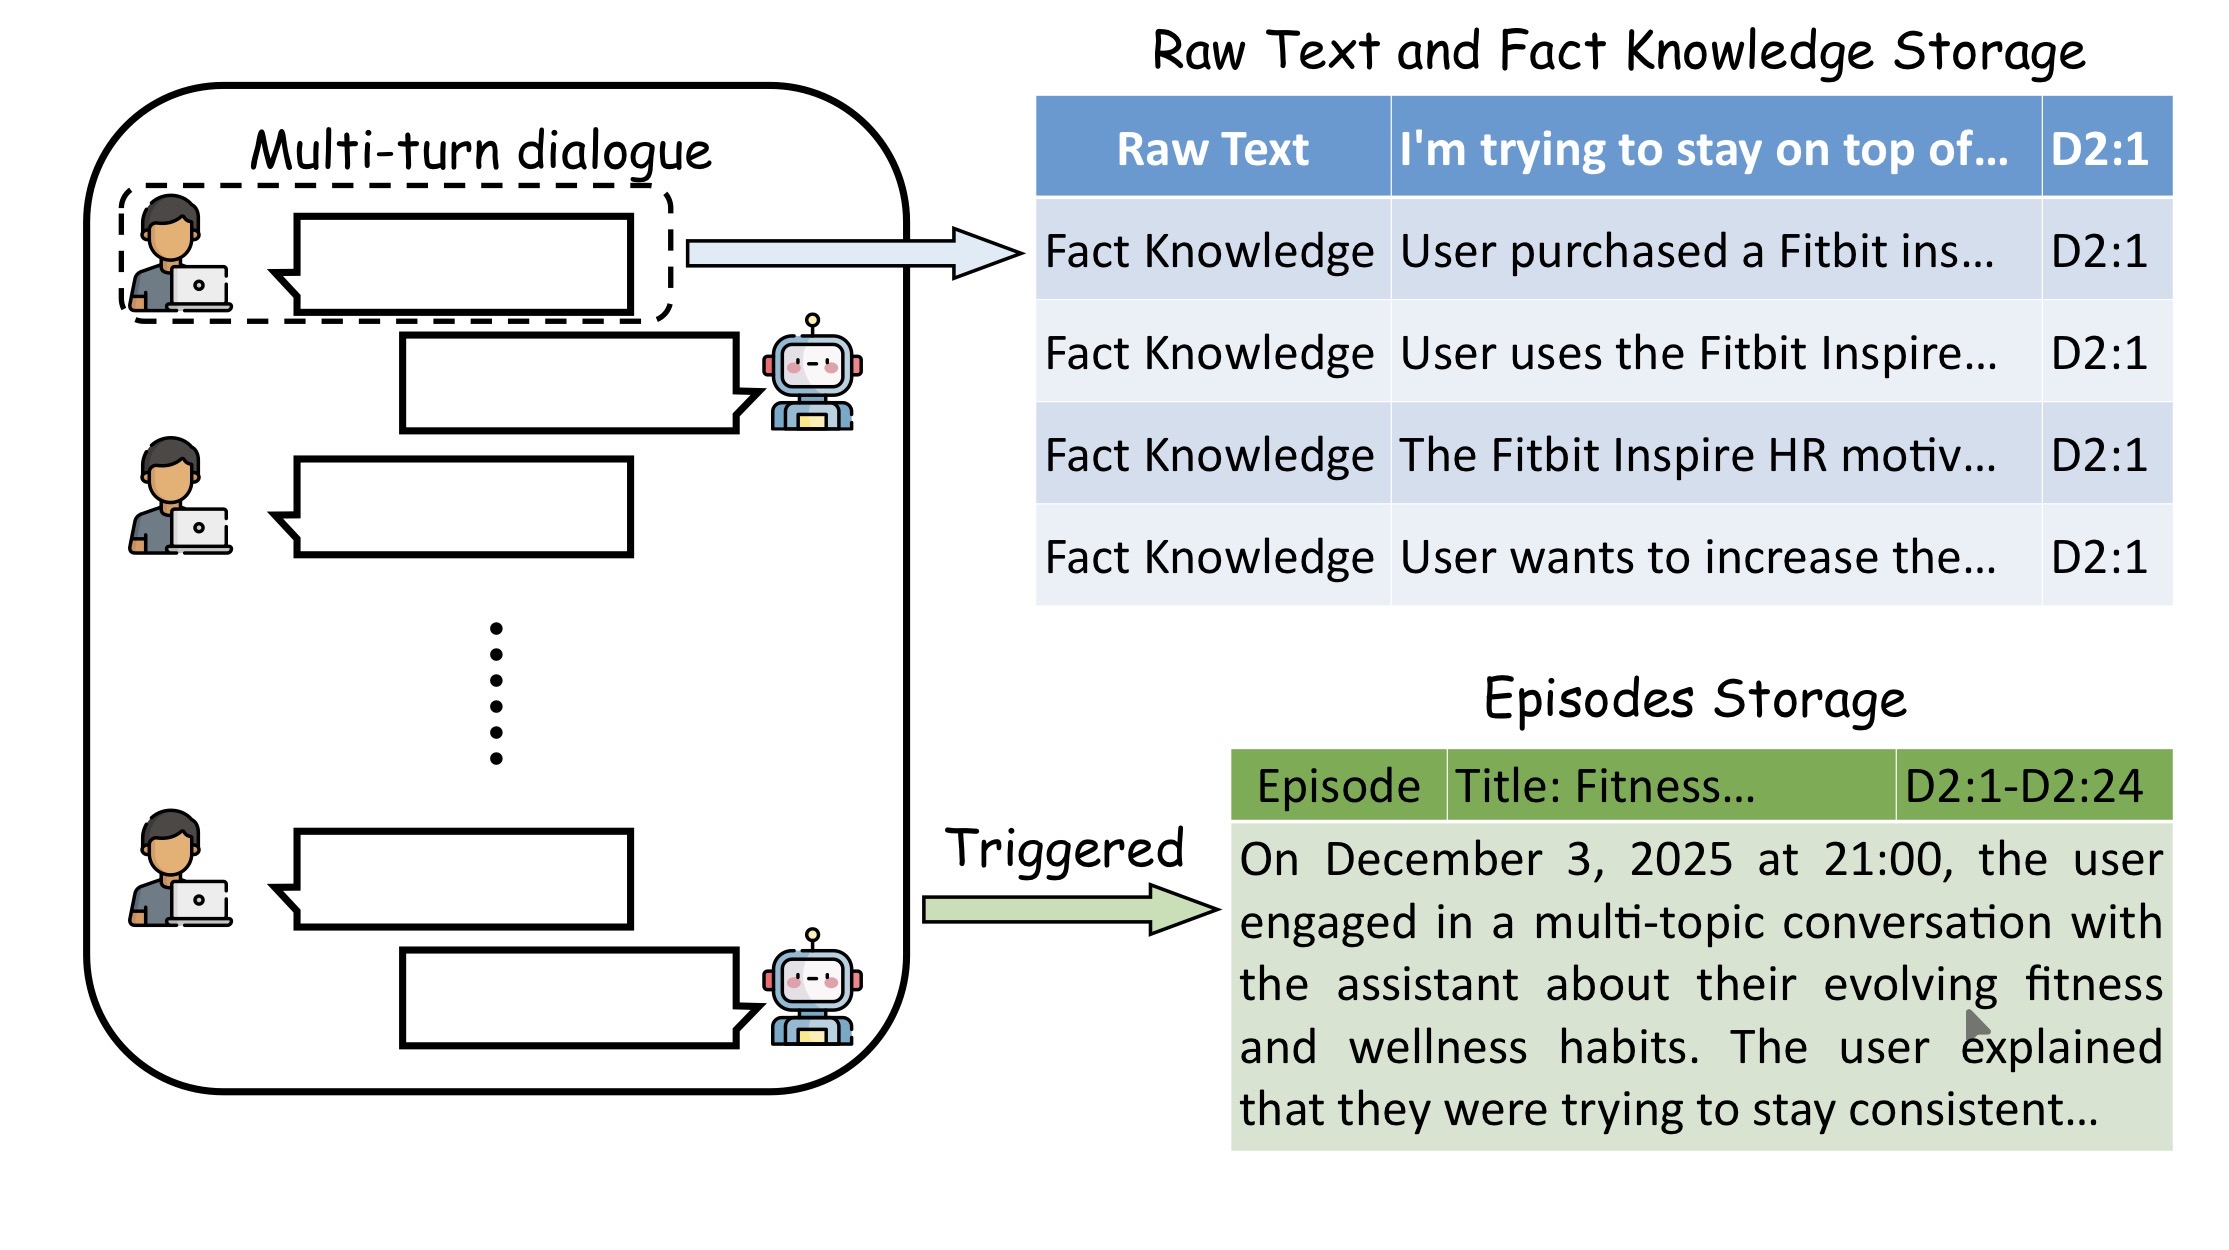
图源:论文 Figure 3。
Figure 3 展示 Memory Construction Stage。原始话语会直接形成 Raw Text,同时被拆成多个 Fact Knowledge;当触发 Episode 条件时,多轮历史进一步被抽象为 Episode Memory。
2. 事实抽取
设当前输入为:
u t u_t ut
当前上下文窗口为:
W t W_t Wt
已经通过一致性检查的历史记忆为:
H t ∗ H_t^* Ht∗
Constructor 根据 Prompt P c o n P_{con} Pcon 得到:
K t , R t ← C o n s t r u c t o r ( u t , W t ∥ H t ∗ ∥ P c o n ) K_t,R_t\leftarrow \mathrm{Constructor}(u_t,W_t\Vert H_t^*\Vert P_{con}) Kt,Rt←Constructor(ut,Wt∥Ht∗∥Pcon)
其中:
- K t K_t Kt 表示从当前内容中提取出的事实集合;
- R t R_t Rt 表示与当前内容相关的历史对话索引;
- ∥ \Vert ∥ 表示上下文拼接。
论文没有让 LLM 随意生成一句摘要,而是借助基本句法结构,将事实约束为若干较稳定的模板:
text
S-V
S-V-O
S-V-C
S-V-O-O
S-V-O-C
也就是围绕:
- Subject;
- Verb;
- Object;
- Complement;
拆分成更原子的事实。
例如:
text
用户说:

"I bought a Fitbit Inspire HR
and want to increase my daily activity."
可以拆成:
text
User purchased a Fitbit Inspire HR.

User uses a Fitbit Inspire HR.

User wants to increase daily activity.
这样做有两个好处:
- 一条事实对应一个较明确的语义单位;
- 后续冲突检测可以精确定位到具体事实,而不是重写整段摘要。
论文还为对话轮次建立唯一标识 D s : j D_{s:j} Ds:j,其中 s s s 表示 Session, j j j 表示该 Session 中的第 j j j 轮,并为记忆附加时间戳、轮次 ID 和 Speaker 信息,以支持长期追踪和时间相关冲突判断。
3. Raw Text Memory:原始文本记忆
Raw Text Memory 保存当前轮原始输入。
形式可以写成:
m t r a w = u t , R t , Ω t m_t^{raw}={u_t,R_t,\Omega_t} mtraw=ut,Rt,Ωt
其中:
- u t u_t ut:当前原始文本;
- R t R_t Rt:相关历史轮次;
- Ω t \Omega_t Ωt:时间戳、Dialogue ID、Speaker 等元信息。
这一层基本不做语义抽象。
它的目标是:
保留最细粒度、可追溯的历史。
例如:
text
用户:
"I actually said Fitbit Inspire HR,
not Fitbit Charge."
如果未来问题要求:
"用户当时的原话是什么?"
直接查看 Raw Text 比读取事实摘要更可靠。
因此,Raw Text 可以看作:
AMA 中的信息底座。
论文强调 Raw Text Memory 主要用于保留完整会话轨迹、支持可追溯性和细粒度检索。
4. Fact Knowledge Memory:事实知识记忆
Fact Knowledge 将每个抽取出来的事实作为独立 Memory Unit:
m t , i f a c t = k t , i , R t , Ω t m_{t,i}^{fact}={k_{t,i},R_t,\Omega_t} mt,ifact=kt,i,Rt,Ωt
其中:
- k t , i k_{t,i} kt,i 表示第 i i i 个事实;
- R t R_t Rt 保留其来源;
- Ω t \Omega_t Ωt 保留时间和身份信息。
例如:
text
Raw Text:

"I recently replaced my Fitbit
with an Apple Watch."
可以形成:
text
Fact 1:
User previously used a Fitbit.

Fact 2:
User now uses an Apple Watch.
这一层特别适合:
- 用户偏好;
- 设备信息;
- 地点;
- 职业;
- 人物关系;
- 配置状态。
相比 Raw Text,它更适合高精度事实检索;相比 Episode,它又保留了更细的语义单元。
而且:
Refresher 的精确更新主要依赖这种原子化事实。
因为如果所有知识都放在一段大摘要中,修改一个事实就可能影响整段内容。
5. Episode Memory:情节记忆
Episode Memory 用于保存跨多个 Turn 的高层语义。
它不会每轮都生成。
论文设计一个 Trigger:
T t ∈ 0 , 1 T_t\in{0,1} Tt∈0,1
并通过:
T t = C o n s t r u c t o r ( u t , W t ∥ P t r i ) T_t=\mathrm{Constructor}(u_t,W_t\Vert P_{tri}) Tt=Constructor(ut,Wt∥Ptri)
判断是否需要生成 Episode。
触发条件包括三类:
- 检测到 Topic Shift;
- 用户显式请求;
- Context Window 达到阈值。
当:
T t = 1 T_t=1 Tt=1
Constructor 使用另一个 Prompt P e p i P_{epi} Pepi 生成:
E t = C o n s t r u c t o r ( u t , W t ∥ P e p i ) E_t=\mathrm{Constructor}(u_t,W_t\Vert P_{epi}) Et=Constructor(ut,Wt∥Pepi)
并将其作为:
m t e p i = E t m_t^{epi}=E_t mtepi=Et
保存。
例如,连续十几轮对话可能涉及:
text
跑步频率
睡眠质量
健身设备
饮食习惯
健康目标
系统最终形成一个 Episode:
text
用户最近开始更加规律地进行晚间跑步,
同时关注 Fitbit 记录的睡眠质量,
并希望通过调整运动和饮食提高整体健康状态。
因此:
text
Raw Text
→ 具体说了什么

Fact Knowledge
→ 具体知道什么

Episode
→ 这一阶段总体发生了什么
论文的 Episode 生成并非固定轮数触发,而是在主题切换、显式请求或上下文接近饱和时生成跨轮次摘要。
6. 三种粒度并不是简单的"短中长期"
很容易把 AMA 理解成:
text
Raw Text = 短期记忆
Fact = 中期记忆
Episode = 长期记忆
但这种理解并不准确。
三个 Memory 的主要区别是:
语义粒度,而不是保存时间。
| 类型 | 信息粒度 | 适合的问题 |
|---|---|---|
| Raw Text | 最细 | 原话、细节、具体描述 |
| Fact Knowledge | 原子事实 | 人物属性、偏好、状态 |
| Episode | 高层抽象 | 总结、跨时间事件、整体变化 |
也就是说:
AMA 的 Hierarchy 本质上是一个 Abstraction Hierarchy。
五、Retriever:根据问题动态选择记忆粒度
1. 设计动机
有了三层 Memory 之后,新的问题出现了:
当前问题到底应该查哪一层?
如果每次全部查:
text
Raw
+
Fact
+
Episode
那就失去了多粒度设计降低噪声的意义。
因此 Retriever 是 AMA 中非常关键的组件。
它不是简单做 Top-K Vector Search,而是先:
text
理解 Query
    ↓
判断 Query Intent
    ↓
选择 Memory Granularity
    ↓
执行检索
论文把 Retriever 定义为 AMA 的 Memory Access Gateway。
2. Query Rewrite
长对话中,用户经常会问:
text
"那他后来怎么样了?"单独拿出来几乎无法检索。
Retriever 首先结合近期 Context:
W t W_t Wt
将问题改写成独立 Query:
u t ′ u_t' ut′
例如:
text
原问题:

"那它是什么型号?"
↓
text
重写:

"What model of Fitbit does the user use?"
这样可以避免:
- 指代不清;
- 主语省略;
- 上下文缺失。
3. 四维 Intent Vector
Retriever 同时生成一个四维二值向量:
B = b f i n e , b a b s , b e v e n t , b a t o m i c B=b_{fine},b_{abs},b_{event},b_{atomic} B=bfine,babs,bevent,batomic
四个维度分别表示:
- b f i n e b_{fine} bfine:是否需要细粒度细节;
- b a b s b_{abs} babs:是否需要抽象总结;
- b e v e n t b_{event} bevent:是否涉及跨时间事件;
- b a t o m i c b_{atomic} batomic:是否需要原子事实。
除此之外,Retriever 还预测:
K d y n K_{dyn} Kdyn
也就是当前问题预计需要多少条 Memory。
整个过程可以写成:
u t ′ , B , K d y n ← R e t r i e v e r ( u t , W t ∥ P r e t ) u_t',B,K_{dyn}\leftarrow \mathrm{Retriever}(u_t,W_t\Vert P_{ret}) ut′,B,Kdyn←Retriever(ut,Wt∥Pret)
这意味着 AMA 不仅动态选择:
"查哪里?"
还会动态决定:
"大概查多少?"
4. Granularity Routing
根据 Intent Vector,AMA 使用优先级规则选择 Memory:
O = f M ( B ) O=f_M(B) O=fM(B)
具体为:
text
如果 bfine = 1
    ↓
Raw Text Memory

否则,如果 babs = 1 或 bevent = 1
    ↓
Episode Memory

否则
    ↓
Fact Knowledge Memory
也就是:
查询具体原话
text
"我当时具体说了什么?"↓
text
Raw Text查询整体变化
text
"总结一下我最近的健身情况。"↓
text
Episode查询具体事实
text
"我用什么设备?"↓
text
Fact Knowledge论文明确规定了这一优先级路由逻辑:细节型查询进入 Raw Text,抽象或跨事件查询进入 Episode,其余默认进入 Fact Knowledge。
5. Granularity 内部仍使用向量检索
AMA 并没有抛弃 Embedding Retrieval。
确定目标 Memory Store 之后,仍然计算改写 Query 和 Memory Entry 的余弦相似度:
s i = cos ( f e n c ( u t ′ ) , e i ) s_i=\cos(f_{enc}(u_t'),e_i) si=cos(fenc(ut′),ei)
其中:
- f e n c f_{enc} fenc 表示 Embedding Encoder;
- e i e_i ei 表示第 i i i 条 Memory 的向量;
- s i s_i si 表示语义相似度。
最终取 Top-K:
H t = T o p K ( m i i = 1 ∣ M ∣ , k e y = s i ) H_t=\mathrm{TopK}({m_i}_{i=1}^{|M|},key=s_i) Ht=TopK(mii=1∣M∣,key=si)
但这里的:
K K K
不是完全固定,而是:
K = max ( K d y n , K m ) K=\max(K_{dyn},K_m) K=max(Kdyn,Km)
其中:
- K d y n K_{dyn} Kdyn:Retriever 动态预测;
- K m K_m Km:最低检索数量。
因此,AMA 的检索可以概括为:
text
第一阶段:
选择 Memory Space

第二阶段:
在选中的 Memory Space 内做 Top-K
这和传统 RAG 最大区别在于:
text
传统 RAG:

Query
 ↓
统一向量库
 ↓
Top-K


AMA:

Query
 ↓
Intent Routing
 ↓
Raw / Fact / Episode
 ↓
Top-K
六、Judge:不是检索到就直接使用
1. 设计动机
Retriever 最终还是基于向量相似度。
但:
Semantic Similarity 并不等于真正有用。
例如当前问题:
text
用户现在使用什么运动设备?Retriever 可能取回:
text
用户以前使用 Fitbit。

用户现在使用 Apple Watch。

用户曾经购买 Fitbit 表带。
这三条在向量空间中都非常相似。
如果全部直接放给主 Agent:
- 可能引入旧状态;
- 可能增加噪声;
- 可能产生冲突。
因此 AMA 在 Retriever 后增加 Judge。
Judge 不负责回答问题,而负责:
text
检索结果
  ↓
相关吗?
  ↓
一致吗?
论文将这一过程称为 sequential dual-verification。
2. 第一阶段:Relevance Assessment
Judge 首先判断:
当前 Memory 对问题真的有用吗?
如果有效信息密度太低,Judge 不会强行使用结果,而是输出:
text
Retry然后 Retriever 可以:
- 查询其他记忆粒度;
- 根据关系索引 R t R_t Rt 扩展检索范围。
整个 Retry 过程受到最大检索轮数:
K r K_r Kr
限制。
因此:
text
Retriever
    ↓
Memory
    ↓
Judge
    ↓
相关性不足
    ↓
Retry
    ↓
Retriever
构成一个反馈循环。
这非常重要。
传统 Retriever 通常:
text
Top-K
=
最终结果
AMA:
text
Top-K
=
候选结果
Retriever 只负责召回。
Judge 才决定:
"这些 Memory 到底能不能用。"
论文明确指出,如果相关信息比例不足,Judge 会触发 Retry,让 Retriever 访问剩余粒度或进行关系扩展,直到达到轮数上限。
3. 第二阶段:Conflict Detection
通过相关性检查后,还需要判断:
Memory 和当前输入有没有矛盾?
例如:
text
历史 Memory:

User uses Fitbit Inspire HR.
当前输入:
text
I stopped using Fitbit.
I use an Apple Watch now.
Judge 会识别出:
text
Fitbit
vs
Apple Watch
之间存在状态变化。
冲突记忆组成:
C e r r C_{err} Cerr
随后触发:
text
Refresh调用 Refresher。
如果不存在冲突,则得到最终验证后的 Memory:
H t ∗ H_t^* Ht∗
论文将 Judge 的整体输出形式化为:
H t ∗ , C e r r , A c t i o n ← J u d g e ( u t , H t , W t ∥ P j u d ) H_t^*,C_{err},Action\leftarrow \mathrm{Judge}(u_t,H_t,W_t\Vert P_{jud}) Ht∗,Cerr,Action←Judge(ut,Ht,Wt∥Pjud)
其中:
A c t i o n ∈ P a s s , R e t r y , R e f r e s h Action\in{Pass,Retry,Refresh} Action∈Pass,Retry,Refresh
分别表示:
text
Pass
→ 记忆相关且一致,可以使用

Retry
→ 相关性不足,重新检索

Refresh
→ 存在逻辑冲突,更新记忆
七、Refresher:处理长期记忆冲突
1. 为什么需要独立的 Refresher?
长期记忆系统不能只有:
text
Write
+
Retrieve
还必须能够:
text
Update
+
Forget
否则随着交互增加:
text
正确旧事实
+
新事实
+
过期事实
+
重复事实
+
冲突事实
会不断累积。
Refresher 只在 Judge 检测到:
C e r r ≠ ∅ C_{err}\neq\varnothing Cerr=∅
时激活。
也就是说:
它并不是每轮都对整个 Memory Store 做重写,而是事件驱动的局部维护。
2. Delete
AMA 对删除非常保守。
论文规定只有两种情况执行 Delete:
情况一:用户明确要求忘记
例如:
text
"忘掉我之前告诉你的住址。"情况二:冲突 Memory 已经超过最大保留期限
此时:
text
旧事实
+
已经失效
+
超过生命周期
才会真正从 Memory Store 中删除。
因此 AMA 并不是:
text
发现冲突
→ Delete
而是优先:
text
发现冲突
→ Update
这种策略可以减少因为一次状态变化而直接丢失记忆连续性的风险。
3. Update
其他冲突默认通过 Update 解决:
m i ← U ( m i , u t ) m_i\leftarrow U(m_i,u_t) mi←U(mi,ut)
例如:
text
旧:

User lives in Shanghai.

新:

User moved to Beijing.
更新后可以变成:
text
User currently lives in Beijing.同时保留来源和时间信息。
最终 Refresher 输出:
H t ∗ ← R e f r e s h e r ( C e r r , H t ∥ P r e f ) H_t^*\leftarrow \mathrm{Refresher}(C_{err},H_t\Vert P_{ref}) Ht∗←Refresher(Cerr,Ht∥Pref)
更新后的冲突无关 Memory 会重新进入:
- Constructor;
- 下游 Response Agent。
论文的 Refresher 正是 AMA 在 LongMemEvals 的 Knowledge-update 类问题上表现突出的一项关键设计。
八、一个完整案例
为了把四个 Agent 串起来,可以构造一个简化例子。
假设历史中已有:
text
D1:5

User:
I use a Fitbit Inspire HR.
Constructor 保存:
text
Raw Text:
I use a Fitbit Inspire HR.

Fact:
User uses Fitbit Inspire HR.

Episode:
用户近期关注使用 Fitbit 记录运动和健康数据。
一段时间后:
text
D5:2

User:
I finally switched from Fitbit to Apple Watch.
此时系统开始工作。
第一步:Retriever
当前信息涉及:
text
设备状态因此 Retriever 判断:
text
batomic = 1路由到:
text
Fact Knowledge Memory召回:
text
User uses Fitbit Inspire HR.第二步:Judge
Judge 比较:
text
历史:
User uses Fitbit Inspire HR.

当前:
User switched to Apple Watch.
检测到状态冲突:
text
Cerr ≠ ∅输出:
text
Refresh第三步:Refresher
由于用户没有要求删除历史,而且这是普通状态更新,因此执行:
text
Update把当前有效状态修改为:
text
User currently uses Apple Watch.第四步:Constructor
Constructor 将新信息重新写入不同粒度:
text
Raw Text:
I finally switched from Fitbit to Apple Watch.

Fact:
User currently uses Apple Watch.

Episode:
用户的健康设备从 Fitbit 迁移到了 Apple Watch。
未来如果用户问:
text
"我现在用什么设备?"Retriever:
text
Fact Knowledge
→ Apple Watch
如果问:
text
"我这段时间换设备的情况怎么样?"Retriever:
text
Episode
→ Fitbit → Apple Watch
如果问:
text
"我当时是怎么说换手表这件事的?"Retriever:
text
Raw Text
→ 原始表述
这正是 AMA 所谓:
Adaptive Memory Granularity。
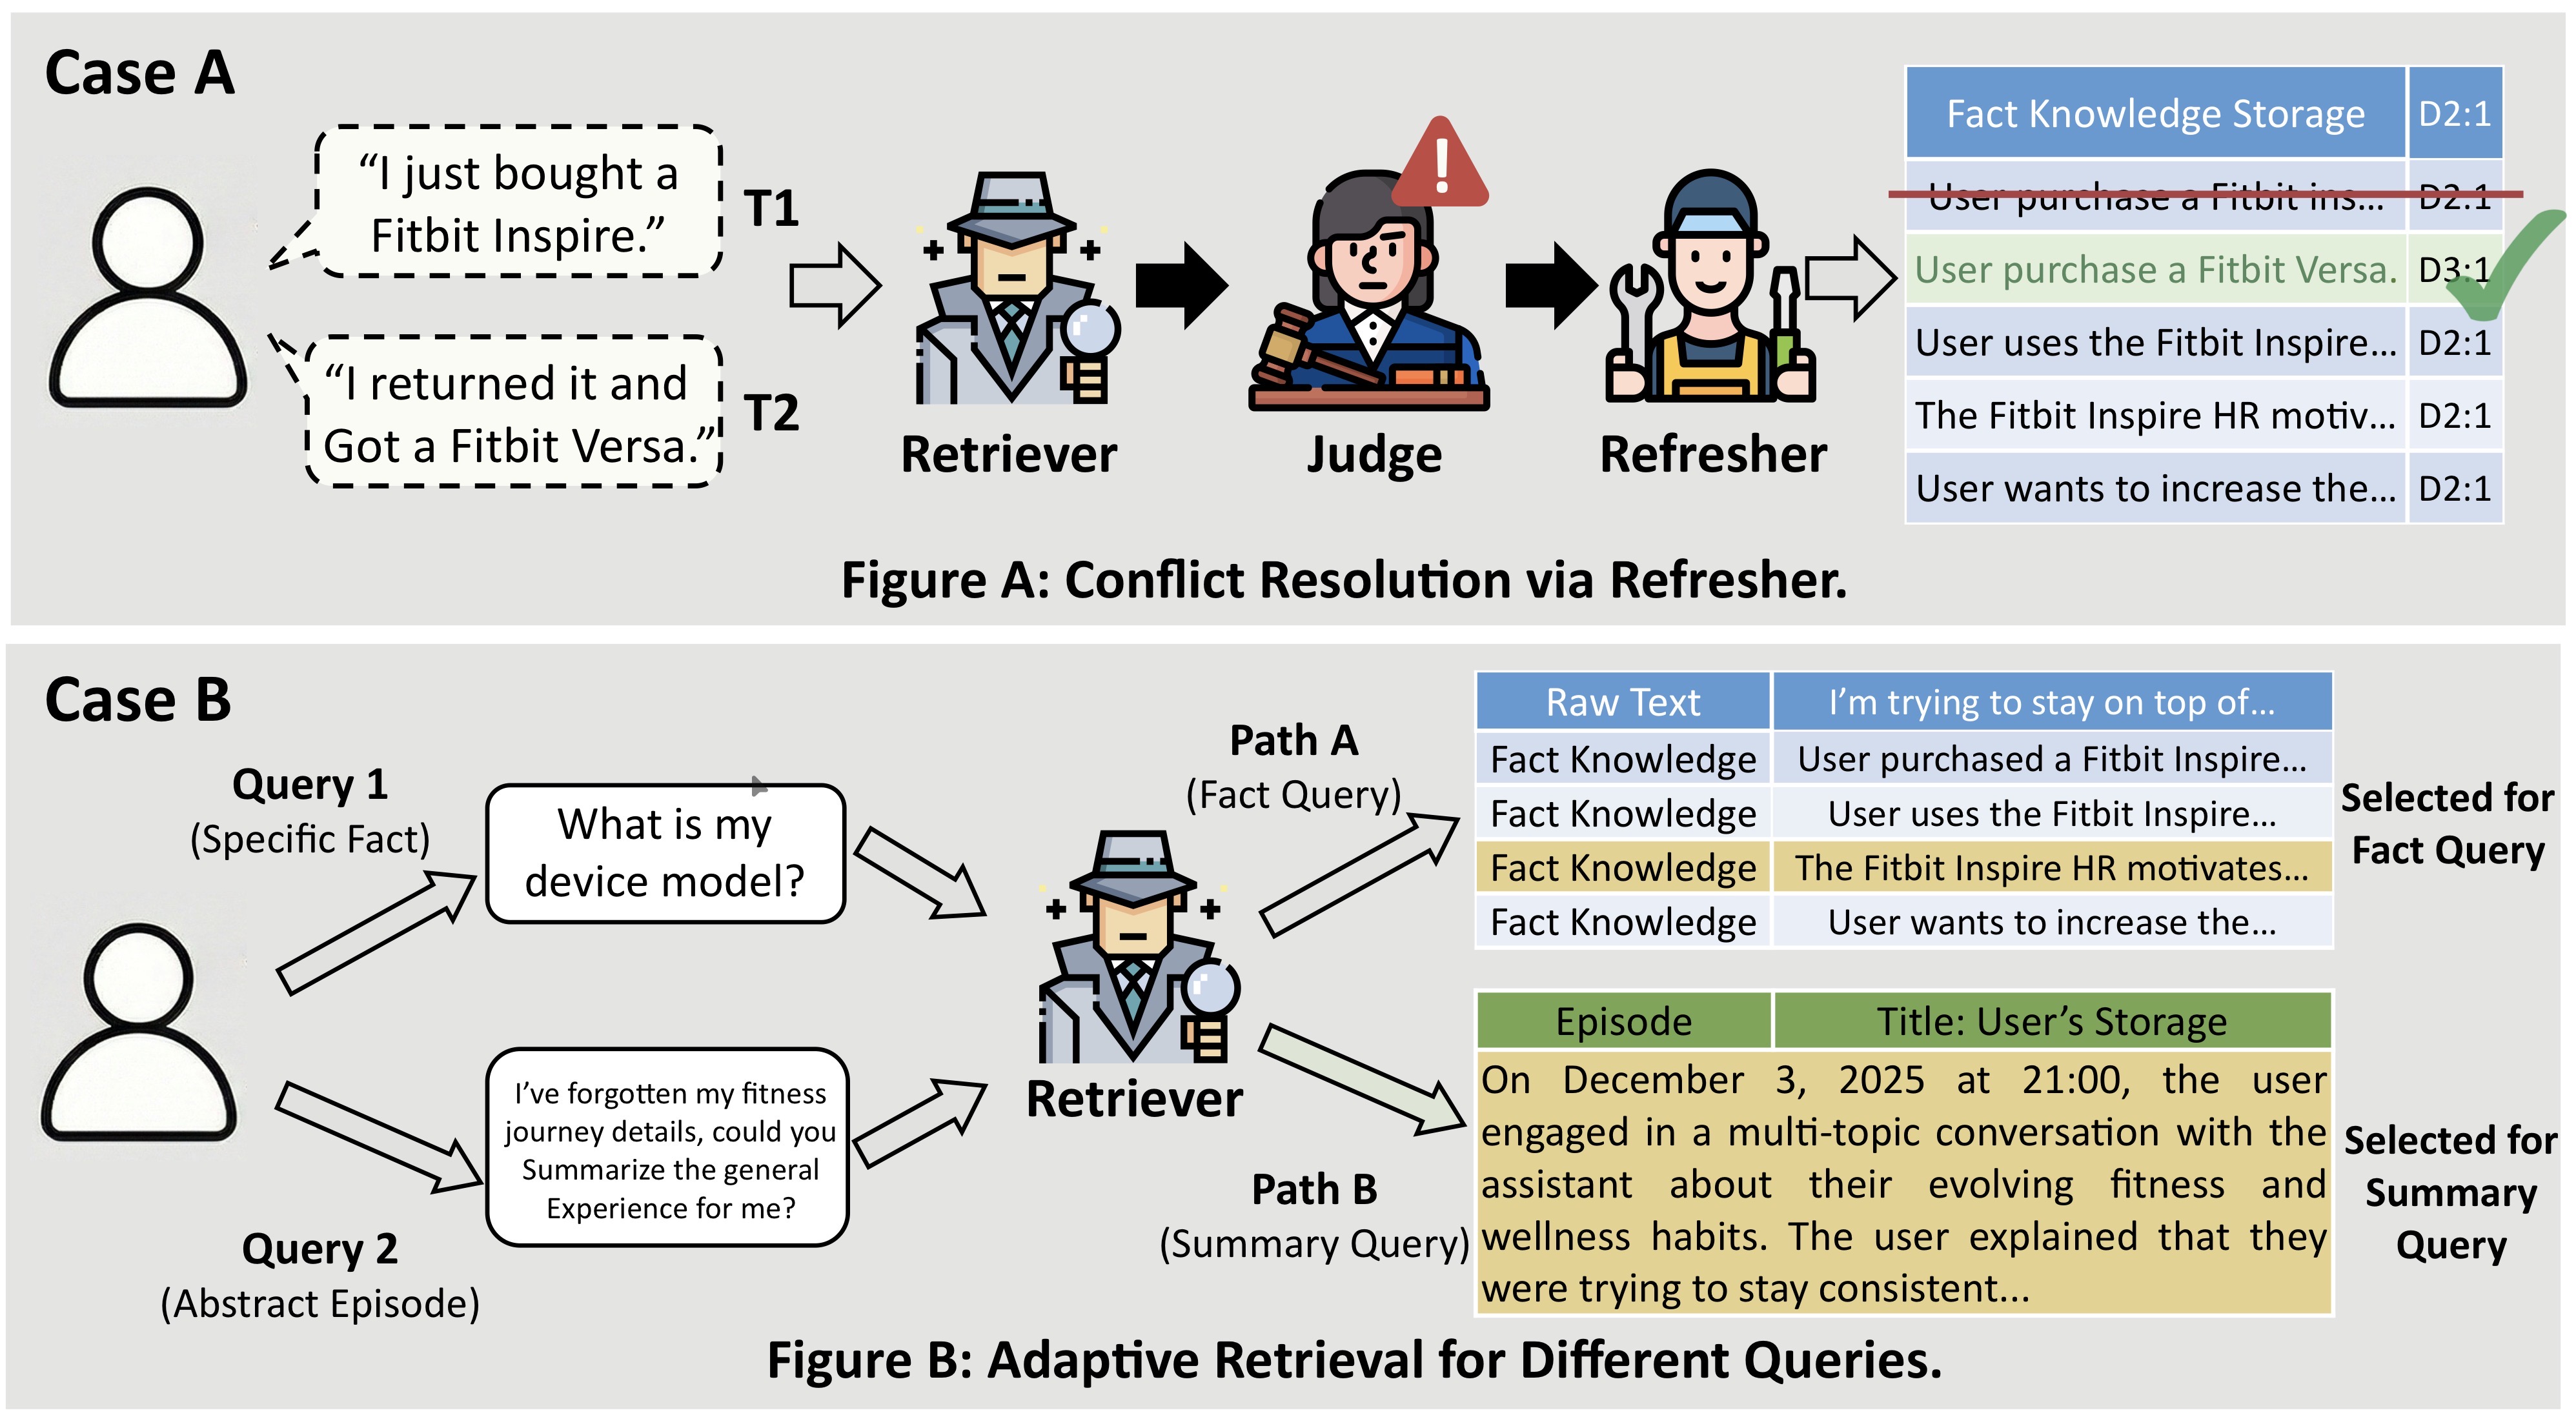
论文附录 Figure 5 给出的案例也展示了类似的两类能力:一方面通过 Judge + Refresher 处理设备信息冲突,另一方面根据事实型问题和总结型问题分别路由到 Fact Knowledge 与 Episode Memory。
九、实验设置
1. 数据集
论文使用两个长期记忆 Benchmark。
LoCoMo
LoCoMo 主要测试长对话环境中的长期记忆问答。
问题类型包括:
- Single-Hop;
- Multi-Hop;
- Temporal Reasoning;
- Open Domain。
论文报告:
- LLM Score;
- F1;
- BLEU-1。
LongMemEvals
LongMemEvals 更强调长期交互中的记忆变化和多 Session 推理。
论文重点报告 Pass@1 Accuracy,并包含:
- single-session preference;
- single-session assistant;
- temporal reasoning;
- multi-session;
- knowledge update;
- single-session user。
其中 knowledge-update 对 AMA 尤其重要,因为它直接测试:
用户状态发生变化后,Memory System 能不能维护正确的当前知识。
2. 对比方法
论文使用:
- FullContext;
- RAG;
- LangMem;
- MemGPT;
- Zep;
- A-MEM;
- Mem0;
- Nemori。
其中:
text
FullContext表示直接给模型完整历史。
text
RAG使用 2048 Token Chunk。
此外还加入多种代表性的 Agent Memory Framework。
3. Backbone
论文同时测试闭源和开源模型:
- GPT-4o-mini;
- GPT-4.1-mini;
- Qwen3-8B-Instruct;
- Qwen3-30B-Instruct。
AMA 中不同角色与最终回答生成使用相同 Backbone。
其他设置包括:
- Temperature = 0;
- RAG Top-K = 10;
- AMA 默认最大检索轮数 K r = 2 K_r=2 Kr=2;
- Embedding 使用
text-embedding-3-large。
LongMemEvals 规模约 5800 万 Token,因此论文只使用 GPT-4o-mini 对其进行完整评测。
十、主要实验结果
1. LoCoMo
论文 Table 1 给出了不同 Backbone 上的主要结果。
为了避免表格过宽,这里重点整理 Overall LLM Score。
| Backbone | FullContext | RAG | A-MEM | Mem0 | Zep | Nemori | AMA |
|---|---|---|---|---|---|---|---|
| GPT-4o-mini | 0.717 | 0.300 | 0.476 | 0.608 | 0.580 | 0.740 | 0.774 |
| GPT-4.1-mini | 0.786 | 0.321 | 0.487 | 0.647 | 0.601 | 0.774 | 0.805 |
| Qwen3-30B-Instruct | 0.733 | 0.307 | 0.476 | - | - | 0.756 | 0.791 |
| Qwen3-8B-Instruct | 0.696 | 0.298 | 0.464 | - | - | 0.686 | 0.707 |
其中,GPT-4o-mini 下:
text
Nemori:
0.740

AMA:
0.774
提升:
text
+0.034GPT-4.1-mini 下:
text
FullContext:
0.786

AMA:
0.805
也就是说,AMA 甚至超过了直接读取完整历史。
这说明:
更多上下文并不必然带来更好的长期推理。
完整历史中同样存在:
- 无关信息;
- 过期信息;
- 冲突信息。
AMA 通过抽取事实、情节和动态路由,实际上在做:
text
Raw History
     ↓
Memory Selection
     ↓
Information Filtering
     ↓
Task-Relevant Context
论文在 Qwen3-30B 和 Qwen3-8B 上也观察到 AMA 优于 FullContext,说明这种收益并不只依赖某一个闭源模型。
2. LongMemEvals
论文 Table 2 的结果如下:
| Question Type | FullContext | RAG | LangMem | A-MEM | MemGPT | Mem0 | Zep | Nemori | AMA |
|---|---|---|---|---|---|---|---|---|---|
| Single-session Preference | 0.300 | 0.333 | 0.267 | 0.367 | 0.200 | 0.333 | 0.533 | 0.467 | 0.467 |
| Single-session Assistant | 0.818 | 0.714 | 0.777 | 0.804 | 0.857 | 0.875 | 0.750 | 0.839 | 0.964 |
| Temporal Reasoning | 0.365 | 0.280 | 0.353 | 0.398 | 0.451 | 0.399 | 0.541 | 0.617 | 0.444 |
| Multi-session | 0.406 | 0.254 | 0.424 | 0.451 | 0.549 | 0.481 | 0.474 | 0.511 | 0.624 |
| Knowledge Update | 0.769 | 0.385 | 0.578 | 0.602 | 0.410 | 0.654 | 0.744 | 0.615 | 0.897 |
| Single-session User | 0.814 | 0.686 | 0.750 | 0.750 | 0.814 | 0.857 | 0.929 | 0.886 | 0.986 |
| Average | 0.548 | 0.374 | 0.528 | 0.538 | 0.554 | 0.574 | 0.632 | 0.642 | 0.698 |
AMA Average 达到:
text
0.698相比:
text
Nemori:
0.642

Zep:
0.632
分别提升:
text
+0.056
+0.066
最值得注意的是 Knowledge Update:
text
AMA:
0.897
这是论文方法设计最有针对性的结果之一。
因为这类题恰好要求:
text
发现旧状态
    ↓
识别新状态
    ↓
检测冲突
    ↓
更新 Memory
    ↓
回答当前事实
也就是直接对应:
text
Retriever
→ Judge
→ Refresher
不过 AMA 并不是所有子任务都最好。
例如 Temporal Reasoning:
text
Nemori:
0.617

Zep:
0.541

AMA:
0.444
AMA 明显落后于 Nemori 和 Zep。
这是一个很值得注意的负结果。
它说明:
多粒度 + 冲突维护并不自动等于更强的显式时间推理。
Zep 本身就专门构建时间感知知识图,因此在时间关系建模上仍然具有明显优势。
十一、消融实验
1. 三种 Memory 是否都有必要?
论文 Table 3 对三种 Memory Granularity 进行了组合消融。
其中:
- RT:Raw Text;
- FK:Fact Knowledge;
- EP:Episode;
- RF:Refresher。
核心结果如下:
| Raw | Fact | Episode | Refresher | LoCoMo LLM Score | LongMemEvals Knowledge-update | Average |
|---|---|---|---|---|---|---|
| ✓ | × | × | ✓ | 0.669 | 0.767 | 0.614 |
| × | ✓ | × | ✓ | 0.712 | 0.804 | 0.642 |
| × | × | ✓ | ✓ | 0.688 | 0.748 | 0.630 |
| ✓ | ✓ | × | ✓ | 0.752 | 0.863 | 0.686 |
| ✓ | × | ✓ | ✓ | 0.725 | 0.804 | 0.656 |
| × | ✓ | ✓ | ✓ | 0.741 | 0.842 | 0.680 |
| ✓ | ✓ | ✓ | ✓ | 0.774 | 0.897 | 0.710 |
如果只保留一种 Memory:
text
Fact Knowledge:
0.712
最好。
这很好理解。
长期对话 QA 中,大量问题其实就是:
"用户的某个具体事实是什么?"
因此 Fact Memory 的信息密度很高。
但是三种 Memory 全部开启后:
text
0.774进一步提升。
说明:
三种粒度不是互相替代,而是互补。
Raw Text 保细节;
Fact 保原子知识;
Episode 保高层事件。
这也验证了 AMA 最核心的假设:
长期记忆不应该只选择一种固定粒度。
2. Refresher 有多重要?
这一项结果非常明显。
完整系统:
text
Knowledge Update:
0.897
去掉 Refresher:
text
Knowledge Update:
0.568
下降:
text
0.329这说明一个长期 Memory System 即使:
text
存得很好
+
检索得很好
如果没有:
text
Conflict Resolution
+
Memory Update
仍然会随着历史增长逐渐失效。
我认为这是 AMA 实验中最有价值的结果之一。
因为它证明:
Memory Retrieval 和 Memory Maintenance 是两个不同的问题。
很多系统只优化 Recall:
text
"能不能找到过去的信息?"但长期 Agent 还需要:
text
"找到的信息现在还对不对?"十二、效率分析
多 Agent 最大的疑问之一是:
四个 Agent 来回调用,会不会非常贵?
论文专门报告了 Token、Latency 和 LLM Score。
| 方法 | Input Tokens | Latency | LLM Score |
|---|---|---|---|
| FullContext | 18625 | 7.206 s | 0.717 |
| RAG | 5800 | 2.983 s | 0.300 |
| Nemori | 2925 | 3.152 s | 0.740 |
| Zep | 2461 | 3.255 s | 0.580 |
| Mem0 | 1340 | 3.739 s | 0.608 |
| A-MEM | 2720 | 3.227 s | 0.476 |
| AMA ( K r = 1 K_r=1 Kr=1) | 2491 | 3.124 s | 0.723 |
| AMA ( K r = 2 K_r=2 Kr=2) | 3613 | 3.910 s | 0.774 |
FullContext:
text
18625 TokensAMA 默认:
text
3613 Tokens只相当于 FullContext 的约:
text
19%也就是减少约:
text
80%同时:
text
FullContext LLM Score:
0.717

AMA:
0.774
因此 AMA 的多 Agent 调用确实增加了控制逻辑,但它通过减少进入主模型的历史信息,降低了总 Context Token。
不过也不能因此说:
"Multi-Agent 比单 Agent 更便宜。"
准确理解应该是:
AMA 使用更多控制步骤,换取更少的上下文输入和更高的信息密度。
论文作者自己也在 Limitations 中承认,多 Agent 协作相比静态检索方法仍存在额外计算开销。
十三、检索轮数应该设置多少?
为了观察 Retry Loop 的成本,可以看论文 Figure 4。
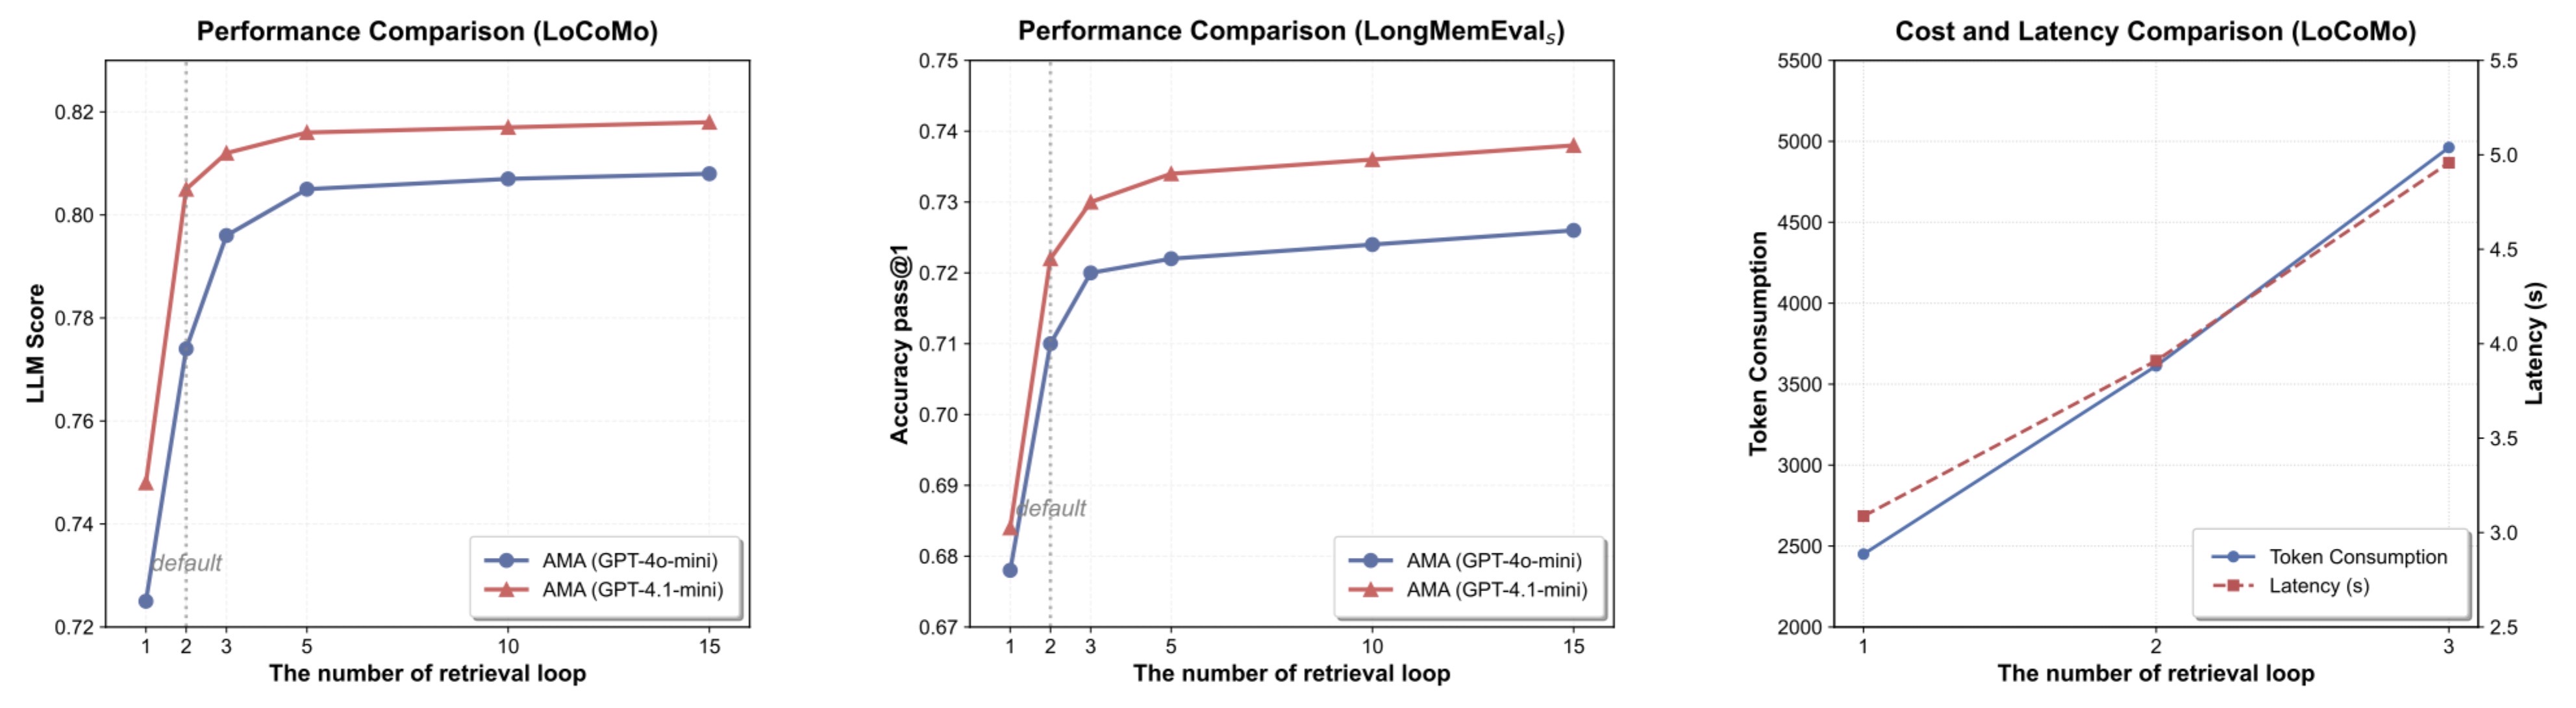
图源:论文 Figure 4。
Figure 4 展示不同最大检索轮数 K r K_r Kr 对 LoCoMo、LongMemEvals、Token 消耗和延迟的影响。随着检索轮数增加,性能继续提升,但边际收益逐渐减小,同时 Token 和延迟近似线性增长。
从:
K r = 1 K_r=1 Kr=1
增加到:
K r = 3 K_r=3 Kr=3
性能持续提升。
但继续增加后,收益逐渐减小。
论文观察到:
K r ≥ 5 K_r\ge5 Kr≥5
后性能基本趋于饱和。
而 Token 和 Latency 则随着检索轮数继续增长。
因此作者默认选择:
K r = 2 K_r=2 Kr=2
这是典型的:
text
Retrieval Quality
        ↑
        |
        |      _____
        |    /
        |  /
        |/
        +----------------→ Retrieval Rounds

Cost
        ↑
        |       /
        |     /
        |   /
        | /
        +----------------→ Retrieval Rounds
增加一次检索,在早期比较有价值;
但无限"反思---检索---再反思"并不划算。
这对 Agent 系统设计有一个很实际的启发:
反馈闭环必须设置预算。
否则 Multi-Agent 很容易退化成无休止的 Agent Loop。
十四、与已有 Agent Memory 方法的对比
| 方法 | Memory Representation | Retrieval | Memory Update | 核心贡献 |
|---|---|---|---|---|
| Mem0 | 原子事实 | 语义检索 | ADD / UPDATE / DELETE | 生产级长期记忆生命周期 |
| A-MEM | 动态 Memory Note Network | 语义 + 关联扩展 | 动态链接与内容演化 | 自进化关联记忆 |
| Zep | 时间知识图 | 搜索 + 图遍历 | 时间有效区间更新 | 时间感知长期记忆 |
| Nemori | 自组织情节结构 | 情节级检索 | 动态组织 | 语义情节记忆 |
| AMA | Raw + Fact + Episode | Intent Routing + Top-K + Retry | Judge + Refresher | 多粒度自适应检索与一致性维护 |
我认为 AMA 和 Mem0 的区别尤其值得注意。
Mem0 更像:
text
Memory Record Lifecycle核心问题:
一条事实怎么增删改?
AMA 更像:
text
Memory System Orchestration核心问题:
面对不同任务,该查什么层级?召回结果是否可靠?冲突时由谁维护?
因此,两者理论上甚至可以结合:
text
AMA
负责:
Granularity Routing
Judge
Retry
Conflict Detection

↓

Mem0-like Memory Store
负责:
事实级 CRUD
AMA 和 Zep 也并不是简单替代关系。
LongMemEvals 的 Temporal Reasoning 结果恰恰显示:
text
Zep > AMA因此,更合理的工程组合甚至可能是:
text
Raw Text
+
Fact Memory
+
Episode Memory
+
Temporal Graph
再由 Router 根据任务类型选择。
十五、局限性与未来方向
1. 方法限制
多 Agent 增加推理开销
AMA 的流程可能包含:
text
Retriever
↓
Judge
↓
Retry
↓
Retriever
↓
Judge
↓
Refresher
这显然比:
text
Embedding
↓
Top-K
更复杂。
虽然 AMA 降低了 Context Token,但增加了:
- LLM 调用次数;
- 控制延迟;
- Agent Orchestration;
- Prompt 维护成本。
论文也明确把多 Agent 带来的计算开销列为主要限制之一。
强依赖 Backbone 推理能力
Retriever 需要判断 Intent。
Judge 需要判断:
- 相关性;
- 逻辑冲突。
Refresher 需要正确更新 Memory。
这些都不是简单规则任务。
因此:
Backbone 的 Reasoning Capability 会直接影响整个 Memory System。
论文也指出,系统对基础模型能力存在依赖,在更小模型上的效率仍有优化空间。
Routing Rule 仍然比较人工
AMA 虽然叫 Adaptive Routing,但三类 Memory 的路由规则仍然是预定义的:
text
fine
→ Raw

abstract / event
→ Episode

otherwise
→ Fact
因此它更接近:
LLM Intent Classification + Rule-based Routing
而不是端到端学出的 Memory Policy。
未来可以进一步学习:
P ( M e m o r y T y p e ∣ Q u e r y , S t a t e , H i s t o r y ) P(MemoryType\mid Query,State,History) P(MemoryType∣Query,State,History)
甚至允许:
text
同时访问多个 Memory Store而不是主要选择单一路径。
2. 时间推理仍然不是强项
LongMemEvals 中:
text
Temporal Reasoning

Nemori:0.617
Zep:0.541
AMA:0.444
这是不能忽略的结果。
AMA 有:
- Timestamp;
- Metadata;
- Conflict Detection。
但这些机制主要用于:
状态更新和一致性维护。
它并没有像 Temporal Knowledge Graph 那样显式建模:
text
valid_from
valid_to
before
after
overlap
因此,未来如果要增强 Temporal Reasoning,可以考虑:
text
AMA Router
    ↓
Temporal Query
    ↓
Temporal Graph Memory
把时间推理作为第四种 Memory Granularity。
3. Memory 更新主要依赖 LLM 逻辑判断
Judge 检测冲突,本质上仍然是:
text
LLM 判断 A 和 B 是否冲突这会出现:
- 隐式冲突漏检;
- 时间关系判断错误;
- 不确定事实被错误覆盖;
- 用户推测被当成确定状态。
例如:
text
"我可能年底搬去北京。"并不等于:
text
"我现在住在北京。"未来更完善的 Refresher 需要处理:
- confidence;
- source;
- temporal validity;
- uncertainty;
- provenance。
而不是单纯:
text
Update / Delete4. 工程复杂度比较高
AMA 至少需要维护:
text
Raw Text Store
Fact Store
Episode Store
Embedding Index
Relation Index
Metadata
Conflict State
同时还有:
text
Constructor Prompt
Episode Trigger Prompt
Episode Summary Prompt
Retriever Prompt
Judge Prompt
Refresher Prompt
论文附录确实分别提供了这些 Prompt Template,说明 AMA 本质上已经接近一个完整 Memory Runtime,而不是一个简单的检索模块。
实际落地时还需要考虑:
- 并发更新;
- Memory Version;
- Agent 调用失败;
- Retry 超时;
- 不同 Memory Store 的事务一致性。
十六、我的理解和启发
1. AMA 最重要的不是 Multi-Agent,而是 Memory Responsibility Separation
第一次看到 AMA 很容易关注:
"它用了四个 Agent。"
但我认为更值得借鉴的是:
text
Memory Construction
Memory Retrieval
Memory Verification
Memory Maintenance
被分成了四种独立职责。
即使实际工程中不用四个独立 LLM,也完全可以实现成:
text
MemoryConstructor
MemoryRouter
MemoryValidator
MemoryUpdater
四个模块。
也就是说:
Multi-Agent 是论文实现职责解耦的一种方式,职责解耦才是更通用的工程思想。
2. 不应该问"Agent 应该使用哪种 Memory",而应该问"这个问题需要哪种 Memory"
以前设计 Agent Memory 时,很容易从系统角度出发:
text
我要用:
Vector Memory?
Graph Memory?
Episodic Memory?
AMA 给我的启发是:
这个问题可能本身就问错了。
更合理的方式是:
text
不同 Query
↓
需要不同 Memory Representation
例如:
事实问题
text
"用户用什么数据库?"↓
text
Structured Fact调试问题
text
"刚才那条报错原文是什么?"↓
text
Raw Trajectory历史总结
text
"这次项目目前主要做了什么?"↓
text
Episode Summary时间变化
text
"什么时候从 PostgreSQL 换成 MySQL?"↓
text
Temporal Memory因此,一个更完整的 Agent Memory Architecture 应该是:
text
Query
 ↓
Memory Router
 ↓
选择最适合当前推理的信息表示
3. Judge 这一层非常值得加入实际 Agent
很多工程 Memory Pipeline 是:
text
Query
 ↓
Vector Search
 ↓
Top-K
 ↓
Prompt
我觉得可以直接借鉴 AMA 改成:
text
Query
 ↓
Candidate Retrieval
 ↓
Memory Validator
 ↓
Relevant Evidence
 ↓
Prompt
Validator 不一定需要大模型。
可以组合:
text
Embedding Score
+
Reranker
+
Rule
+
LLM Judge
判断:
- 是否真的相关;
- 是否过期;
- 是否冲突;
- 是否已经足够。
这可以明显减少:
"检索出来了,所以一定塞进上下文"
这种简单做法。
4. Memory Retrieval 应该允许失败
AMA 中一个很好的设计是:
text
Judge
 ↓
结果不好
 ↓
Retry
传统 RAG 经常默认:
text
Top-K = Answer Evidence但实际上 Retrieval 只是一次猜测。
更合理的是:
text
Search
 ↓
Evaluate
 ↓
Not Enough
 ↓
Re-search
这其实和 Agentic RAG 非常接近。
区别在于:
AMA 把这种 Agentic Retrieval 放到了 Memory System 内部。
5. Retry 一定要有预算
另一方面,Figure 4 也说明:
text
更多 Retrieval Loop
≠
无限提升
所以实际系统应该设置:
text
max_retrieval_rounds
token_budget
latency_budget
例如:
text
Round 1:
Fact Memory

↓

Judge:不足

↓

Round 2:
Episode / Raw 扩展

↓

仍不足

↓

停止检索
而不是:
text
Agent 一直觉得证据不够
→ 无限循环
这一点对于多 Agent 系统尤其重要。
6. 长期记忆必须有"读路径"和"写路径"
我觉得 AMA 还体现了一个很清楚的设计:
Read Path
text
Query
↓
Retriever
↓
Judge
↓
Validated Memory
↓
Reasoning
Write Path
text
New Interaction
↓
Judge
↓
Refresher
↓
Constructor
↓
Memory Store
很多 Memory 系统只重点优化:
text
Read Path也就是:
怎么召回得更准。
但长期运行真正困难的往往是:
text
Write Path也就是:
- 新信息该不该写?
- 旧信息是否冲突?
- 冲突怎么改?
- 哪条需要删除?
- 是否需要形成更高层 Episode?
这也是为什么 Refresher 的消融会在 Knowledge Update 上产生如此大的差异。
7. 可以如何用到自己的 Agent Framework 中
如果让我把 AMA 的思想加入自己的 Agent,我不会直接部署四个完全独立的大模型 Agent。
我更倾向:
text
                 Memory Service
                       |
       ---------------------------------
       |               |               |
  Raw Archive      Fact Store      Episode Store
       |               |               |
       ---------------------------------
                       |
                 Memory Router
                       |
                 Hybrid Retrieval
                       |
                 Memory Judge
                  /          \
               Retry        Conflict
                              |
                         Memory Updater
其中:
Raw Archive
保存:
- 原始用户消息;
- Tool Result;
- 完整错误日志;
- 文件修改记录。
Fact Store
保存:
- 用户稳定偏好;
- 项目配置;
- 环境信息;
- 长期约束。
Episode Store
保存:
- 一个任务阶段做了什么;
- 关键决策;
- 结果;
- 未解决问题。
然后使用一个轻量 Router:
text
detail
fact
episode
temporal
进行路由。
检索完成后再做一次 Validation:
text
Relevant?
Current?
Consistent?
Enough?
这比简单:
text
Vector DB Top-K更接近真正长期运行的 Agent Memory System。
十七、总结
AMA 研究的是长期 Agent Memory 中两个经常被分开处理的问题:
不同问题需要不同粒度的记忆。
以及:
长期记忆必须随着用户状态变化持续保持逻辑一致。
为此,AMA 同时设计了三种 Memory:
text
Raw Text Memory
↓
保留原始细节

Fact Knowledge Memory
↓
保存原子事实

Episode Memory
↓
保存跨轮次高层语义
并通过四个协作 Agent 管理整个生命周期:
text
Constructor
↓
构建多粒度 Memory

Retriever
↓
根据 Query Intent 选择粒度

Judge
↓
判断相关性和逻辑冲突

Refresher
↓
精确更新或删除过期 Memory
它真正形成的是这样一个闭环:
text
Memory Construction
        ↓
Adaptive Retrieval
        ↓
Memory Verification
        ↓
Conflict Resolution
        ↓
Memory Evolution
        └──────────────→
实验中,AMA 在 LoCoMo 上使用 GPT-4o-mini 时达到 0.774 的 Overall LLM Score,高于 Nemori 的 0.740;在 GPT-4.1-mini 上达到 0.805,并超过 FullContext 的 0.786。LongMemEvals 上,AMA 平均准确率达到 0.698,其中 Knowledge Update 达到 0.897。
消融实验进一步说明:
多粒度记忆和 Refresher 都不是可有可无的组件。
三种粒度共同使用时效果最好;去掉 Refresher 后,Knowledge Update 从 0.897 大幅下降到 0.568。
与此同时,AMA 也并不是所有长期记忆问题的最优解。
它在 Temporal Reasoning 上落后于 Nemori 和 Zep,多 Agent 协作还带来了额外推理开销,而且 Router 和 Update 仍高度依赖 LLM 的判断能力。
我认为这篇论文最值得借鉴的地方,不是简单地:
"Memory System 也可以用 Multi-Agent。"
而是:
长期记忆不应该只有一个固定表示,也不应该把检索结果直接视为可信上下文。
一个更加成熟的 Agent Memory System 应该能够:
text
根据问题选择记忆粒度
        ↓
检索候选信息
        ↓
验证相关性
        ↓
发现冲突
        ↓
更新长期状态
        ↓
继续形成新的记忆
从这个角度看,AMA 已经不只是一个 Memory Retrieval 方法,而更像一个:
面向长期 Agent 的记忆编排层(Memory Orchestration Layer)。
这也是我认为它相较于很多"新的 Memory Representation"方法更有意思的地方。
参考资料
- Weiquan Huang, Zixuan Wang, Hehai Lin, et al. AMA: Adaptive Memory via Multi-Agent Collaboration. Findings of ACL 2026.