Scrapy + Playwright 完整示例(JS 动态渲染网页)

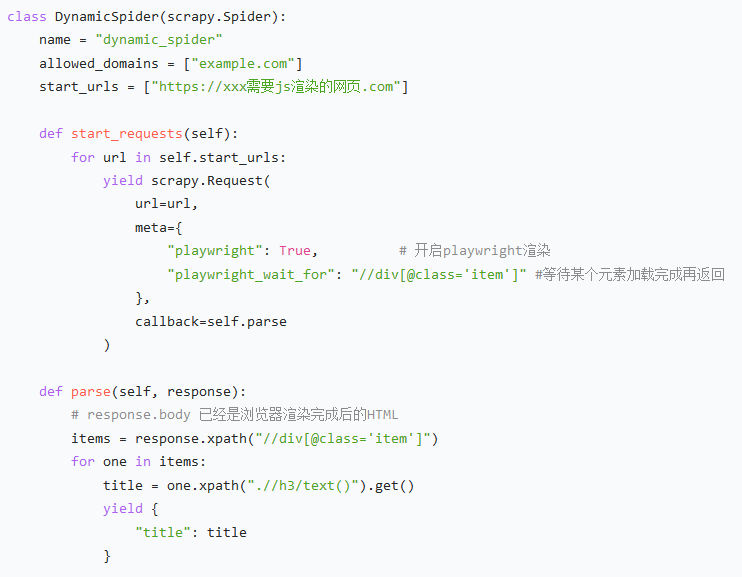
作用:Scrapy 本身不执行 JS,Playwright 启动真实浏览器渲染页面,获取 ajax 动态加载出来的数据。

  1. 安装依赖

pip install scrapy scrapy-playwright

安装浏览器内核

playwright install chromium

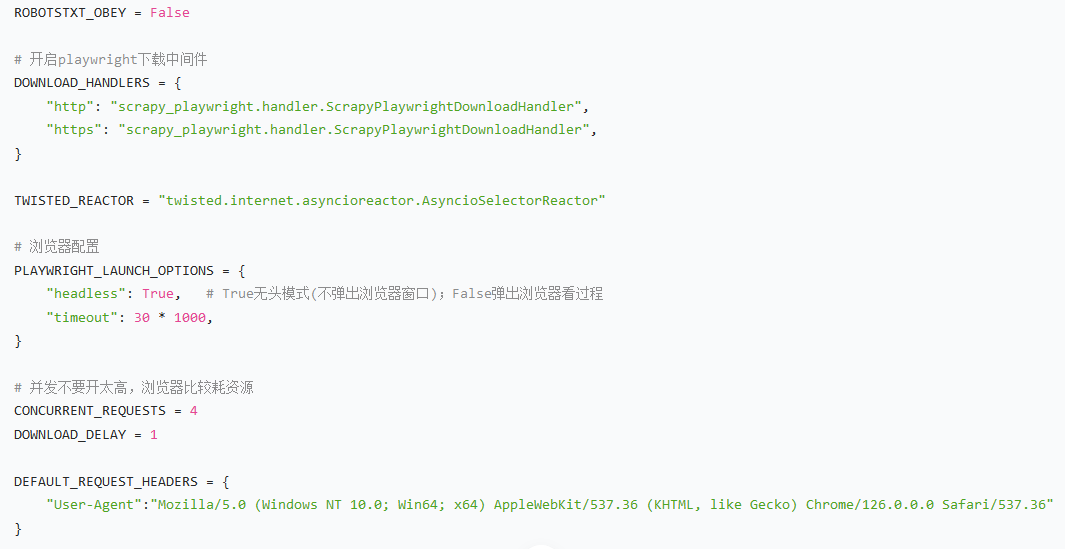
  1. 修改 settings.py 关键配置
  1. 编写爬虫 spiders/dynamic_spider.py
  1. 运行爬虫

scrapy crawl dynamic_spider -o out.json

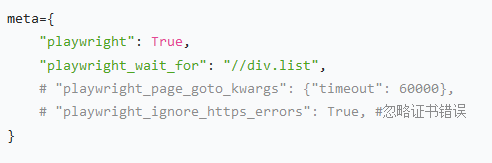
常用 meta 参数拓展
重要注意点

Playwright 会启动 Chromium 浏览器,内存占用高,并发不要设置很大。

headless=False 可以看到浏览器真实访问页面,适合调试。

如果页面滚动加载,需要自定义 playwright 页面回调,模拟下拉滚动。

相关推荐
Wang's Blog4 分钟前
Java 项目实战: 交友项目 - 安装开发工具与环境准备
java·开发语言·交友
kyriewen5 分钟前
我上手了 Vite+ 1.0:Node 不用自己装,lint 却翻车了
前端·javascript·程序员
启观川1 小时前
数据结构与算法-第 3 章 常用算法-贪心算法
数据结构·笔记·python·算法·贪心算法
南笙北梦1 小时前
本地开源大模型多轮对话显存泄漏排查与修复实录
python
小羊没烦恼!1 小时前
如何在IIS6,7中部署ASP.NET网站?
数据库·后端·python·web安全·asp.net
鹏多多1 小时前
前端是如何死去的?| 完整时间线
前端·javascript·程序员
古夕2 小时前
iframe 授权失败时露出 60000 JSON 的复盘
前端·javascript
钱栈up2 小时前
扫完 3.5 万文件后,我发现了 521 组散落的同名文件
爬虫·python·数据分析
黄权光2 小时前
AI智能体项目实战记录(01):开发环境搭建之conda的安装与配置
python
Wokoo72 小时前
Selenium 核心 API 解析(三)
python·功能测试·selenium