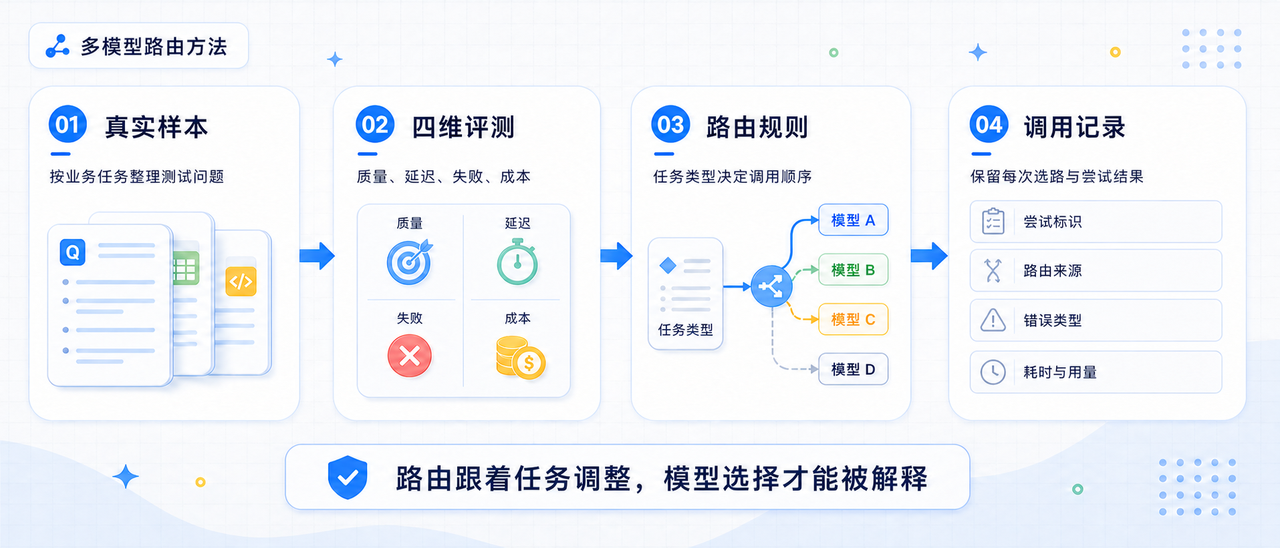
多模型接入解决了可选模型不足的问题,也带来了回答质量、响应速度和调用成本的波动。稳定路由需要一组真实任务样本,把质量、延迟、失败和成本分开记录,再按任务类型制定规则。仅凭模型榜单或一次体验,很难支撑线上选择。
ZGI 的模型网关(Model Gateway)把授权、选路、调用和计量放进同一条请求链路,流式与非流式调用都带有路由和尝试级标识。企业可以据此观察一次请求选中了哪条 Provider 路由、是否发生后续尝试,以及每次调用产生了多少用量,再结合业务样本调整策略。
同一个问题为何得到不同结果
模型差异只占一部分。系统提示词、知识片段、工具返回值、采样参数和上下文长度都会影响答案。直接拿两个聊天窗口比较,很容易把输入差异误判成模型差异。正式评测前,需要固定任务材料、提示配置和判分方法。
任务类型也不能混在一起统计。合同字段抽取关注遗漏和格式;客服回复关注规则一致与表达;代码修复还要检查测试能否通过。如果全部压成一个平均分,路由规则会失去业务含义。
| 评测维度 | 记录内容 | 常见误区 |
|---|---|---|
| 质量 | 正确项、遗漏项、格式要求 | 只凭读起来顺不顺 |
| 延迟 | 首字时间、完整响应时间 | 只记录单次最快结果 |
| 失败 | 超时、限流、服务错误 | 把失败请求直接删掉 |
| 成本 | 输入输出用量、调用次数 | 只比较模型标价 |
先建立任务样本,再配置路由
样本应来自准备上线的真实任务,并覆盖常见输入、边界输入和失败输入。每条样本保留期望结果或人工判分标准。数量不必一开始就很大,二十到五十条经过整理的问题,通常比几百条来源混乱的提问更适合做首轮路由判断。
评测时保持变量可控。同一批样本使用相同知识材料和工具结果,分别调用候选模型;每个模型重复运行若干次,记录输出波动。结构化任务可以检查字段准确与格式合法,开放回答则需要人工评分规则,避免"语言更流畅"遮住事实错误。
拿到结果后,再按任务分组。高频、规则明确的任务可以优先考虑速度和成本;需要复杂推理的任务提高质量权重;涉及关键业务结果的调用增加校验或人工确认。路由规则跟着任务走,模型名称只负责承接具体条件。
故障切换也要留下完整记录
当某条 Provider 路由失败,ZGI 的模型网关可以继续尝试后续选路,单次请求最多选择三条 Provider 路由。这个机制能处理部分服务故障,但不能推出固定的可用率。上游同时异常、配额耗尽、授权不通过或输入本身有问题时,请求仍可能失败。
因此,故障切换需要和记录配套。团队至少要保留任务类型、模型、Provider、尝试序号、错误类型、耗时和用量。用户只看到一次回答,运营人员却能从尝试记录中分清:调用是否走了备用路由,慢在模型还是网络,成本增加来自长上下文还是多次尝试。
路由规则需要持续校准
模型版本、价格和业务输入都会变化,一次评测不能长期沿用。更稳妥的做法是保留一组固定回归样本,每次调整模型、提示词、知识或工具后重新运行;线上再抽取脱敏样本,检查离线结果能否覆盖真实分布。
开始时可以只做三条规则:任务按类型分组;每组明确首选路由和失败处理;所有尝试进入同一份记录。运行一段时间后,再根据质量、延迟、失败和成本调整权重。多模型接入的价值,最终要落到每类任务可解释、可复查的选择上。
GitHub:https://github.com/zgiai/zgi