📖标题:AVA-Encoder: Towards Agent-Native Video Representation Learning
🌐来源:arXiv, 2608.12313v1
🛎️文章简介
🔸研究问题:如何构建一种既忠实于电影内容,又能被智能体直接理解、推理和编辑的结构化视频表示,以解决创意智能体难以从高质量人类电影中学习的问题?
🔸主要贡献:论文提出了AVA-Encoder框架,通过智能体自编码范式学习智能体原生的视频知识图谱表示,显著提升了视频重建 fidelity 和下游生成质量。
📝重点思路
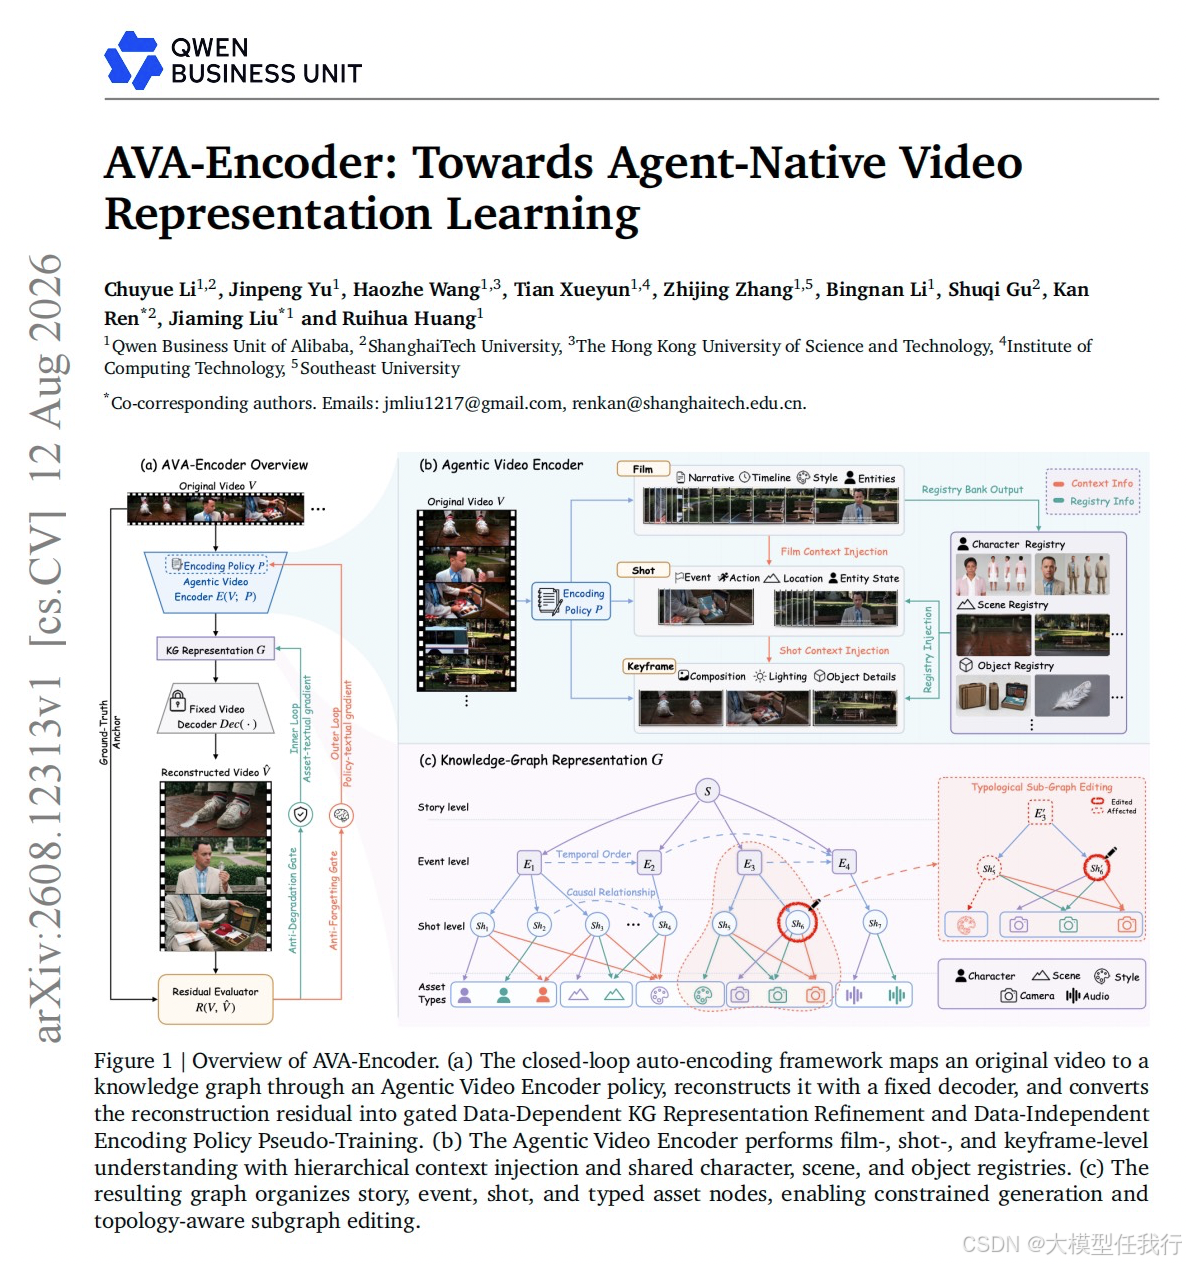
🔸提出智能体视频自编码器(AVA-Encoder)范式,将视频编码为以文本为中心的知识图谱(KG),包含故事-事件-镜头层级及关联资产层,再通过固定解码器重建视频,以重建误差作为优化信号。
🔸设计多层级智能体视频编码器,按电影、镜头、关键帧三级由粗到细进行理解,并通过上下文注入和注册表机制保持全局一致性与局部细节,减少信息损失。
🔸引入双循环文本梯度进化机制:外循环进行数据独立的编码策略伪训练,优化共享的镜头级编码策略;内循环进行数据依赖的KG表示细化,在测试时针对特定输入优化图谱表示。
🔸建立基于重建忠实度的评估基准,利用视觉语言模型生成原子事实问答作为优化奖励,并设计防退化与防遗忘门控机制,确保优化过程的稳定性与泛化能力。
🔎分析总结
🔸实验显示AVA-Encoder在整体重建准确率上达到49.0%,比最强外部基线高出20.7个百分点,在视频、关键帧及回溯描述等四个维度均表现优异。
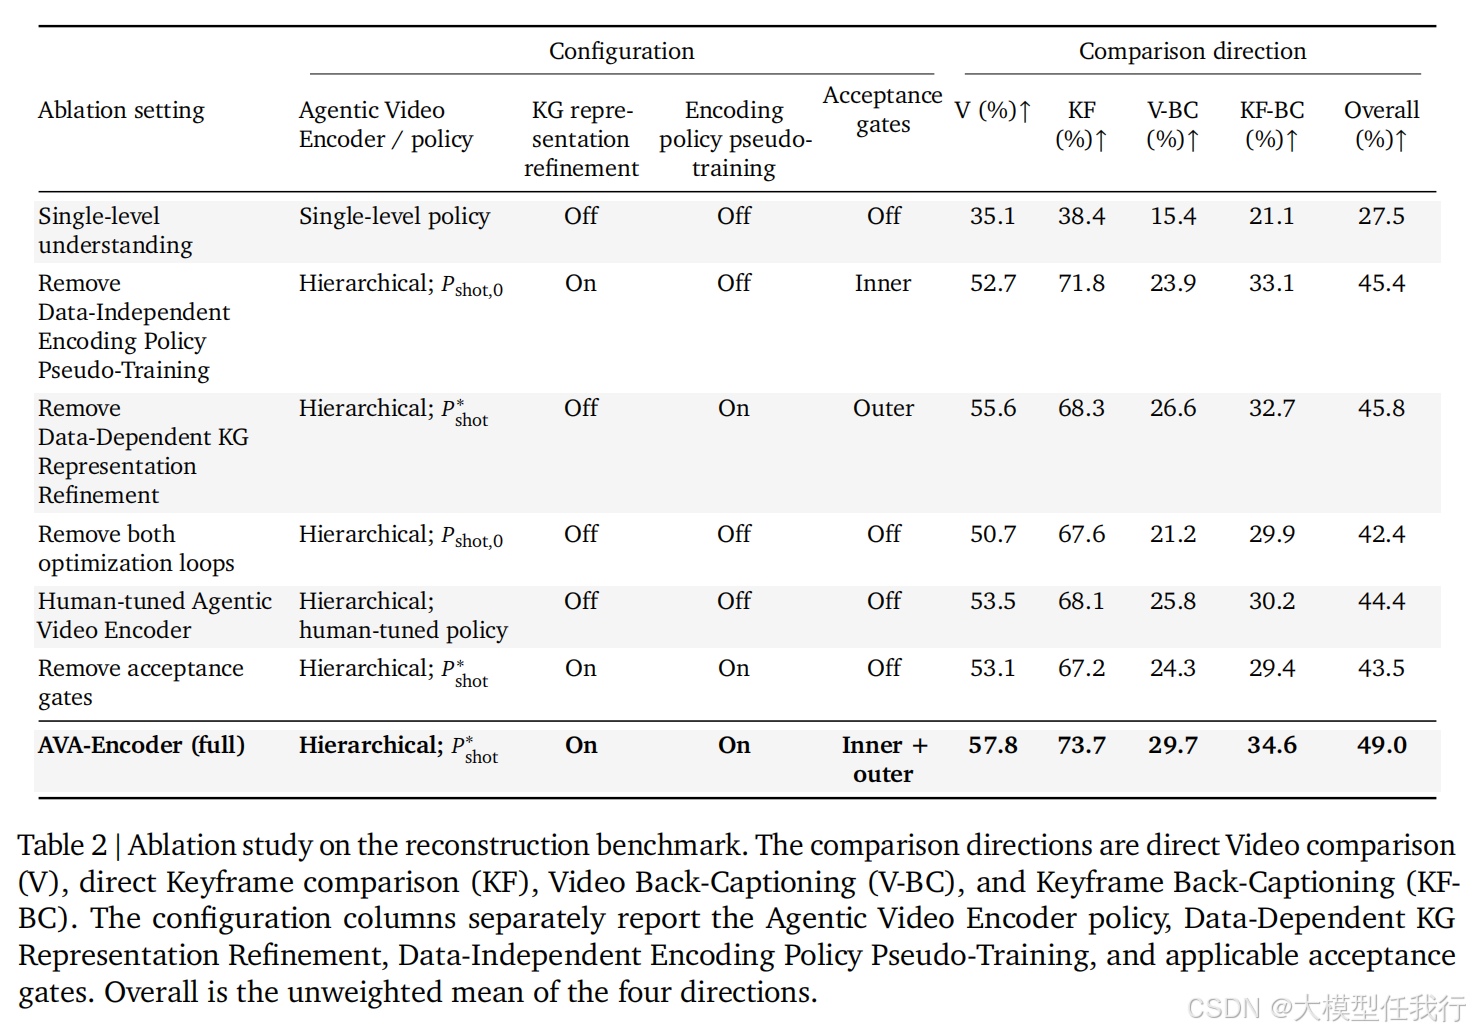
🔸消融实验证明,经过伪训练的共享编码策略优于人工调优策略,且系统提示词令牌减少74.3%;双循环结合使用比单独使用任一循环带来额外6.6个百分点的性能提升。
🔸知识图谱支持可控的链接编辑,修改特定节点(如角色身份或视觉风格)能自动传播至相关镜头并保持语义一致性,验证了表示的可操作性。
🔸该表示方法能有效提升下游多个创意智能体视频生成框架的故事视频质量,证明了其作为通用中间表示的复用价值。
💡个人观点
论文将"重建忠实度"作为智能体表示学习的核心目标,通过引入文本梯度和双循环优化,解决了非结构化视频向结构化图谱映射中的信息丢失难题。