这里写目录标题
- 一、为什么要写自定义插件
- [二、为什么需要 Plugin 和 PluginCreator 两个类](#二、为什么需要 Plugin 和 PluginCreator 两个类)
- 三、本案例的算子与网络
- [四、Python 端:导出含自定义 op 的 ONNX 模型](#四、Python 端:导出含自定义 op 的 ONNX 模型)
- [五、C++ 端:头文件------两个类的声明](#五、C++ 端:头文件——两个类的声明)
- [六、C++ 端:Plugin 类的实现](#六、C++ 端:Plugin 类的实现)
- [七、C++ 端:PluginCreator 类的实现(cpp 后半)](#七、C++ 端:PluginCreator 类的实现(cpp 后半))
- [八、CUDA 核函数](#八、CUDA 核函数)
- [九、C++ main函数,工程构建与验证](#九、C++ main函数,工程构建与验证)
- 十、参数的传递过程
- 十一、总结
前面一篇文章 优雅地解决 onnx 算子不兼容 ------ 算子注册:解决了 "导出阶段" 的问题 ------ 当模型里用到 TensorRT 不认识的算子时,用 register_custom_op_symbolic 配合 g.op("custom::xxx"),把自定义算子导出成 ONNX 的自定义节点,相当于给 "翻译官的词典" 补了一条新词条。
但上一篇结尾我特别强调过:这其实只是 "上半场"。导出的那个 custom::xxx 节点只是个 "空壳"------onnxruntime 跑不了,TensorRT 也跑不了,因为 TensorRT 根本不知道这个节点该怎么算。
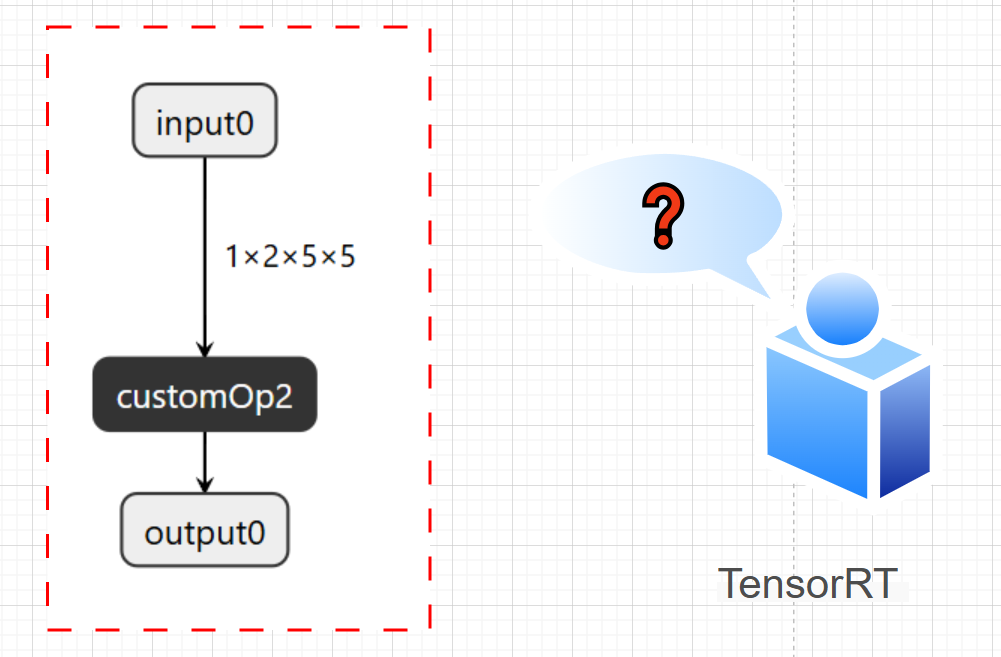
本篇就是那个 "下半场":写一个 TensorRT Plugin,把这个空壳真正填实,让 TensorRT 认识它、并教会它在 GPU 上执行。我会用一个最简单的自定义激活算子 customScaledTanh(out = k·tanh(a·x))走完整流程 ------"Python 端导出 → C++ 端实现插件 → CUDA 编写核函数 → 构建与推理验证",并重点讲清楚一个核心问题:为什么一个自定义算子需要同时写 "插件类(Plugin) " 和 "插件工厂类(PluginCreator) " 两个类。
上下两篇合起来,就是 "算子不认识时到底该怎么办" 的完整闭环:上半场(算子注册)负责把不认识的算子带进 ONNX,下半场(TensorRT 插件)负责让 TensorRT 真正执行它。
一、为什么要写自定义插件
TensorRT 内置了一大批标准算子(卷积、激活、池化、归一化......),ONNX Parser 在解析模型时,能自动把"标准 ONNX 算子"翻译成对应的 TensorRT 层。
但是,真实模型里经常会出现 TensorRT 不认识的算子,例如:
- 某种自定义激活函数 (例如本文的
k·tanh(a·x),它不是 ReLU / Sigmoid / GELU 中的任何一个); - 某个融合算子(把多个运算合在一起、减少 Kernel 启动次数);
- 某个私有网络结构(ONNX 里根本没有对应定义)。
遇到这种情况,ONNX Parser 会直接报错:找不到这个 op。解决办法就是写一个"自定义插件(Plugin)",教会 TensorRT 认识并执行这个算子。
一个自定义插件的工作可以拆成两件事:
- 告诉 TensorRT 这个算子"是什么"(叫什么名字、输入输出几个、什么格式、输出形状怎么算);
- 告诉 TensorRT 这个算子"怎么算" (实际执行的 CUDA 核函数)。
正是为了把这两件事解耦,TensorRT 的插件体系才拆成了两个类。
二、为什么需要 Plugin 和 PluginCreator 两个类
这是理解整套插件机制最关键的一环,先记住一个类比:
Plugin(插件类)是"工人",PluginCreator(插件工厂类)是"招工处"。
招工处(Creator)负责"按需求招人、发工牌";工人(Plugin)负责"到岗干活"。
具体到 TensorRT:
-
PluginCreator(继承
IPluginCreator)------工厂类- 它是 TensorRT 唯一直接打交道 的入口。ONNX Parser 解析到自定义 op 时,会拿 op 的名字去全局注册表(
IPluginRegistry)里按名字找到对应的 Creator。 - Creator 负责创建插件实例 :
createPlugin()在 build/parse 阶段创建;deserializePlugin()在加载序列化引擎时创建。 - Creator 还负责声明这个算子需要哪些参数 (
PluginField),并在创建时把参数传给 Plugin。 - 正因为 TensorRT 只认 Creator,所以注册宏注册的也是 Creator,不是 Plugin。
- 它是 TensorRT 唯一直接打交道 的入口。ONNX Parser 解析到自定义 op 时,会拿 op 的名字去全局注册表(
-
Plugin(继承
IPluginV2DynamicExt)------插件类- 它是"具体干活的"那个:
enqueue()里真正调用 CUDA 核函数完成计算。 - 它还向 TensorRT 汇报元信息 :输出几个(
getNbOutputs)、输出形状(getOutputDimensions)、支持的数据格式(supportsFormatCombination)、序列化占用多大(getSerializationSize/serialize)。
- 它是"具体干活的"那个:
为什么要拆成两个类? 本质是工厂模式(Factory Pattern)带来的解耦:
- TensorRT(builder / parser)只需要认识 Creator,通过统一接口"要一个插件实例",完全不需要知道 Plugin 内部怎么实现、有多少私有成员。
- 同一类算子可以有多个不同参数的实例(不同 k、不同 a),但只有一个 Creator。Creator 负责根据参数把不同的 Plugin 实例"造出来"。
- 序列化 / 反序列化也由 Creator 统一接管:build 完成后把 Plugin 序列化成字节流存进引擎文件;加载引擎时再由 Creator 的反序列化构造把 Plugin"重建"出来。
一句话:Creator 管"创建与注册",Plugin 管"执行与元信息"。 缺了 Plugin,没人干活;缺了 Creator,TensorRT 找不到这个算子、也造不出实例。
下面用一个完整的例子把它们串起来。
三、本案例的算子与网络
算子定义(逐元素操作,单输入单输出):
o u t p u t = k ⋅ t a n h ( a ⋅ i n p u t ) output = k · tanh(a · input) output=k⋅tanh(a⋅input)
网络结构:
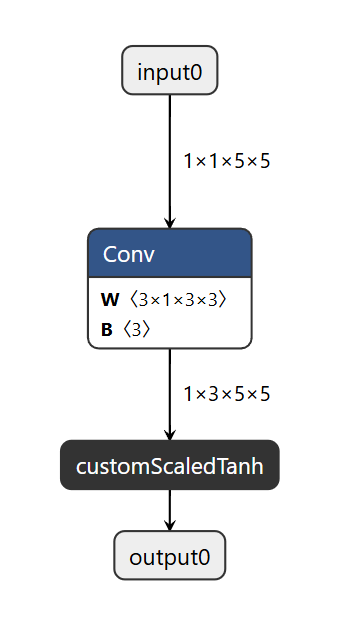
卷积负责把单通道升到 3 通道,自定义激活算子逐元素地作用在每一个元素上。因为 customScaledTanh 是逐元素操作,输出形状和输入完全相同 (都是 [1,3,5,5]),这也是后面 getOutputDimensions 直接返回输入形状的原因。
四、Python 端:导出含自定义 op 的 ONNX 模型
在 PyTorch 里,要让一个自定义计算在导出 ONNX 时成为一个"自定义 op 节点",需要自定义并继承torch.autograd.Function 类,并重写的 symbolic 方法,完成局部算子的封装,再自定义一个CustomScaledTanhImpl类,继承最经典的nn.Module,完成局部网络模块的搭建。
python
import torch
import torch.onnx
import torch.nn as nn
import onnx
import onnxsim
import os

class CustomScaledTanhImpl(torch.autograd.Function):
    @staticmethod
    def symbolic(g, x, k, a):
        # 关键:导出一个自定义 op,domain=custom,名字=customScaledTanh
        return g.op("custom::customScaledTanh", x, k_f=k, a_f=a)

    @staticmethod
    def forward(ctx, x, k, a):
        return k * torch.tanh(a * x)

class CustomScaledTanh(nn.Module):
    def __init__(self, k, a):
        super().__init__()
        self.k = k
        self.a = a

    def forward(self, x):
return CustomScaledTanhImpl.apply(x, self.k, self.a)再自定义一个Model类,完成整个神经网络的搭建。
python
class Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv = nn.Conv2d(1, 3, (3, 3), padding=1)
        self.act  = CustomScaledTanh(2, 1.5)

        for m in self.modules():
            if isinstance(m, nn.Conv2d):
                nn.init.kaiming_normal_(m.weight, mode='fan_out', nonlinearity='relu')

    def forward(self, x):
        x = self.conv(x)
        x = self.act(x)
        return x
def export_norm_onnx(input, model):
    file = "./sample_customScaledTanh.onnx"
    torch.onnx.export(
        model=model,
        args=(input,),
        f=file,
        input_names=["input0"],
        output_names=["output0"],
        opset_version=11)
    # 用 onnx-simplifier 简化
    model_onnx = onnx.load(file)
    model_onnx, check = onnxsim.simplify(model_onnx)
    assert check
    onnx.save(model_onnx, file)
    print("onnx exported & simplified")


if __name__ == "__main__":
    setup_seed(1)
    torch.set_printoptions(precision=4, sci_mode=False)
    input = torch.tensor([[[
        [0.7576, 0.2793, 0.4031, 0.7347, 0.0293],
        [0.7999, 0.3971, 0.7544, 0.5695, 0.4388],
        [0.6387, 0.5247, 0.6826, 0.3051, 0.4635],
        [0.4550, 0.5725, 0.4980, 0.9371, 0.6556],
        [0.3138, 0.1980, 0.4162, 0.2843, 0.3398]]]])

    model = Model()
    model.eval()

    # 计算
    eval(input, model)

    # 导出onnx
export_norm_onnx(input, model);CustomScaledTanhImpl.symbolic里的g.op("custom::customScaledTanh", x, k_f=k, a_f=a)就是告诉 ONNX 导出器 :把这个算子导出成一个自定义节点,它的domain是custom,op_type是customScaledTanh,两个标量参数k、a作为节点属性(attribute)保存。- **
custom::customScaledTanh就是后面 TensorRT 查找插件 Creator 的"钥匙"。** 后面 C++ 端 Creator 的getPluginName()必须返回customScaledTanh、domain 必须匹配custom,TRT 才能在解析 ONNX 时对上号。 - 导出后可以用
onnx打印一下节点,会看到一个op_type=customScaledTanh、domain=custom的节点,这正是插件机制要解析的对象。
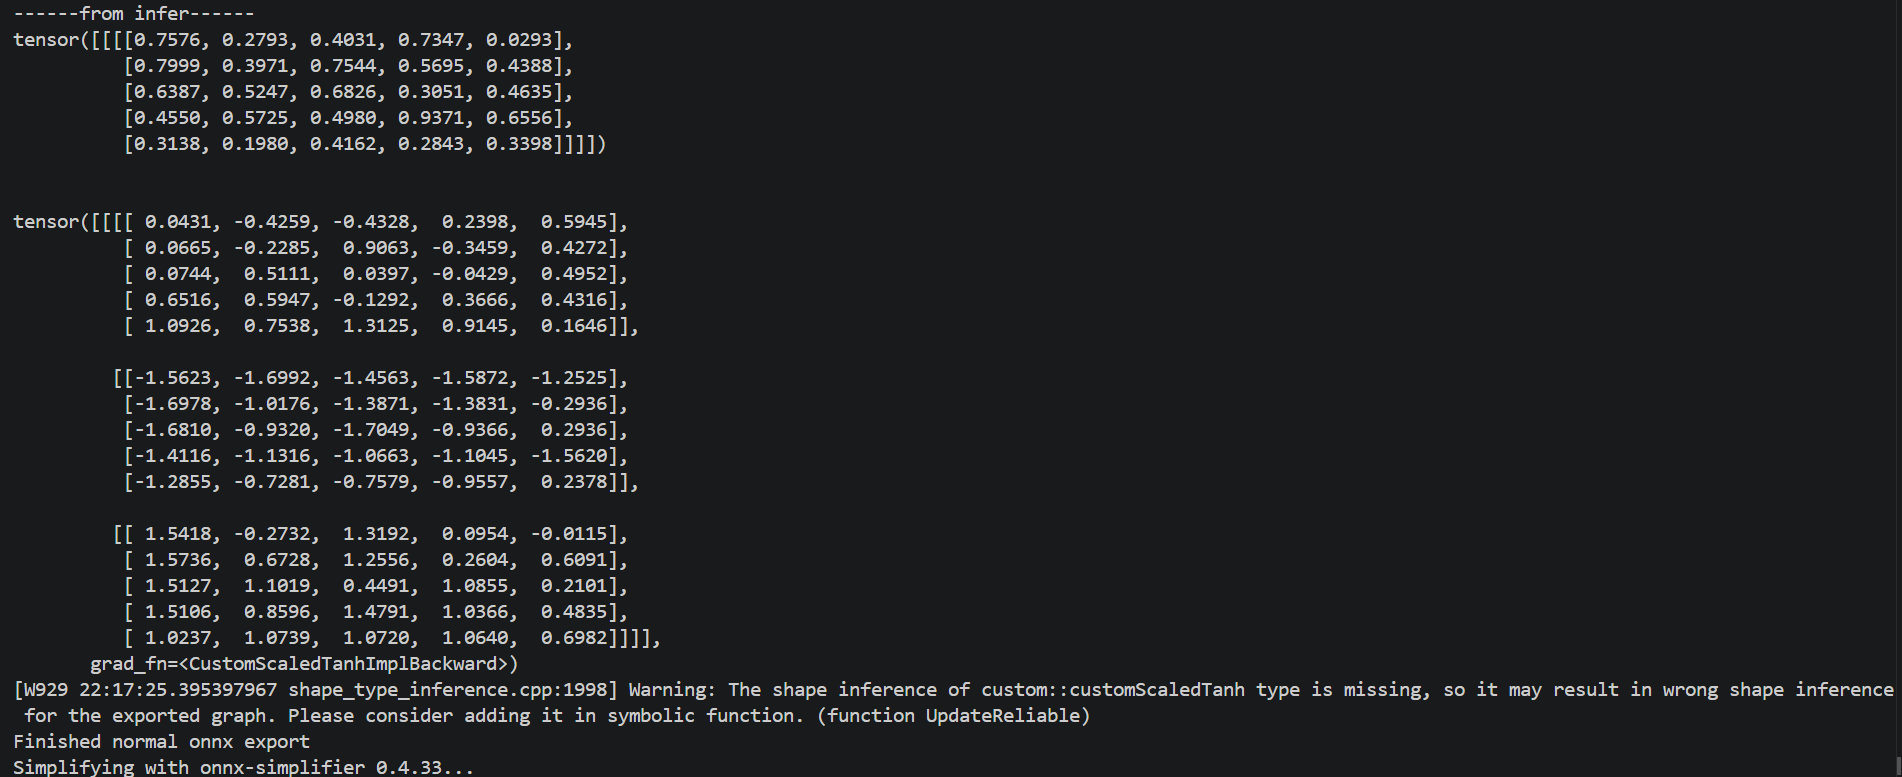
其中,for m in self.modules():部分用来初始化网络权重。由于是自己写的例子,因此并无训练过程。然后自己定义了网络的输入数据input。运行程序,打印输出:
五、C++ 端:头文件------两个类的声明
自定义插件涉及两个类,在头文件里一起声明,为方便后续开发,最好将插件类命名为XXXPlugin ,将插件工厂类命名为XXXPluginCreator。
cpp
// custom-scaledTanh-plugin.hpp
#ifndef __CUSTOM_SCALEDTANH_PLUGIN_HPP
#define __CUSTOM_SCALEDTANH_PLUGIN_HPP

#include "NvInferRuntime.h"
#include "NvInferRuntimeCommon.h"
#include <NvInfer.h>
#include <string>
#include <vector>

using namespace nvinfer1;

namespace custom
{
// 这个字符串就是"钥匙":必须和 Python 端导出的 op_type/domain 对上
static const char* PLUGIN_NAME    {"customScaledTanh"};
static const char* PLUGIN_VERSION {"1"};

// ============ 类一:Plugin(工人,负责具体执行与元信息) ============
class CustomScaledTanhPlugin : public IPluginV2DynamicExt {
public:
    // 一个插件在整条流水线里会被创建三次,对应三种构造函数:
    // 1. parse 阶段:读 onnx 创建实例(用带参构造)
    // 2. clone 阶段:build 时 TRT 复制多个副本做优化(用带参/反序列化构造)
    // 3. deserialize 阶段:加载引擎时反序列化重建(用反序列化构造)
    CustomScaledTanhPlugin() = delete;                                   // 默认构造,直接禁用
    CustomScaledTanhPlugin(const std::string &name, float k, float a);   // parse、clone 用
    CustomScaledTanhPlugin(const std::string &name, const void* buffer, size_t length); // 反序列化用

    ~CustomScaledTanhPlugin();

    /* ---- 元信息接口:告诉 TRT 这个算子长什么样 ---- */
    const char* getPluginType() const noexcept override;
    const char* getPluginVersion() const noexcept override;
    int32_t     getNbOutputs() const noexcept override;                 // 输出几个
    size_t      getSerializationSize() const noexcept override;         // 序列化占多大
    const char* getPluginNamespace() const noexcept override;
    DataType    getOutputDataType(int32_t index, DataType const* inputTypes, int32_t nbInputs) const noexcept override;
    DimsExprs   getOutputDimensions(int32_t outputIndex, const DimsExprs* inputs, int32_t nbInputs, IExprBuilder &exprBuilder) noexcept override; // 输出形状
    size_t      getWorkspaceSize(const PluginTensorDesc *inputs, int32_t nbInputs, const PluginTensorDesc *outputs, int32_t nbOutputs) const noexcept override;

    /* ---- 生命周期接口 ---- */
    int32_t     initialize() noexcept override;
    void        terminate() noexcept override;
    void        serialize(void *buffer) const noexcept override;
    void        destroy() noexcept override;
    int32_t     enqueue(const PluginTensorDesc* inputDesc, const PluginTensorDesc* outputDesc, const void* const* inputs, void* const* outputs, void* workspace, cudaStream_t stream) noexcept override; // 真正的计算入口
    IPluginV2DynamicExt* clone() const noexcept override;               // 复制副本

    /* ---- 格式与配置接口 ---- */
    bool supportsFormatCombination(int32_t pos, const PluginTensorDesc* inOuts, int32_t nbInputs, int32_t nbOutputs) noexcept override; // 支持的数据类型/格式
    void configurePlugin(const DynamicPluginTensorDesc* in, int32_t nbInputs, const DynamicPluginTensorDesc* out, int32_t nbOutputs) noexcept override;
    void setPluginNamespace(const char* pluginNamespace) noexcept override;
    void attachToContext(cudnnContext* contextCudnn, cublasContext* contextCublas, IGpuAllocator *gpuAllocator) noexcept override;
    void detachFromContext() noexcept override;

private:
    const std::string mName;      // 插件名字(const,必须在初始化列表赋值)
    std::string       mNamespace; // 命名空间
    struct {
        float k;                  // 算子参数
        float a;
    } mParams;                    // 参数统一装进结构体,方便整体序列化
};
// ============ 类二:PluginCreator(招工处,负责创建与注册) ============
class CustomScaledTanhPluginCreator : public IPluginCreator {
public:
    CustomScaledTanhPluginCreator();  // 构造里注册参数(PluginField)
    ~CustomScaledTanhPluginCreator();

    const char*                     getPluginName() const noexcept override;    // 返回 PLUGIN_NAME
    const char*                     getPluginVersion() const noexcept override;
    const PluginFieldCollection*    getFieldNames() noexcept override;         // 声明需要哪些参数
    const char*                     getPluginNamespace() const noexcept override;
    IPluginV2*                      createPlugin(const char* name, const PluginFieldCollection* fc) noexcept override;      // 创建插件(parse 用)
    IPluginV2*                      deserializePlugin(const char* name, const void* serialData, size_t serialLength) noexcept override; // 反序列化创建
    void                            setPluginNamespace(const char* pluginNamespace) noexcept override;

private:
    static PluginFieldCollection    mFC;      // 参数集合,传给 TRT
    static std::vector<PluginField> mAttrs;   // 参数列表(从 onnx 属性得到)
    std::string                     mNamespace;
};
} // namespace custom
#endif- 三个构造函数对应三个生命周期阶段:parse(读 onnx)、clone(build 时复制副本)、deserialize(加载引擎)。这也是你会在网上很多插件实现里看到"为什么有三个构造函数"的原因。
mParams结构体把参数打包:getSerializationSize()返回sizeof(mParams)、serialize()直接memcpy整个结构体------这是"参数越多代码越少"的经典做法,把两个 float 打包成一个结构体一次拷完。mName是const std::string:const 成员必须在构造函数初始化列表里赋值(不能在函数体里赋值),后面 cpp 里会看到。
六、C++ 端:Plugin 类的实现
这是整套插件的核心实现。逐段讲解:
cpp
// custom-scaledTanh-plugin.cpp
#include "custom-scaledTanh-plugin.hpp"
#include <cuda_fp16.h>
#include <map>
#include <cstring>

// 声明 cu 里的核函数接口(实现写在 .cu 里)
void customScaledTanhImpl(const float * inputs, float * outputs, const float k, const float a, const int nElements, cudaStream_t stream);
void customScaledTanhImplFp16(const __half* inputs, __half* outputs, const float k, const float a, const int nElements, cudaStream_t stream);

using namespace nvinfer1;

namespace custom
{
// ============ 注册宏:把 Creator 注册进 TRT 全局注册表 ============
REGISTER_TENSORRT_PLUGIN(CustomScaledTanhPluginCreator);

// ============ 静态成员定义 ============
PluginFieldCollection   CustomScaledTanhPluginCreator::mFC {};
std::vector<PluginField> CustomScaledTanhPluginCreator::mAttrs;

// ============ 构造函数一:parse / clone 用(带参数) ============
CustomScaledTanhPlugin::CustomScaledTanhPlugin(const std::string &name, float k, float a):
    mName(name)          // const 成员必须在初始化列表
{
    mParams.k = k;
    mParams.a = a;
}

// ============ 构造函数二:反序列化用 ============
CustomScaledTanhPlugin::CustomScaledTanhPlugin(const std::string &name, const void* buffer, size_t length):
    mName(name)
{
    // 从序列化字节流里恢复参数
    memcpy(&mParams, buffer, sizeof(mParams));
}

CustomScaledTanhPlugin::~CustomScaledTanhPlugin()
{
    return; // 生命周期结束时会自动调用 terminate 和 destroy
}

/* ============ 元信息接口 ============ */
const char* CustomScaledTanhPlugin::getPluginType() const noexcept { return PLUGIN_NAME; }
const char* CustomScaledTanhPlugin::getPluginVersion() const noexcept { return PLUGIN_VERSION; }

int32_t CustomScaledTanhPlugin::getNbOutputs() const noexcept { return 1; }   // 单输出

size_t CustomScaledTanhPlugin::getSerializationSize() const noexcept
{
    return sizeof(mParams);   // 参数打包在结构体里,序列化大小 = 结构体大小
}

const char* CustomScaledTanhPlugin::getPluginNamespace() const noexcept
{
    return mNamespace.c_str();
}

DataType CustomScaledTanhPlugin::getOutputDataType(int32_t index, DataType const* inputTypes, int32_t nbInputs) const noexcept
{
    return inputTypes[0];     // 输出数据类型 = 输入数据类型
}

DimsExprs CustomScaledTanhPlugin::getOutputDimensions(int32_t outputIndex, const DimsExprs* inputs, int32_t nbInputs, IExprBuilder &exprBuilder) noexcept
{
    return inputs[0];         // 逐元素算子:输出形状 = 输入形状
}

size_t CustomScaledTanhPlugin::getWorkspaceSize(const PluginTensorDesc *inputs, int32_t nbInputs, const PluginTensorDesc *outputs, int32_t nbOutputs) const noexcept
{
    return 0;                 // 不需要额外 workspace
}

/* ============ 生命周期 ============ */
int32_t CustomScaledTanhPlugin::initialize() noexcept { return 0; }   // 无状态,无需初始化
void CustomScaledTanhPlugin::terminate() noexcept { return; }         // 与 initialize 配对

void CustomScaledTanhPlugin::serialize(void *buffer) const noexcept
{
    memcpy(buffer, &mParams, sizeof(mParams));   // 把参数拷进引擎文件
    return;
}

void CustomScaledTanhPlugin::destroy() noexcept
{
    delete this;   // TRT10 统一写法:直接 delete 自身
    return;
}

/* ============ 核心:enqueue,真正执行的地方 ============ */
int32_t CustomScaledTanhPlugin::enqueue(
    const PluginTensorDesc* inputDesc, const PluginTensorDesc* outputDesc,
    const void* const* inputs, void* const* outputs,
    void* workspace, cudaStream_t stream) noexcept
{
    // 1. 计算总元素数 = 各维度相乘
    int nElements = 1;
    for (int i = 0; i < inputDesc[0].dims.nbDims; i++) {
        nElements *= inputDesc[0].dims.d[i];
    }

    // 2. 按输入数据类型选择 FP32 还是 FP16 的 kernel
    if (inputDesc[0].type == DataType::kHALF) {
        customScaledTanhImplFp16(
            static_cast<const __half*>(inputs[0]),
            static_cast<__half*>(outputs[0]),
            mParams.k, mParams.a, nElements, stream);
    } else {
        customScaledTanhImpl(
            static_cast<const float *>(inputs[0]),
            static_cast<float *>(outputs[0]),
            mParams.k, mParams.a, nElements, stream);
    }
    return 0;
}

/* ============ clone:复制一个副本 ============ */
IPluginV2DynamicExt* CustomScaledTanhPlugin::clone() const noexcept
{
    // 用"反序列化构造"复用:把当前 mParams 当字节流传进去,一次拷出副本
    auto p = new CustomScaledTanhPlugin(mName, &mParams, sizeof(mParams));
    p->setPluginNamespace(mNamespace.c_str());
    return p;
}

/* ============ 格式支持 ============ */
bool CustomScaledTanhPlugin::supportsFormatCombination(int32_t pos, const PluginTensorDesc* inOut, int32_t nbInputs, int32_t nbOutputs) noexcept
{
    // pos=0 是输入,pos=1 是输出:都支持 FP32 或 FP16,且必须是线性排布(NCHW)
    switch (pos) {
    case 0:
        return (inOut[0].type == DataType::kFLOAT || inOut[0].type == DataType::kHALF)
               && inOut[0].format == TensorFormat::kLINEAR;
    case 1:
        return (inOut[1].type == DataType::kFLOAT || inOut[1].type == DataType::kHALF)
               && inOut[1].format == TensorFormat::kLINEAR;
    default:
        return false;
    }
}

/* ============ 配置接口:一般空实现 ============ */
void CustomScaledTanhPlugin::configurePlugin(const DynamicPluginTensorDesc* in, int32_t nbInputs, const DynamicPluginTensorDesc* out, int32_t nbOutputs) noexcept { return; }
void CustomScaledTanhPlugin::setPluginNamespace(const char* pluginNamespace) noexcept { mNamespace = pluginNamespace; return; }
void CustomScaledTanhPlugin::attachToContext(cudnnContext* contextCudnn, cublasContext* contextCublas, IGpuAllocator *gpuAllocator) noexcept { return; }
void CustomScaledTanhPlugin::detachFromContext() noexcept { return; }
} // namespace custom- REGISTER_TENSORRT_PLUGIN(CustomScaledTanhPluginCreator):会生成一个文件级静态对象 ,在
main()之前就把 Creator 注册进 TRT 全局注册表getPluginRegistry()。这正是"程序不在乎自定义算子在网络哪里"的原因------只要注册了,TRT 一启动就能按名字找到它。 getOutputDimensions返回inputs[0]:逐元素算子输出 = 输入形状,最简单的情况。后面如果写池化这类"输出尺寸变化"的算子,这里就要用exprBuilder计算新尺寸。- enqueue是灵魂:每帧推理都会调它,拿到输入输出的显存指针(inputs0 / outputs0)、维度、CUDA stream,然后按数据类型派发到对应 kernel。核函数就是在这里被启动的。
supportsFormatCombination:声明这个算子接受什么数据类型和排布。这里同时放开了 FP32 和 FP16------只有这里允许,TRT 才有可能让插件在 FP16 引擎里跑半精度。clone复用反序列化构造:new CustomScaledTanhPlugin(mName, &mParams, sizeof(mParams))把当前参数当字节流传进反序列化构造,一次完成"带参数复制"。这是避免代码重复的一个小技巧。- destroy 写
delete this:这是 TensorRT 10 的写法(旧版本是xxx->destroy()成员调用方式,10 已移除),统一delete this即可。
七、C++ 端:PluginCreator 类的实现(cpp 后半)
Creator 管"创建":声明算子需要哪些参数、按参数创建插件、反序列化创建插件。
cpp
// custom-scaledTanh-plugin.cpp(续)
namespace custom
{
// ============ Creator 构造:声明算子参数 ============
CustomScaledTanhPluginCreator::CustomScaledTanhPluginCreator()
{
    // 每个参数用 PluginField 描述:名字 + 类型
    // TRT 会用这些声明,把 onnx 节点里的属性(k, a)填进来
    mAttrs.emplace_back(PluginField("k", nullptr, PluginFieldType::kFLOAT32, 1));
    mAttrs.emplace_back(PluginField("a", nullptr, PluginFieldType::kFLOAT32, 1));
    mFC.nbFields = mAttrs.size();
    mFC.fields   = mAttrs.data();
}

CustomScaledTanhPluginCreator::~CustomScaledTanhPluginCreator() { }

const char* CustomScaledTanhPluginCreator::getPluginName() const noexcept { return PLUGIN_NAME; }
const char* CustomScaledTanhPluginCreator::getPluginVersion() const noexcept { return PLUGIN_VERSION; }
const char* CustomScaledTanhPluginCreator::getPluginNamespace() const noexcept { return mNamespace.c_str(); }

// ============ 创建插件:parse 阶段调用 ============
IPluginV2* CustomScaledTanhPluginCreator::createPlugin(const char* name, const PluginFieldCollection* fc) noexcept
{
    // 从 fc(onnx 属性填进来的参数)里读出 k 和 a
    float k = 0, a = 0;
    std::map<std::string, float*> paramMap = {{"k", &k}, {"a", &a}};
    for (int i = 0; i < fc->nbFields; i++) {
        if (paramMap.find(fc->fields[i].name) != paramMap.end()) {
            *paramMap[fc->fields[i].name] = *reinterpret_cast<const float*>(fc->fields[i].data);
        }
    }
    // 用读到的参数 new 一个 Plugin 实例
    return new CustomScaledTanhPlugin(name, k, a);
}

// ============ 反序列化创建插件:加载引擎时调用 ============
IPluginV2* CustomScaledTanhPluginCreator::deserializePlugin(const char* name, const void* serialData, size_t serialLength) noexcept
{
    return new CustomScaledTanhPlugin(name, serialData, serialLength);
}

void CustomScaledTanhPluginCreator::setPluginNamespace(const char* pluginNamespace) noexcept
{
    mNamespace = pluginNamespace;
    return;
}

const PluginFieldCollection* CustomScaledTanhPluginCreator::getFieldNames() noexcept
{
    return &mFC;
}

} // namespace custom- 构造里用 PluginField声明参数:
PluginField("k", nullptr, kFLOAT32, 1)表示"我这个算子有个 float 类型的参数,名字叫 k"。TRT 解析 onnx 时,会把节点属性k填进PluginFieldCollection(mFC)。 createPlugin里取参数:遍历fc拿到真实的 k、a 值,然后new CustomScaledTanhPlugin(name, k, a)用带参构造创建实例。这是 parse 阶段。deserializePlugin重建实例:加载序列化的引擎文件时,把字节流serialData交给反序列化构造new CustomScaledTanhPlugin(name, serialData, length),从中恢复参数。
八、CUDA 核函数
插件真正"干活"的地方,是调用 CUDA 核函数完成 k·tanh(a·x)。这里写了 FP32 和 FP16 两个版本的 kernel,以便在支持半精度的设备上对比精度与速度:
c
// ============ FP32 核函数 ============
__global__ void customScaledTanhKernel(
    const float* input, float* output,
    const float k, const float a, const int nElements)
{
    const int index = blockIdx.x * blockDim.x + threadIdx.x;
    if (index >= nElements)   // 关键:把"多余线程"挡在任务范围外
        return;

    output[index] = k * tanh(a * input[index]);   // 逐元素运算
}

// 启动 FP32 kernel 的 host 封装
void customScaledTanhImpl(const float * inputs, float * outputs,
    const float k, const float a, const int nElements, cudaStream_t stream)
{
    dim3 blockSize(256, 1, 1);
    dim3 gridSize(ceil(float(nElements) / 256), 1, 1);
    customScaledTanhKernel<<<gridSize, blockSize, 0, stream>>>(
        inputs, outputs, k, a, nElements);
}

// ============ FP16 核函数 ============
__global__ void customScaledTanhKernelFp16(
    const __half* input, __half* output,
    const float k, const float a, const int nElements)
{
    const int index = blockIdx.x * blockDim.x + threadIdx.x;
    if (index >= nElements)
        return;

    const float x = __half2float(input[index]);      // 半精度 → 浮点
    output[index] = __float2half(k * tanhf(a * x));  // 用 tanhf 更快,再转回半精度
}

void customScaledTanhImplFp16(const __half* inputs, __half* outputs,
    const float k, const float a, const int nElements, cudaStream_t stream)
{
    dim3 blockSize(256, 1, 1);
    dim3 gridSize(ceil(float(nElements) / 256), 1, 1);
    customScaledTanhKernelFp16<<<gridSize, blockSize, 0, stream>>>(
        inputs, outputs, k, a, nElements);
}- 线程 = 一个输出元素:
index = blockIdx.x * blockDim.x + threadIdx.x把每个线程编号和数组下标一一对应。GPU 的线程编号天然从 0 开始、连续递增,正好可以当数组下标用。 if (index >= nElements) return;是精髓:启动的线程总数(ceil(nElements/256)*256)一定 ≥ 元素数,多出来的线程必须挡在门外,否则会越界读写。- 逐元素运算天然适合 CUDA:输入输出一一对齐,每个线程算一个,互不干扰。
blockSize=256:每个 block 256 个线程(8 个 warp),gridSize = ceil(nElements/256)保证线程总数 ≥ 元素数。这是最常见的"一元素一线程"启动模型。
九、C++ main函数,工程构建与验证
main函数比较简单,直接读取相关的onnx文件,进行本地引擎构建,再推理即可。
cpp
#include <iostream>
#include <memory>

#include "utils.hpp"
#include "model.hpp"

using namespace std;

int main(int argc, char const *argv[])
{
    Model model("models/onnx/sample_customScaledTanh.onnx", Model::precision::FP16);

    if(!model.build()){
        LOGE("fail in building model");
        return 0;
    }
    if(!model.infer()){
        LOGE("fail in infering model");
        return 0;
    }
    return 0;
}
构建(Makefile 自动收集 src/cpp/*.cpp 与 *.cu),Makefile 文件可以根据自己的运行环境自己设计。
推理验证:分别用 PyTorch 跑 ONNX 模型、用 C++ 加载 TRT 引擎跑自定义插件,打印输出对比。这一致性验证很重要------它证明整条链路(导出 → 解析 → 插件 → 核函数)没有断裂。
先运行python程序的推理结果上文已经展示过了,看看C++程序的推理结果:
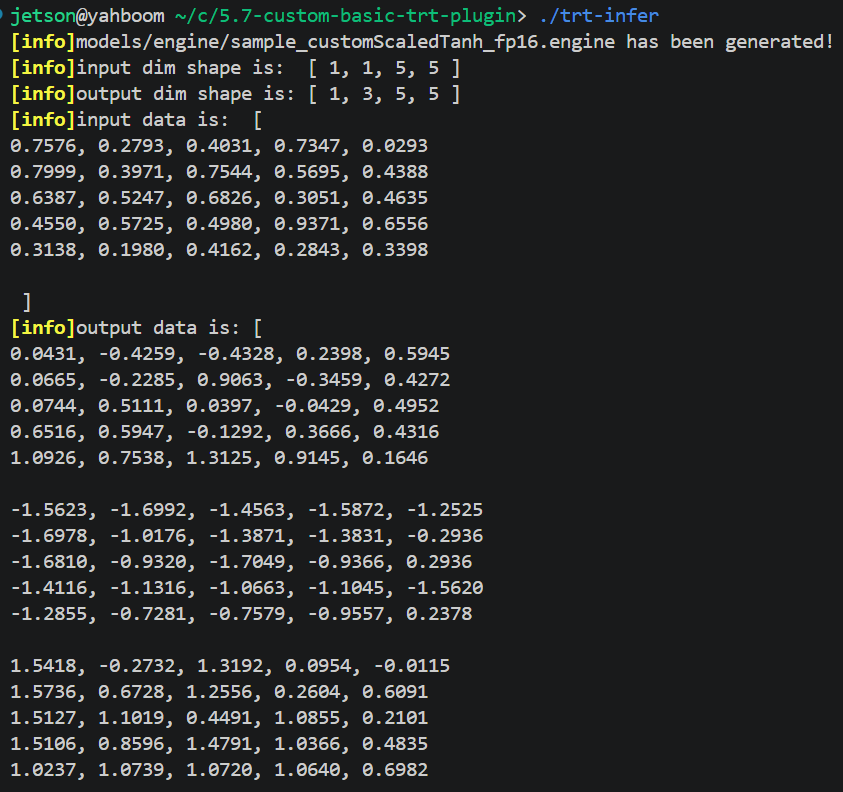
与上文的python推理结果一致。
十、参数的传递过程
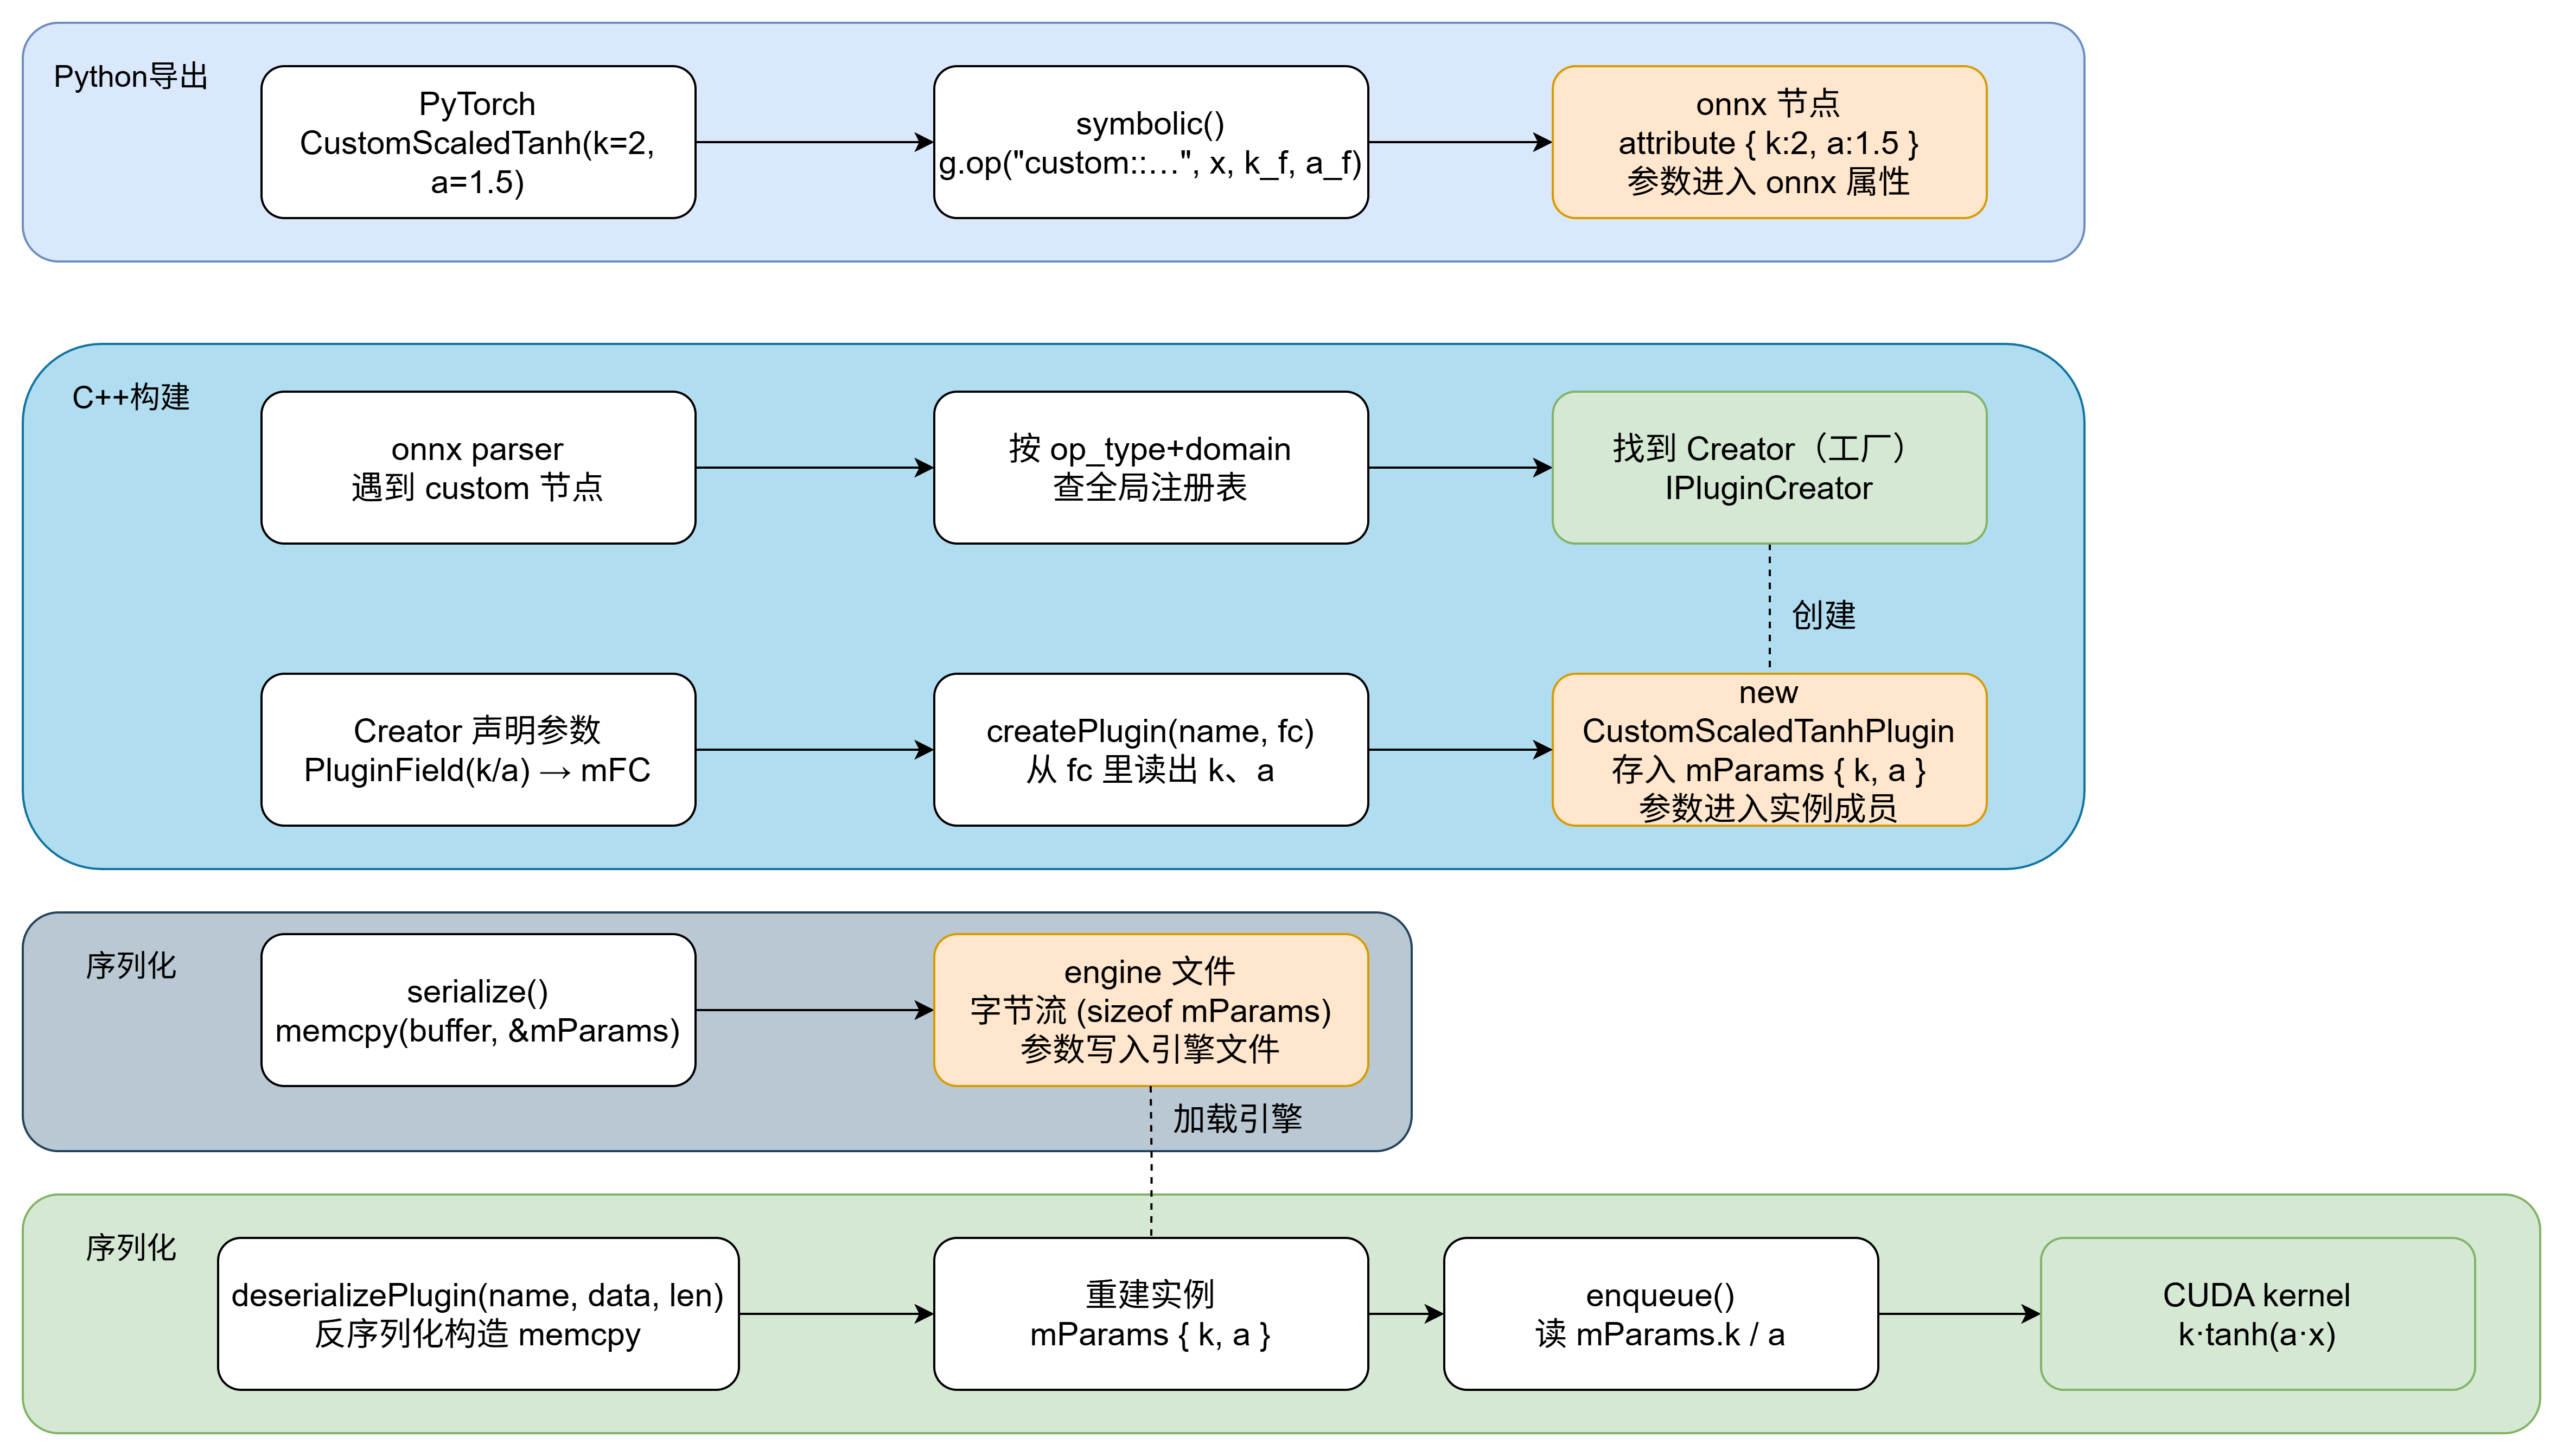
- ① Python 导出 :
k=2, a=1.5通过symbolic的k_f/a_f写进 onnx 节点的attribute。 - ② C++ 构建 :onnx parser 按
op_type+domain在注册表找到 Creator → Creator 用PluginField声明参数、TRT 把 onnx 属性填进mFC→createPlugin从 fc 读出 k、a →new进 Plugin 的mParams。 - ③ 序列化 :
serialize把mParams整个memcpy进 engine 文件(字节流)。 - ④ 加载推理 :
deserializePlugin→ 反序列化构造把字节流memcpy回新的mParams→enqueue从mParams取 k、a 传给 CUDA kernel。
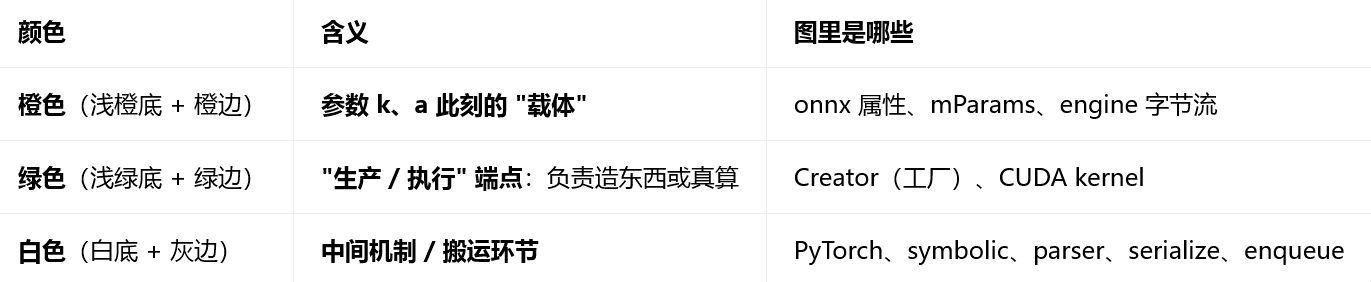
不同颜色方块表示不同的含义:
十一、总结
本文从一个 k·tanh(a·x) 的自定义激活算子出发,讲清了自定义插件的完整骨架:
- 为什么需要两个类:Creator(工厂)管"创建与注册",Plugin(工人)管"执行与元信息",二者由工厂模式解耦,TensorRT 只和 Creator 打交道。
- Python 端 只需
symbolic导出自定义 op,靠custom::customScaledTanh这个"钥匙"和 C++ 端对上。 - C++ 端 三个构造对应 parse / clone / deserialize 三个阶段;
enqueue是核心,调用 CUDA 核函数;serialize/deserialize负责参数进出引擎文件。 - CUDA 端 "一元素一线程" +
if (index >= nElements) return是最基本的核函数设计哲学。
掌握了这个框架,后续面对更复杂的算子(多输入融合、输出尺寸变化、窗口邻域运算)时,只需改三个地方:getOutputDimensions(输出形状)、supportsFormatCombination(格式)、enqueue(计算逻辑)------插件的"外壳"是通用的。
此基础上还自研了两个更进阶的插件:customGatedTanh(双输入门控融合算子)和 customMaxPool(2×2 窗口最大池化、输出尺寸变化、无参数),分别对应"多输入融合"和"空间邻域重排"两类真实部署中最常见的难点,后续文章会继续阐述,敬请期待!!!💓💓💓