一、基本定义
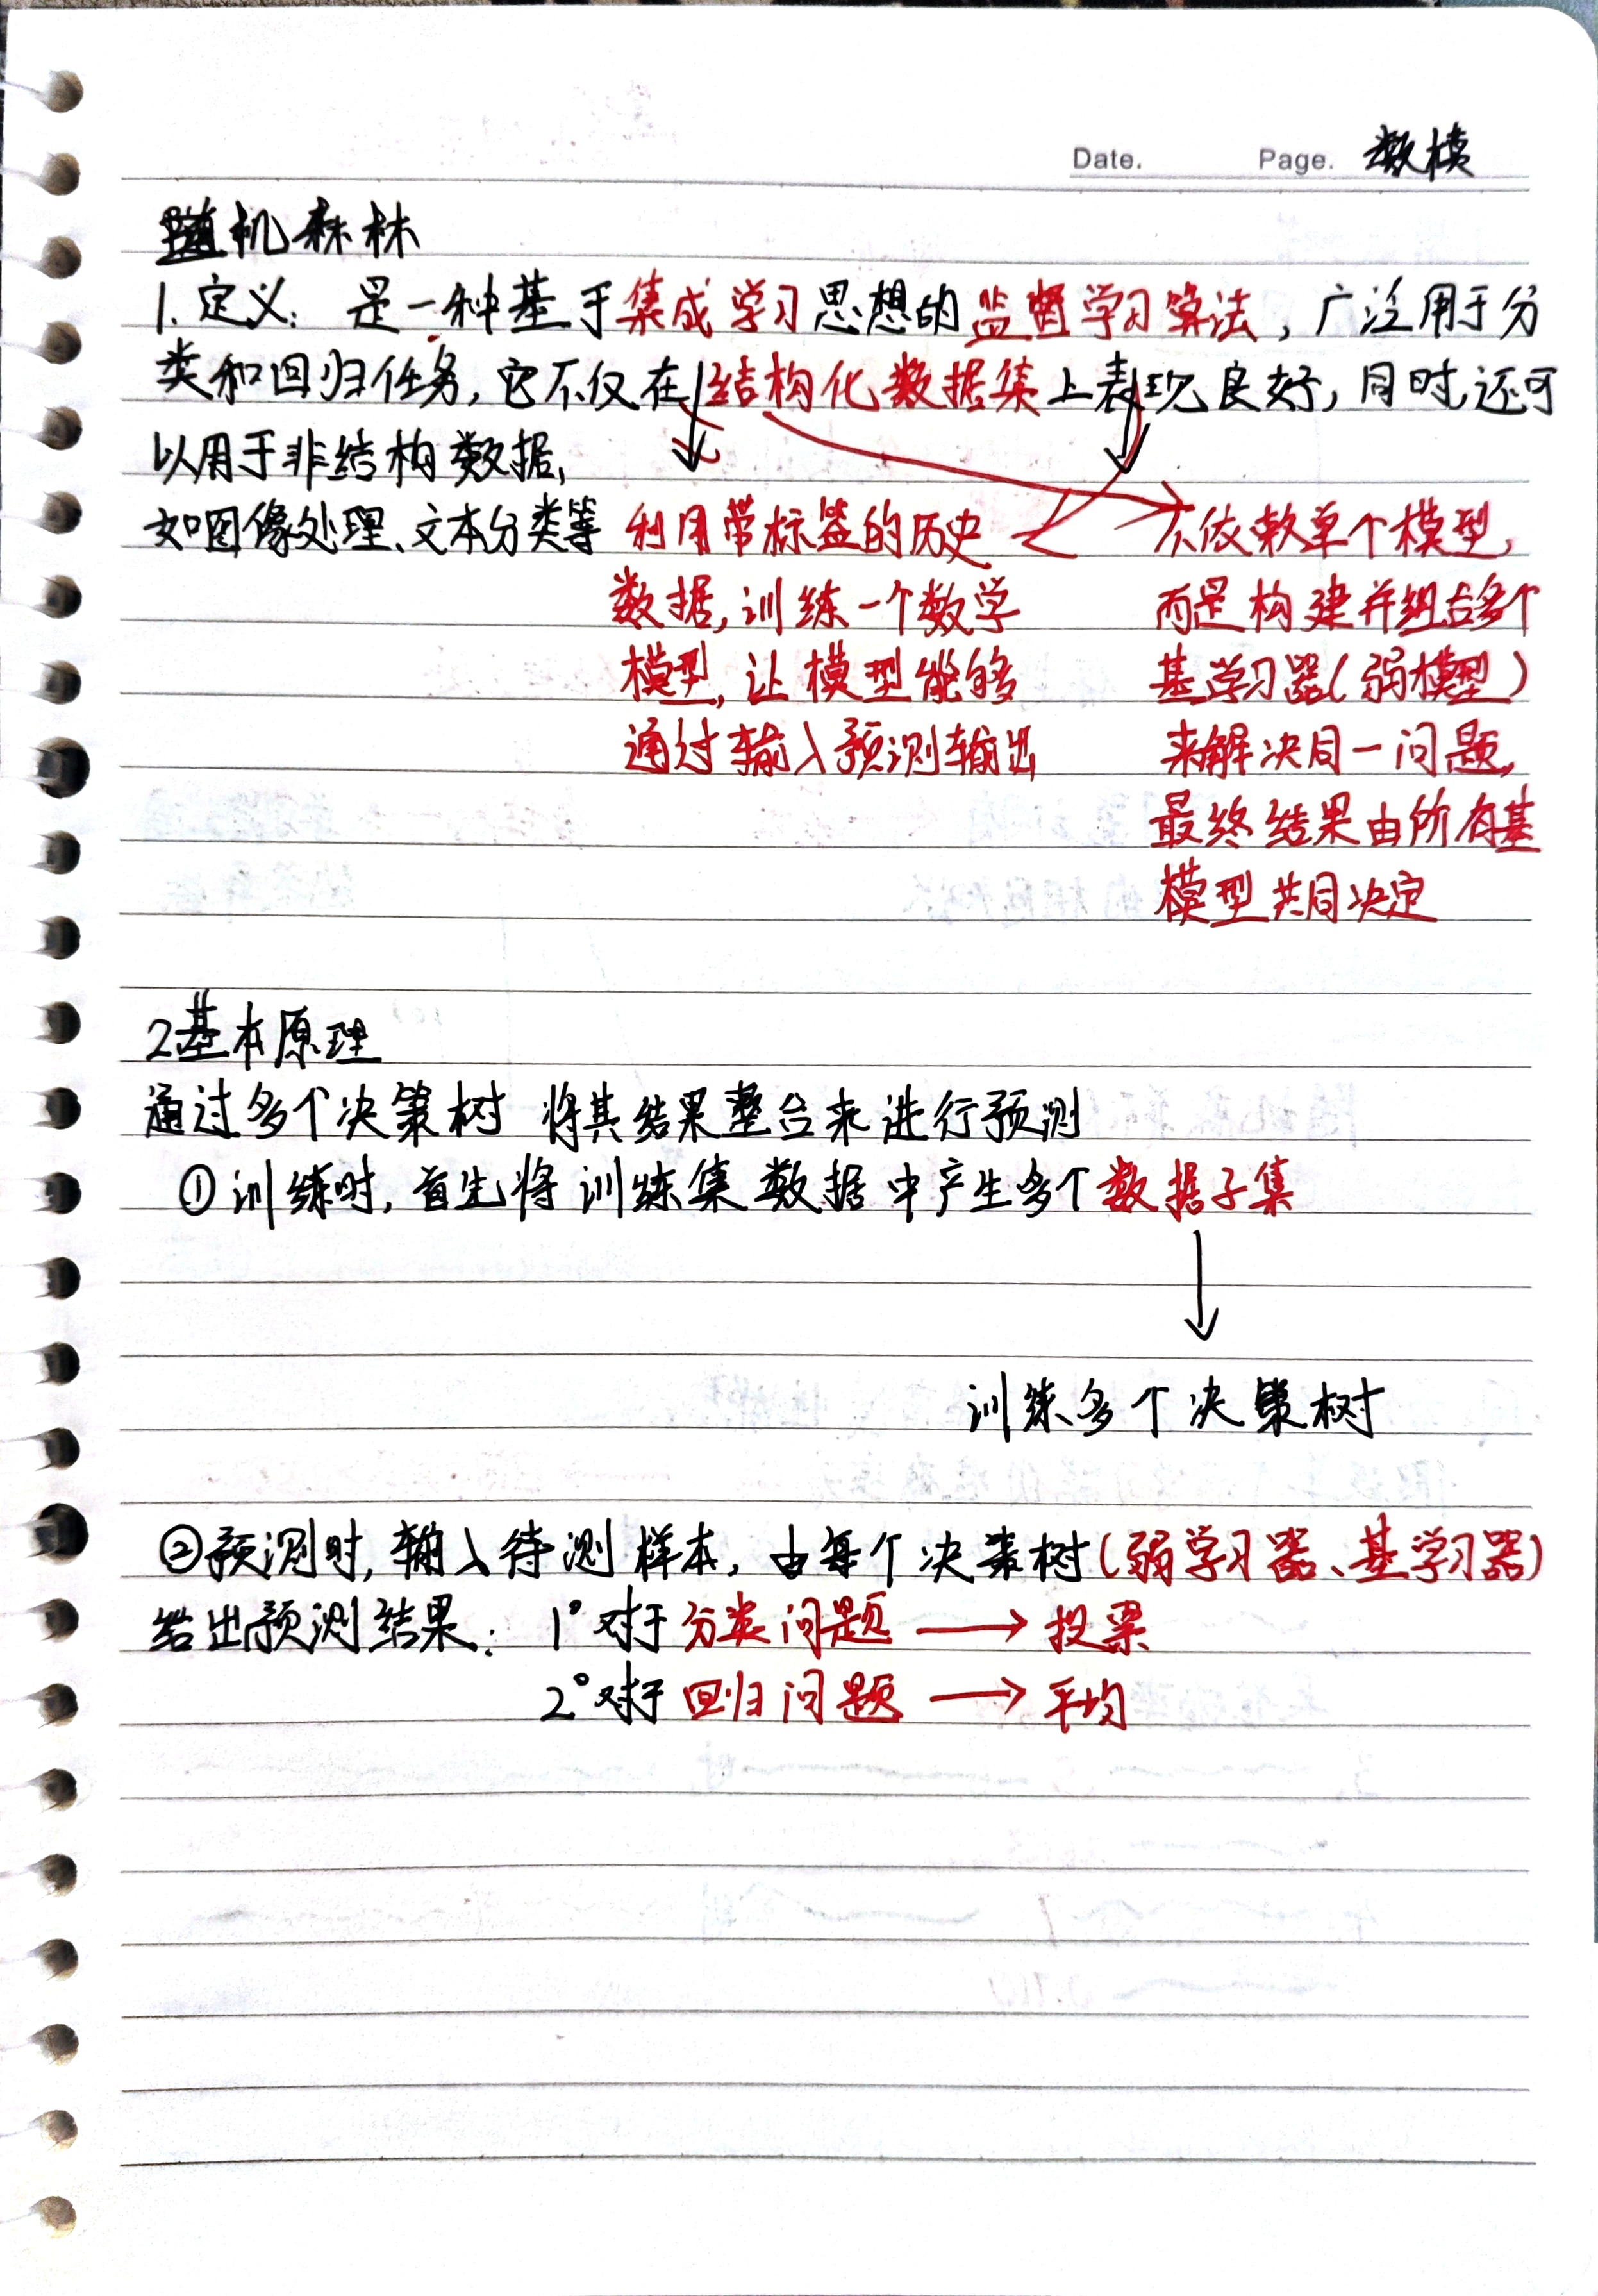
随机森林是Bagging(自助聚合)框架下的集成监督学习算法,可完成分类、回归任务,结构化/图像、文本等非结构化数据集都适用。核心思路:不依赖单个模型,训练大量决策树(基学习器/弱模型)共同预测结果。
- 分类任务:所有树投票选出最终类别
- 回归任务:所有树输出结果取平均值
二、训练核心步骤
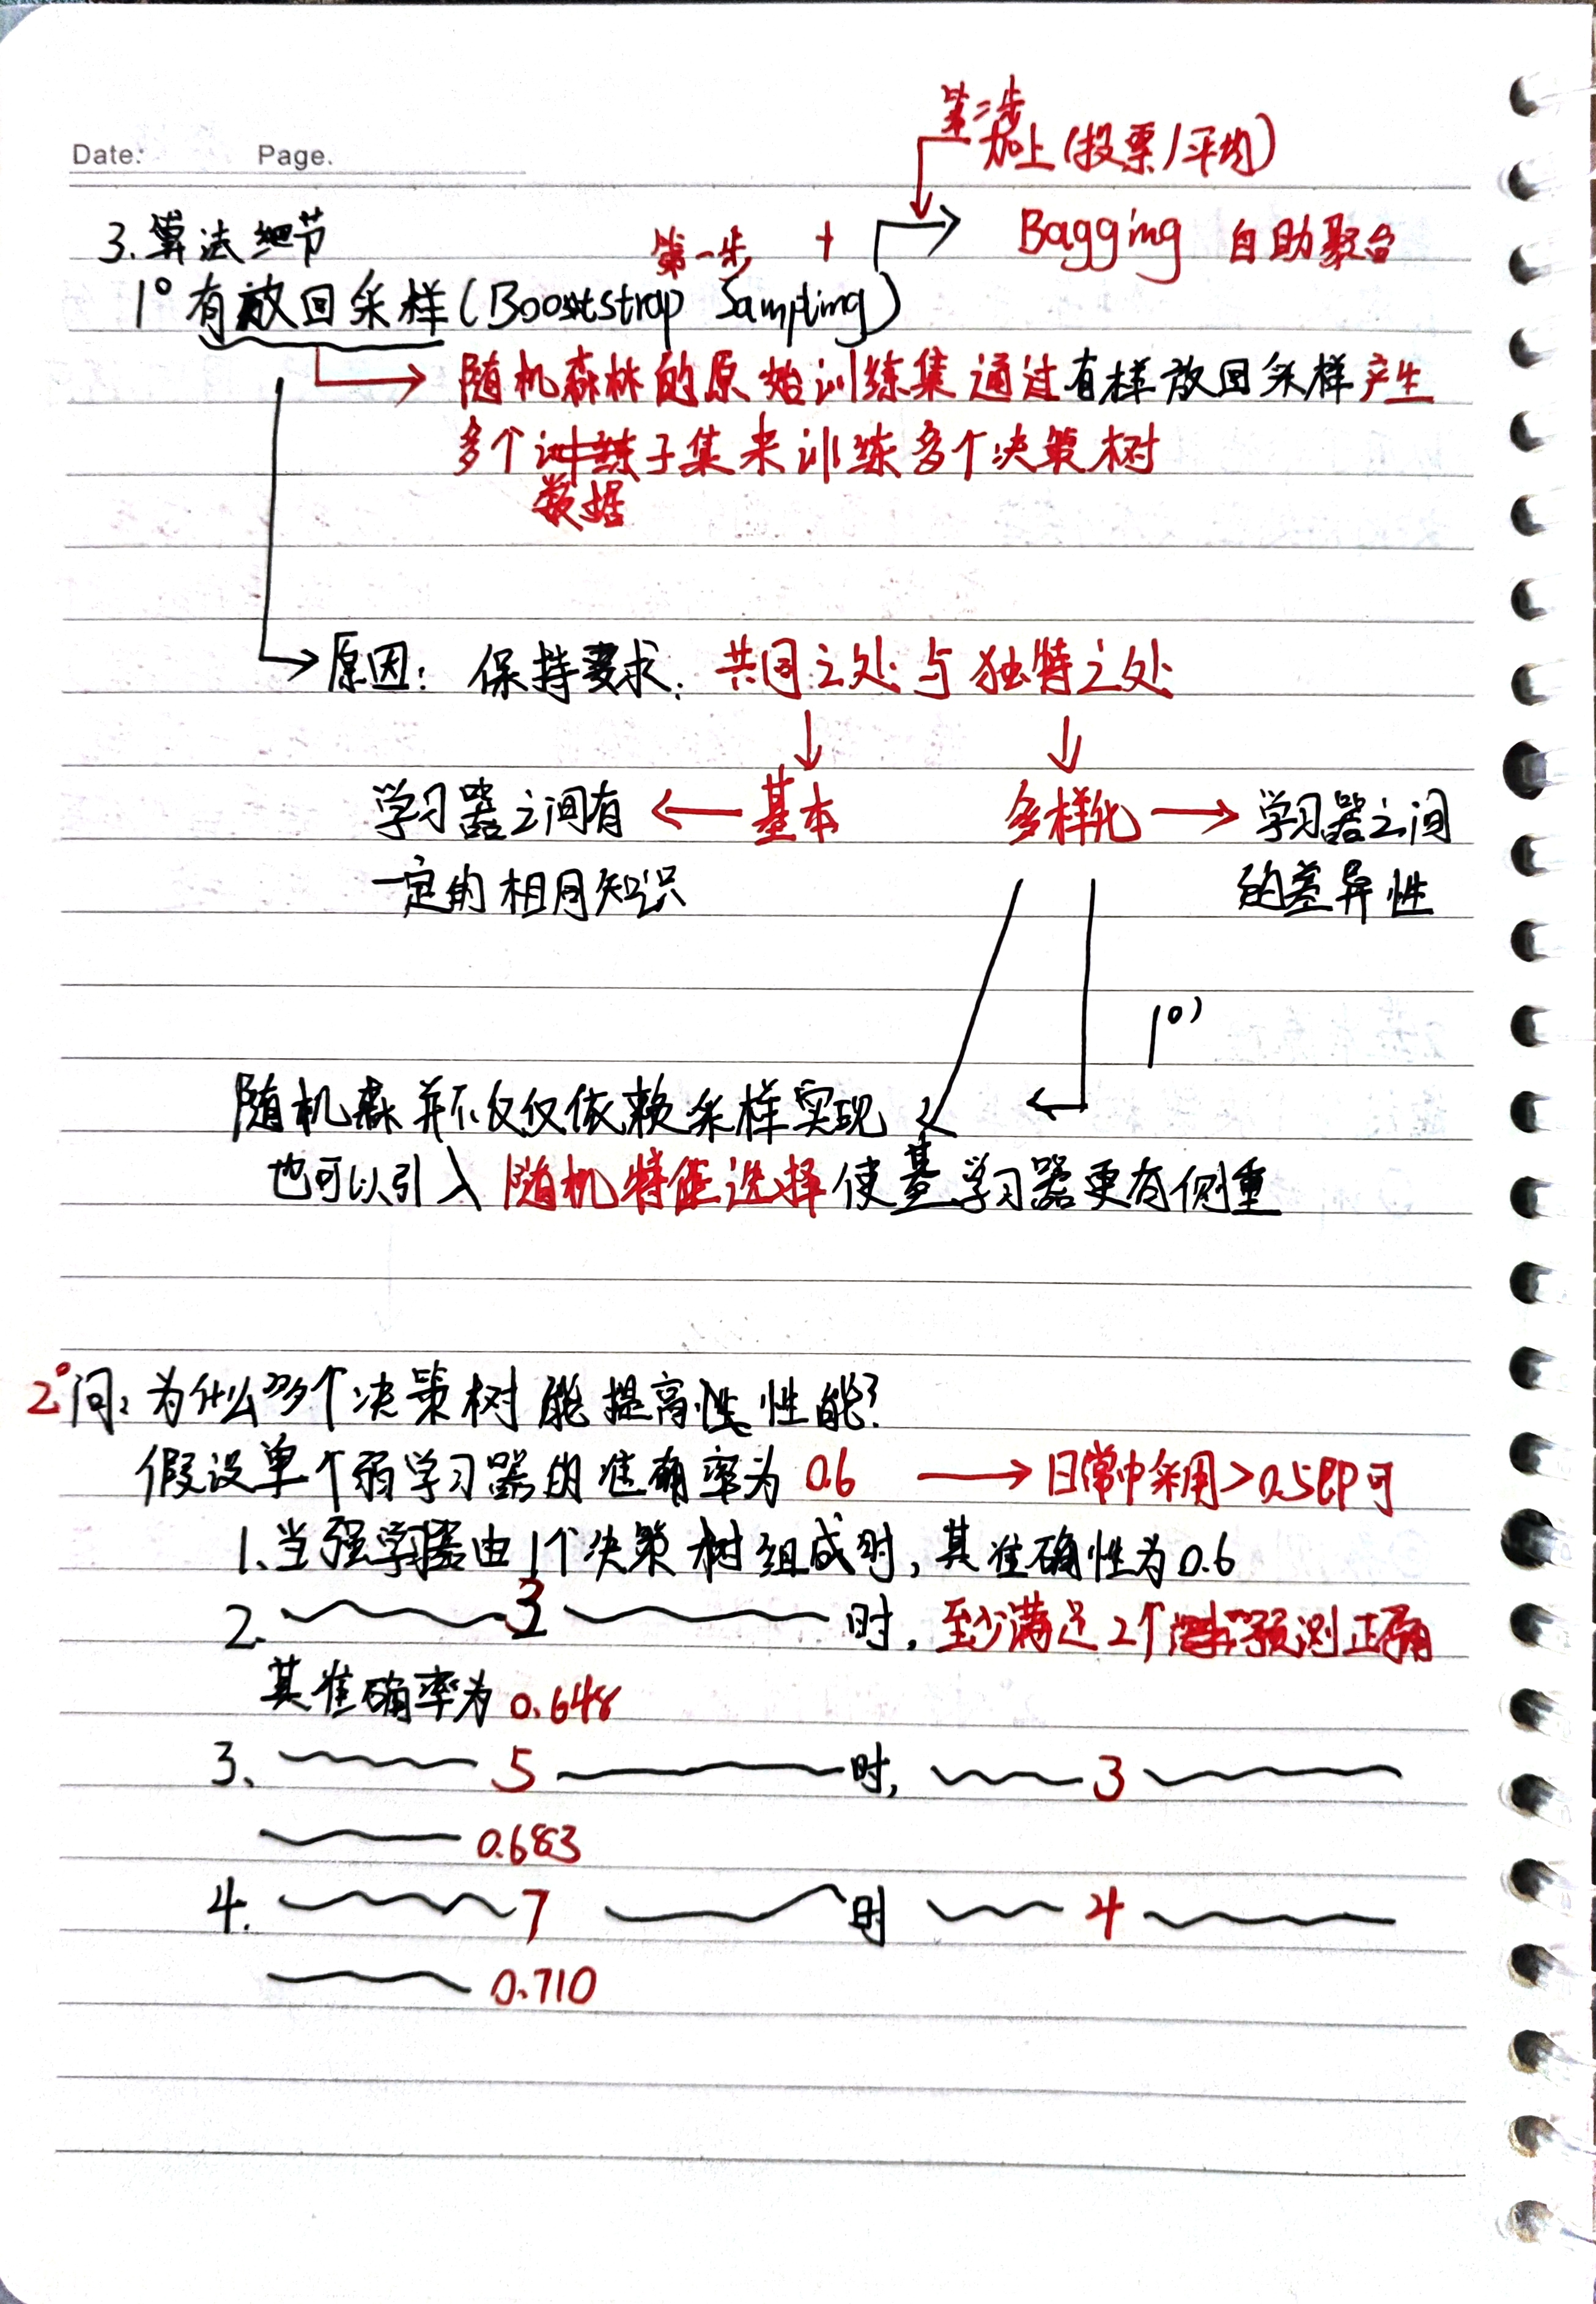
1、有放回采样(Bootstrap 自助采样)
从原始数据集中有放回抽样生成多个独立的数据子集,分别用来训练每一棵决策树。
- 目的:保证基学习器之间既有一部分公共知识,又拥有差异性(多样性)。
- 额外增加随机特征选择:每棵树再随机挑选部分特征训练,进一步提升树之间的差异化。
集成效果前提:单个弱学习器准确率只需要大于 0.5 即可,不是要求单棵树精度极高。
2、为什么多棵树组合之后整体性能会变好?
- 不同决策树对噪声、异常样本敏感度不一样,可以互相抵消一部分错误,提升鲁棒性。
- 每一棵树会学到数据集里面不一样的特征和内在模式,多个模型融合覆盖更多情况。举例(单棵树准确率 0.6)。
- 3棵树:至少2棵预测正确 →整体准确率
0.648 - 5棵树:至少3棵预测正确 →整体准确率
0.683 - 7棵树:至少4棵预测正确 →整体准确率
0.710
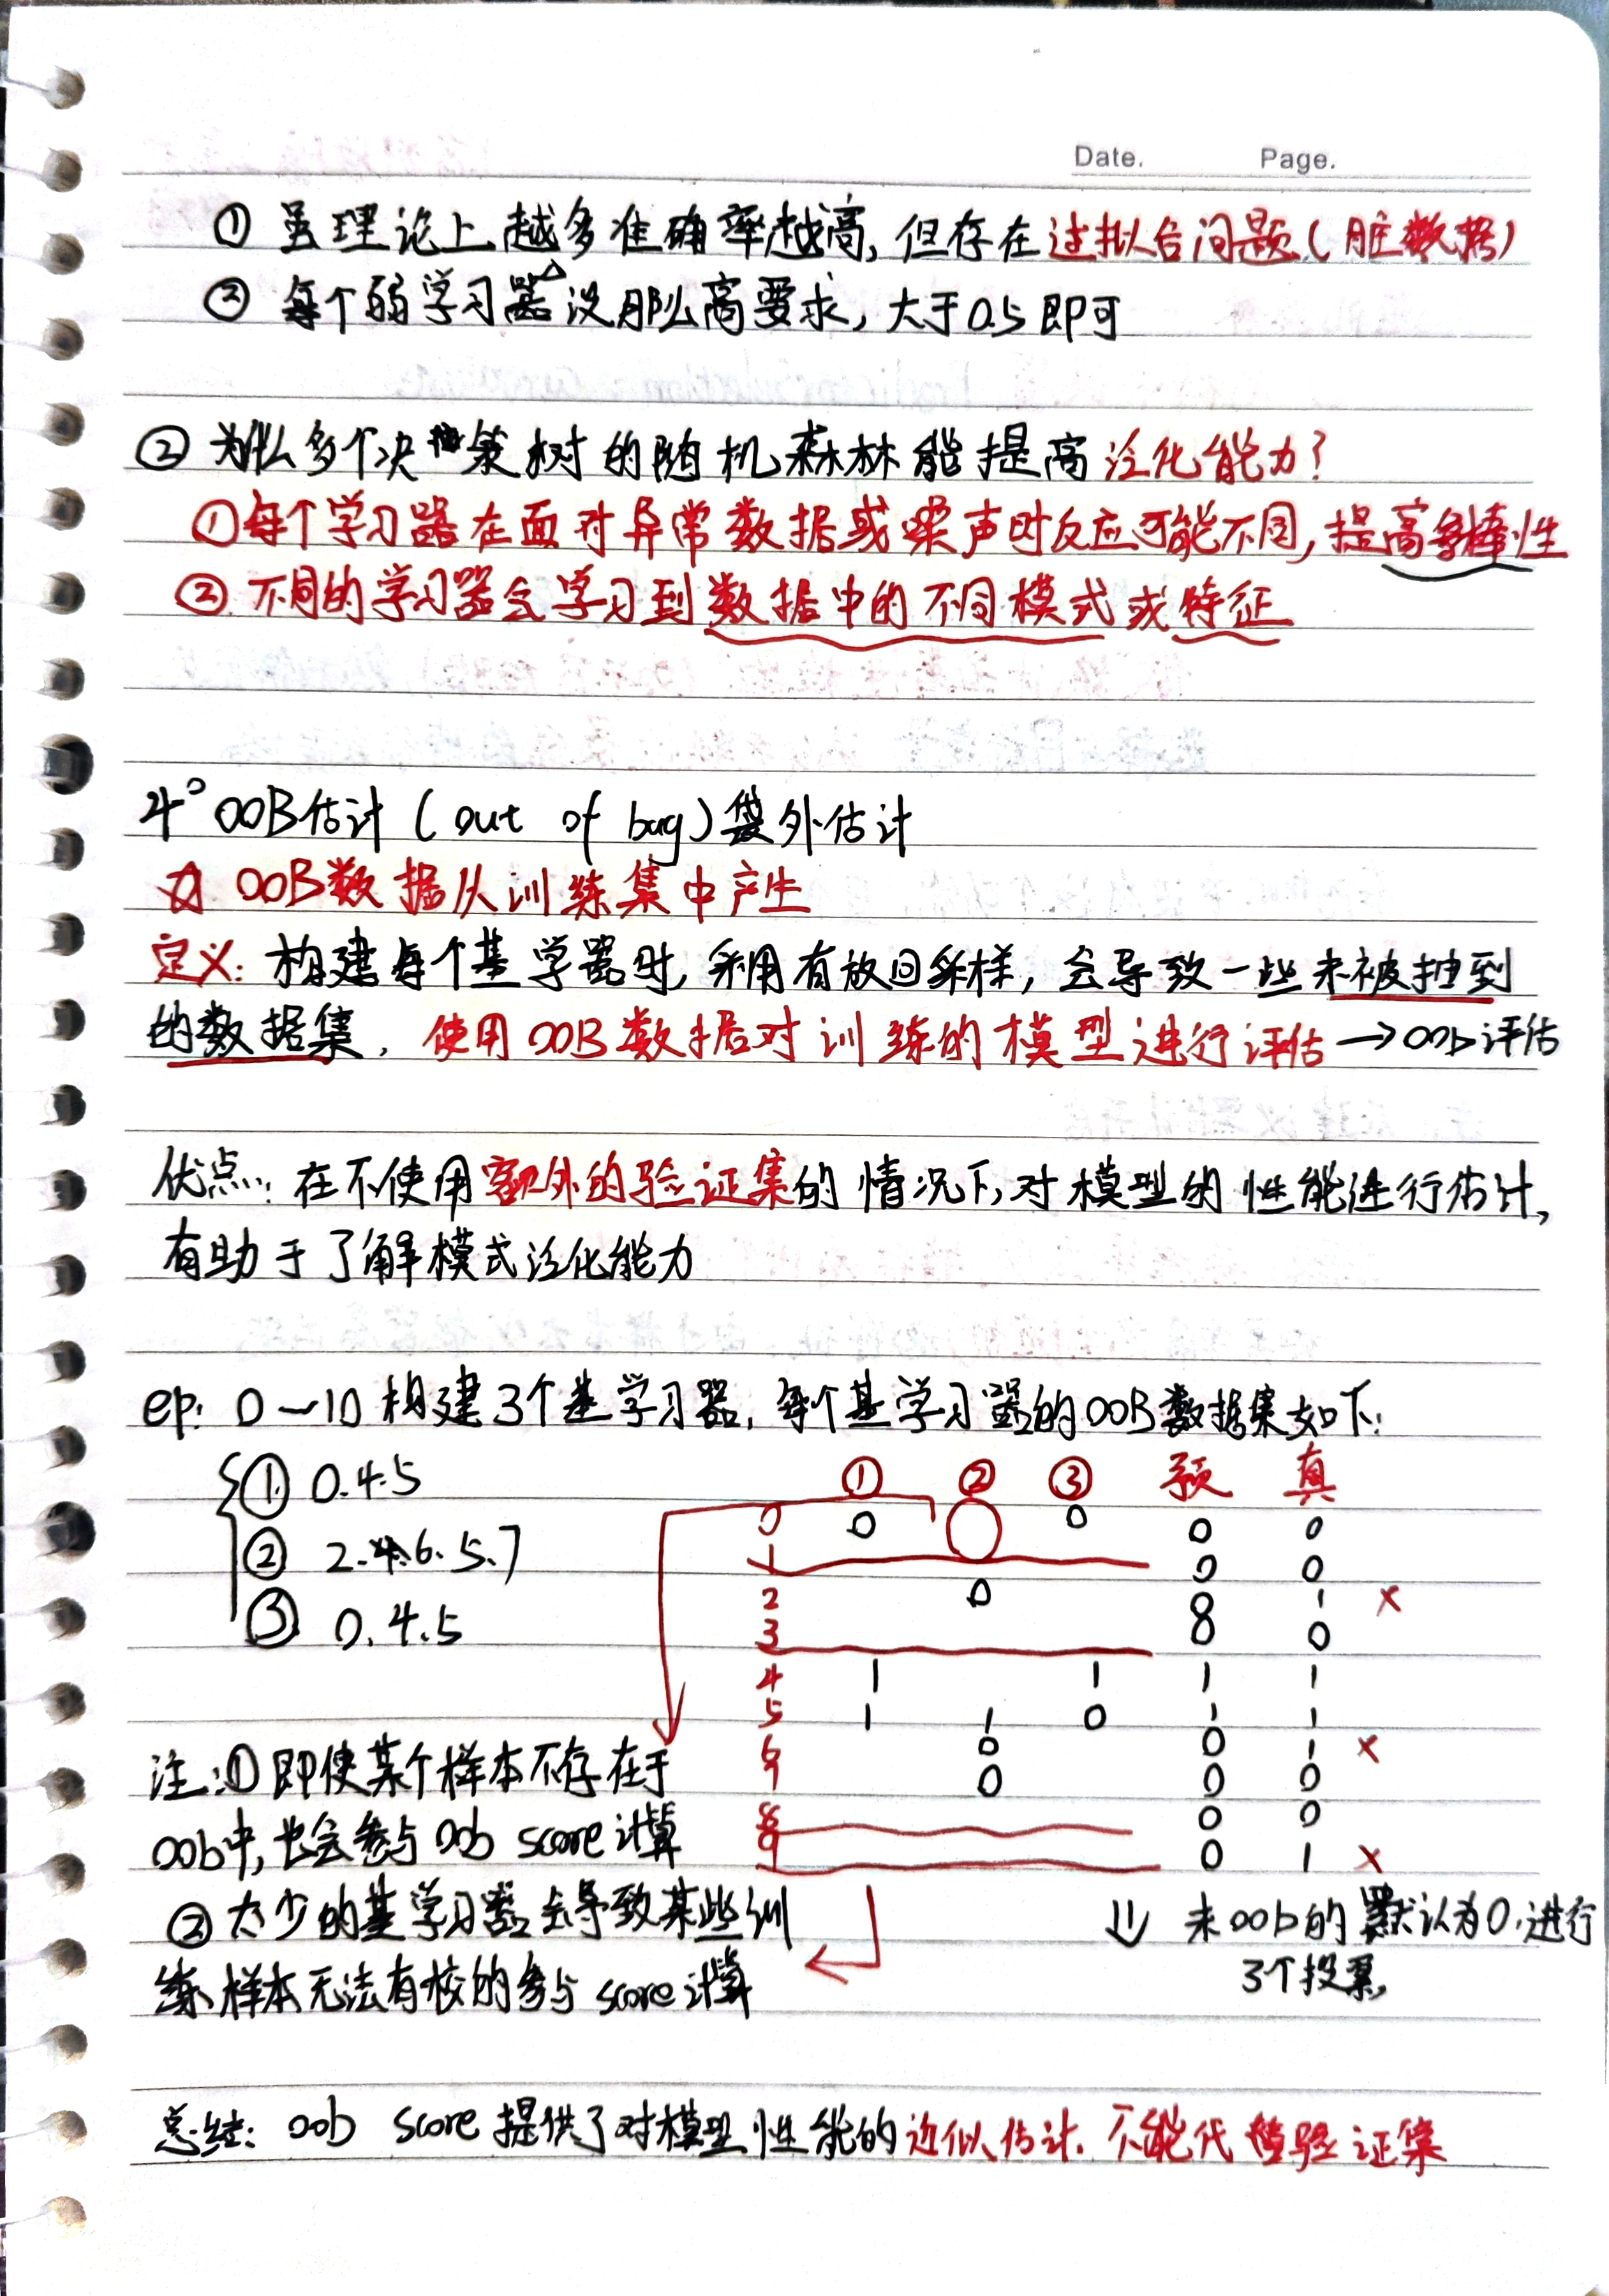
树不是越多越好:数量过大容易造成过拟合,模型学习到噪声。
三、OOB袋外估计(Out‑of‑Bag)
定义
自助有放回采样的时候,原始训练集里面一部分样本不会被抽到,这部分样本叫做袋外样本。可以直接拿袋外样本,评估当前树的泛化性能。
- 优点:不需要单独划分验证集,就能大致评估模型泛化能力。
- 局限性 :只是近似估计,不能完全代替独立验证集。
注意细节:1. 样本没有出现在某一棵树 OOB 集,仍然能够参与整体 OOB 得分运算;2. 基学习器太少,部分样本无法参与 OOB 评分计算。
四、整体流程速记
原始数据集 →自助采样生成多个子集 +随机选特征 →训练一堆独立决策树 →预测阶段投票/平均输出结果 →OOB 样本评估模型效果