精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖
文章目录
- 一、项目介绍
- 二、视频展示
- 三、开发环境
- 四、系统展示
- 五、代码展示
- 六、项目文档展示
- 七、项目总结
- [<font color=#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻](#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻)
一、项目介绍
心血管疾病风险因素多、指标散,单靠表格或零散统计很难把年龄、血脂、生活方式和穿戴数据串成一张"风险地图",临床教学和健康科普也缺一个能随手查、能对比的展示入口。本文通过开发一个基于大数据的心脏病风险数据可视化与分析网站,用以帮助梳理心脏病风险相关指标、呈现多维分析结果并支撑日常查阅与演示讲解。
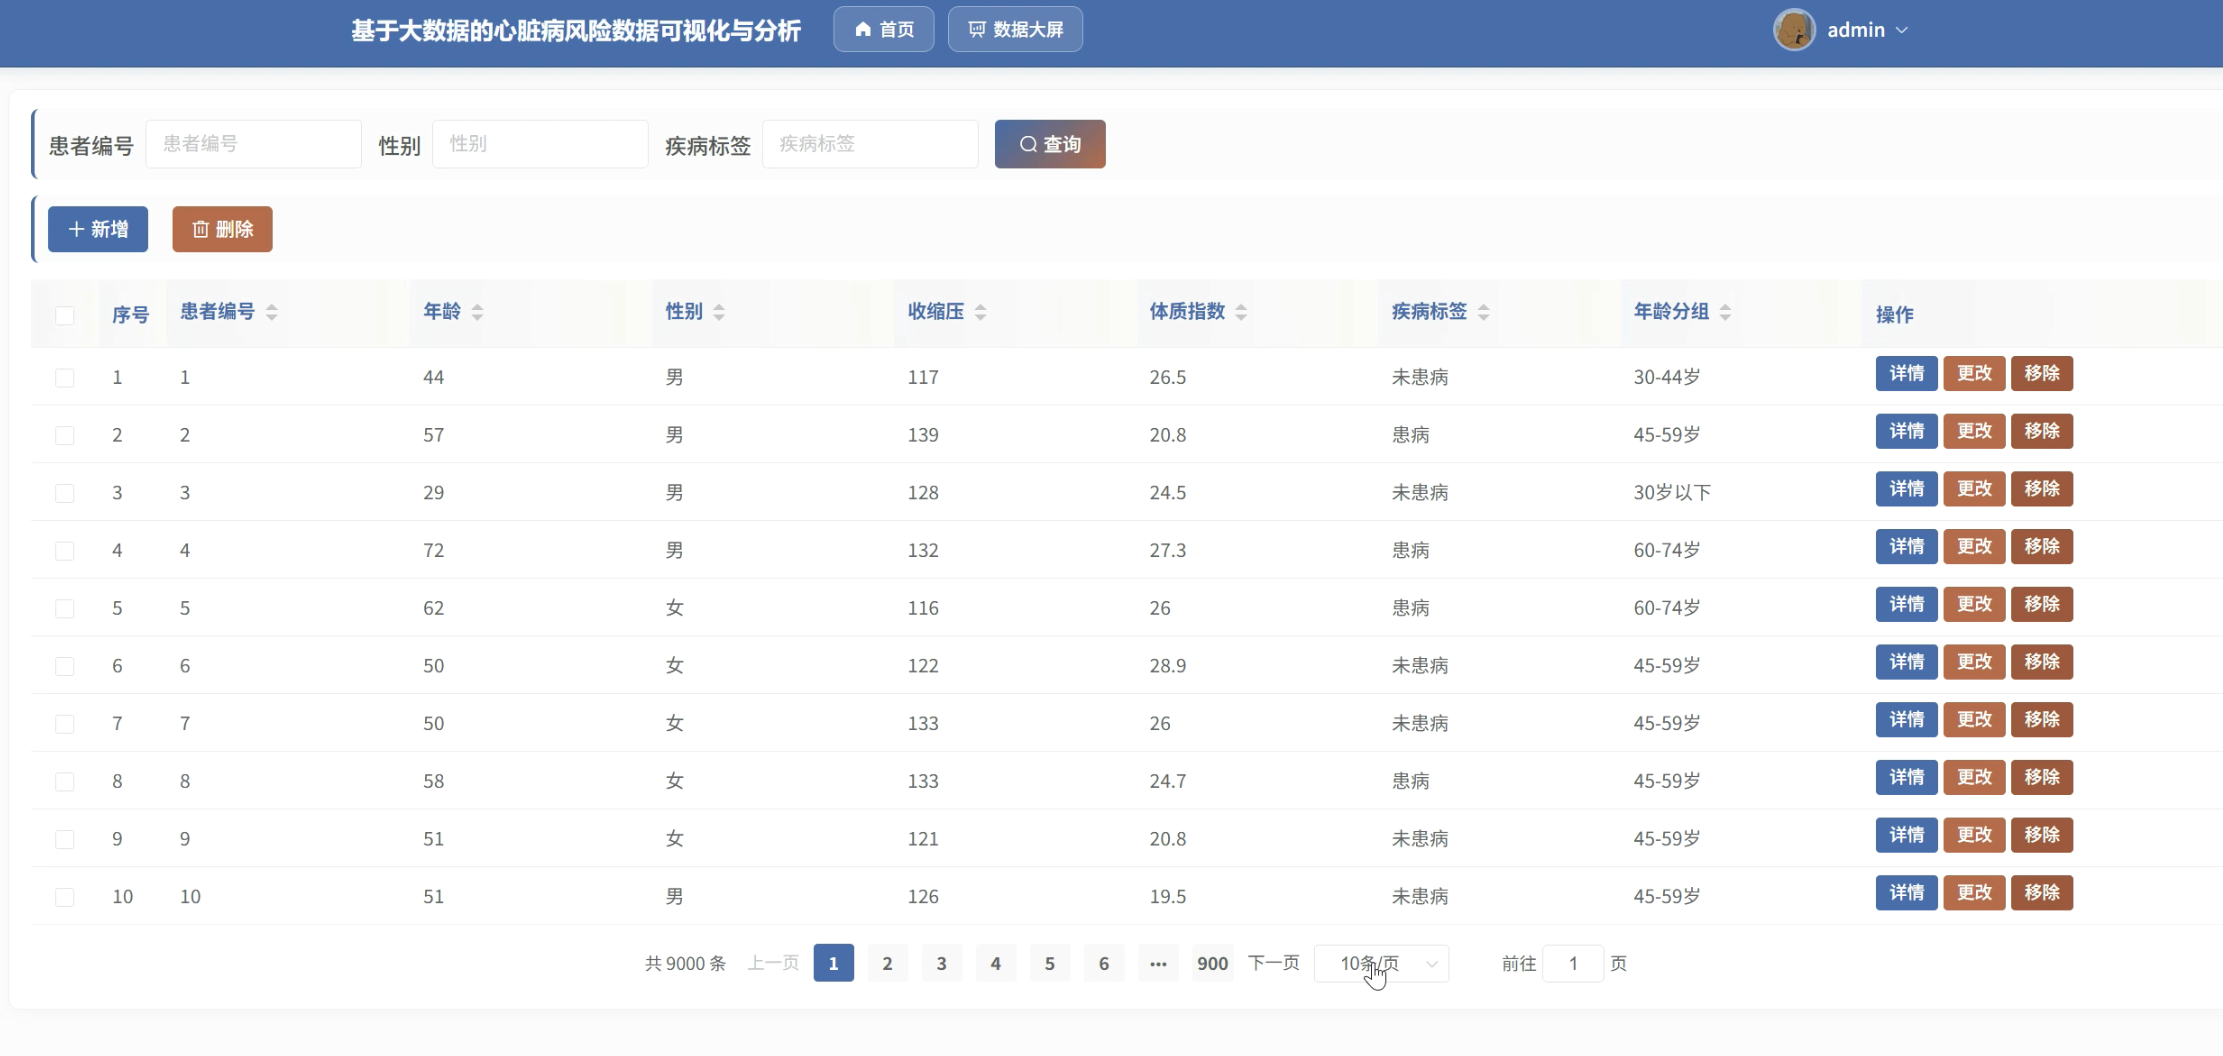
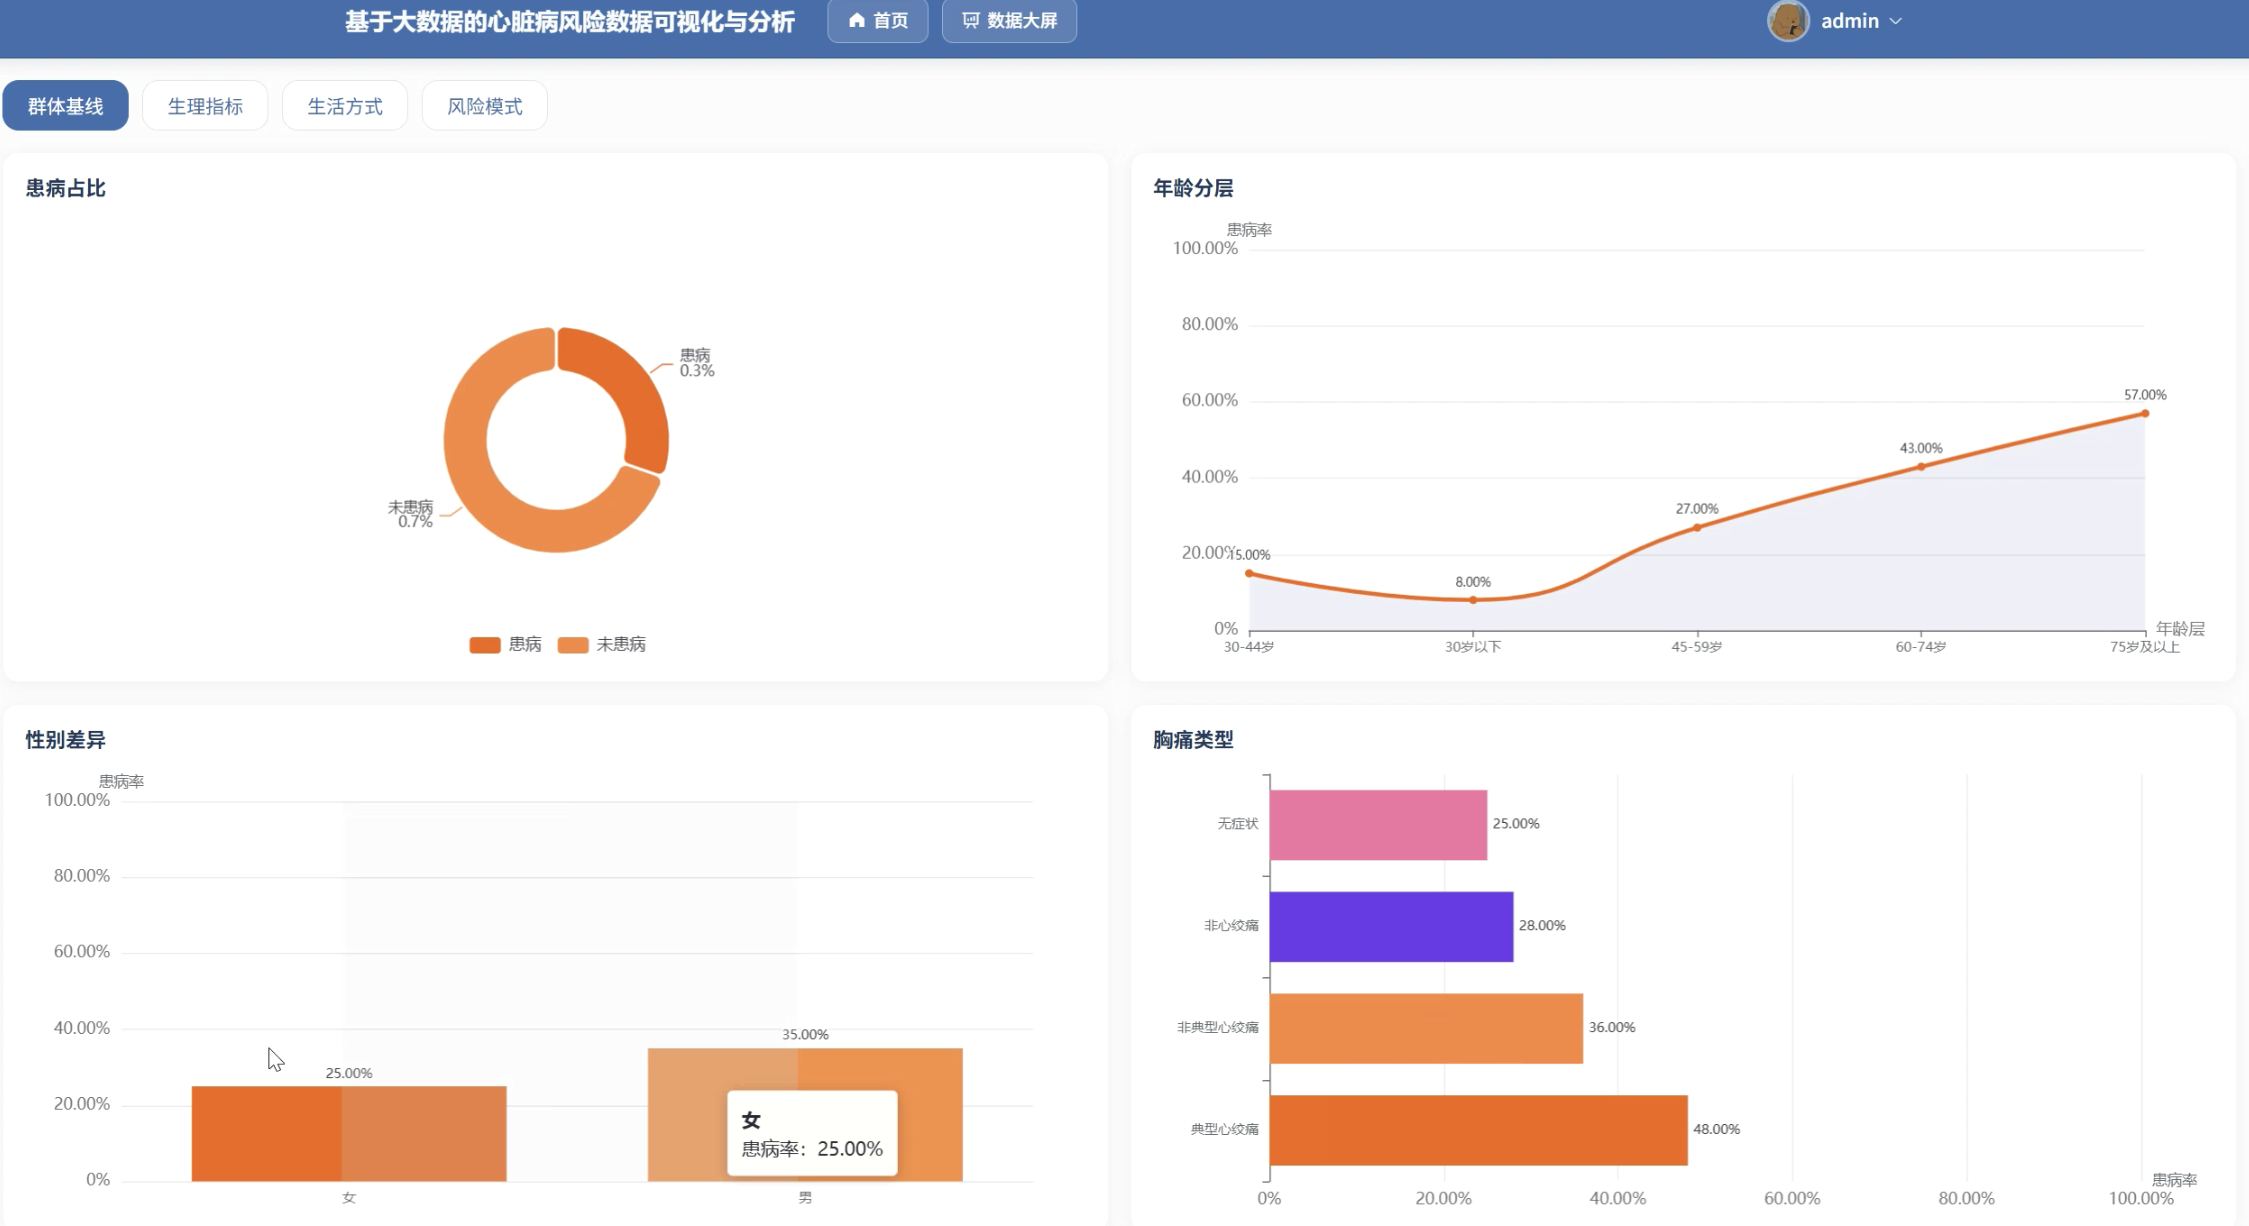
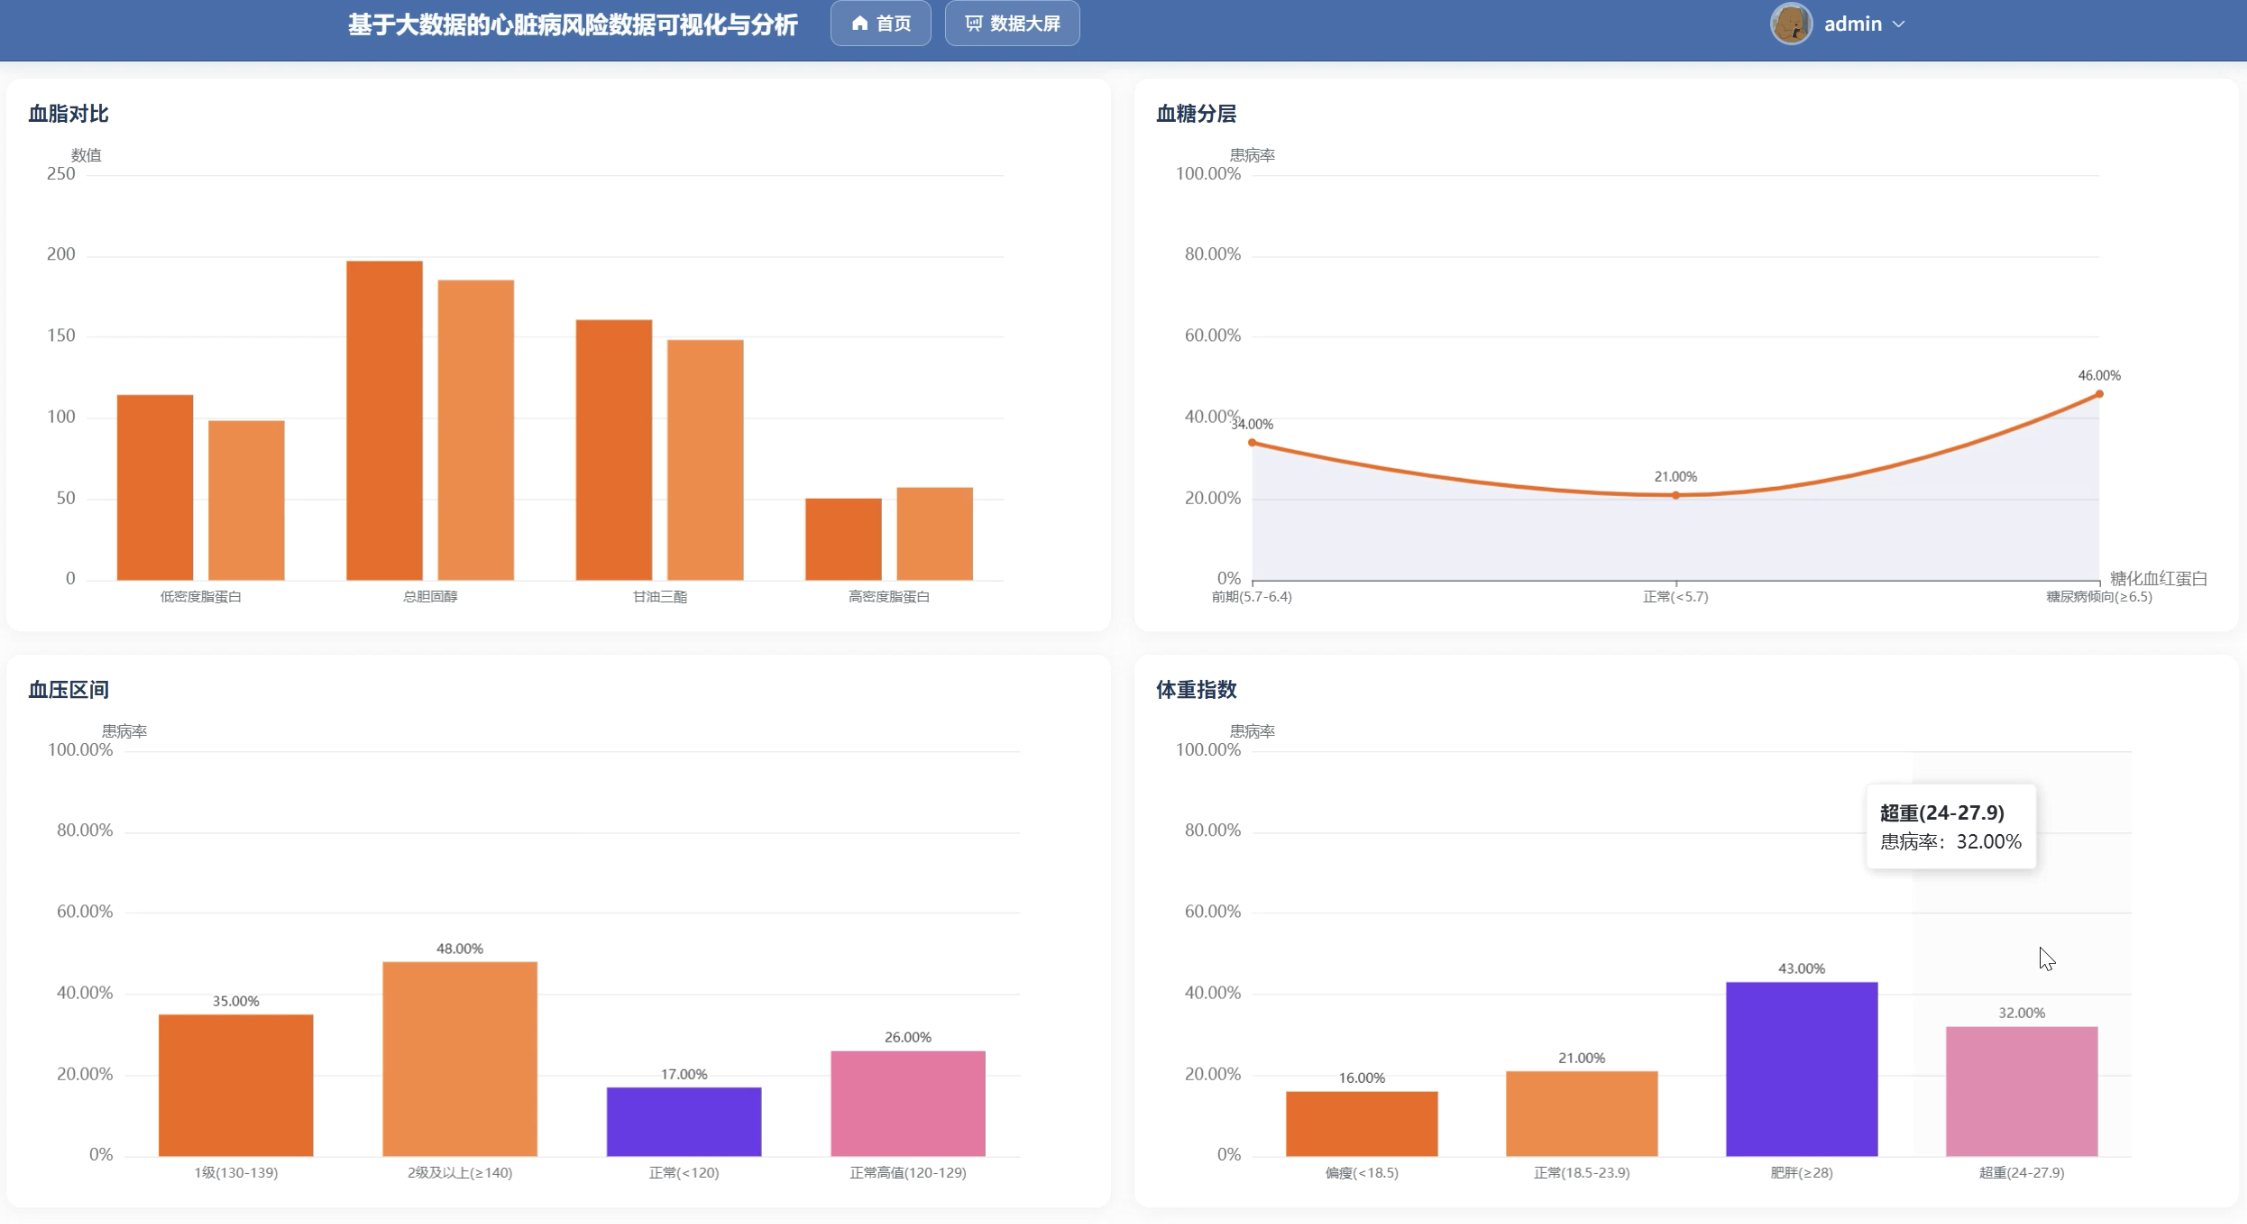
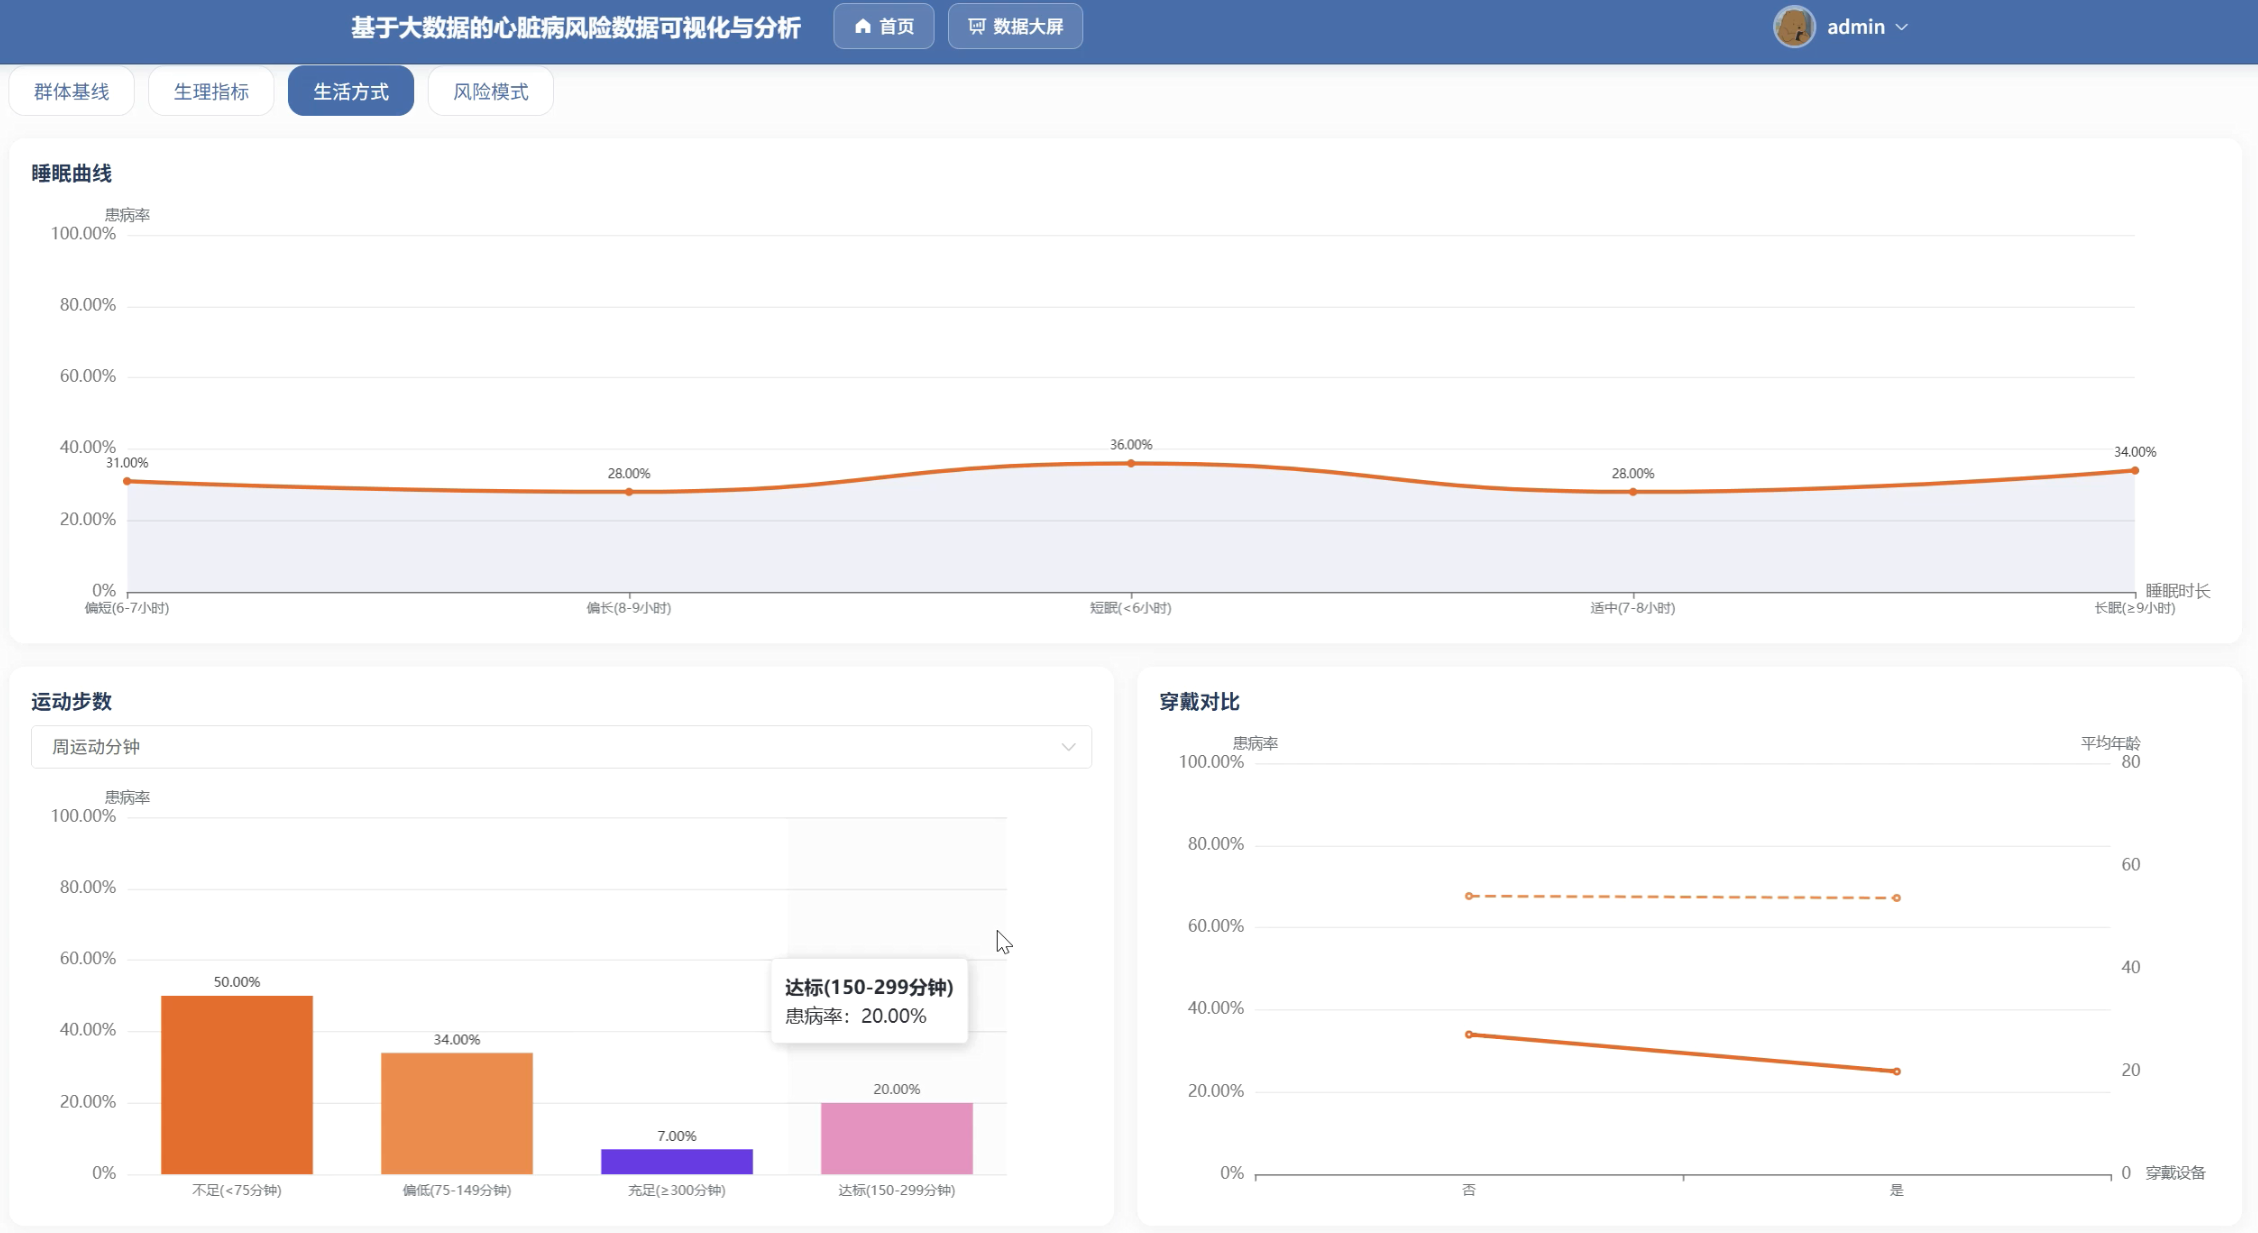
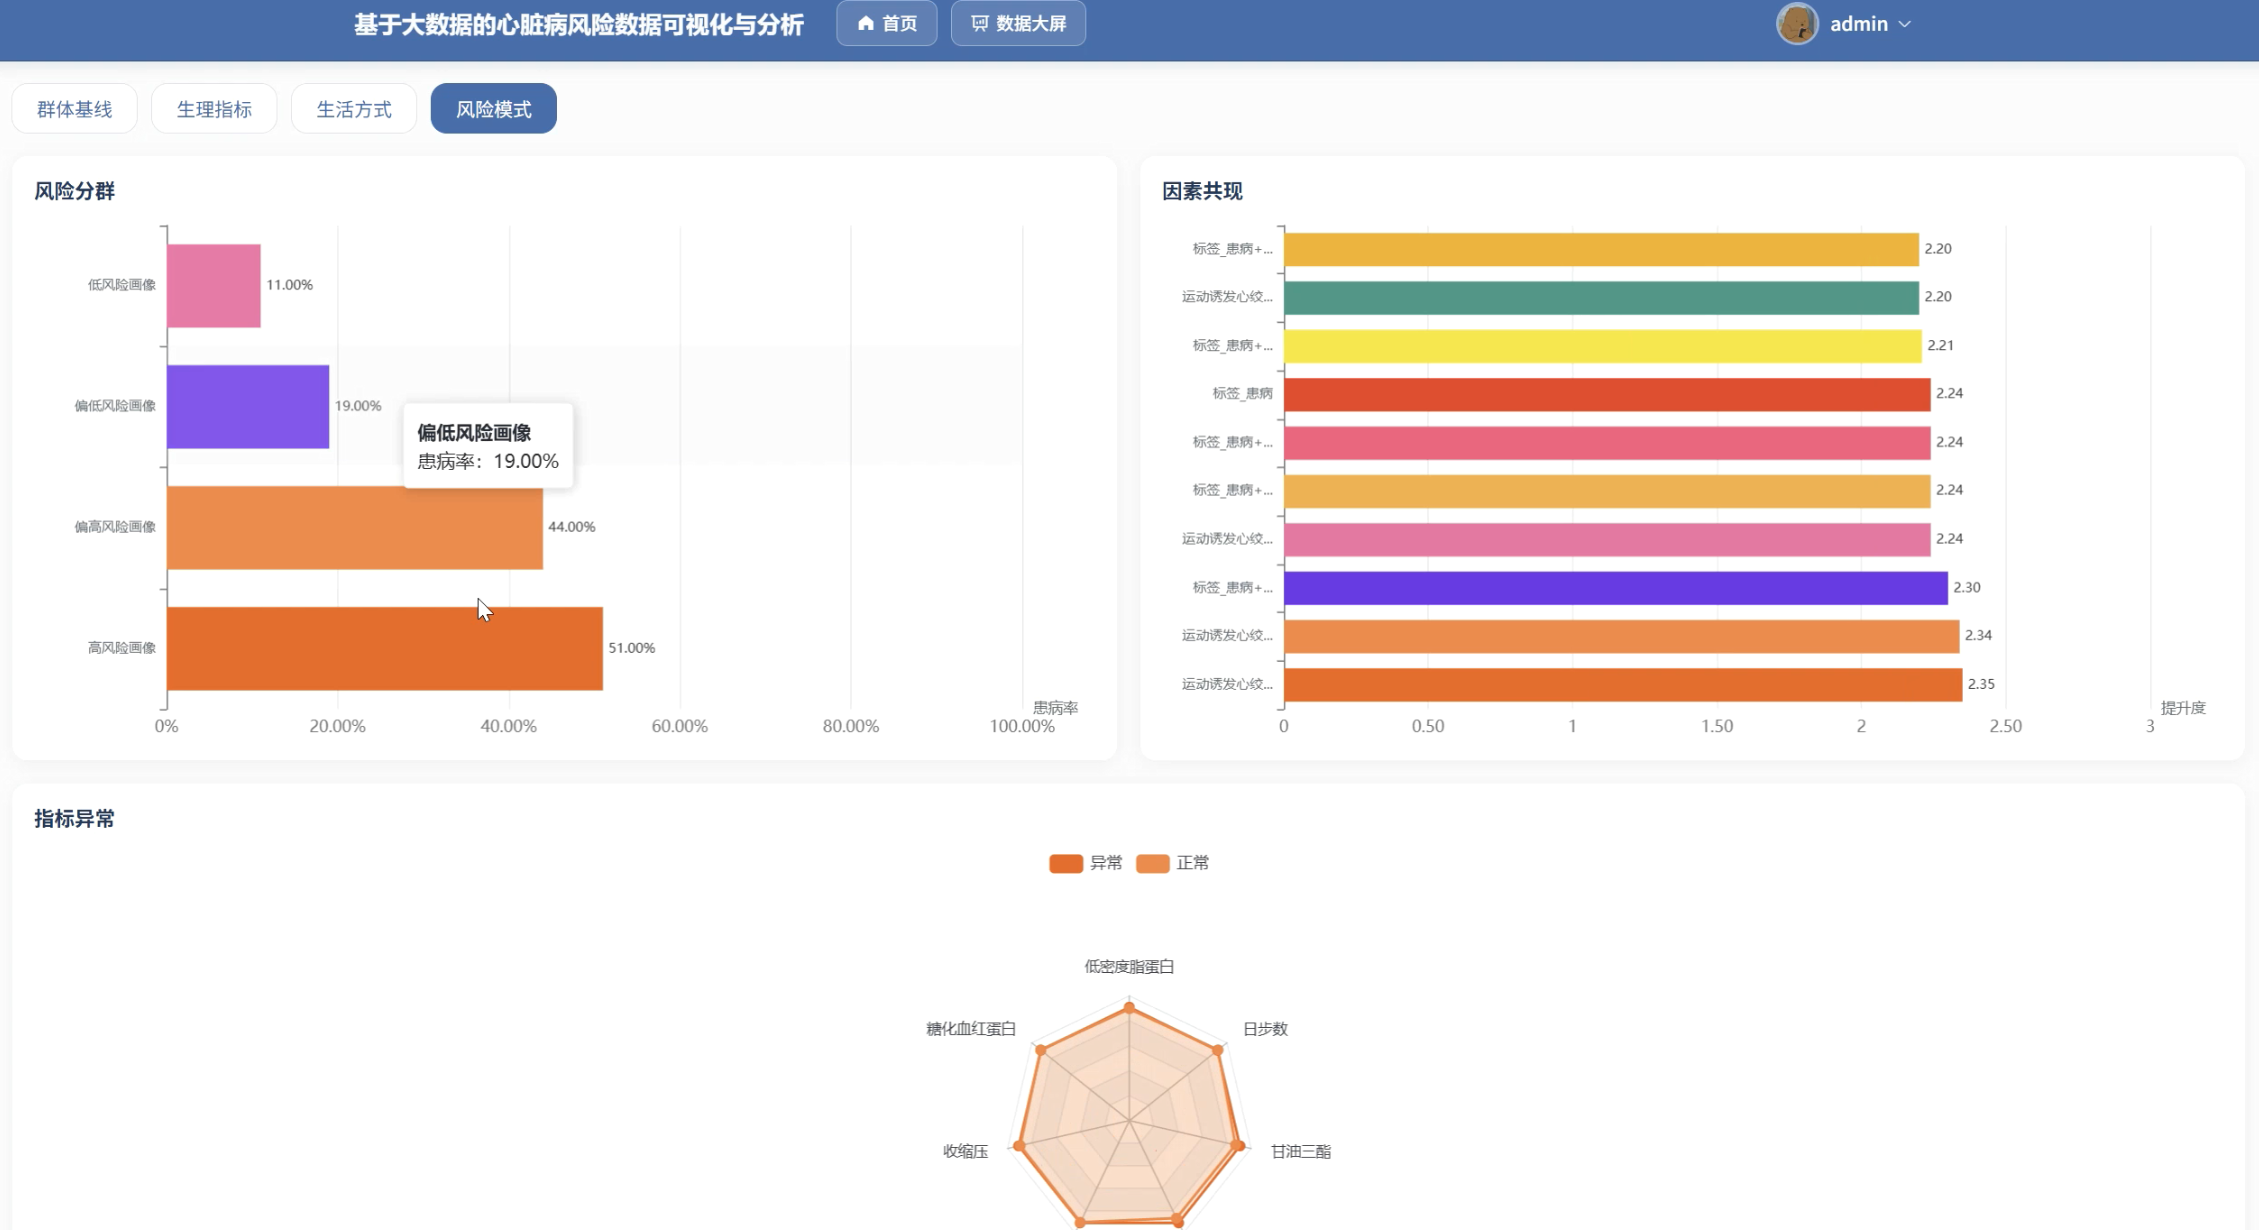
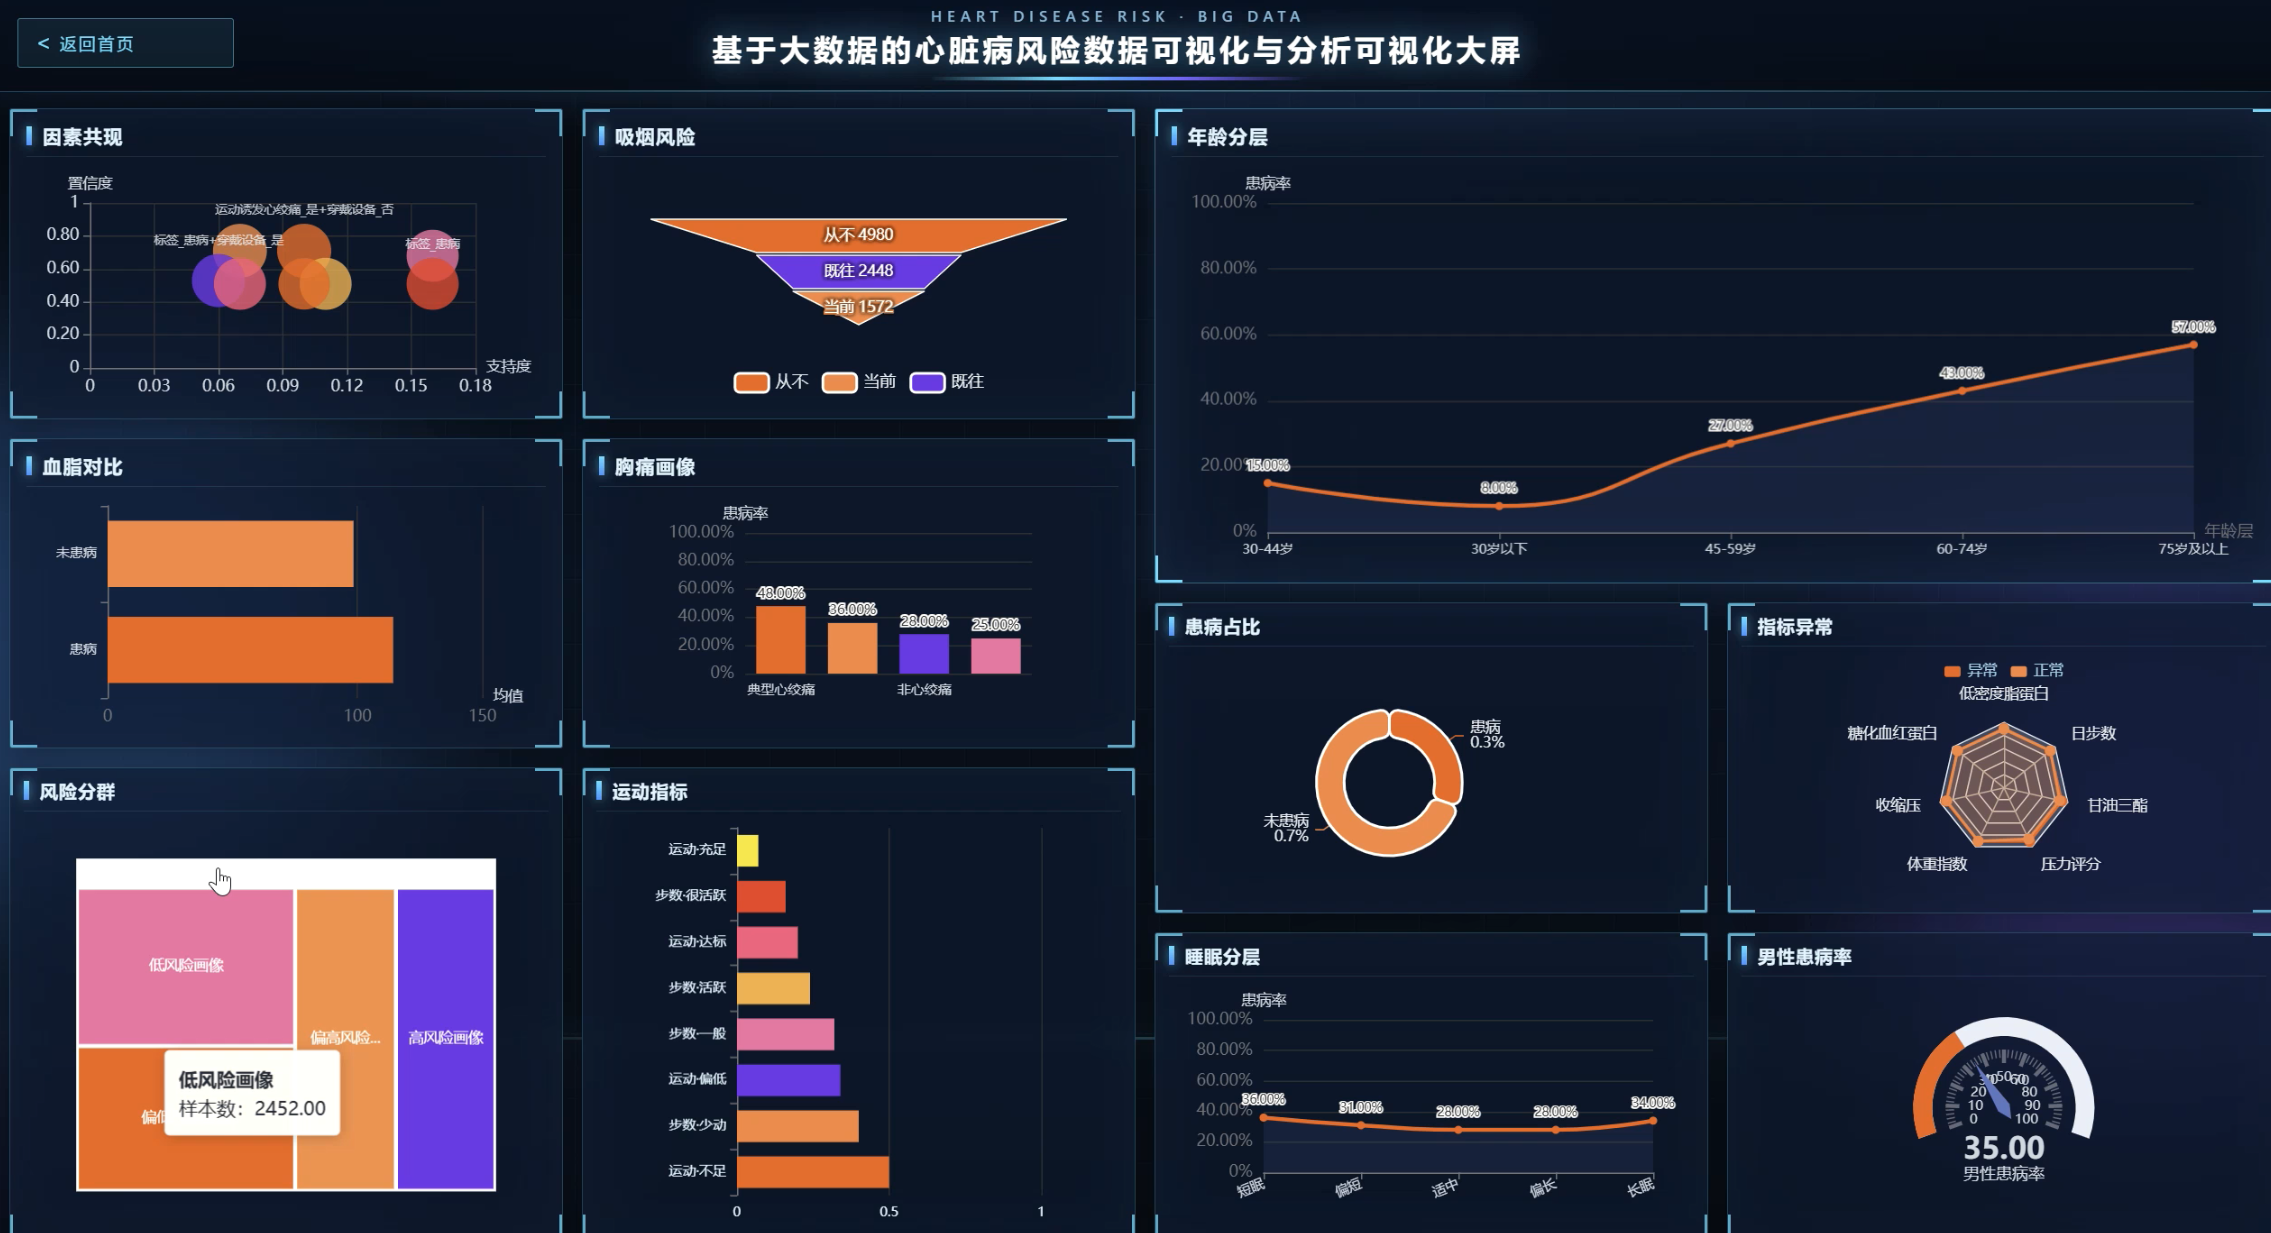
系统以 Hadoop HDFS 存原始数据,用 Python 做清洗与中文化映射,PySpark 完成 15 项统计分析,其中 K-Means 做风险人群分群、FP-Growth 挖因素共现规则、Isolation Forest 识别指标异常;分析结果入库 MySQL 后,由 Django 提供接口,Vue2 与 ECharts 做成 4 个专题分析页、单屏可视化大屏,以及患者体征数据的增删改查与登录、个人中心。
经过系统测试,本网站能把 9000 条样本的患病率基线、生理指标分层、生活方式对比和分群画像集中展示出来,方便计算机专业同学做毕设演示,也方便教师带学生看数据分析流程,还能给关注心脏健康的人群提供一个直观的指标查阅窗口,算得上一套"能跑通、能看懂"的医学大数据应用样例。
二、视频展示
计算机毕业设计选题推荐:基于大数据的心脏病风险数据分析
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
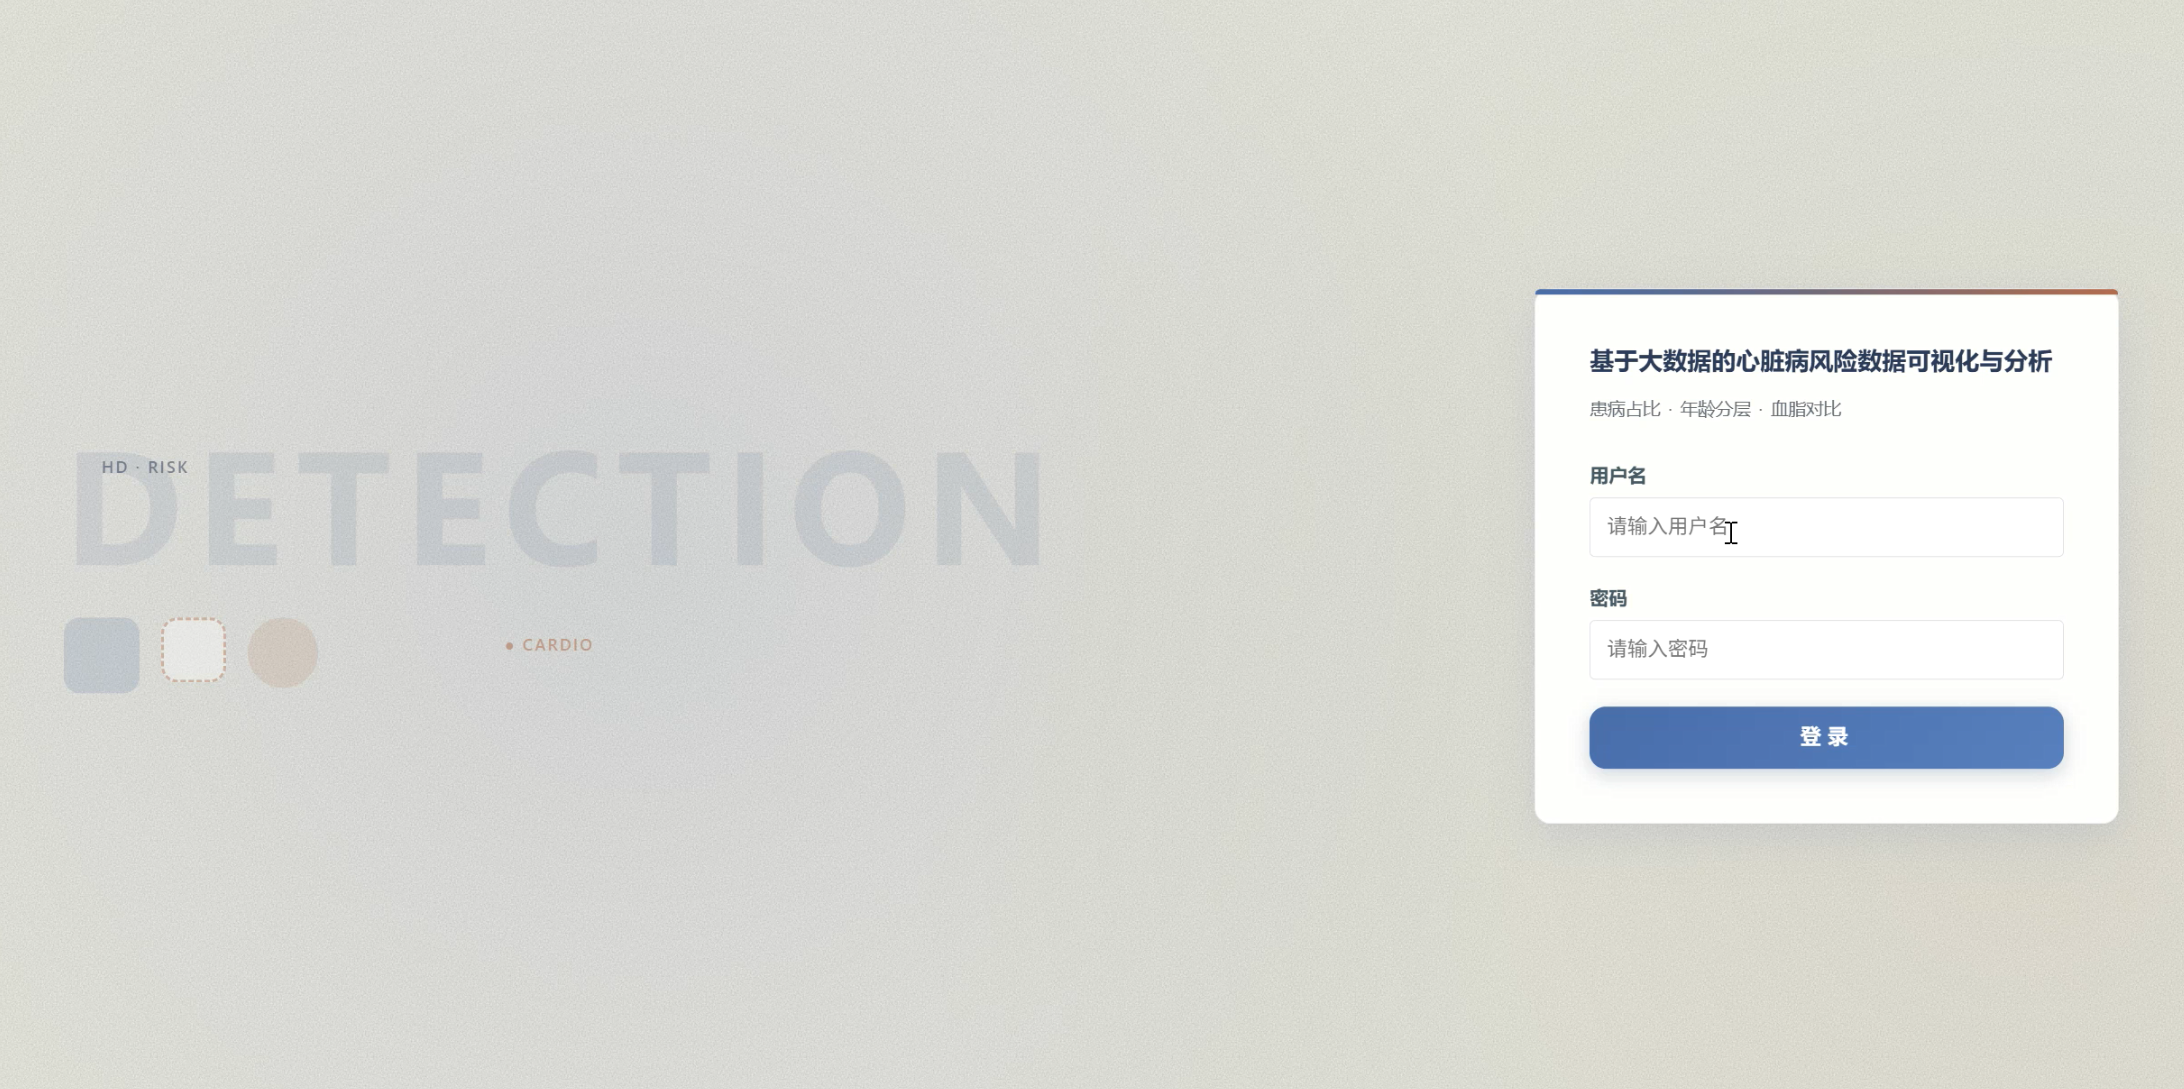
系统页面模块展示:
五、代码展示
bash
def factor_association_analysis(input_df):
    """离散风险因素项集的 FP-Growth 关联规则。"""
    items_df = input_df.select(
        F.array_distinct(
            F.array(
                F.concat(lit('吸烟_'), col('smoker_status').cast('string')),
                F.concat(lit('家族史_'), col('family_history').cast('string')),
                F.concat(lit('运动诱发心绞痛_'), col('exercise_induced_angina').cast('string')),
                F.concat(lit('胸痛_'), col('chest_pain_type').cast('string')),
                F.concat(lit('穿戴设备_'), col('wearable_owner').cast('string')),
                when(col('has_heart_disease') == 1, lit('标签_患病')).otherwise(lit('标签_未患病')),
            )
        ).alias('items')
    )

    fp = FPGrowth(itemsCol='items', minSupport=0.05, minConfidence=0.3)
    model = fp.fit(items_df)
    rules = model.associationRules

    # Spark 3.3 的 associationRules 无 support 列,用频繁项集频次 / 事务数补齐
    n_tx = float(input_df.count())
    freq = model.freqItemsets.withColumn(
        'full_items', sort_array(col('items'))
    ).select(col('full_items'), col('freq'))
    rules_enriched = (
        rules.withColumn(
            'full_items',
            sort_array(array_distinct(array_union(col('antecedent'), col('consequent')))),
        )
        .join(freq, on='full_items', how='left')
        .withColumn('support', spark_round(col('freq').cast('double') / lit(n_tx), 2))
    )

    top = (
        rules_enriched.withColumn('antecedent', F.concat_ws('+', col('antecedent')))
        .withColumn('consequent', F.concat_ws('+', col('consequent')))
        .withColumn('confidence', spark_round(col('confidence').cast('double'), 2))
        .withColumn('lift', spark_round(col('lift').cast('double'), 2))
        .select('antecedent', 'consequent', 'support', 'confidence', 'lift')
        .orderBy(col('lift').desc(), col('confidence').desc())
        .limit(50)
    )
    _save_local_csv(top, 'factor_association.csv')
    return top


def metric_outlier_summary_analysis(input_df):
    """Isolation Forest 标记异常/正常并对比指标均值。"""
    metric_cols = [
        'ldl', 'hba1c', 'resting_bp_systolic', 'bmi',
        'stress_score', 'triglycerides', 'daily_steps',
    ]
    work = input_df
    for c in metric_cols:
        work = work.withColumn(c, col(c).cast('double'))

    feat_pdf = work.select(*metric_cols).toPandas()

    from sklearn.ensemble import IsolationForest
    X = feat_pdf[metric_cols].astype(float).values
    clf = IsolationForest(n_estimators=200, contamination=0.08, random_state=42)
    preds = clf.fit_predict(X)  # 1=正常, -1=异常
    feat_pdf['is_outlier'] = (preds == -1)

    total = float(len(feat_pdf))
    rows = []
    for is_out, group_name in [(True, '异常'), (False, '正常')]:
        sub = feat_pdf[feat_pdf['is_outlier'] == is_out]
        cnt = int(len(sub))
        ratio = round(cnt / total, 2) if total else 0.0
        row = {'group': group_name, 'sample_count': cnt, 'ratio': ratio}
        for c in metric_cols:
            row[f'{c}_avg'] = round(float(sub[c].mean()) if cnt else 0.0, 2)
        rows.append(row)

    out_pdf = pd.DataFrame(rows)
    out_pdf.to_csv(str(LOCAL_OUT_DIR / 'metric_outlier_summary.csv'), encoding='utf-8', index=False)
    return out_pdf
六、项目文档展示

七、项目总结
本课题围绕心脏病风险相关数据,完成了从采集清洗、分布式计算到 Web 展示的一条龙建设。项目以 9000 条患者画像数据为基础,涵盖人口学、血脂血糖、血压心率、生活方式与穿戴设备等 27 个字段,先经 Python 完成类别中文化与辅助分箱,再上传 HDFS 供 PySpark 执行 15 项统计分析,其中 K-Means 实现多维风险人群分群,FP-Growth 挖掘吸烟、家族史等因素共现规则,Isolation Forest 识别指标异常样本,三类算法与常规分层统计相互补充,使分析不止停留在患病率对比。
分析结果导入 MySQL 后,后端以 Django 提供统一接口,前端采用 Vue2 与 ECharts 构建 4 个专题分析页和单屏可视化大屏,并配套患者体征数据的增删改查与登录、个人中心功能,形成"Spark 计算---数据入库---接口调用---图表呈现"的闭环。经系统测试,各分析模块数据加载正常,大屏与专题页图表渲染稳定,CRUD 功能可用。
本系统的意义在于:将分散的心脏病风险指标集中到一个可交互平台,方便计算机专业学生展示大数据处理与前后端开发能力,也为健康科普和教学演示提供直观参考。后续可在现有分析框架上扩展更多临床指标,或引入预测模型,进一步提升系统的实用价值。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖