摘要:Spark Streaming 的配置参数几十个,但真正需要你动手调的就那么几个,剩下的调错了反而添乱。这篇把参数按功能分六类,重点讲五个高频参数(blockInterval、反压、concurrentJobs、unpersist、stopGracefully)的默认值、什么时候该动、以及动了之后会踩的坑。
关键词:Spark Streaming, 配置参数, blockInterval, 反压, concurrentJobs, unpersist
一、参数不少,但别乱调
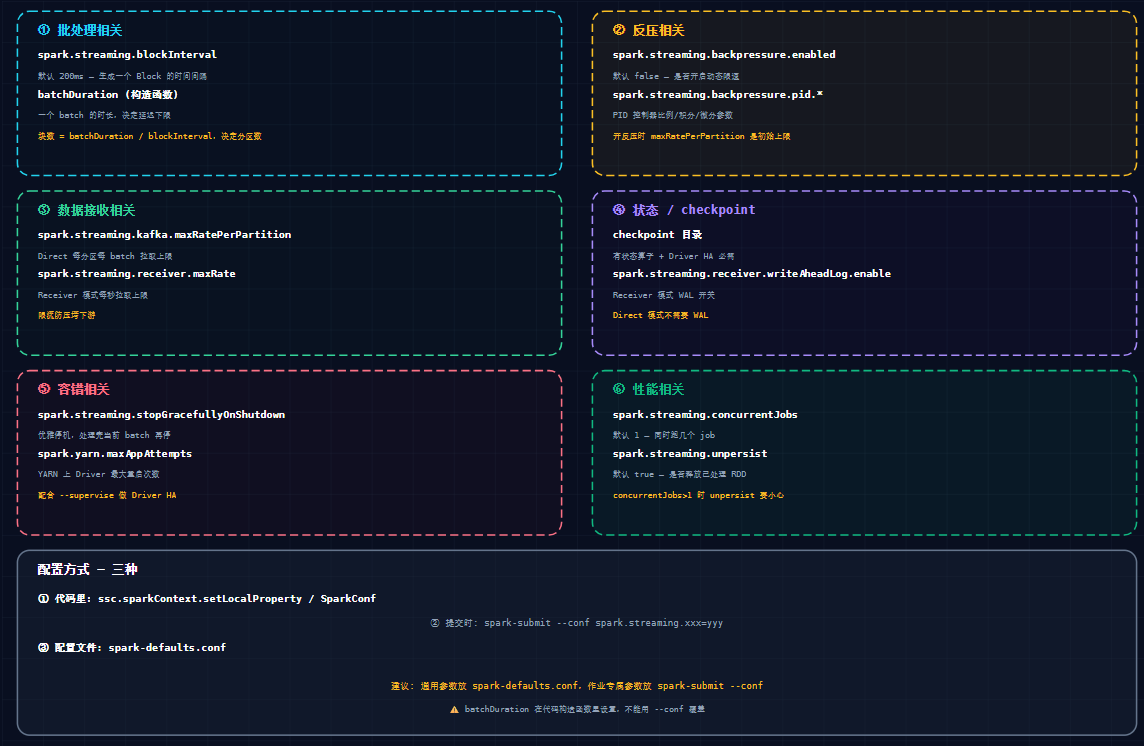
先给个总判断:Spark Streaming 的大部分参数有合理的默认值,没搞清楚作用之前别乱动。真正需要你关心的,是下面这五个和"吞吐、延迟、稳定性"直接相关的参数,以及它们的配合关系。
参数配置有三种方式:
bash
# ① 提交时(作业专属参数用这个)
spark-submit --conf spark.streaming.xxx=yyy ...

# ② 配置文件(通用参数放这里)
spark-defaults.conf

# ③ 代码里(batchDuration 只能在这里)
val ssc = new StreamingContext(conf, Seconds(2))注意:batchDuration 在构造函数里设置,不能用 --conf 覆盖,这是很多人试了没效果的原因。
二、blockInterval:Receiver 模式的分区开关
spark.streaming.blockInterval 默认 200ms,它决定"多久生成一个 Block"。而 Block 数直接决定分区数:
分区数 = batchDuration / blockInterval比如 batchDuration=2s、blockInterval=200ms,一个 batch 就有 10 个 Block、10 个分区。
坑:吞吐小的时候,如果 blockInterval 设得太小,会产生一大堆小 Block,调度开销反而比处理开销还大。反过来吞吐大时,可以把它调小(200ms→100ms)让分区更多、并行度更高。
判断 :这是 Receiver 模式的参数。Direct 模式下分区数由 Kafka 分区数决定,blockInterval 调了没意义。
三、反压:backpressure.enabled
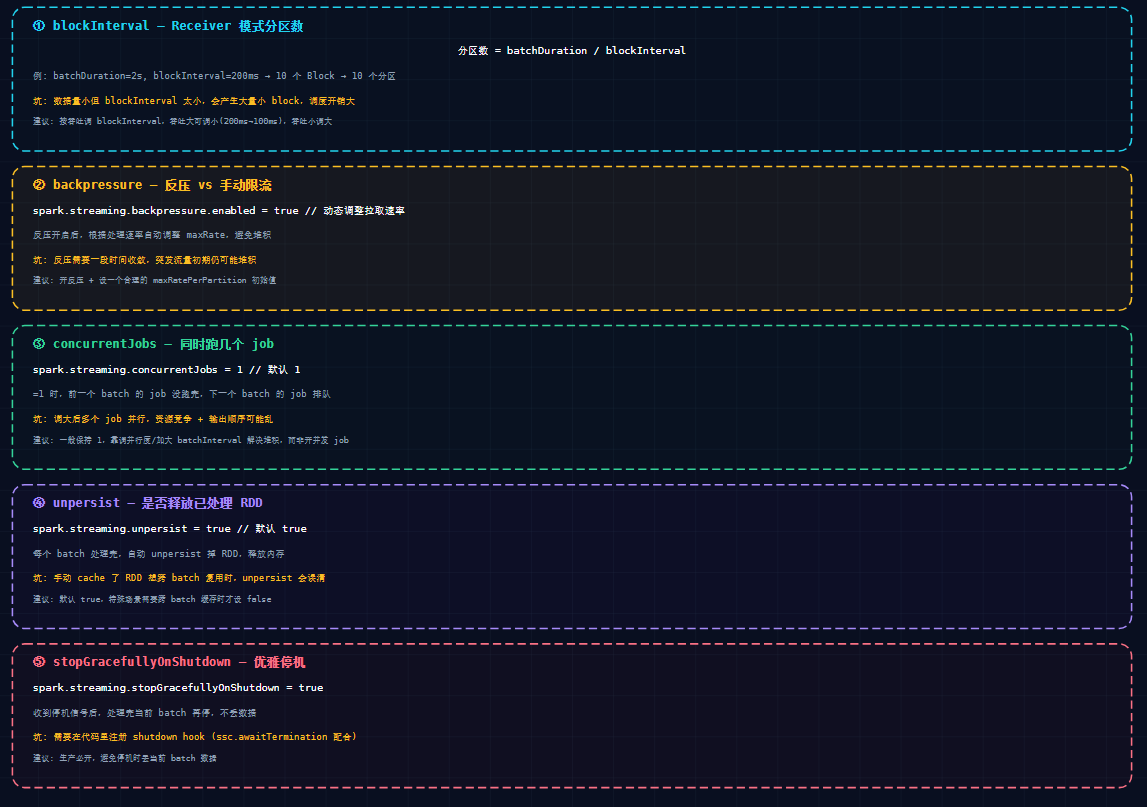
默认 false。开启后,Spark 会根据当前批处理速度动态调整拉取速率,避免数据在内存里越积越多。
bash
spark.streaming.backpressure.enabled = true
spark.streaming.kafka.maxRatePerPartition = 10000   # 初始上限
坑 :反压不是瞬时生效的,它靠 PID 控制器逐步收敛,突发流量涌进来的初期仍可能堆积。所以别指望开了反压就一劳永逸,还是得配合一个合理的 maxRatePerPartition 初始值兜底。
判断 :处理能力波动大的场景开反压;处理能力稳定的场景,手动设 maxRatePerPartition 就够了。
四、concurrentJobs:别靠它解决堆积
默认 1,即同一时刻只跑一个 batch 的 job。当前一个 batch 没处理完,后一个 batch 的 job 排队等。
有些人的第一反应是"堆积了就把 concurrentJobs 调大,让多个 batch 并行"。这通常是个坑:
- 多个 job 并行会抢同一批 Executor 资源,单个 job 反而更慢;
- 输出顺序可能乱,有状态场景(如 updateStateByKey)语义会出问题。
判断 :堆积了,正确解法是加 Kafka 分区/加 executor 核数/调大 batchInterval,而不是开并发 job。concurrentJobs 默认 1 保持不动。
五、unpersist:内存回收
默认 true,每个 batch 处理完自动 unpersist 掉 RDD,释放内存。这是好事,绝大多数情况保持默认。
坑 :如果你手动 cache 了某个 RDD 想跨 batch 复用,默认的 unpersist 会把它误清掉,导致下个 batch 重算。真有这种跨 batch 缓存的需求,才需要把它设成 false------但这种情况很少,遇到时先想想是不是设计有问题。
六、stopGracefullyOnShutdown:优雅停机
默认 false。设成 true 后,应用收到停机信号会先处理完当前 batch 再停,不丢数据。
bash
spark.streaming.stopGracefullyOnShutdown = true坑:光设这个参数还不够,代码里得配合 shutdown hook 才能生效:
scala
sys.addShutdownHook {
  ssc.stop(stopSparkContext = true, stopGracefully = true)
}
ssc.start()
ssc.awaitTermination()判断:生产环境必开。否则每次停机(发版、扩容)都可能丢当前 batch 正在处理的数据。
七、其余几类,各挑重点
按功能分六类,剩下的快速过一遍:
- 数据接收 :
maxRatePerPartition(Direct 每分区限流)、receiver.maxRate(Receiver 每秒上限)。 - 状态/checkpoint :checkpoint 目录(有状态算子 + Driver HA 必需)、
receiver.writeAheadLog.enable(Receiver 模式 WAL,Direct 用不上)。 - 容错 :
spark.yarn.maxAppAttempts(YARN 上 Driver 最大重启次数,配合--supervise)。
八、总结
- 参数不少,但真正要动的就五个:blockInterval、反压、concurrentJobs、unpersist、stopGracefully。
- blockInterval 决定 Receiver 模式分区数,Direct 模式调了没用。
- 反压有收敛延迟,得配合 maxRatePerPartition 兜底。
- 堆积了别开 concurrentJobs,正确解法是加并行度或调大 batchInterval。
- unpersist 默认 true,跨 batch 缓存才改 false;stopGracefully 生产必开,但要配 shutdown hook。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践