✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!也可以在主页上或文末下与博主交流~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
多源社交媒体心理健康情感分析与可视化系统-简介
基于Hadoop的多源社交媒体心理健康情感分析与可视化系统是一套面向海量社交文本的大数据分析平台,旨在通过分布式计算技术洞察网络群体的心理健康趋势。系统底层依托Hadoop生态,利用HDFS实现多源数据的可靠存储,计算层全面拥抱Spark与Spark SQL,通过内存计算大幅提升数据聚合与挖掘的效率,并辅以Pandas与NumPy进行局部数据清洗与数值特征派生。后端采用Django框架提供高并发的数据接口服务,前端基于Vue结合ElementUI构建响应式管理后台,并深度集成Echarts实现柱状图、饼图、散点图等多种图表的动态渲染。在具体业务功能上,系统划分了三大核心分析维度共18个分析点。情感状态分析模块负责处理status字段,执行状态总量排名、七态占比计算、高危文本比识别与焦虑抑郁比对比,同时引入归一化信息熵计算七态离散度,并通过常态偏离比量化压力面分布。文本特征分析模块针对statement字段展开,对文本长度与词元规模进行分档统计,计算长短文本差与状态均长比,并结合TF算法提取高频词权重;在无监督学习方面,系统提取文本数值特征并运用K-Means算法进行主题词聚类,同时基于PySpark MLlib的FP-Growth算法挖掘症状共现链,发现潜在的情绪关联规则。多源对照分析模块则综合mh_combined_posts与student_anxiety_posts两个数据源,开展双源体量比、均长比与焦虑阳性比计算,通过双源标签映射与短帖焦虑比分析,对比不同平台群体的情绪表达特征。整个系统将复杂的大数据挖掘算法与直观的前端可视化图表结合,为心理健康领域的社交网络文本研究提供了一套完整的技术落地实践。
多源社交媒体心理健康情感分析与可视化系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
多源社交媒体心理健康情感分析与可视化系统-背景
现在的互联网环境里,大家在社交媒体上表达情绪已经成了常态,各种平台上每天都积攒了海量的帖子。很多年轻人在遇到心理压力或者情绪起伏的时候,更倾向于在网上倾诉,这就让社交媒体成了一个巨大的情绪资料库。面对这么庞大的文本数据,单靠传统的一台服务器去跑处理程序,不仅速度慢得让人着急,还经常容易卡死崩掉。咱们在做计算机相关的毕业设计时,要想把这些多源的心理健康发帖数据真正利用起来,就得找个能扛住大数据量的框架。Hadoop和Spark这套大数据生态正好能解决这个问题,它们能把海量文本拆开存、分布式算,效率高很多。所以我就想着结合当下大家关注的网络心理健康话题,用这套大数据技术搭一个能自动处理、分析并展示多源社交媒体情感状态的系统,看看能不能从数据里找到一些有价值的情绪规律。
做这个系统其实挺有现实意义的。对咱们计算机专业的学生来说,能把书本上的Hadoop、Spark这些大数据理论真正落地跑起来,特别是用K-Means和FP-Growth算法去处理真实的社交文本,这本身就是一个很好的工程实践锻炼,比只做个普通的增删改查系统要有料得多。从实际应用角度看,系统能把杂乱的多源发帖数据整理成直观的图表,像高危文本占比、焦虑抑郁情绪对比这些指标,看一眼就能大概了解网络群体的心理状态分布。虽然这仅仅是个毕业设计,没法跟专业机构的心理干预系统比,但它提供了一种用数据视角去观察心理健康问题的思路。通过分析不同状态的文本长度和症状共现关系,或许能给高校或者心理研究者在做群体情绪调研时提供一点数据上的参考,帮他们更快定位到哪些话题背后藏着高风险情绪,这也是咱们做技术的一点小愿景吧。
多源社交媒体心理健康情感分析与可视化系统-视频展示
基于Hadoop的多源社交媒体心理健康情感分析与可视化系统
多源社交媒体心理健康情感分析与可视化系统-图片展示
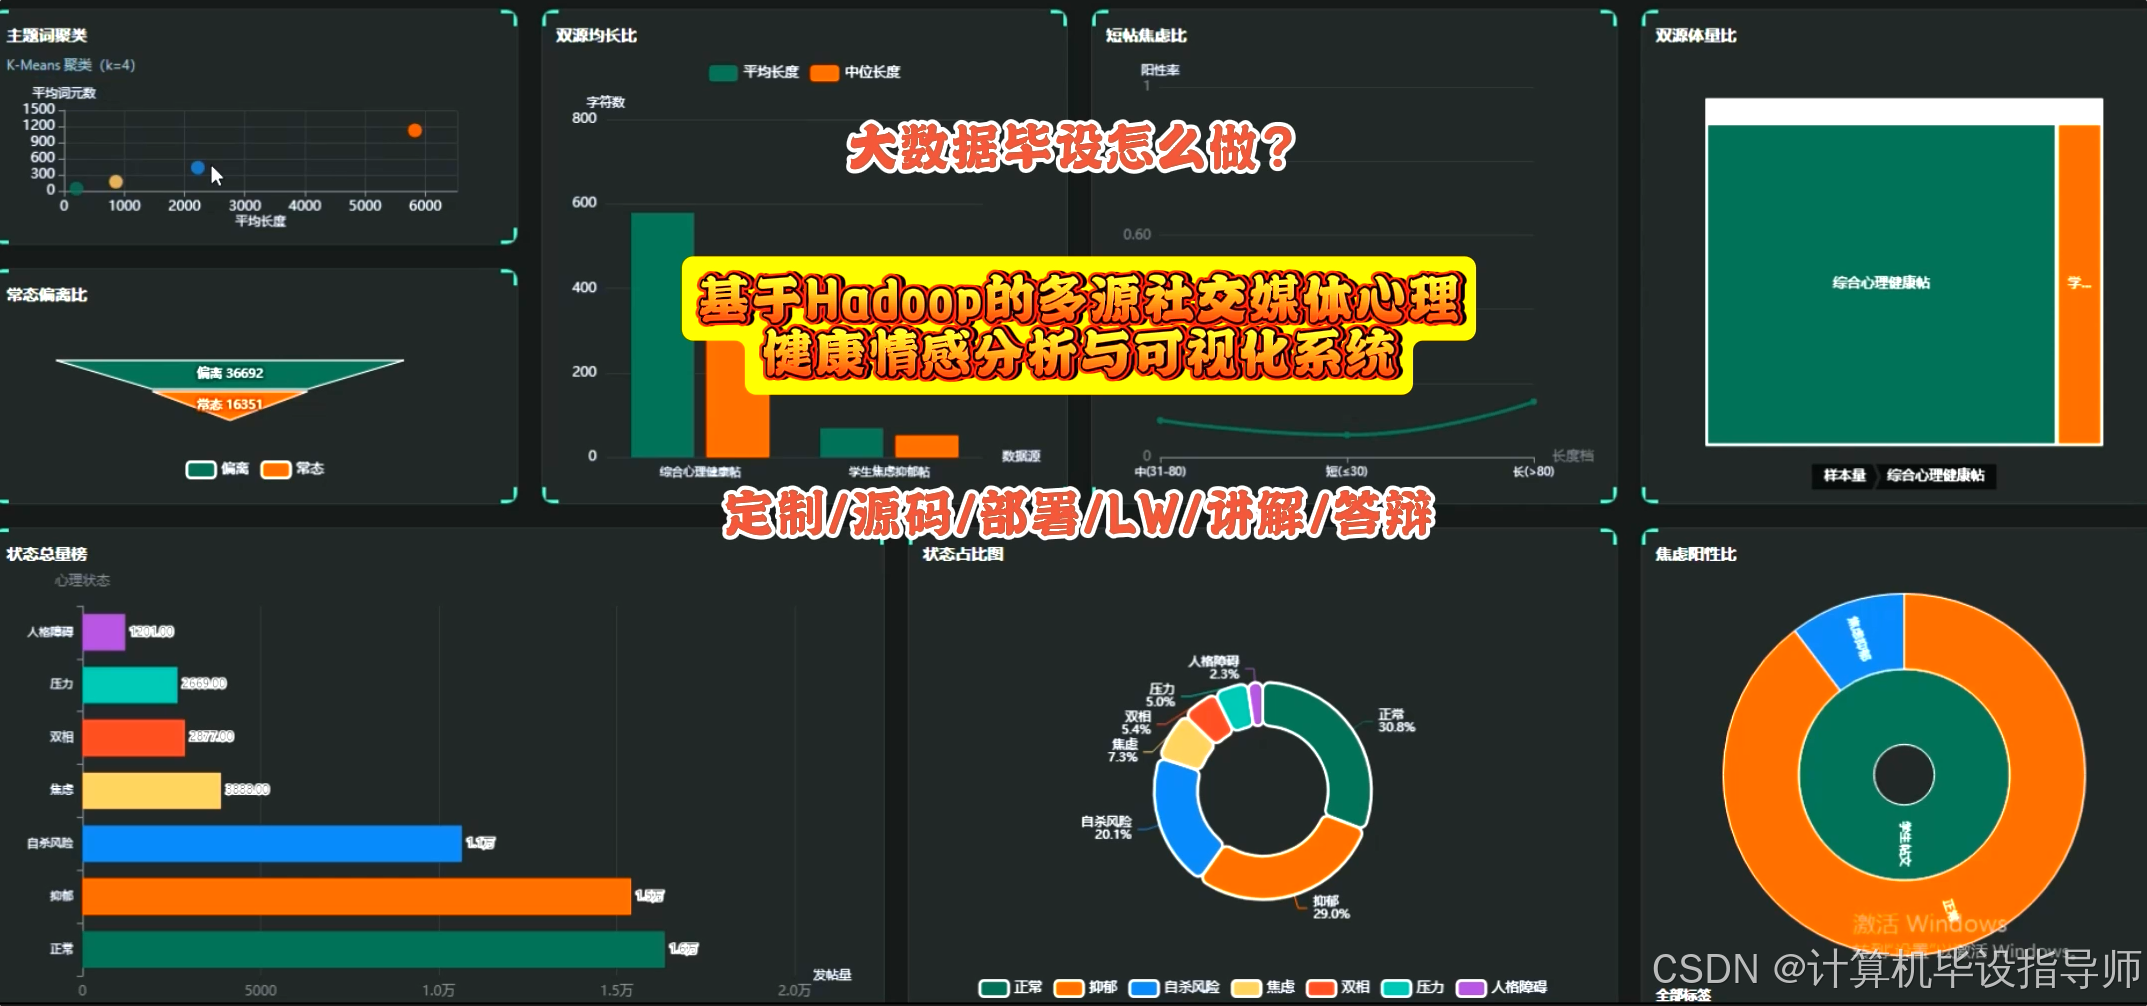
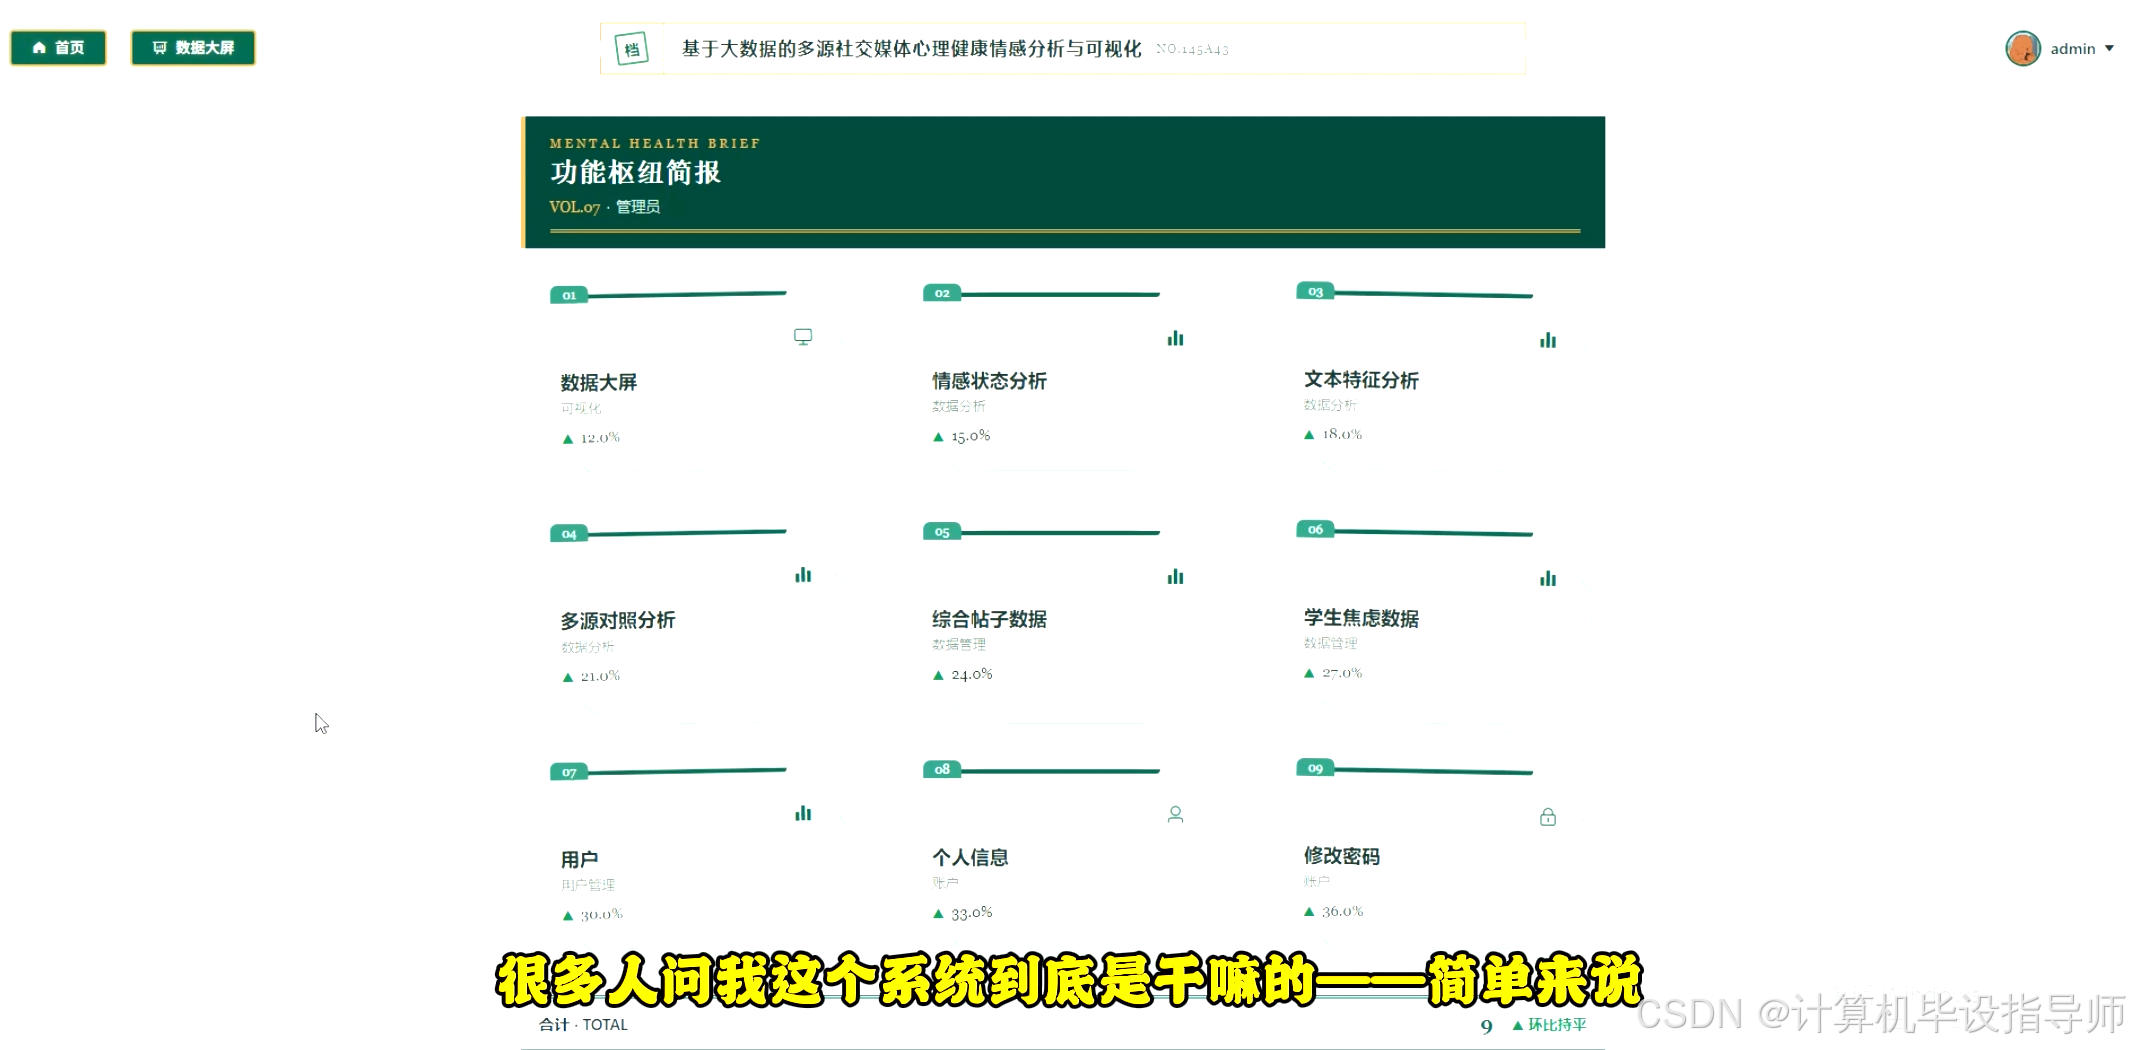
多源社交媒体心理健康情感分析与可视化系统-代码展示
python
spark = SparkSession.builder.appName("MentalHealthSentimentAnalysis").master("local[*]").getOrCreate()
df_posts = spark.read.csv("hdfs://localhost:9000/data/mh_combined_posts.csv", header=True, inferSchema=True)
def calculate_status_entropy(spark_df):
    total_count = spark_df.count()
    status_counts = spark_df.groupBy("status").count()
    status_counts = status_counts.withColumn("probability", col("count") / lit(total_count))
    status_counts = status_counts.withColumn("prob_log", log2(col("probability")))
    status_counts = status_counts.withColumn("prob_mul", col("probability") * col("prob_log"))
    status_counts = status_counts.na.fill(0)
    entropy_val = status_counts.agg(sum(col("prob_mul")).alias("entropy")).collect()[0]["entropy"]
    entropy_val = -entropy_val
    max_entropy = log2(7)
    norm_entropy = entropy_val / max_entropy
    pandas_df = pd.DataFrame({"entropy": [entropy_val], "norm_entropy": [norm_entropy], "n_classes": [7]})
    pandas_df['entropy'] = np.round(pandas_df['entropy'], 4)
    pandas_df['norm_entropy'] = np.round(pandas_df['norm_entropy'], 4)
    result_df = spark.createDataFrame(pandas_df)
    result_df.coalesce(1).write.mode("overwrite").csv("output/MentalHealthSentiment_analysis/status_entropy.csv", header=True)
    return result_df
def perform_text_kmeans(spark_df):
    filtered_df = spark_df.filter(col("statement").isNotNull())
    cleaned_df = filtered_df.withColumn("clean_text", lower(trim(col("statement"))))
    cleaned_df = cleaned_df.withColumn("char_len", length(col("clean_text")))
    tokenizer = Tokenizer(inputCol="clean_text", outputCol="words")
    w_data = tokenizer.transform(cleaned_df)
    hashingTF = HashingTF(inputCol="words", outputCol="raw_features", numFeatures=100)
    featurized_data = hashingTF.transform(w_data)
    idf = IDF(inputCol="raw_features", outputCol="features")
    idf_model = idf.fit(featurized_data)
    rescaled_data = idf_model.transform(featurized_data)
    kmeans = KMeans(k=4, seed=1, featuresCol="features", predictionCol="cluster_id")
    model = kmeans.fit(rescaled_data)
    clustered_data = model.transform(rescaled_data)
    cluster_summary = clustered_data.groupBy("cluster_id", "status").count()
    window_spec = Window.partitionBy("cluster_id").orderBy(col("count").desc())
    dominant_status = cluster_summary.withColumn("rank", row_number().over(window_spec)).filter(col("rank") == 1).drop("rank")
    avg_len_df = clustered_data.groupBy("cluster_id").agg(avg("char_len").alias("avg_len"))
    final_cluster_df = dominant_status.join(avg_len_df, "cluster_id")
    final_cluster_df.coalesce(1).write.mode("overwrite").csv("output/MentalHealthSentiment_analysis/text_kmeans_clusters.csv", header=True)
    return final_cluster_df
def extract_symptom_fp_growth(spark_df):
    keyword_list = ["anxiety", "depression", "suicidal", "stress", "lonely", "fear", "panic"]
    def extract_keywords(text):
        if text is None: return []
        words = text.lower().split()
        valid_words = [word for word in words if word in keyword_list]
        return valid_words
    extract_udf = udf(extract_keywords, ArrayType(StringType()))
    base_df = spark_df.filter(col("statement").isNotNull())
    transactions_df = base_df.withColumn("items", extract_udf(col("statement"))).filter(size(col("items")) > 0)
    fp_growth = FPGrowth(itemsCol="items", minSupport=0.02, minConfidence=0.5)
    fp_model = fp_growth.fit(transactions_df)
    freq_itemsets = fp_model.freqItemsets
    association_rules = fp_model.associationRules
    filtered_rules = association_rules.filter(col("confidence") > 0.6)
    sorted_itemsets = freq_itemsets.orderBy(col("freq").desc())
    pandas_itemsets = sorted_itemsets.toPandas()
    pandas_rules = filtered_rules.toPandas()
    combined_pd = pd.merge(pandas_itemsets.head(10), pandas_rules, left_on="items", right_on="antecedent", how="left")
    result_df = spark.createDataFrame(combined_pd.dropna())
    result_df.coalesce(1).write.mode("overwrite").csv("output/MentalHealthSentiment_analysis/symptom_fp_growth.csv", header=True)
    return result_df
calculate_status_entropy(df_posts)
perform_text_kmeans(df_posts)
extract_symptom_fp_growth(df_posts)
多源社交媒体心理健康情感分析与可视化系统-结语
做计算机毕设卡壳了不知道从哪下手?别慌,这套系统的思路和实现过程我都在文章里掰开了讲,希望能帮你理清方向,如果内容对你有帮助,别忘了点赞、收藏、关注支持一下,你的鼓励就是我持续输出的动力。有具体的技术问题,欢迎直接在评论区提出来,看到都会回复。架构怎么搭、数据怎么跑、模块怎么调,咱们公开讨论,一起把计算机毕设顺利搞定!
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得点赞、收藏,再点个关注,学习不迷路!~~