随着企业AI化转型不断深入,越来越多业务团队需要理解神经网络的基本原理,以便在技术选型、模型调优和跨部门沟通中做出更合理的判断。本文将从神经元模型出发,系统介绍激活函数与多层感知机(MLP)的工作原理,帮助读者建立对前馈神经网络的基础认知。
一、神经元模型
一个基本的人工神经元可以看作一个计算单元,其计算过程如下:
z=∑i=1nwixi+bz =i =1∑nwixi +b a=f(z)a =f (z)
其中,xixi 是输入信号,wiwi 是对应权重,bb 是偏置,zz 是加权和,也叫净输入,f(⋅)f (⋅) 是激活函数,aa 是神经元输出。
如果没有激活函数,无论网络有多少层,最终都只是输入的线性组合,无法拟合复杂的非线性关系。因此,激活函数是神经网络具备强大表达能力的关键。
二、常见激活函数
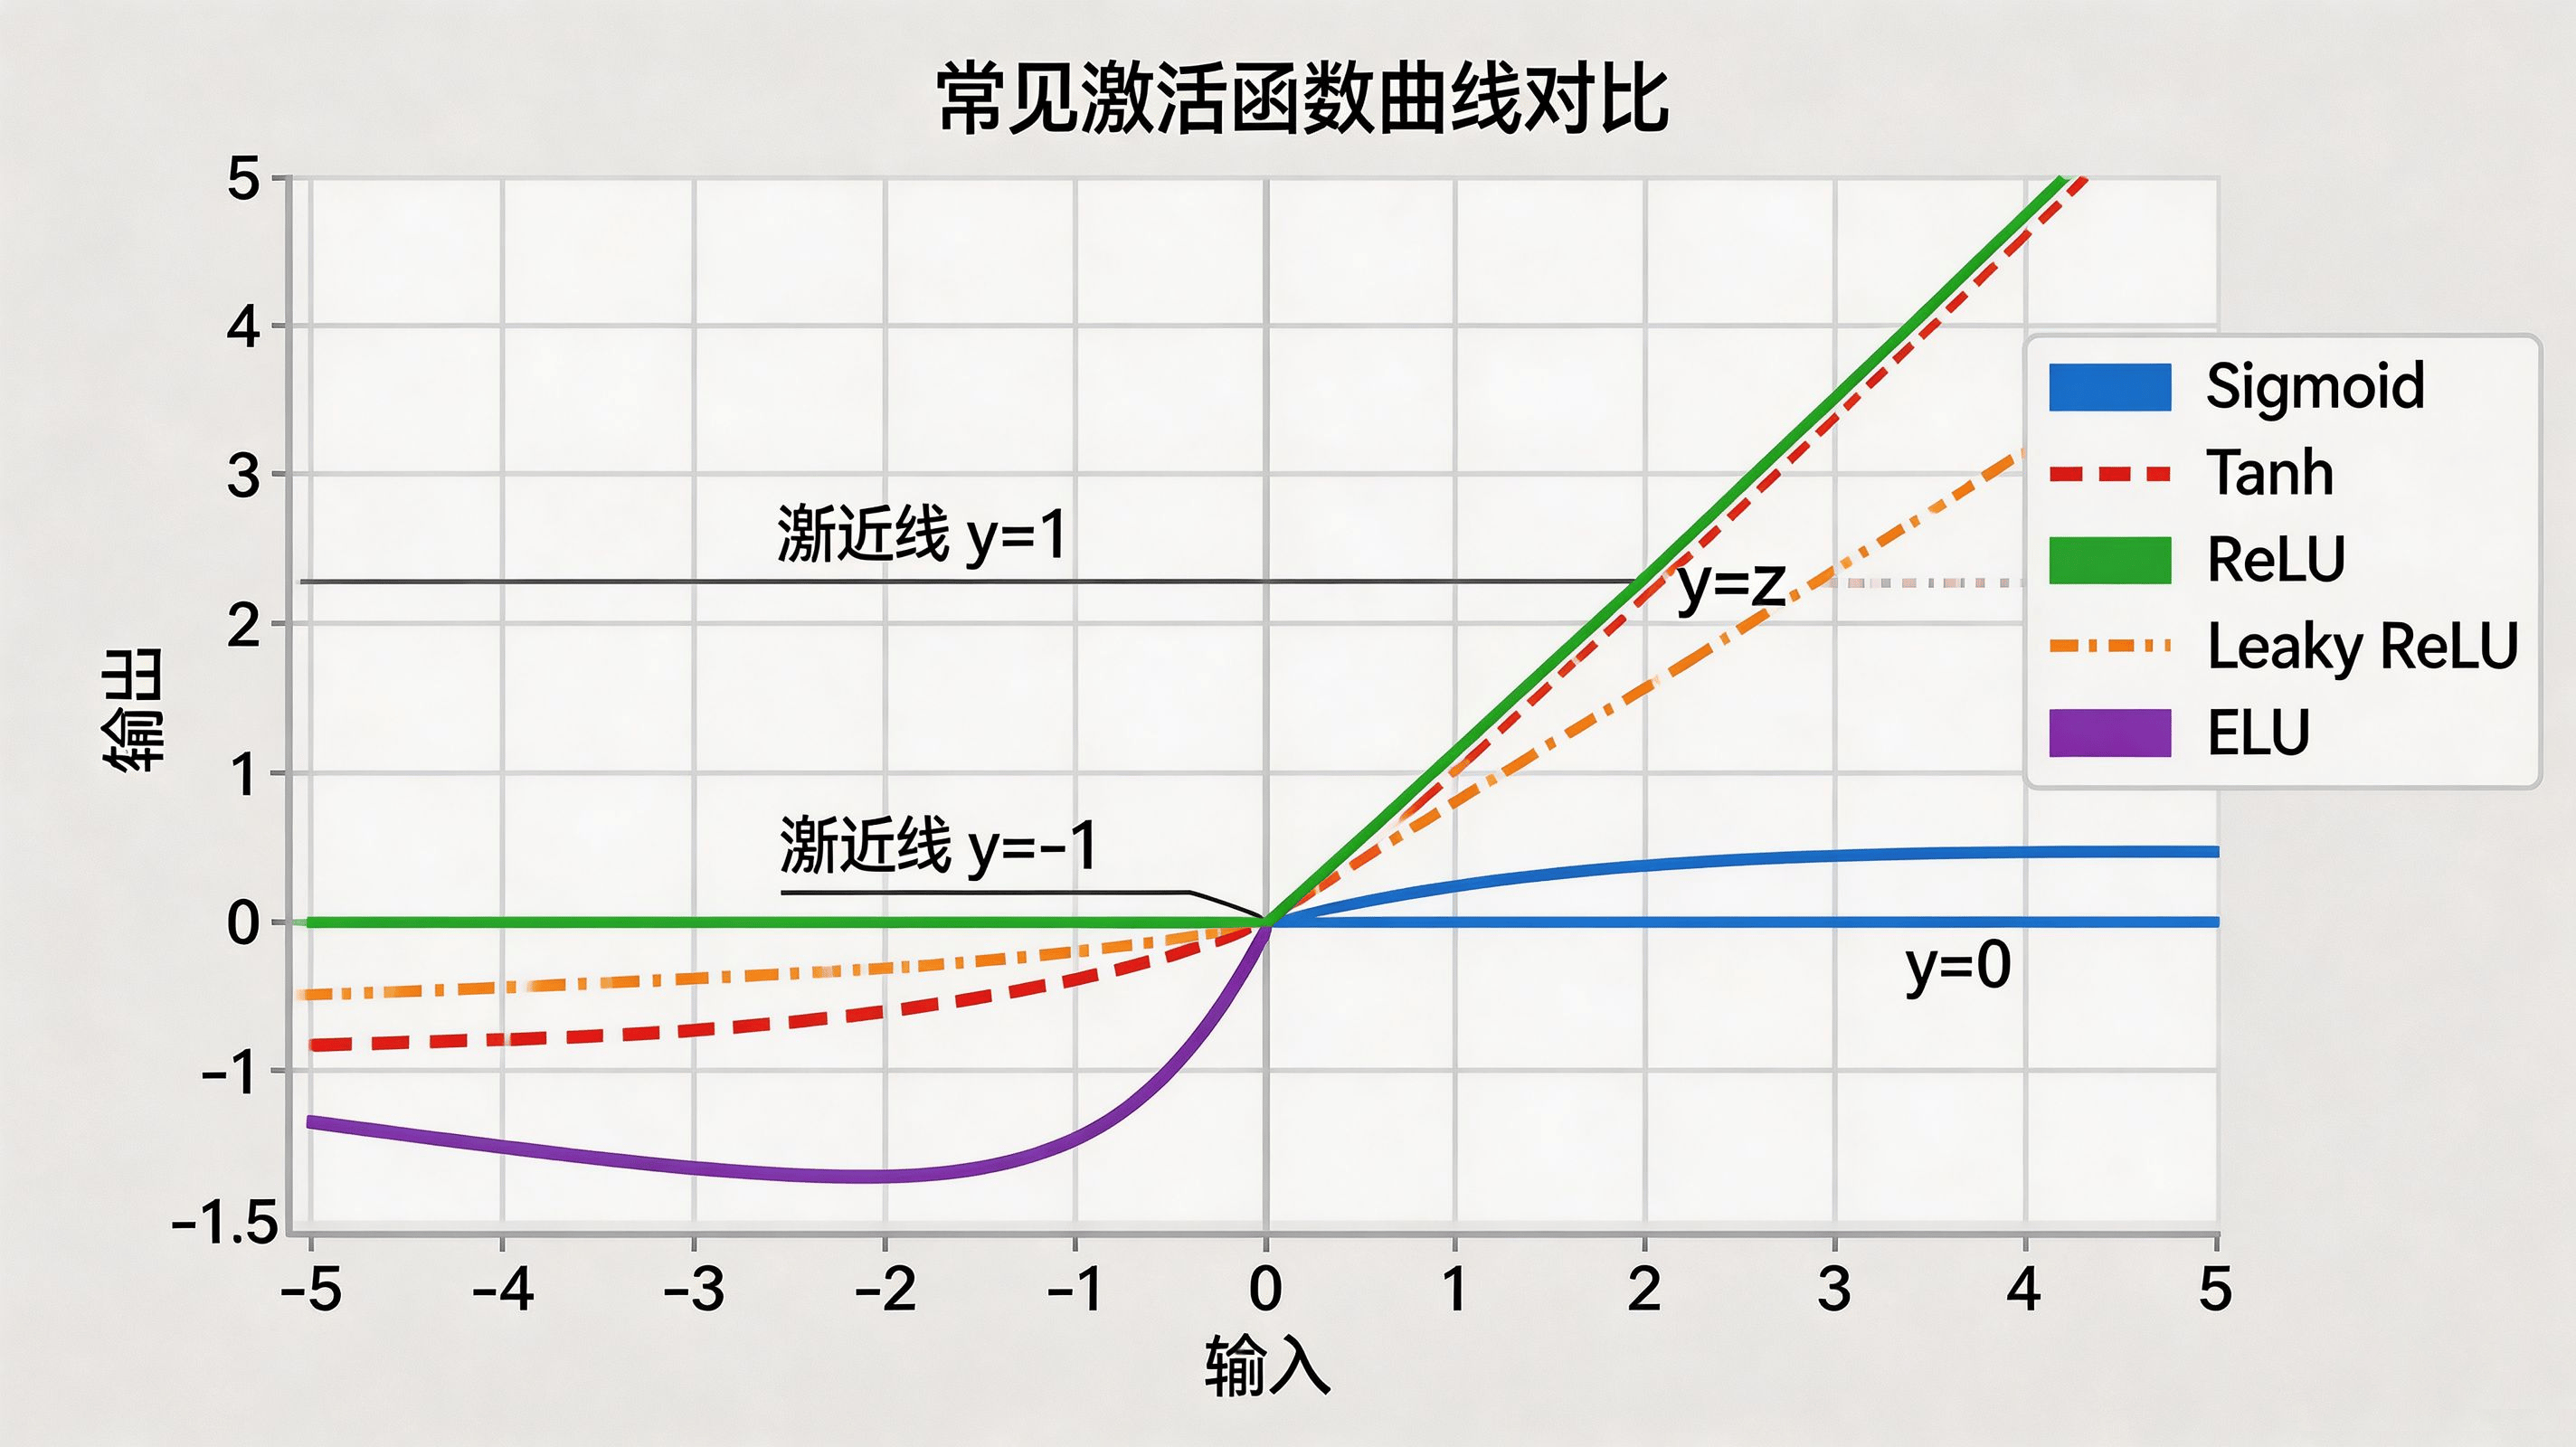
激活函数的作用是引入非线性,使神经网络能够学习复杂函数。以下是几种常见激活函数的对比。
其中,Softmax 通常用于多分类输出层,所有输出之和为1,可解释为类别概率。ReLU 及其变体在隐藏层中使用最为广泛,因其计算简单且能缓解梯度消失。
三、MLP 原理
MLP(多层感知机)是最基本的前馈神经网络结构,由输入层、隐藏层和输出层组成,层与层之间全连接。
1. 前向传播
以一个隐藏层为例,输入 xx 经过隐藏层计算:
z1=W1x+b1z 1=W 1x +b 1a1=f1(z1)a 1=f 1(z1)
输出层计算:
z2=W2a1+b2z 2=W 2a 1+b 2y^=a2=f2(z2)y ^=a 2=f 2(z2)
其中,WlW *l* 是第 ll 层权重矩阵,blb *l* 是偏置向量,flf *l* 是激活函数。
2. 损失函数
根据任务类型选择损失函数。回归问题常用均方误差:
L=1m∑i=1m(y^i−yi)2L =m 1i =1∑m (y ^i −yi)2
二分类常用交叉熵:
L=−1m∑i=1myilogy\^i+(1−yi)log(1−y\^i)L =−m 1i =1∑m *yi* log*y* \^*i* +(1−*yi* )log(1−*y* \^*i*)
多分类则使用多分类交叉熵。
3. 反向传播与参数更新
反向传播利用链式法则计算损失函数对每个参数的梯度。以输出层为例:
∂L∂W2=∂L∂a2⋅∂a2∂z2⋅∂z2∂W2∂W 2∂L =∂a 2∂L ⋅∂z 2∂a 2⋅∂W 2∂z2
然后继续向前传播到隐藏层,最后使用梯度下降更新参数:
Wl:=Wl−η∂L∂WlW *l* :=W *l* −η ∂W *l* ∂L bl:=bl−η∂L∂blb *l* :=b *l* −η ∂b *l* ∂L
其中 ηη 是学习率。
四、激活函数在 MLP 中的作用
如果 MLP 中所有激活函数都是线性的,例如 f(z)=zf (z )=z,那么整个网络等价于一个线性模型:
y^=W2(W1x+b1)+b2=(W2W1)x+(W2b1+b2)y ^=W 2(W 1x +b 1)+b 2=(W 2W 1)x +(W 2b 1+b2)
无论多少层,都只是一个线性变换,无法解决非线性问题。引入非线性激活函数后,MLP 可以通过增加隐藏层神经元数量来逼近任意连续函数,这就是万能近似定理。
五、全文总结与AI未来展望
总体来看,激活函数为神经网络引入非线性,MLP通过前向传播与反向传播完成从输入到输出的映射学习。理解这些基础原理,是深入掌握深度学习的重要一步。未来,随着自动机器学习、稀疏化训练和新一代激活函数的发展,神经网络将更高效、更易解释。对企业AI化转型而言,扎实的基础认知将帮助团队更理性地评估技术方案,避免盲目跟风,推动AI能力真正落地到业务场景中。
常见问题FAQ
1. 为什么神经网络需要激活函数?
如果没有激活函数,多层网络只是输入的线性组合,无法拟合非线性关系。激活函数引入非线性,使网络能逼近复杂函数,解决分类、回归等实际问题。
2. ReLU为什么比Sigmoid常用?
ReLU计算简单,正区间梯度恒为1,能缓解梯度消失,收敛更快。但负区间梯度为0,可能导致神经元死亡,可用Leaky ReLU等变体缓解。
3. Softmax和Sigmoid有什么区别?
Sigmoid用于二分类,输出单个概率;Softmax用于多分类,输出多个类别概率且和为1,适合互斥类别。二分类也可用Softmax两个节点,但Sigmoid更简洁。
4. MLP能解决哪些问题?
MLP通过非线性激活和足够隐藏层神经元,理论上能逼近任意连续函数,可用于回归、分类、特征提取等任务,适合结构化数据建模。
5. 什么是梯度消失?
在深层网络中,Sigmoid或Tanh饱和区导数接近0,反向传播时梯度连乘迅速变小,导致前层参数更新缓慢。ReLU及其变体可部分缓解该问题。