Hadoop高可用集群与OpenStack Mitaka控制节点部署实操复盘
%E6%96%87%E7%AB%A0%E7%9B%AE%E5%BD%95
- [Hadoop高可用集群与OpenStack Mitaka控制节点部署实操复盘](#Hadoop高可用集群与OpenStack Mitaka控制节点部署实操复盘)
-
- 一、ZooKeeper三节点集群部署
-
- [1.1 安装包准备与节点规划](#1.1 安装包准备与节点规划)
- [1.2 zoo.cfg核心配置](#1.2 zoo.cfg核心配置)
- [1.3 各节点myid配置](#1.3 各节点myid配置)
- [1.4 集群启动与角色验证](#1.4 集群启动与角色验证)
- [二、HDFS HA高可用集群部署](#二、HDFS HA高可用集群部署)
-
- [2.1 核心配置文件修改](#2.1 核心配置文件修改)
- [2.2 启动JournalNode集群](#2.2 启动JournalNode集群)
- [2.3 NameNode格式化与元数据同步](#2.3 NameNode格式化与元数据同步)
- [2.4 启动HDFS集群与进程验证](#2.4 启动HDFS集群与进程验证)
- [2.5 HA状态验证与DataNode启动](#2.5 HA状态验证与DataNode启动)
- 三、HDFS自动故障切换验证
- [四、YARN HA高可用部署](#四、YARN HA高可用部署)
-
- [4.1 MapReduce配置](#4.1 MapReduce配置)
- [4.2 YARN核心配置](#4.2 YARN核心配置)
- [4.3 踩坑:协议不支持报错](#4.3 踩坑:协议不支持报错)
- [4.4 YARN故障切换验证](#4.4 YARN故障切换验证)
- [4.5 NodeManager端口占用排错](#4.5 NodeManager端口占用排错)
- [4.6 节点重复注册与ZK宕机排错](#4.6 节点重复注册与ZK宕机排错)
- [4.7 Web界面最终验证](#4.7 Web界面最终验证)
- [五、OpenStack Mitaka控制节点基础环境](#五、OpenStack Mitaka控制节点基础环境)
-
- [5.1 虚拟机与网络配置](#5.1 虚拟机与网络配置)
- [5.2 系统基础优化](#5.2 系统基础优化)
- [5.3 配置离线YUM源](#5.3 配置离线YUM源)
- 六、基础依赖服务部署
-
- [6.1 MariaDB数据库](#6.1 MariaDB数据库)
- [6.2 RabbitMQ消息队列](#6.2 RabbitMQ消息队列)
- [6.3 Memcached缓存](#6.3 Memcached缓存)
- 七、Keystone身份服务部署
-
- [7.1 创建Keystone数据库](#7.1 创建Keystone数据库)
- [7.2 安装初始化与Apache配置](#7.2 安装初始化与Apache配置)
- [7.3 管理员身份验证](#7.3 管理员身份验证)
- [7.4 项目、用户与角色创建](#7.4 项目、用户与角色创建)
- 八、核心踩坑点汇总
- 九、实操总结
本次实操分为两大模块:先基于ZooKeeper搭建三节点协调集群,在此基础上完成HDFS HA与YARN HA全栈高可用部署,并验证自动故障切换;后半段从零搭建OpenStack Mitaka控制节点基础环境,完成数据库、消息队列等依赖服务部署,以及Keystone身份服务全流程验证。全程踩坑不少,下面按操作顺序完整复盘。
一、ZooKeeper三节点集群部署
ZooKeeper是后续Hadoop高可用的核心协调组件,负责主备选举、状态存储,先把这一层搭稳。
1.1 安装包准备与节点规划
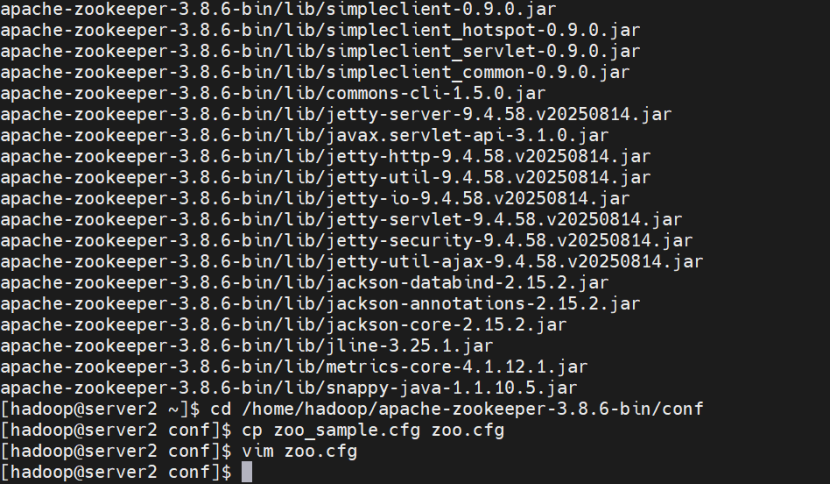
使用apache-zookeeper-3.8.6-bin版本,解压后lib目录包含jetty、jackson、metrics等全部依赖。规划3台ZK节点:server2、server3、server4,对应myid分别为1、2、3。
1.2 zoo.cfg核心配置
在server2节点进入conf目录,复制样例配置为正式文件:
cd /home/hadoop/apache-zookeeper-3.8.6-bin/conf
cp zoo_sample.cfg zoo.cfg
vim zoo.cfg
在文件末尾追加三节点集群配置,2888为数据同步端口,3888为Leader选举端口:
server.1=server2:2888:3888
server.2=server3:2888:3888
server.3=server4:2888:3888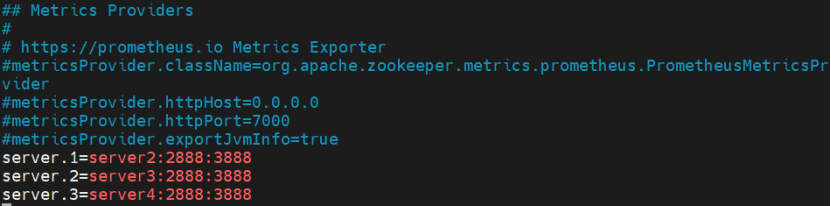
1.3 各节点myid配置
ZK每个节点需要唯一的myid文件,和配置中的server序号一一对应。
-
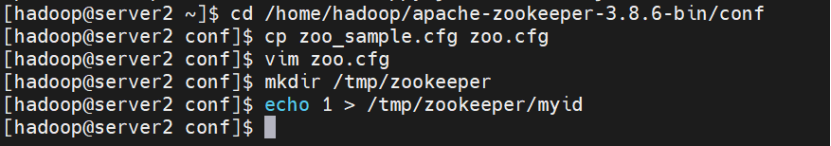
server2节点:
mkdir /tmp/zookeeper
echo 1 > /tmp/zookeeper/myid
-
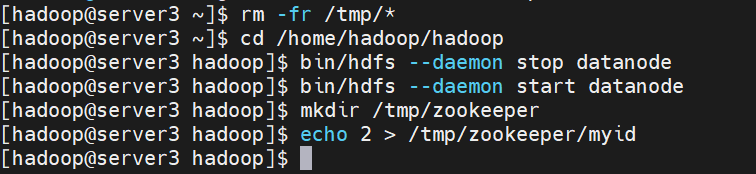
server3节点:先清理临时目录,再写入myid=2
rm -fr /tmp/*
mkdir /tmp/zookeeper
echo 2 > /tmp/zookeeper/myid
-
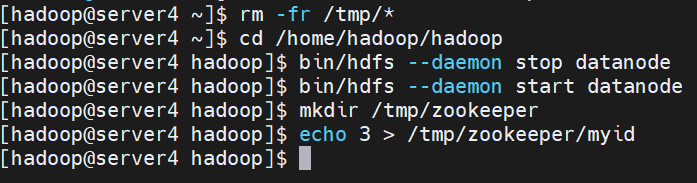
server4节点:同理写入myid=3
rm -fr /tmp/*
mkdir /tmp/zookeeper
echo 3 > /tmp/zookeeper/myid
1.4 集群启动与角色验证
依次在三个节点启动ZK服务,查看节点角色:
-
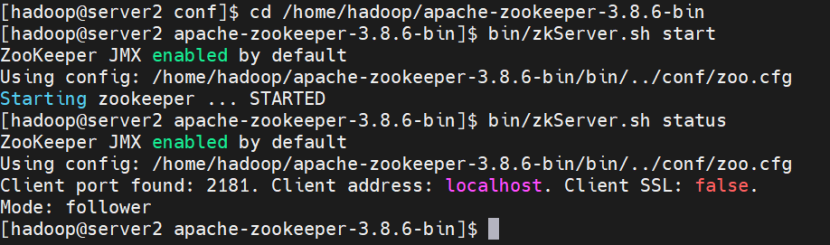
server2启动后为follower:
cd /home/hadoop/apache-zookeeper-3.8.6-bin
bin/zkServer.sh start
bin/zkServer.sh status
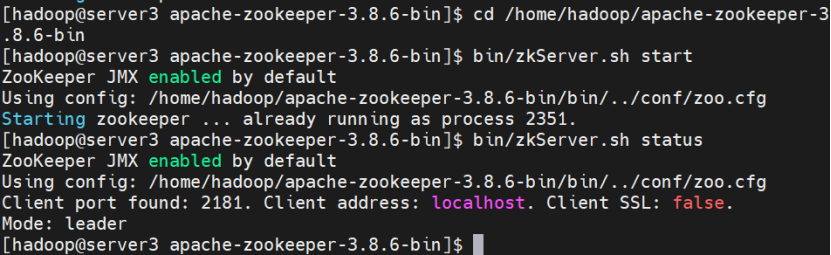
- server3启动后当选为leader:
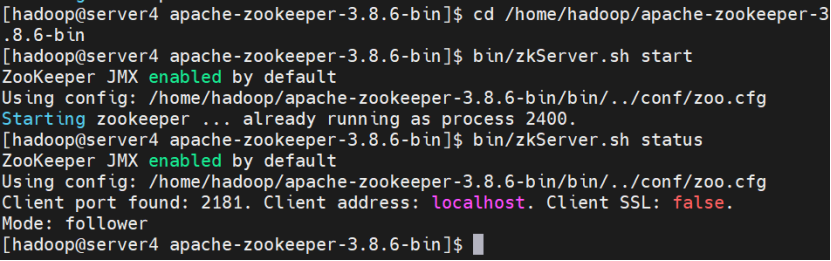
- server4启动后为follower:
也可以通过nc命令批量查看所有节点运行模式,不用逐个登录:
echo stat | nc server2 2181 | grep Mode
echo stat | nc server3 2181 | grep Mode
echo stat | nc server4 2181 | grep Mode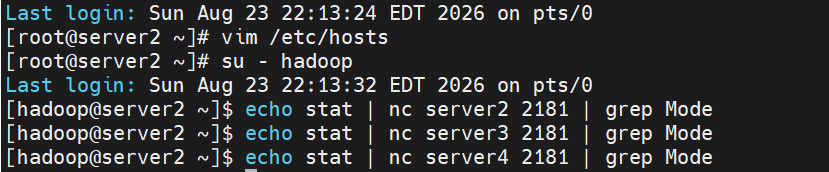
原理说明:ZK采用过半选举机制,3节点集群2台正常即可选出主节点。server2先启动时只有1台无法选主,server3启动后满足过半条件当选leader,server4后续加入只能作为follower,完全符合选举逻辑。
二、HDFS HA高可用集群部署
ZK就绪后,开始配置HDFS高可用:两个NameNode一主一备,JournalNode同步编辑日志,ZKFC配合ZK实现自动故障切换。
2.1 核心配置文件修改
core-site.xml
指定HDFS逻辑集群名masters,配置ZK集群地址用于HA选举:
<configuration>
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://masters</value>
  </property>
  <property>
    <name>ha.zookeeper.quorum</name>
    <value>server2:2181,server3:2181,server4:2181</value>
  </property>
</configuration>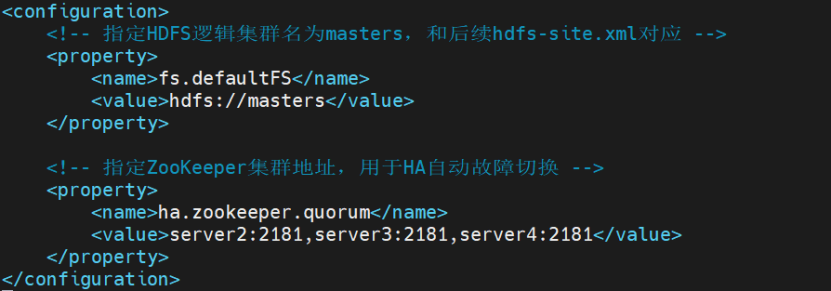
hdfs-site.xml
第一部分声明命名服务、两个NameNode的RPC和Web地址:
<configuration>
  <property>
    <name>dfs.replication</name>
    <value>3</value>
  </property>
  <property>
    <name>dfs.nameservices</name>
    <value>masters</value>
  </property>
  <property>
    <name>dfs.ha.namenodes.masters</name>
    <value>h1,h2</value>
  </property>
  <property>
    <name>dfs.namenode.rpc-address.masters.h1</name>
    <value>server1:9000</value>
  </property>
  <property>
    <name>dfs.namenode.http-address.masters.h1</name>
    <value>server1:9870</value>
  </property>
  <property>
    <name>dfs.namenode.rpc-address.masters.h2</name>
    <value>server5:9000</value>
  </property>
  <property>
    <name>dfs.namenode.http-address.masters.h2</name>
    <value>server5:9870</value>
  </property>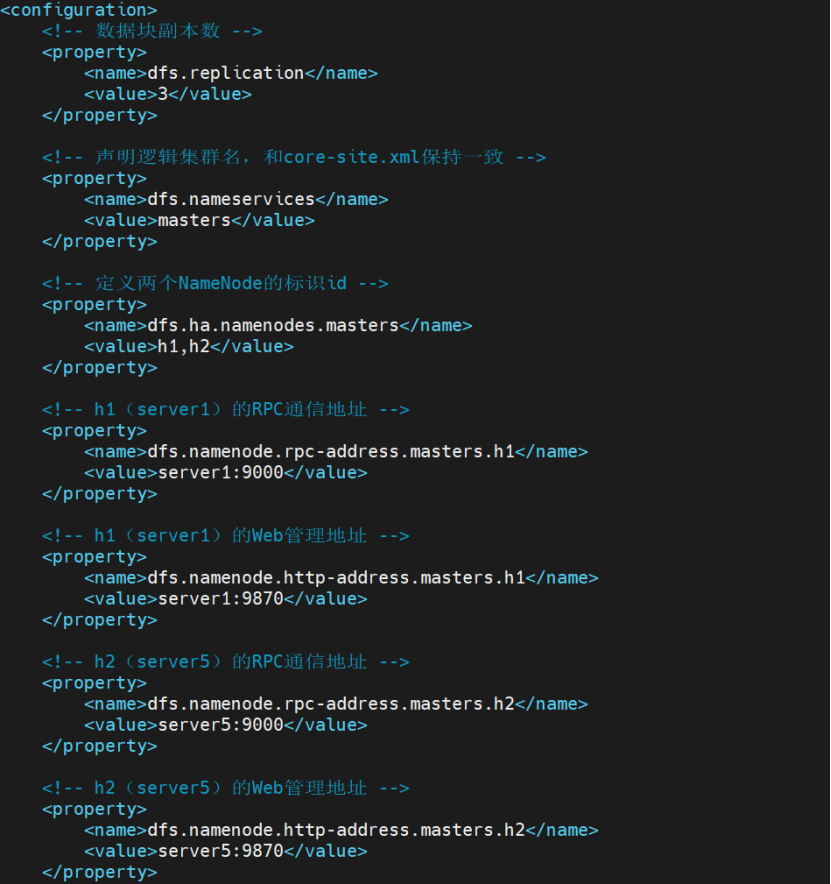
第二部分配置JournalNode、自动故障切换和脑裂防护:
  <property>
    <name>dfs.namenode.shared.edits.dir</name>
    <value>qjournal://server2:8485;server3:8485;server4:8485/masters</value>
  </property>
  <property>
    <name>dfs.journalnode.edits.dir</name>
    <value>/tmp/journaldata</value>
  </property>
  <property>
    <name>dfs.ha.automatic-failover.enabled</name>
    <value>true</value>
  </property>
  <property>
    <name>dfs.client.failover.proxy.provider.masters</name>
    <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
  </property>
  <property>
    <name>dfs.ha.fencing.methods</name>
    <value>
      sshfence
      shell(/bin/true)
    </value>
  </property>
  <property>
    <name>dfs.ha.fencing.ssh.private-key-files</name>
    <value>/home/hadoop/.ssh/id_rsa</value>
  </property>
  <property>
    <name>dfs.ha.fencing.ssh.connect-timeout</name>
    <value>30000</value>
  </property>
</configuration>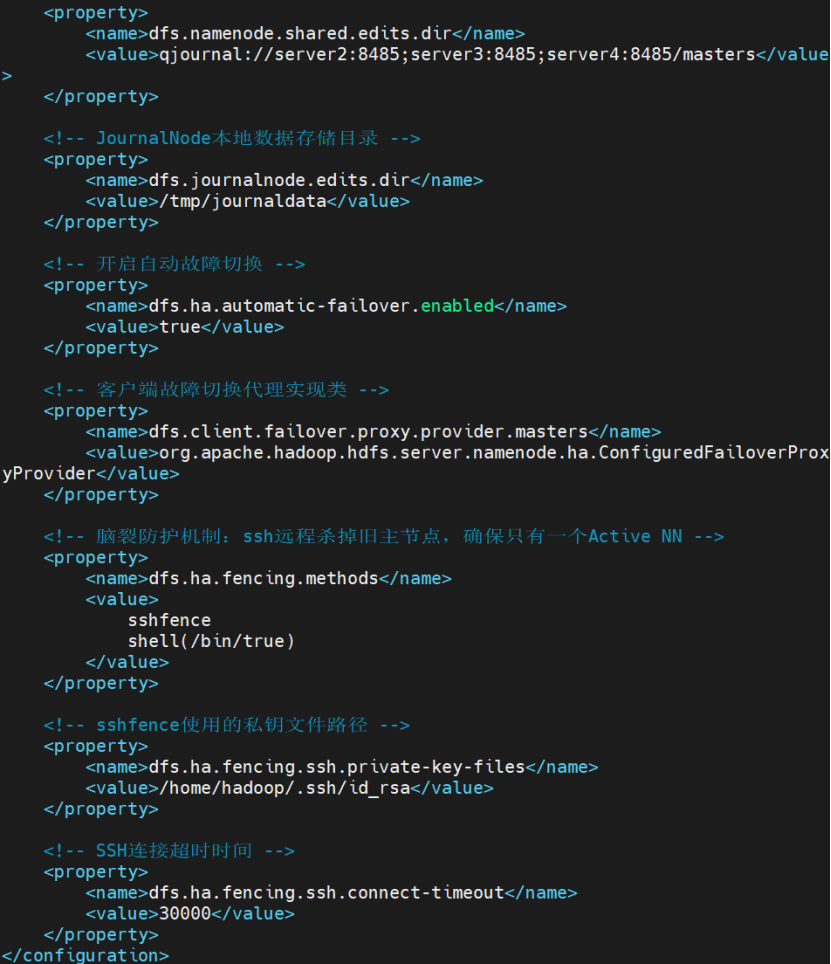
踩坑提醒:JournalNode地址之间用分号分隔,不是逗号;sshfence依赖节点间hadoop用户SSH免密互通,否则故障切换时无法杀掉旧主节点,会引发脑裂。
2.2 启动JournalNode集群
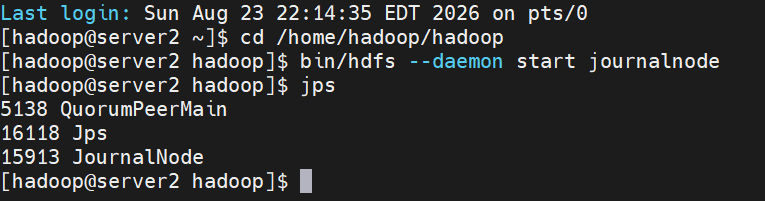
JournalNode必须先于NameNode启动,在server2、server3、server4上分别执行:
cd /home/hadoop/hadoop
bin/hdfs --daemon start journalnode
jps
server2节点验证进程正常:
2.3 NameNode格式化与元数据同步
只能在一个NameNode上执行格式化,这里选server1:
bin/hdfs namenode -format格式化成功日志如下:
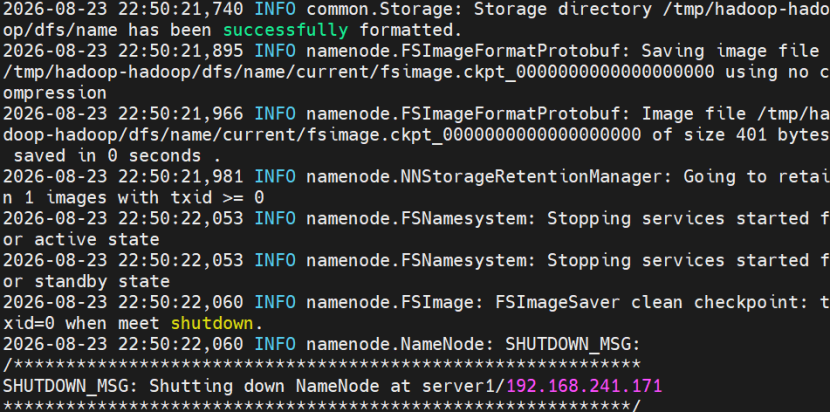
关键红线:绝对不能两个NameNode都执行format,否则会生成不同的ClusterID,导致集群无法同步。
格式化完成后,将server1的元数据目录远程复制到server5:
scp -r /tmp/hadoop-hadoop server5:/tmp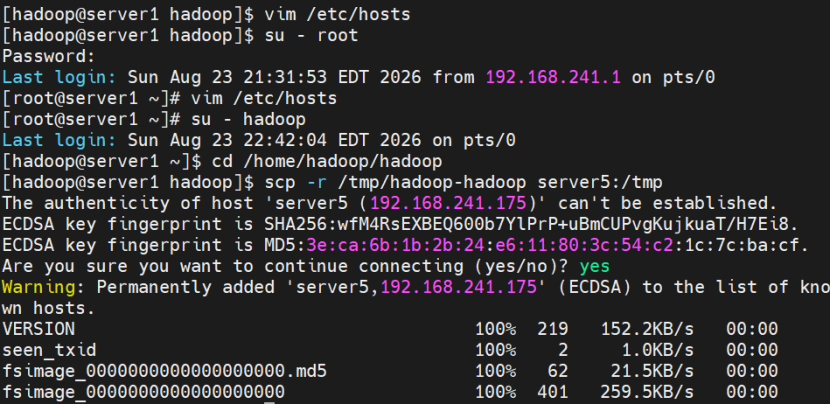
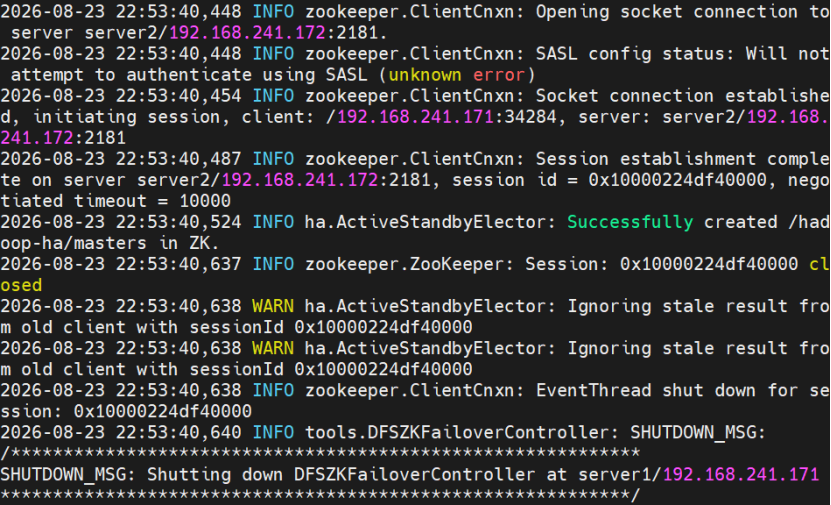
接下来初始化ZooKeeper中的HA状态节点:
bin/hdfs zkfc -formatZK执行日志显示成功在ZK中创建/hadoop-ha/masters节点:
2.4 启动HDFS集群与进程验证
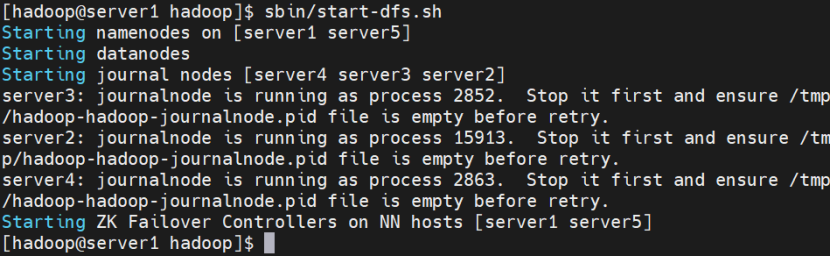
在server1上执行集群启动脚本:
sbin/start-dfs.sh执行后三个JournalNode提示已在运行,属于正常现象------我们前面手动启动过,脚本重复启动会报错,不影响其他组件。
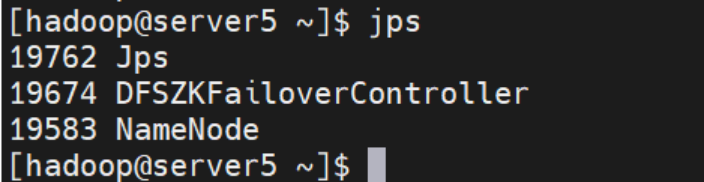
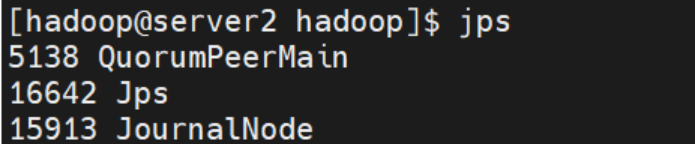
启动完成后各节点进程验证:
- server5:NameNode + DFSZKFailoverController
- server2:QuorumPeerMain(ZK) + JournalNode
- server1:NameNode + SecondaryNameNode(残留) + DFSZKFailoverController + ResourceManager(残留)
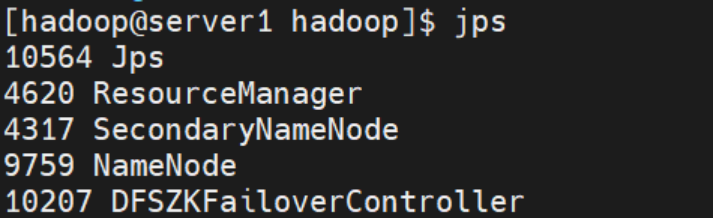
说明:HA模式下SecondaryNameNode已无作用,是之前单节点模式的残留进程,后续清理即可。
2.5 HA状态验证与DataNode启动
查看两个NameNode主备状态:
bin/hdfs haadmin -getAllServiceState结果显示server1为active,server5为standby,状态正常。
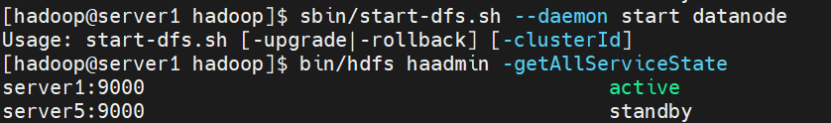
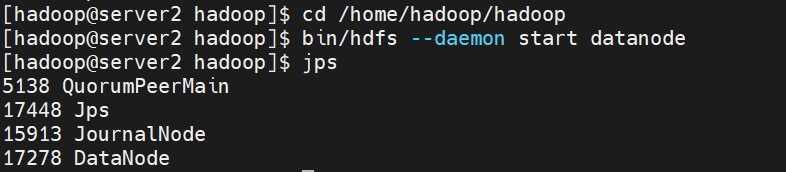
启动DataNode时踩了个小坑:误用start-dfs.sh --daemon start datanode直接报用法错误。正确的单独启动方式是:
bin/hdfs --daemon start datanodeserver2启动后验证DataNode进程:
三、HDFS自动故障切换验证
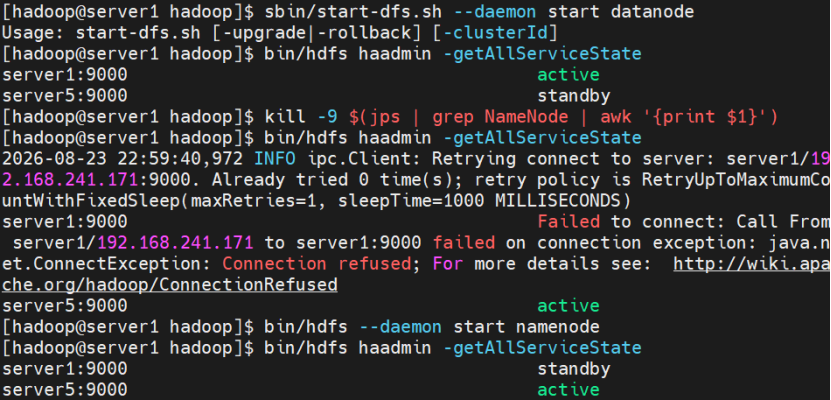
模拟主节点宕机,验证自动切换是否生效。
直接杀掉server1的NameNode进程:
kill -9 $(jps | grep NameNode | grep -v DFSZK | awk '{print $1}')再次查看HA状态,server1连接失败,server5自动切换为active,故障切换成功。重新启动server1的NameNode后,它自动成为standby,集群恢复一主一备健康状态。
四、YARN HA高可用部署
HDFS搞定后,继续配置ResourceManager高可用,同样基于ZooKeeper实现主备选举和状态持久化。
4.1 MapReduce配置
mapred-site.xml指定MR运行在YARN上:
<configuration>
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>
  <property>
    <name>mapreduce.application.classpath</name>
    <value>$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/*:$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value>
  </property>
</configuration>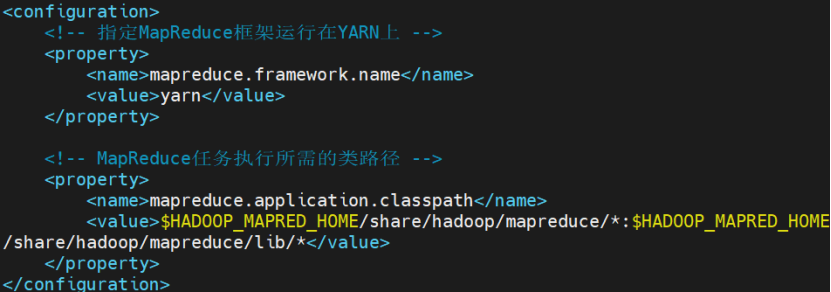
4.2 YARN核心配置
yarn-site.xml第一部分开启RM HA,定义两个RM节点:
<configuration>
  <property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
  </property>
  <property>
    <name>yarn.nodemanager.env-whitelist</name>
    <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_HOME,PATH,LANG,TZ,HADOOP_MAPRED_HOME</value>
  </property>
  <property>
    <name>yarn.resourcemanager.ha.enabled</name>
    <value>true</value>
  </property>
  <property>
    <name>yarn.resourcemanager.cluster-id</name>
    <value>RM_CLUSTER</value>
  </property>
  <property>
    <name>yarn.resourcemanager.ha.rm-ids</name>
    <value>rm1,rm2</value>
  </property>
  <property>
    <name>yarn.resourcemanager.hostname.rm1</name>
    <value>server1</value>
  </property>
  <property>
    <name>yarn.resourcemanager.hostname.rm2</name>
    <value>server5</value>
  </property>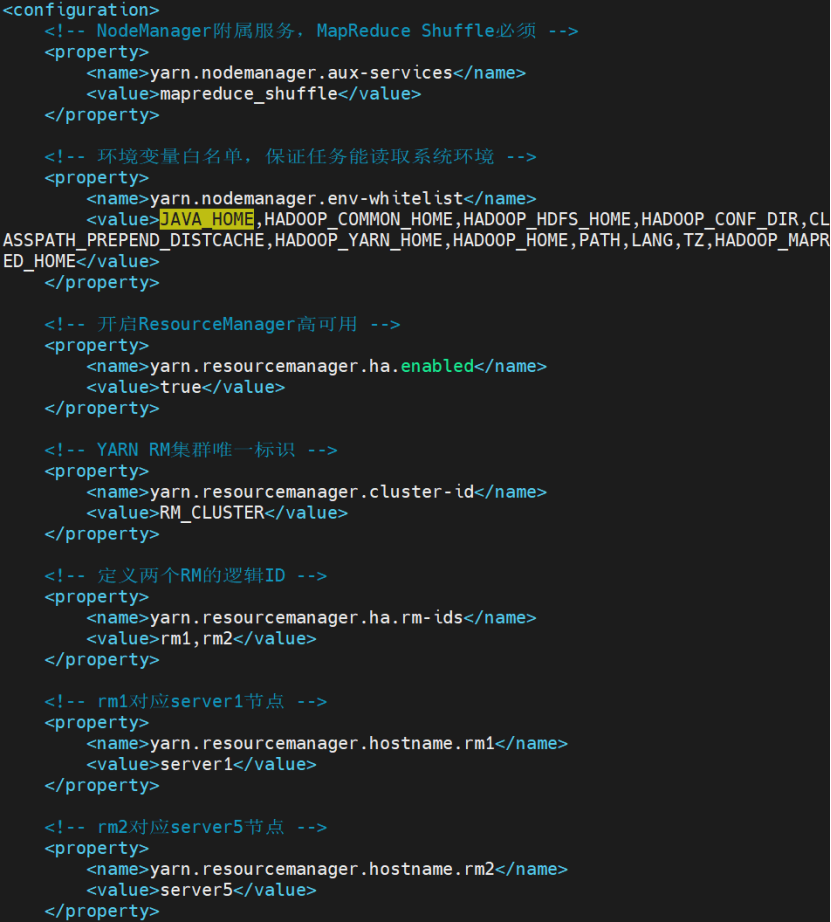
第二部分配置状态持久化到ZooKeeper:
  <property>
    <name>yarn.resourcemanager.recovery.enabled</name>
    <value>true</value>
  </property>
  <property>
    <name>yarn.resourcemanager.store.class</name>
    <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
  </property>
  <property>
    <name>yarn.resourcemanager.zk-address</name>
    <value>server2:2181,server3:2181,server4:2181</value>
  </property>
</configuration>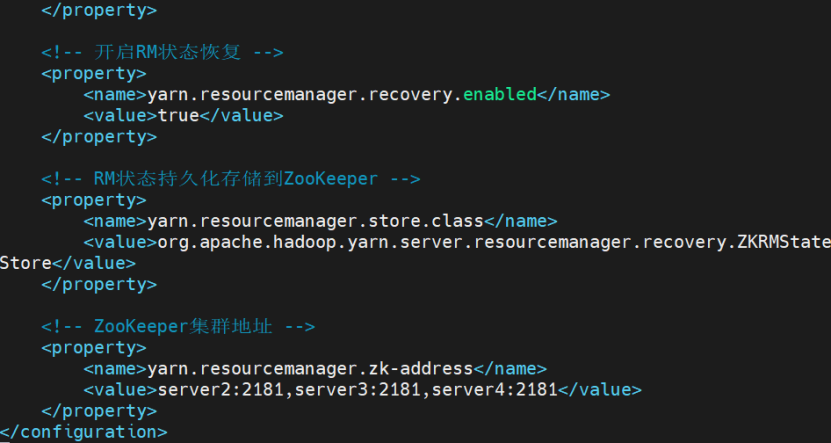
4.3 踩坑:协议不支持报错
配置完直接查RM状态,报Unknown protocol: org.apache.hadoop.ha.HAServiceProtocol错误。
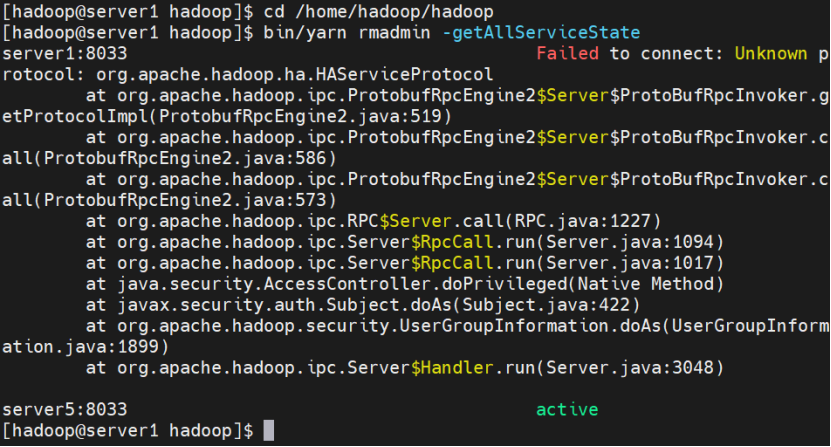
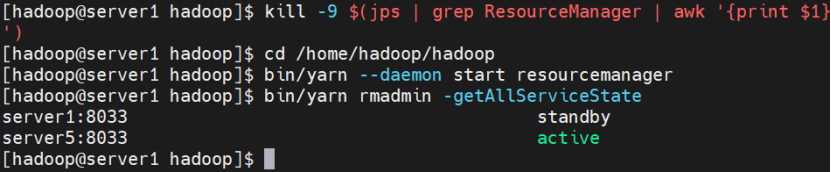
排查:旧的RM进程没有加载新的HA配置,导致协议不识别。杀掉旧进程重启即可:
kill -9 $(jps | grep ResourceManager | awk '{print $1}')
bin/yarn --daemon start resourcemanager
重启后状态正常,server5为active,server1为standby。
4.4 YARN故障切换验证
模拟主RM宕机:杀掉server5的ResourceManager进程。

查看状态,server1自动切换为active,server5连接失败。
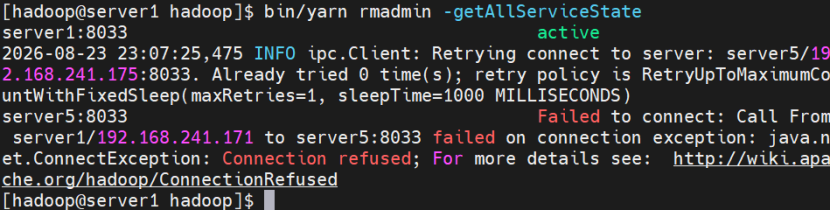
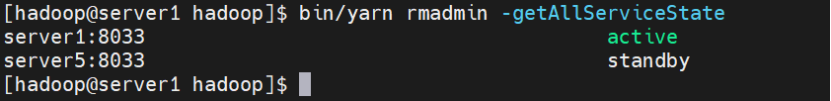
重新启动server5的RM:

再次查看状态,server5恢复为standby,集群健康。
4.5 NodeManager端口占用排错
server2启动NodeManager时报BindException: Address already in use,8040端口被占用。
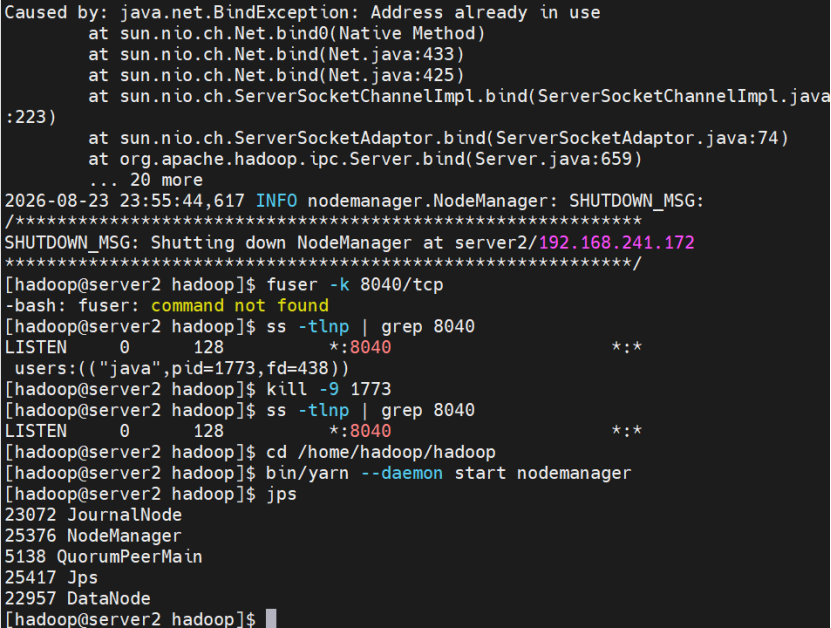
排查:用ss -tlnp | grep 8040查到是旧的NM进程残留,PID 1773。杀掉后重新启动成功。
运维经验:反复启停分布式服务很容易残留进程,遇到端口绑定失败,优先查端口占用,杀进程重启基本都能解决。
4.6 节点重复注册与ZK宕机排错
启动完成后执行yarn node -list,居然显示6个节点,正常应该是3个。
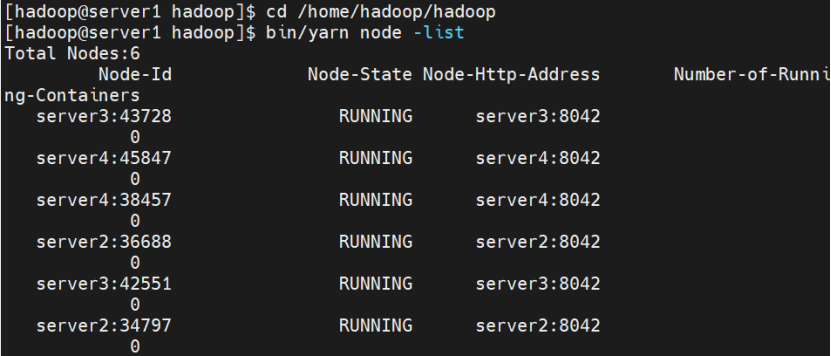
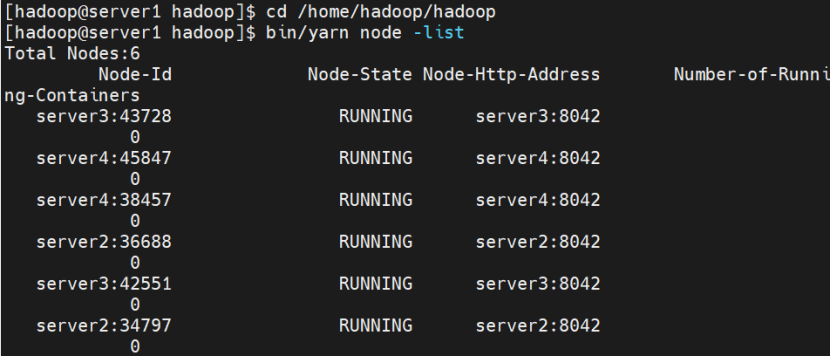
后续更严重:执行yarn命令一直在rm1和rm2之间反复failover,连接全部失败。
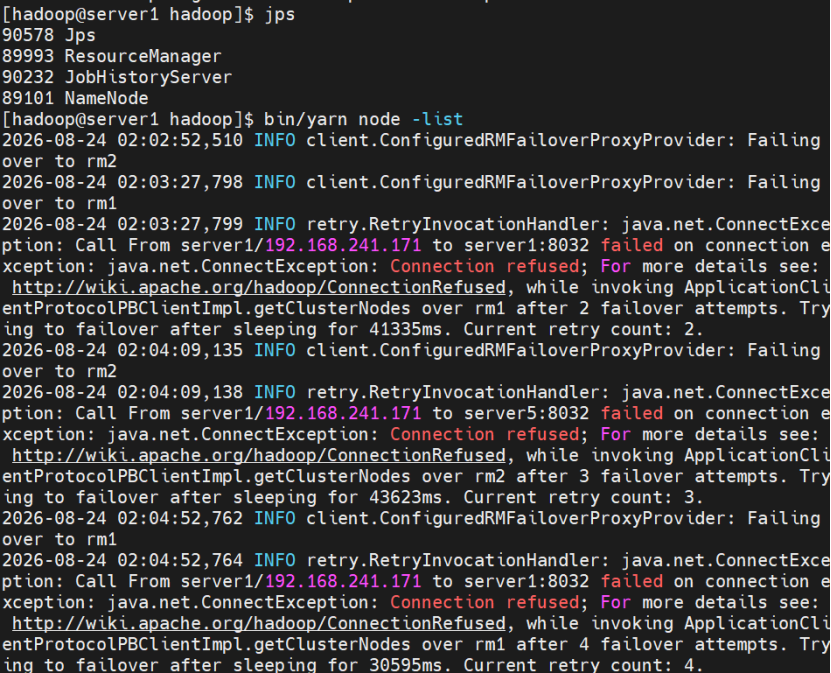
排查结论:
- ZooKeeper集群宕机,RM无法连接ZK做状态同步,导致切换失败
- 配置未同步到所有节点,旧进程残留导致重复注册
解决步骤:
- 重启ZooKeeper集群,确保ZK状态正常
- 将yarn-site.xml同步到server2、server3、server4、server5所有节点
- stop-yarn.sh停止所有服务,清理残留进程
- 重新start-yarn.sh启动集群
重启后节点恢复为正常的3个。
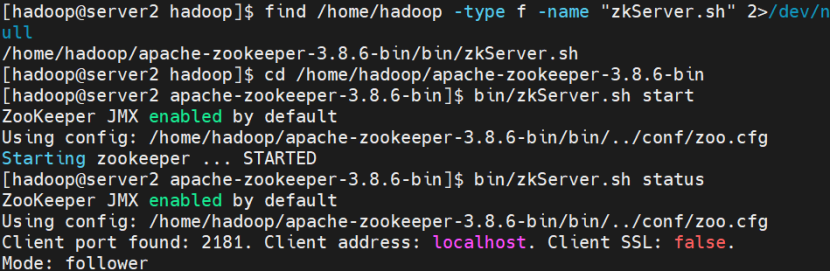
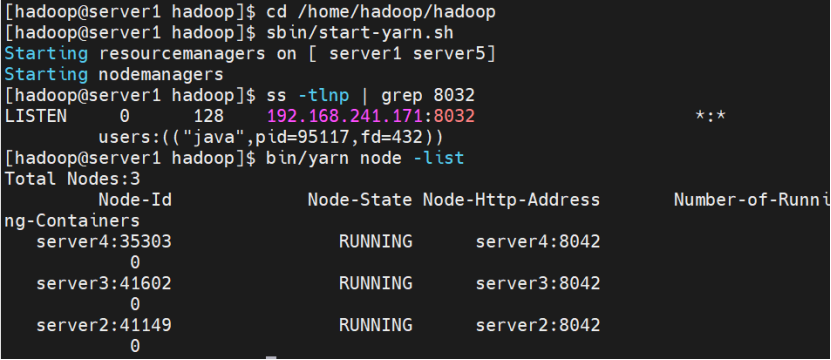
深刻教训:分布式集群配置一致性是重中之重,改完主节点配置一定要同步所有相关节点。
4.7 Web界面最终验证
- HDFS Web界面:当前active为server5的h2节点,集群信息正常

- YARN Web界面:集群资源、调度器正常,RM HA状态正常,ZK连接正常
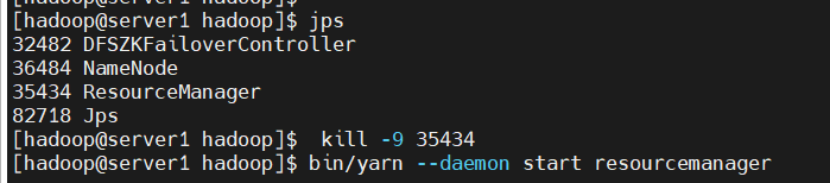
中间个别进程异常退出时,通过杀掉重启即可恢复:
# 修复异常NameNode
kill -9 $(jps | grep NameNode | grep -v DFSZK | awk '{print $1}')
bin/hdfs --daemon start namenode
【
# 重启ResourceManager
kill -9 35434
bin/yarn --daemon start resourcemanager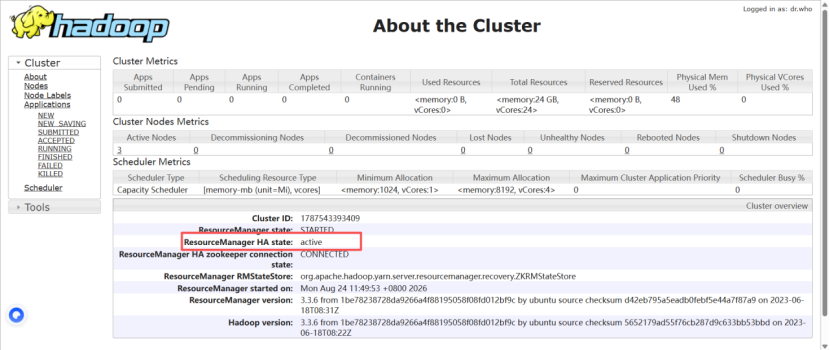
五、OpenStack Mitaka控制节点基础环境
Hadoop部分完成后,转向OpenStack部署,先搭建控制节点基础环境。
5.1 虚拟机与网络配置
控制节点配置:4G内存、4核CPU、50G系统盘。
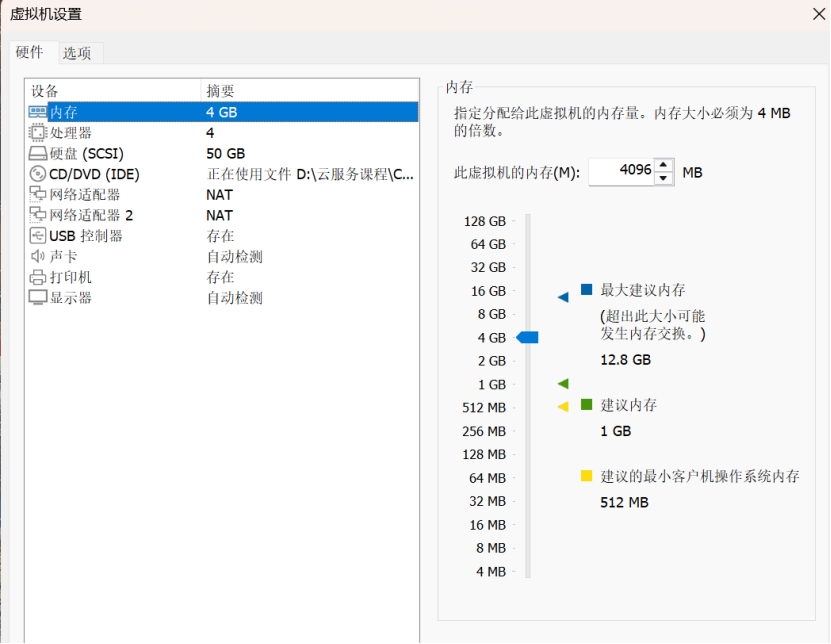
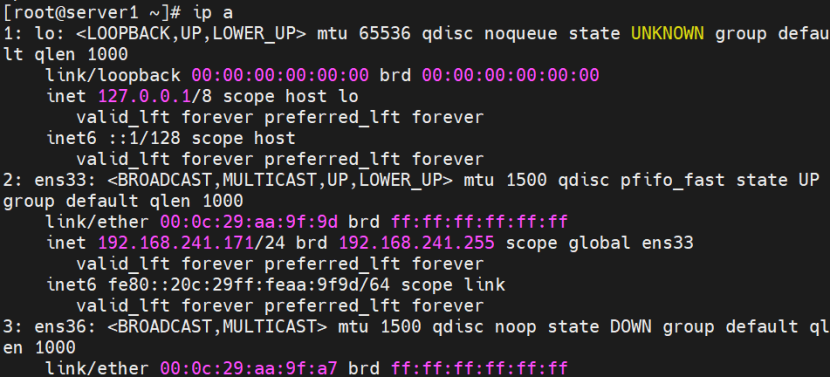
ens33网卡配置静态IP作为管理网络:
TYPE=Ethernet
BOOTPROTO=none
NAME=ens33
DEVICE=ens33
ONBOOT=yes
IPADDR=192.168.241.171
PREFIX=24
GATEWAY=192.168.241.2
DNS1=114.114.114.114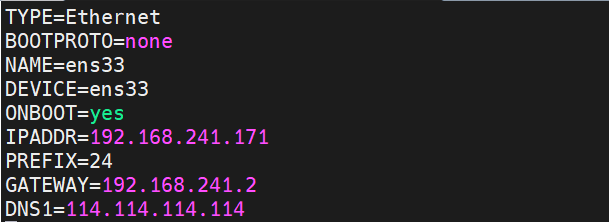
ip a验证网卡配置生效:
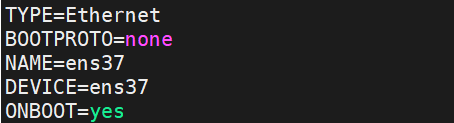
第二块网卡ens37配置开机自启,后续用于租户网络。
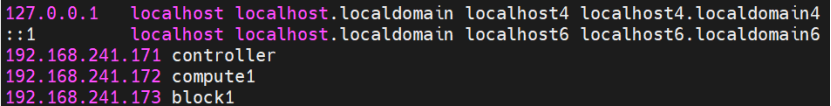
配置hosts主机名解析,规划controller、compute1、block1三个节点。
5.2 系统基础优化
关闭SELinux和防火墙,避免组件间通信被拦截:
getenforce
systemctl disable --now firewalld
iptables -nL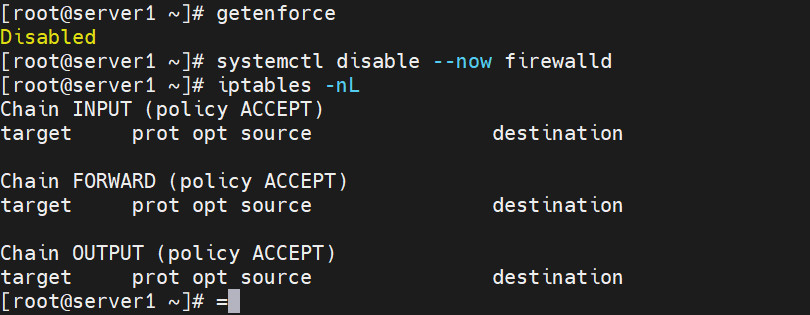
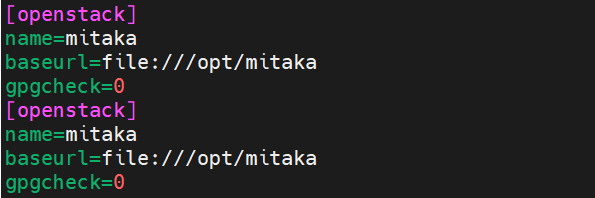
5.3 配置离线YUM源
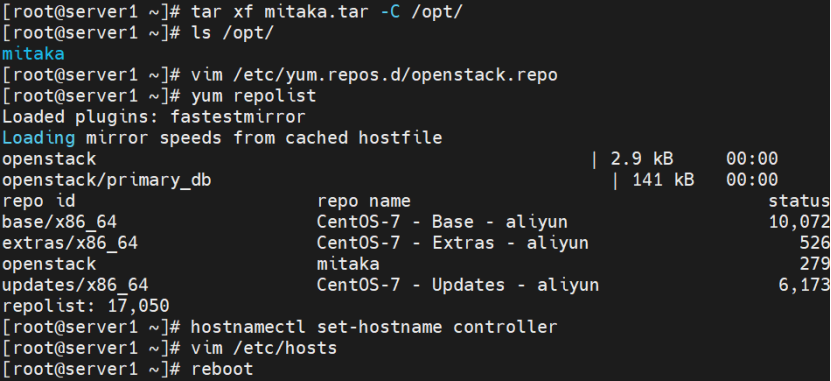
解压mitaka离线安装包到/opt,配置openstack.repo源,验证可用后修改主机名为controller并重启。
六、基础依赖服务部署
6.1 MariaDB数据库
创建/etc/my.cnf.d/openstack.cnf配置文件:
[mysqld]
bind-address = 192.168.241.171
default-storage-engine = innodb
innodb_file_per_table
max_connections = 4096
collation-server = utf8_general_ci
character-set-server = utf8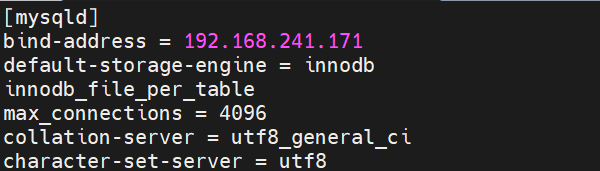
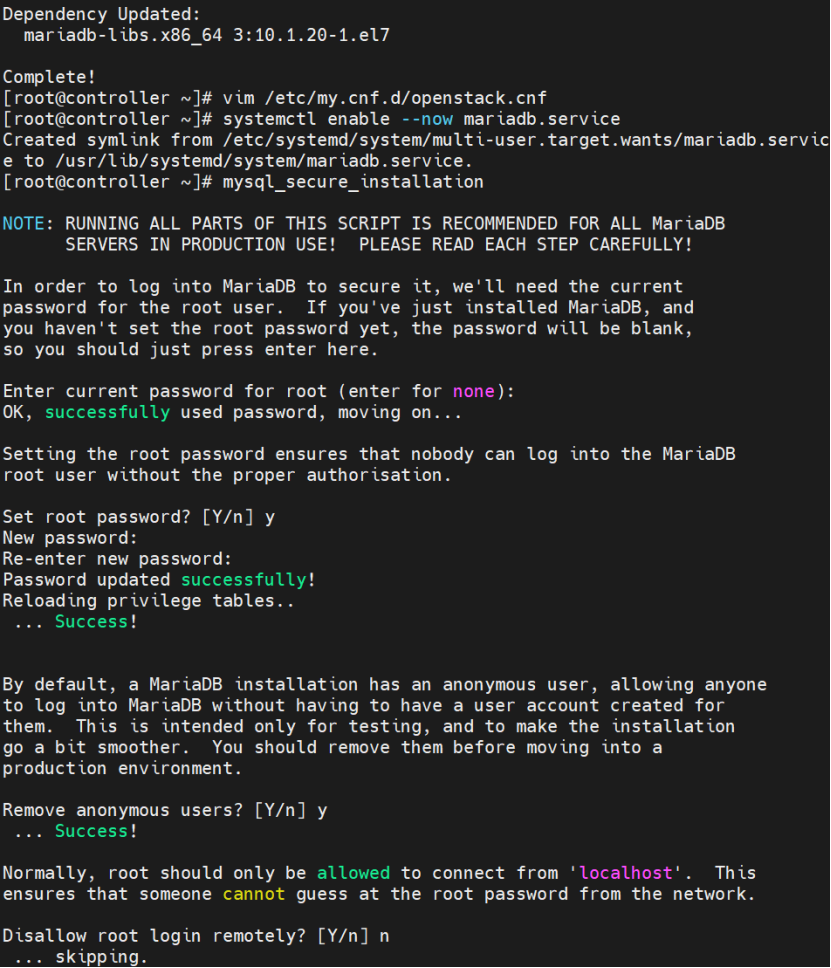
启动服务并执行安全初始化,设置root密码123456,允许远程登录。
6.2 RabbitMQ消息队列
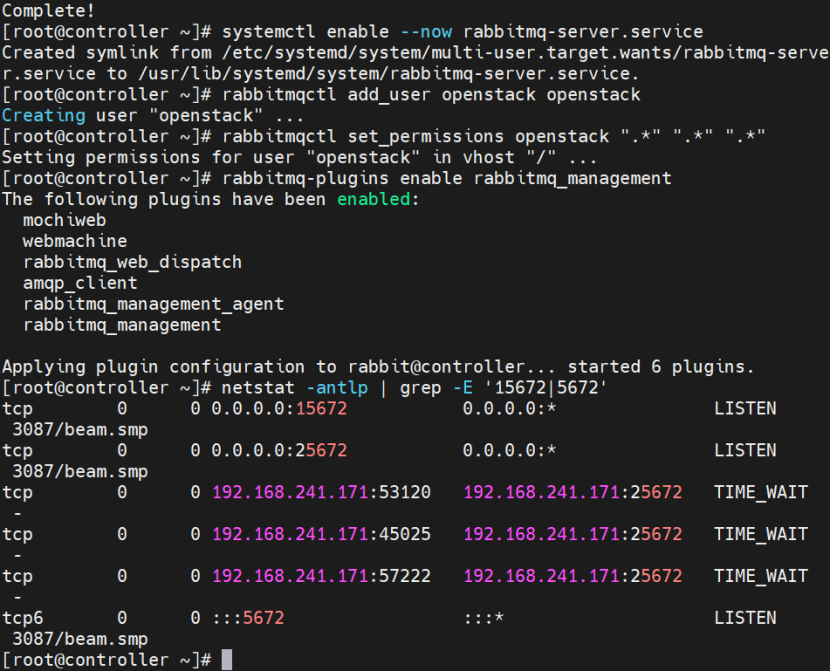
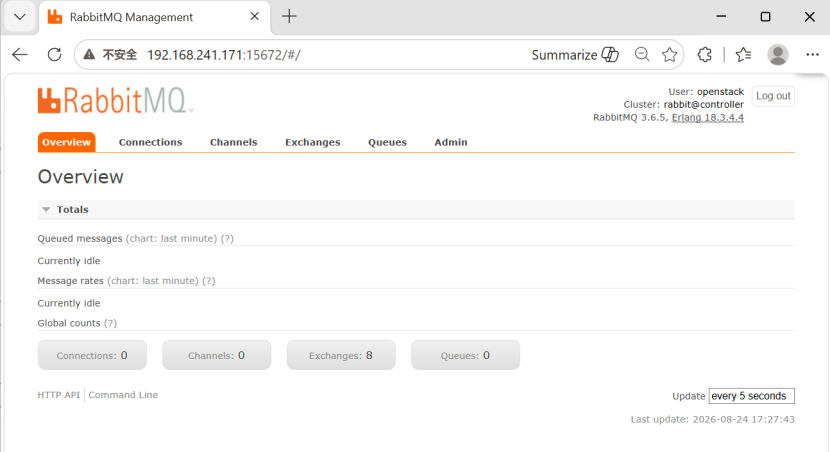
安装并启动RabbitMQ,创建openstack用户并授权,开启management插件:
rabbitmqctl add_user openstack openstack
rabbitmqctl set_permissions openstack ".*" ".*" ".*"
rabbitmq-plugins enable rabbitmq_management
验证5672和15672端口正常监听。
6.3 Memcached缓存
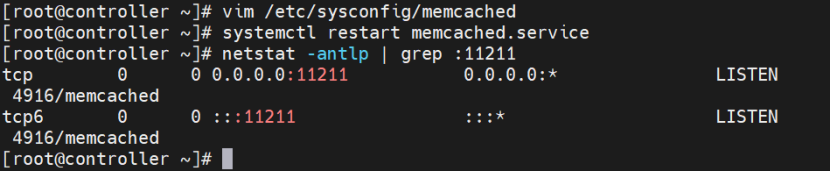
部署Memcached服务,用于Keystone令牌缓存加速。
七、Keystone身份服务部署
Keystone是OpenStack的统一身份认证入口,负责用户、权限、服务目录管理。
7.1 创建Keystone数据库
CREATE DATABASE keystone;
GRANT ALL PRIVILEGES ON keystone.* TO 'keystone'@'localhost' IDENTIFIED BY '123456';
GRANT ALL PRIVILEGES ON keystone.* TO 'keystone'@'%' IDENTIFIED BY '123456';
FLUSH PRIVILEGES;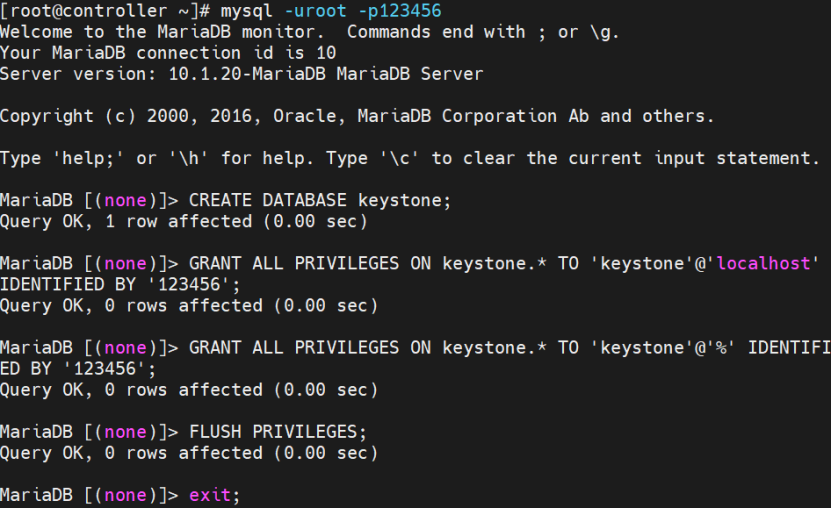
7.2 安装初始化与Apache配置
执行keystone bootstrap初始化管理员和服务端点,配置Apache wsgi代理:
ln -s /usr/share/keystone/wsgi-keystone.conf /etc/httpd/conf.d/
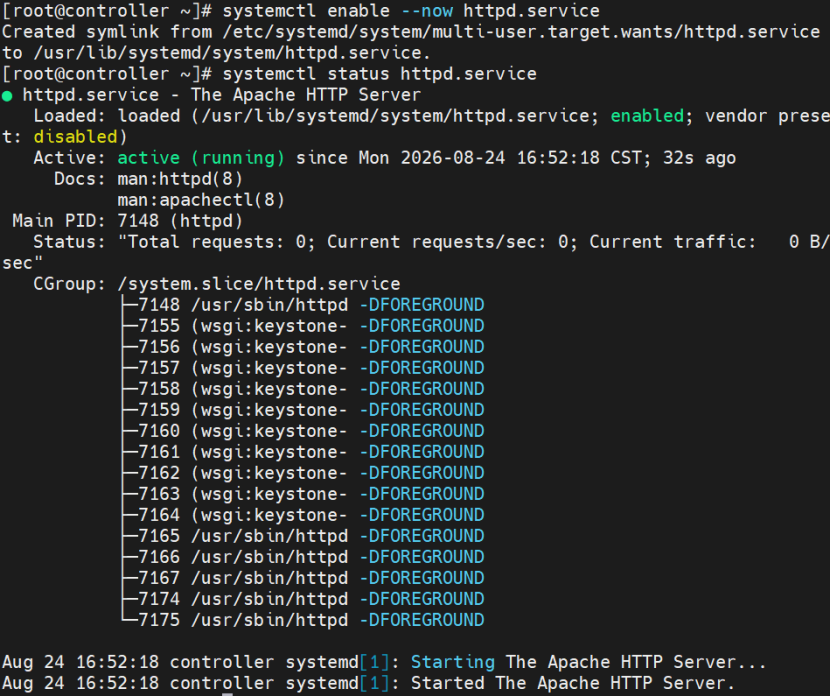
systemctl enable --now httpd.service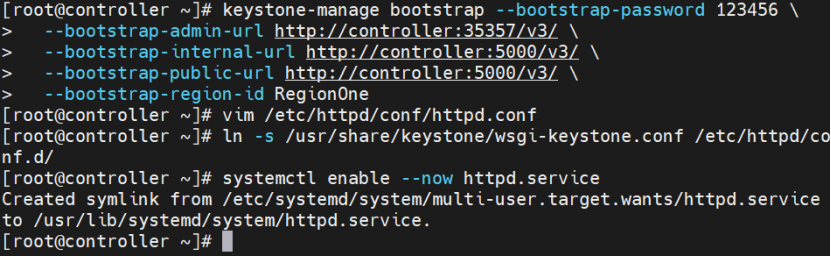
查看httpd状态,多个wsgi:keystone进程正常运行。
7.3 管理员身份验证
创建admin-openrc环境变量脚本:
export OS_USERNAME=admin
export OS_PASSWORD=123456
export OS_PROJECT_NAME=admin
export OS_USER_DOMAIN_NAME=Default
export OS_PROJECT_DOMAIN_NAME=Default
export OS_AUTH_URL=http://controller:35357/v3
export OS_IDENTITY_API_VERSION=3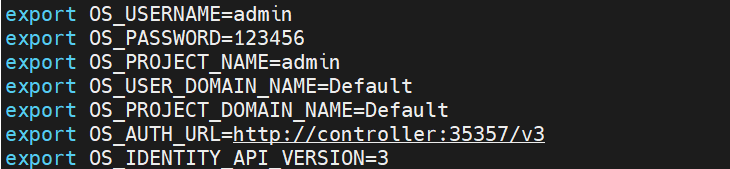
生效后验证令牌获取正常:
source ~/admin-openrc
openstack token issue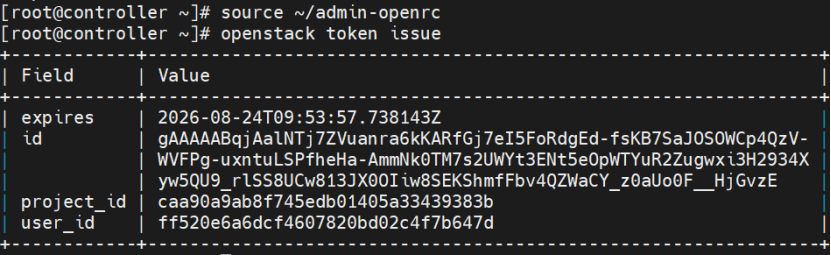
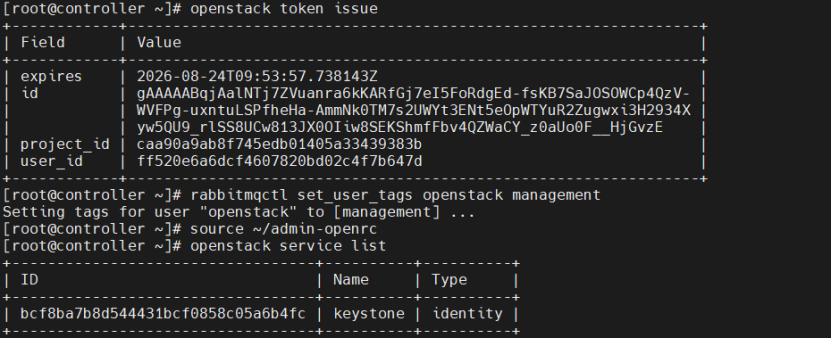
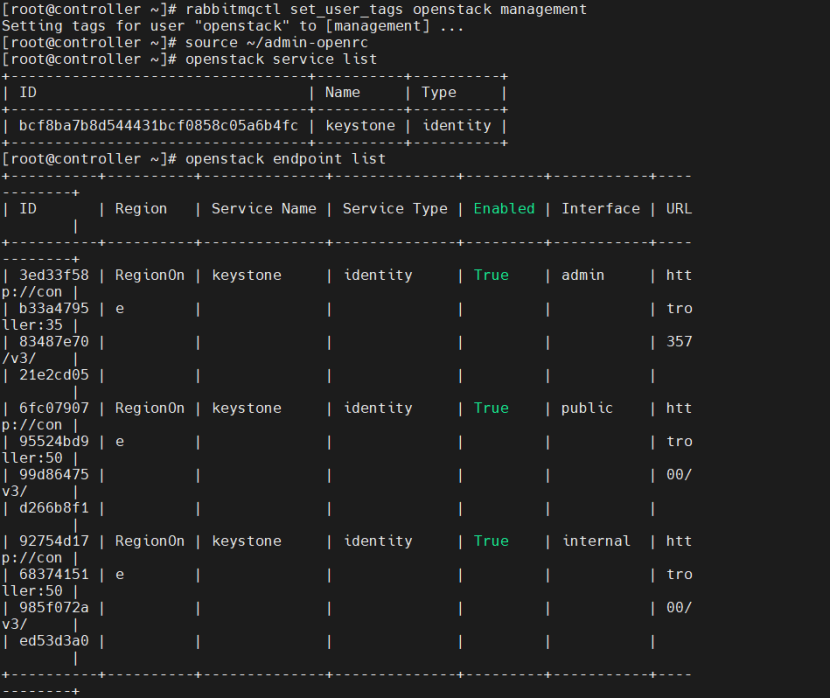
查看已注册的服务和端点,keystone的identity服务及三类接口均正常配置。
7.4 项目、用户与角色创建
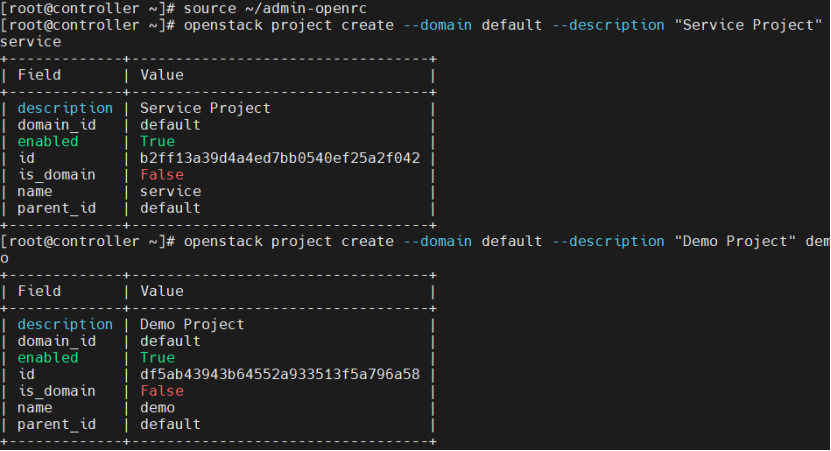
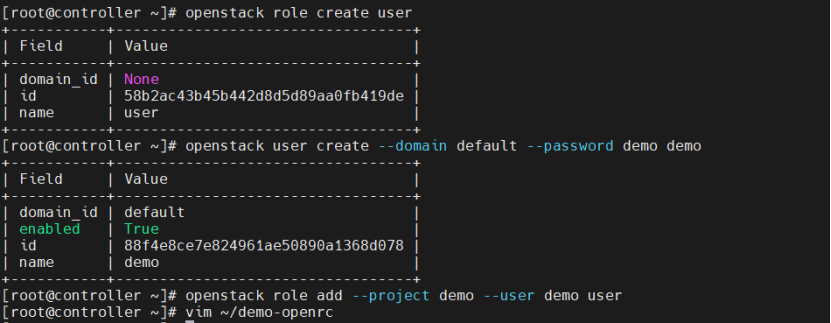
创建service项目(服务组件用)和demo项目(测试用),创建user角色和demo用户并授权。
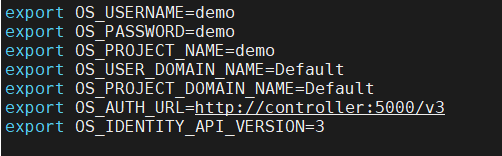
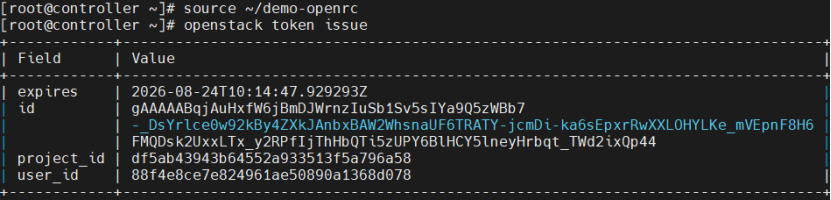
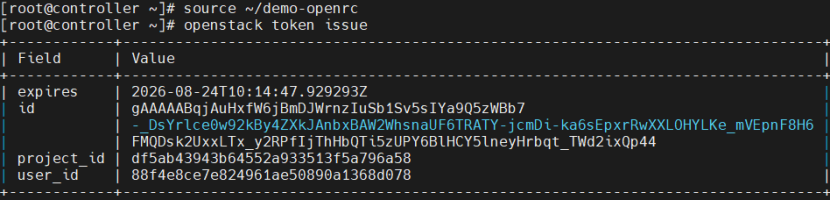
创建demo用户环境变量脚本:
验证demo用户也能正常获取令牌。
最终统一查看角色、服务、端点、项目、域列表,所有资源创建正常。
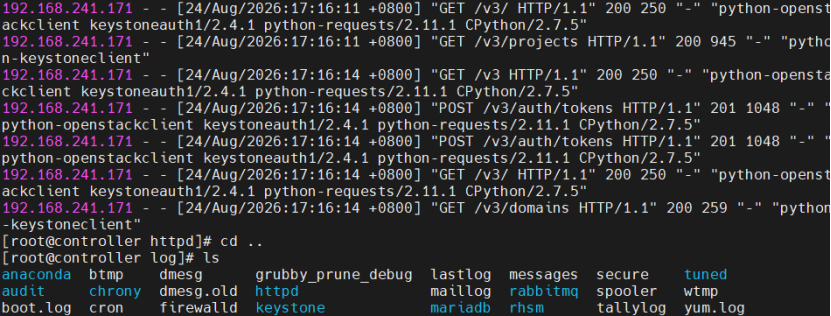
查看httpd访问日志,API请求记录正常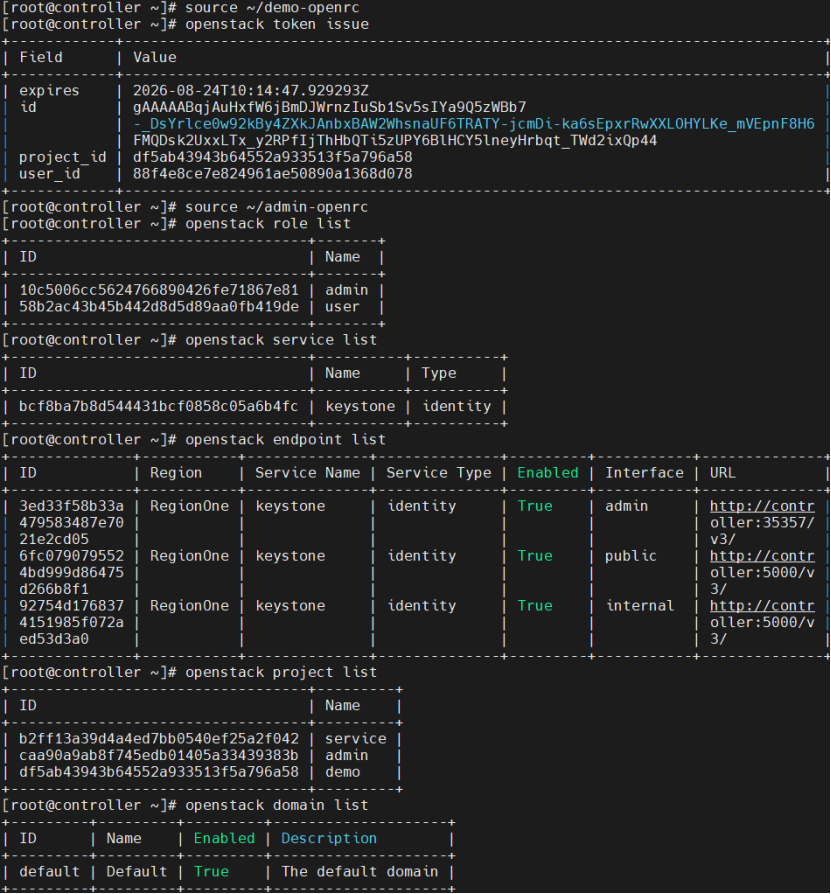
RabbitMQ Web管理界面可正常访问。
八、核心踩坑点汇总
- 重复格式化NameNode:只能格式化一个NN,另一个同步元数据,否则ClusterID不一致导致集群失效
- 命令参数混淆 :启停单个守护进程用
hdfs --daemon/yarn --daemon,start-dfs/start-yarn脚本不带--daemon参数 - 进程残留端口占用:反复启停易残留Java进程,遇到BindException优先用ss查端口杀进程
- 配置不同步:分布式集群改配置必须同步所有节点,否则会出现节点重复注册、协议不识别等异常
- ZK强依赖:HDFS HA和YARN HA都强依赖ZK,ZK宕机直接导致主备切换失效,排错优先查ZK状态
- OpenStack前置环境:必须提前关闭SELinux和防火墙,否则组件间RPC通信会被拦截
九、实操总结
本次实操从底层ZooKeeper协调服务,到Hadoop生态HDFS、YARN高可用,再到OpenStack Keystone身份服务,核心逻辑都是通过第三方协调组件实现状态同步和主备选举,保障服务高可用。
分布式运维细节决定成败,一个配置不同步、一个进程没清干净,都可能引发一连串异常。多踩坑多排错,才能对组件运行机制理解更深刻。后续会继续基于此环境部署Glance、Nova、Neutron等OpenStack核心组件。