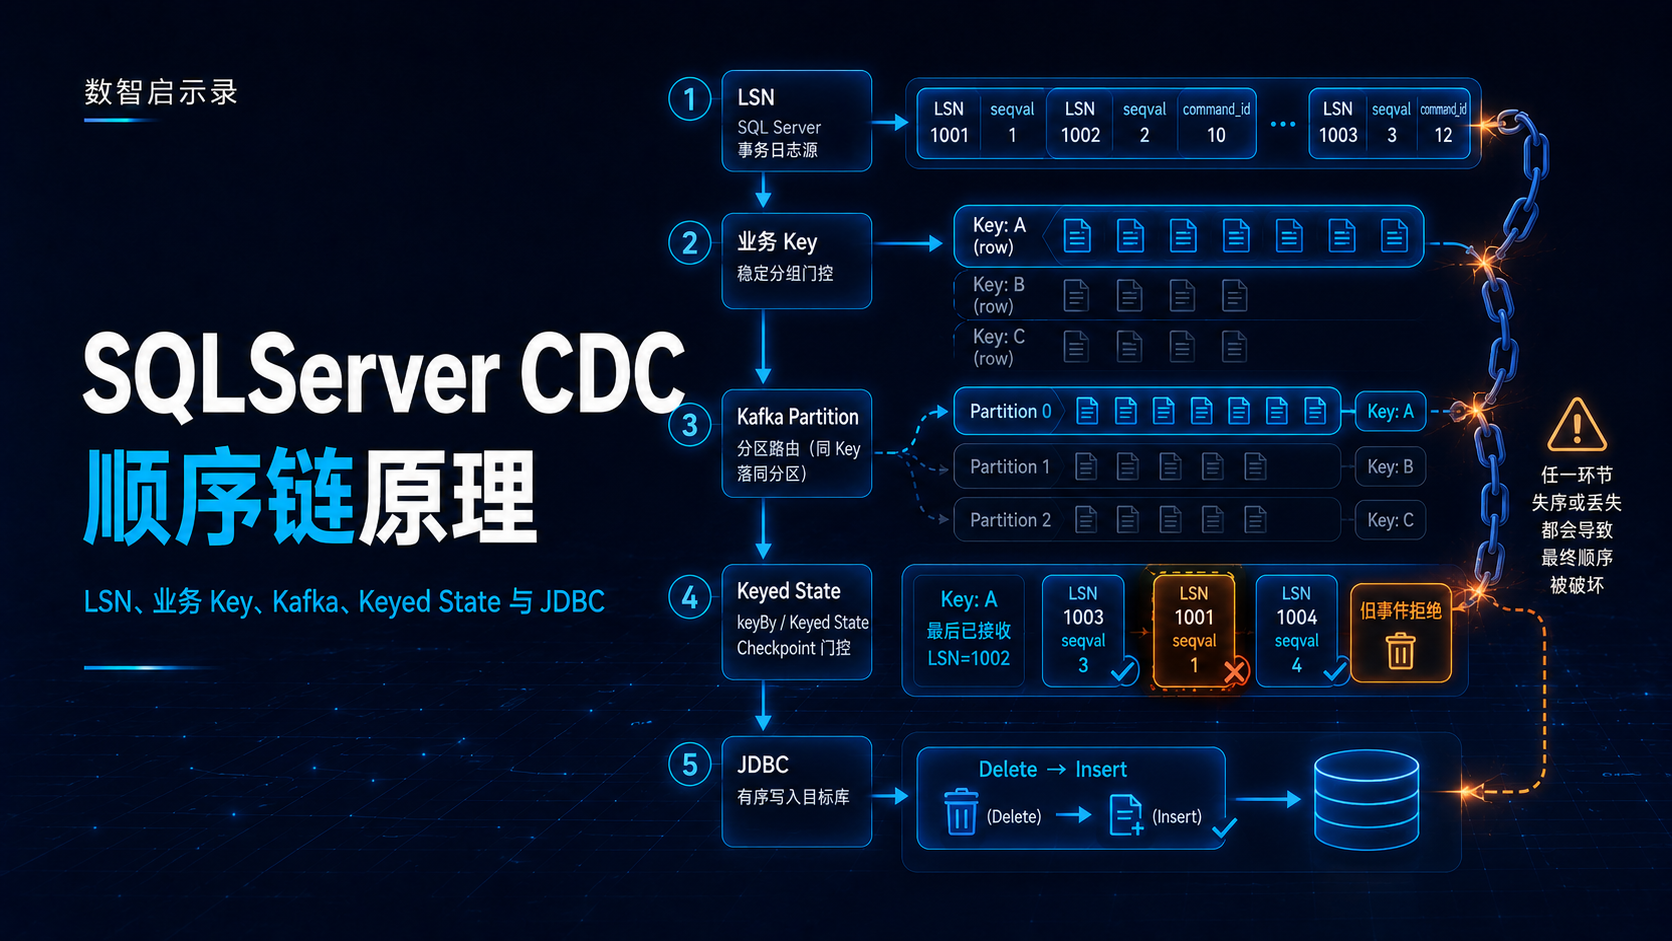
核心结论:顺序不是某一个组件提供的属性,而是一条从数据库日志顺序字段、稳定业务 Key、Kafka 分区、Flink
keyBy、顺序状态到 JDBC 执行次序连续成立的约束链。
一、"Kafka 分区内有序"为什么仍然不够
常见说法是:
同一主键作为 Kafka Key,就能保证顺序。
这句话只在以下前提全部成立时才接近正确:
- 每次变化都能提取出同一个业务 Key;
- 生产端始终按该 Key 分区;
- Topic 分区数和自定义分区策略没有破坏映射;
- 事件到达 Kafka 之前没有被异步重排;
- 消费端没有并发处理同一 Key;
- JDBC Batch 没有重新排列 Delete 和 Upsert;
- 故障恢复后的历史事件不会覆盖更晚状态。
Kafka 只保证单个 Partition 中记录的追加顺序。它不知道哪个字段才是业务主键,也不知道某条 SQLServer CDC 记录在数据库事务中的真实先后关系。
二、先区分四种"顺序"
| 顺序 | 回答的问题 |
|---|---|
| 数据库事务提交顺序 | 哪个事务先进入可见的 CDC 时间线 |
| 同一事务内的命令顺序 | 一个事务中的多条变化谁先谁后 |
| Kafka Partition 顺序 | Broker 在一个分区中按什么顺序保存记录 |
| 业务 Key 最终状态顺序 | 同一行的旧变化是否会覆盖新变化 |
它们有关联,但不能互相替代。
Kafka Offset 只能表达:
text
某条记录在某个 Kafka Partition 中的位置它不能证明:
text
这条记录的 SQLServer 事务一定比另一个 Partition 中的事务更新三、SQLServer CDC 中几个关键顺序字段
SQLServer CDC 变化表中常见的重要元数据包括:
__$start_lsn:与变化关联的提交 LSN,可用于建立提交时间线;__$seqval:日志中的顺序值,用于区分同一事务内的行变化顺序;__$command_id:用于排列事务内部的变化命令;__$operation:Insert、Delete、Update Before、Update After 等操作类型。
在 Debezium/Flink CDC 事件中,字段名称和编码形式可能被包装为 source.lsn、change_lsn、commit_lsn、event_serial_no 等。正确做法不是记住一个固定 JSON 路径,而是:
- 明确当前 Connector 版本真实输出;
- 保留原始数据库顺序信息;
- 用真实 Insert、Update、Delete 样例验证序列化格式;
- 缺少关键顺序字段时明确失败或降级,不要无声假设。
四、稳定业务 Key 是顺序链的入口
假设订单表主键为 order_id=1001。
text
Update(order_id=1001)
Delete(order_id=1001)
Insert(order_id=1001)
三条事件必须生成相同 Kafka Key,才能稳定进入同一 Partition。
Insert/Update 通常可以从 after 取主键;Delete 往往只能从 before 取。如果 Delete 的 Key 为空:
text
Update → Partition 2
Delete → Partition 0 或随机分区
此时 Kafka 的"分区内有序"依然成立,但业务顺序已经断裂。
因此项目在 Source 启动前预热主键元数据,并把主键缺失视为正确性问题,而不是普通字段缺失。
五、Kafka 层到底保证什么
在 Key 稳定、分区策略稳定时:
text
同一业务 Key
    ↓
同一 Kafka Partition
    ↓
Partition 内按 Offset 依次读取
Kafka 不保证:
- 不同 Partition 的全局顺序;
- 业务事务跨多行、跨多表的原子边界;
- Producer 上游已乱序的事件自动恢复数据库顺序;
- 消费端批处理不会重排;
- 目标数据库不会因重试再次执行旧事件。
调整 Topic 分区数以后,同一个 Key 对应的分区可能变化。扩容前后的记录可能分布在不同 Partition,切换期间不能简单依靠 Offset 比较新旧。
六、为什么消费端还要 keyBy
当前项目在 SQLServer Kafka 消费链路中执行:
java
stream
    .keyBy(new CdcKafkaRecordKeySelector())
    .process(new SqlServerKafkaRecordOrderProcessFunction());
keyBy 的作用是让同一个业务 Key 进入同一个 Flink Keyed Operator Subtask,并拥有独立的 ValueState<OrderState>。
状态记录最近一次已放行事件的顺序信息:
text
LSN
seqval
command_id
event timestamp
Kafka offset
新事件只有比状态中的事件更新才会继续下发,否则记录告警并丢弃。
这层不是为了创造数据库中不存在的全局顺序,而是防止同一 Key 的旧事件在重放、跨分区迁移或异常乱序后覆盖新状态。
七、当前项目的比较优先级
SqlServerKafkaRecordOrderProcessFunction 当前按以下优先级判断:
text
LSN
  ↓ 相同
seqval
  ↓ 相同或缺失
command_id
  ↓ 相同
event timestamp
  ↓ 相同
Kafka offset
设计原则是"数据库顺序优先,传输顺序兜底"。
需要准确理解兜底的边界:
- Event Time 可能相同、精度不足或受时钟语义影响;
- Kafka Offset 只能在同一 Partition 内比较;
- 缺失 LSN 时把 Offset 当最终依据,不能声称恢复了 SQLServer 全局提交顺序;
- 两条合法事件的顺序元数据完全相同,可能暴露反序列化丢字段,而不一定是重复消息。
生产监控应统计"缺失 LSN""发生顺序丢弃""只使用 Offset 兜底"的次数,而不应只写 Warn 日志后长期忽略。
八、为什么顺序状态必须进入 Checkpoint
ValueState 中保存了"这个 Key 已经接受到哪里"。如果任务失败后只恢复 Kafka Offset、不恢复顺序状态:
text
最新事件已经写入目标库
        ↓
任务从旧 Offset 重放
        ↓
内存中的 lastOrder 丢失
        ↓
旧事件再次被视为合法新事件
        ↓
旧值覆盖新值
Keyed State 随 Checkpoint 恢复,再配合稳定 Operator UID,才能继续拒绝旧事件。
这也说明 SqlServerKafkaRecordOrderProcessFunction 的 UID 不能随代码结构或下标任意变化。
九、JDBC Batch 是顺序链的最后一段
即使上游完全有序,Sink 仍可能破坏结果。
原始事件:
text
delete(id=1001)
insert(id=1001)
表示删除旧行后重新创建。若 Batch Writer 为了复用 SQL 重排成:
text
insert(id=1001)
delete(id=1001)
最终结果完全相反。
项目的 Route Buffer 必须保持同一表、同一 Key 的原始操作顺序。JDBC 事务只能保证"这一批全部成功或回滚",不能自动修正错误的执行次序。
十、主键更新是特殊边界
当主键从 1001 改成 2001 时,数据库/Connector 可能表达为:
text
Delete(old key=1001)
Insert(new key=2001)
这两条记录天然属于两个不同业务 Key,可能进入不同 Kafka Partition 和 Flink Subtask。普通"同 Key 有序"无法保证两者跨 Key 的原子顺序。
应明确业务策略:
- 尽量禁止更新业务主键;
- 将旧 Key 与新 Key 的关联放入事件契约;
- 目标端允许短暂双记录还是必须事务化迁移;
- 对主键更新设计专门验收用例。
十一、怎样验证整条顺序链
用例 1:同一 Key 高频更新
连续写入版本号 1...1000,最终目标必须为 1000,且不得出现版本回退。
用例 2:Delete → Insert
删除后重建同一主键,最终记录必须存在且字段为新值。
用例 3:Insert → Delete
最终记录必须不存在。
用例 4:故意交换 Kafka 事件
将较旧 LSN 的记录晚于新记录送达,确认顺序算子丢弃旧事件并产生可观测指标。
用例 5:Checkpoint 后故障重放
让目标库 Commit 成功、Checkpoint 未完成时终止任务,恢复后最终版本不能倒退。
用例 6:缺失顺序字段
构造没有 LSN/seqval 的事件,验证系统是明确失败、进入 DLQ,还是降级;不能让行为不确定。
用例 7:主键更新
验证旧 Key 删除、新 Key 创建和下游短暂状态是否符合业务约定。
十二、这套机制不能保证什么
- 不能恢复不同业务 Key 的全局事务顺序;
- 不能用 Kafka Offset 替代数据库提交顺序;
- 不能在业务 Key 不稳定时保证同一分区;
- 不能自动处理任意主键更新的原子迁移;
- 不能阻止 Sink 自己重排事件;
- 不能因为有顺序过滤,就省略目标端幂等。
十三、一句话总结
text
数据库顺序字段定义"谁更新"
业务 Key 定义"谁必须串行"
Kafka Partition 保持传输顺序
Flink Keyed State 拒绝旧事件
稳定 UID 保证顺序状态可恢复
JDBC Writer 保持最终执行顺序