OpenCV入门(五):图像拼接、背景建模、光流估计与DNN风格迁移
前言 :本文是"OpenCV入门"系列的第五篇。前四篇我们学习了图像基础操作、图像预处理、轮廓检测与模板匹配、图像金字塔与透视转换。本篇我们将进入五个更高级的实战应用:图像拼接 ------将多张重叠图像合成为全景图;背景建模与运动检测 ------从视频中分离运动目标;光流估计 ------追踪像素的运动轨迹;摄像头文档扫描 ------实时检测并矫正文档;DNN风格迁移------利用深度学习模型实现图像艺术化。这些技术涵盖了计算机视觉的核心应用场景。
目录
- 一、图像拼接
- 二、背景建模与运动检测
- 三、光流估计
- 四、摄像头文档扫描
- 五、DNN风格迁移
- 六、总结
一、图像拼接
1.1 什么是图像拼接?
图像拼接是指将多张具有重叠区域 的图像合成为一张全景图像的技术,广泛应用于手机全景拍照、无人机航拍、VR场景构建等领域。
1.2 核心技术流程
读取图片 → SIFT特征提取 → 特征匹配 → 计算单应性矩阵 → 透视变换 → 图像融合1.3 完整代码
python
import cv2
import numpy as np
import sys

def cv_show(name, img):
    cv2.imshow(name, img)
    cv2.waitKey(0)

def detect_and_describe(image):
    """提取图像的 SIFT 特征点和描述子"""
    gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
    sift = cv2.SIFT_create()
    kps, des = sift.detectAndCompute(gray, None)
    kps_float = np.float32([kp.pt for kp in kps])
    return kps, kps_float, des

# ====================读取待拼接图片==========================
image_a = cv2.imread("left.jpg")
image_b = cv2.imread("right.jpg")
cv2.imshow("image_a", image_a)
cv2.imshow("image_b", image_b)

# ====================提取特征==========================
kps_a, kps_float_a, des_a = detect_and_describe(image_a)
kps_b, kps_float_b, des_b = detect_and_describe(image_b)

# ====================特征匹配==========================
bf = cv2.BFMatcher()
raw_matches = bf.knnMatch(des_b, des_a, k=2)

good = []
matches = []
for m in raw_matches:
    if len(m) == 2 and m[0].distance < 0.65 * m[1].distance:
        good.append(m)
        matches.append((m[0].queryIdx, m[0].trainIdx))

print(f"找到 {len(good)} 个好的匹配点")

# ====================计算单应性矩阵==========================
if len(matches) > 4:
    pts_b = np.float32([kps_float_b[i] for (i, _) in matches])
    pts_a = np.float32([kps_float_a[j] for (_, j) in matches])
    H, mask = cv2.findHomography(pts_b, pts_a, cv2.RANSAC, 10)
else:
    print("图片未找到4个以上的匹配点")
    sys.exit()

# ====================透视变换与拼接==========================
result = cv2.warpPerspective(
    image_b,
    H,
    (image_b.shape[1] + image_a.shape[1], image_b.shape[0])
)

# 将左图放入拼接结果
result[0:image_a.shape[0], 0:image_a.shape[1]] = image_a

cv2.imwrite("panorama.jpg", result)
cv_show("panorama", result)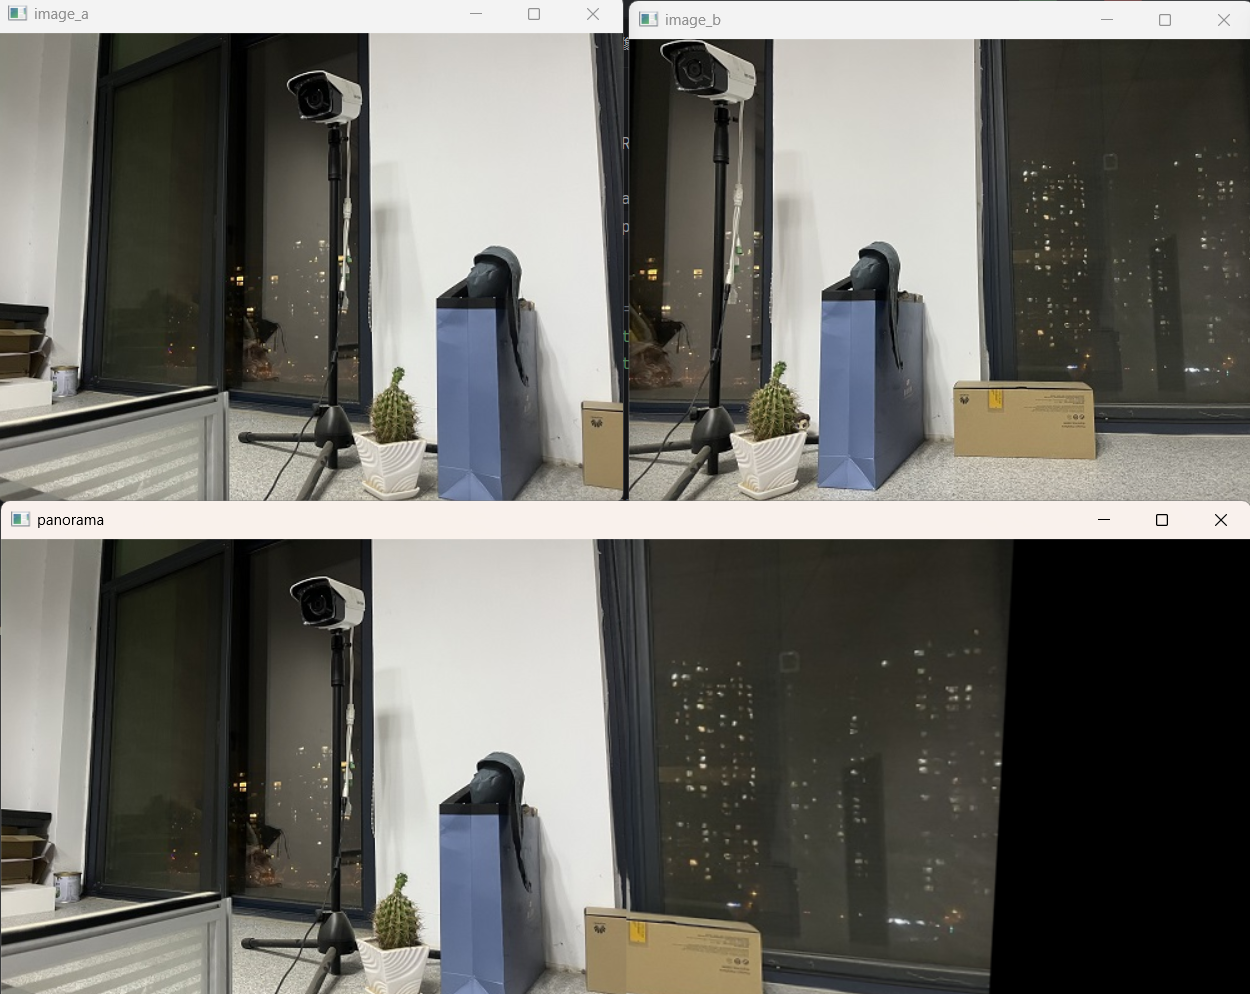
1.4 关键步骤说明
| 步骤 | 说明 |
|---|---|
| SIFT特征提取 | 提取图像中具有尺度不变性和旋转不变性的关键点 |
| BFMatcher匹配 | 暴力匹配两张图片的所有特征点 |
| Lowe's比率测试 | 通过最近邻与次近邻距离之比筛选可靠匹配点 |
| findHomography | 使用RANSAC算法剔除误匹配,计算单应性矩阵 |
| warpPerspective | 对右图进行透视变换,拼接到左图坐标系中 |
二、背景建模与运动检测
2.1 什么是背景建模?
背景建模是视频分析的核心技术,用于从视频序列中分离前景(运动目标)和背景(静止场景),广泛应用于安防监控、行人检测、车辆跟踪、交通流量分析等场景。
2.2 MOG2背景减除
MOG2(Mixture of Gaussians 2)是一种基于高斯混合模型的自适应背景建模算法。它对每个像素建立多个高斯模型,能够适应光照变化、树叶晃动等动态背景。
2.3 完整代码
python
import cv2

cap = cv2.VideoCapture("video.mp4")

# 创建形态学内核
kernel = cv2.getStructuringElement(cv2.MORPH_CROSS, (3, 3))

# 创建 MOG2 背景减除器
fgbg = cv2.createBackgroundSubtractorMOG2()

while True:
    ret, frame = cap.read()
    if not ret:
        break

    # 背景减除,得到前景掩膜
    fgmask = fgbg.apply(frame)

    # 开运算去噪(先腐蚀后膨胀)
    fgmask_new = cv2.morphologyEx(fgmask, cv2.MORPH_OPEN, kernel)

    # 查找轮廓
    contours = cv2.findContours(fgmask_new, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)[-2]

    for c in contours:
        peri = cv2.arcLength(c, True)
        if peri > 188:  # 过滤掉面积过小的噪点轮廓
            x, y, w, h = cv2.boundingRect(c)
            cv2.rectangle(frame, (x, y), (x + w, y + h), (0, 255, 0), 2)

    cv2.imshow("result", frame)

    if cv2.waitKey(60) == 27:
        break

cap.release()
cv2.destroyAllWindows()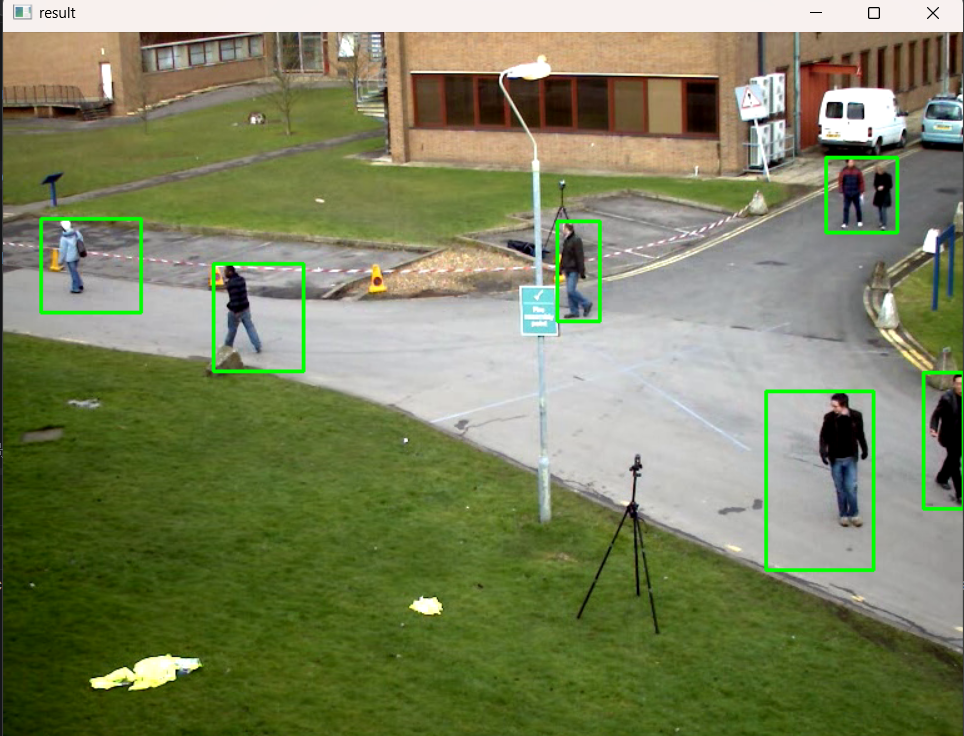
2.4 核心步骤说明
| 步骤 | 说明 |
|---|---|
| createBackgroundSubtractorMOG2 | 创建MOG2背景减除器,自动学习背景模型 |
| apply | 对每一帧应用背景减除,返回前景掩膜(白色为前景,黑色为背景) |
| MORPH_OPEN | 开运算先腐蚀后膨胀,有效去除前景掩膜中的噪声点 |
| findContours | 查找运动目标的轮廓边界 |
| boundingRect | 计算轮廓的外接矩形,在原图上绘制检测框 |
三、光流估计
3.1 什么是光流?
光流是视频中物体运动的视觉表现形式,描述了像素从一帧到下一帧的移动方向和速度。光流信息可以反映物体的运动状态,广泛应用于动作识别、目标跟踪、视频压缩、机器人导航等领域。
3.2 Lucas-Kanade光流
Lucas-Kanade是一种稀疏光流算法,它假设在一个局部窗口内所有像素的运动一致,通过最小二乘法求解运动矢量。该算法只计算特征点的运动,计算量小,适合实时应用。
3.3 完整代码
python
import cv2
import numpy as np

cap = cv2.VideoCapture("test.avi")

# 随机生成颜色,用于区分不同点的轨迹
color = np.random.randint(0, 255, (100, 3))

# 读取第一帧
ret, old_frame = cap.read()
old_gray = cv2.cvtColor(old_frame, cv2.COLOR_BGR2GRAY)

# 角点检测参数
feature_params = dict(maxCorners=100, qualityLevel=0.3, minDistance=7)

# 光流参数
lk_params = dict(winSize=(15, 15), maxLevel=2)

# 检测初始角点作为跟踪特征点
p0 = cv2.goodFeaturesToTrack(old_gray, mask=None, **feature_params)

mask = np.zeros_like(old_frame)

while True:
    ret, frame = cap.read()
    if not ret:
        break

    frame_gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)

    # 计算光流,跟踪特征点
    p1, st, err = cv2.calcOpticalFlowPyrLK(old_gray, frame_gray, p0, None, **lk_params)

    # 选取跟踪成功的点
    good_new = p1[st == 1]
    good_old = p0[st == 1]

    # 绘制运动轨迹
    for i, (new, old) in enumerate(zip(good_new, good_old)):
        a, b = new.ravel()
        c, d = old.ravel()
        mask = cv2.line(mask, (int(a), int(b)), (int(c), int(d)), color[i].tolist(), 2)

    # 将轨迹掩膜叠加到当前帧
    img = cv2.add(frame, mask)
    cv2.imshow("frame", img)

    if cv2.waitKey(150) == 27:
        break

    # 更新旧帧和特征点
    old_gray = frame_gray.copy()
    p0 = good_new.reshape(-1, 1, 2)

cap.release()
cv2.destroyAllWindows()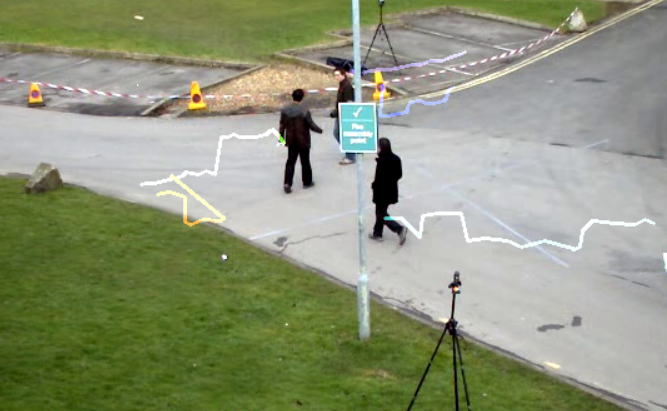
3.4 关键步骤说明
| 步骤 | 说明 |
|---|---|
| goodFeaturesToTrack | 使用Shi-Tomasi角点检测算法提取高质量特征点 |
| calcOpticalFlowPyrLK | 基于金字塔的Lucas-Kanade光流计算,跟踪特征点的位置变化 |
| status | 状态向量,1表示跟踪成功,0表示跟踪丢失 |
| 轨迹绘制 | 将每个特征点当前帧位置与上一帧位置连线,形成运动轨迹 |
四、摄像头文档扫描
4.1 什么是透视变换?
透视变换是将图像从一个视角投影到另一个视角的过程。在文档扫描场景中,它将倾斜拍摄的文档矫正为正面视角,是扫描全能王、证件识别等应用的核心技术。
4.2 完整代码
python
import cv2
import numpy as np

def cv_show(name, img):
    cv2.imshow(name, img)
    cv2.waitKey(25)

def order_points(pts):
    """对四个角点排序:左上、右上、右下、左下"""
    rect = np.zeros((4, 2), dtype="float32")
    s = pts.sum(axis=1)
    rect[0] = pts[np.argmin(s)]    # 左上(坐标和最小)
    rect[2] = pts[np.argmax(s)]    # 右下(坐标和最大)
    diff = np.diff(pts, axis=1)
    rect[1] = pts[np.argmin(diff)] # 右上(y-x最小)
    rect[3] = pts[np.argmax(diff)] # 左下(y-x最大)
    return rect

def four_point_transform(image, pts):
    """执行透视变换,将倾斜文档矫正为正面视图"""
    rect = order_points(pts)
    (tl, tr, br, bl) = rect

    # 计算目标宽度
    widthA = np.sqrt(((br[0] - bl[0]) ** 2) + ((br[1] - bl[1]) ** 2))
    widthB = np.sqrt(((tr[0] - tl[0]) ** 2) + ((tr[1] - tl[1]) ** 2))
    maxWidth = max(int(widthA), int(widthB))

    # 计算目标高度
    heightA = np.sqrt(((tr[0] - br[0]) ** 2) + ((tr[1] - br[1]) ** 2))
    heightB = np.sqrt(((tl[0] - bl[0]) ** 2) + ((tl[1] - bl[1]) ** 2))
    maxHeight = max(int(heightA), int(heightB))

    # 目标四个角点(正面矩形)
    dst = np.array([
        [0, 0],
        [maxWidth - 1, 0],
        [maxWidth - 1, maxHeight - 1],
        [0, maxHeight - 1]
    ], dtype="float32")

    M = cv2.getPerspectiveTransform(rect, dst)
    warped = cv2.warpPerspective(image, M, (maxWidth, maxHeight))
    return warped

# ====================打开摄像头==========================
cap = cv2.VideoCapture(0)

while True:
    flag = 0
    ret, image = cap.read()
    if not ret:
        break

    orig = image.copy()
    gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
    gray = cv2.GaussianBlur(gray, (5, 5), 0)
    edged = cv2.Canny(gray, 15, 45)

    cnts = cv2.findContours(edged, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)[-2]
    cnts = sorted(cnts, key=cv2.contourArea, reverse=True)[:3]

    for c in cnts:
        peri = cv2.arcLength(c, True)
        approx = cv2.approxPolyDP(c, 0.05 * peri, True)
        area = cv2.contourArea(approx)

        if area > 30000 and len(approx) == 4:
            screenCnt = approx
            flag = 1
            break

    if flag == 1:
        warped = four_point_transform(orig, screenCnt.reshape(4, 2))
        warped = cv2.cvtColor(warped, cv2.COLOR_BGR2GRAY)
        ref = cv2.threshold(warped, 135, 255, cv2.THRESH_BINARY)[1]
        cv2.imshow("scan_result", ref)

    if cv2.waitKey(150) == 27:
        break

cap.release()
cv2.destroyAllWindows()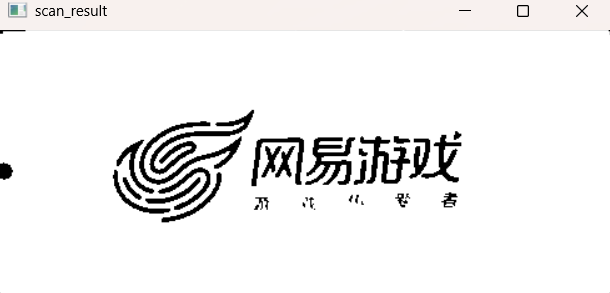
五、DNN风格迁移
5.1 什么是风格迁移?
风格迁移是利用深度学习模型将一幅图像的艺术风格 应用到另一幅图像上的技术。OpenCV的dnn模块支持加载预训练的神经网络模型进行推理,无需安装深度学习框架即可实现风格迁移效果。
5.2 完整代码
python
import cv2

# 读取输入图像
image = cv2.imread("input.jpg")

# 缩放图像便于预览
image = cv2.resize(image, None, fx=0.4, fy=0.4, interpolation=cv2.INTER_AREA)
cv2.imshow("original", image)
cv2.waitKey(0)

(h, w) = image.shape[:2]

# 创建Blob,将图像转换为模型输入格式
blob = cv2.dnn.blobFromImage(image, 1, (w, h), [0, 0, 0], False, crop=False)

# 加载预训练风格迁移模型
net = cv2.dnn.readNet("model/feathers.t7")
net.setInput(blob)

# 前向推理
out = net.forward()

# 后处理:调整维度并归一化到[0,1]范围
out_new = out.reshape(out.shape[1], out.shape[2], out.shape[3])
cv2.normalize(out_new, out_new, norm_type=cv2.NORM_MINMAX)
result = out_new.transpose((1, 2, 0))

cv2.imshow("style_transfer", result)
cv2.waitKey(0)
cv2.destroyAllWindows()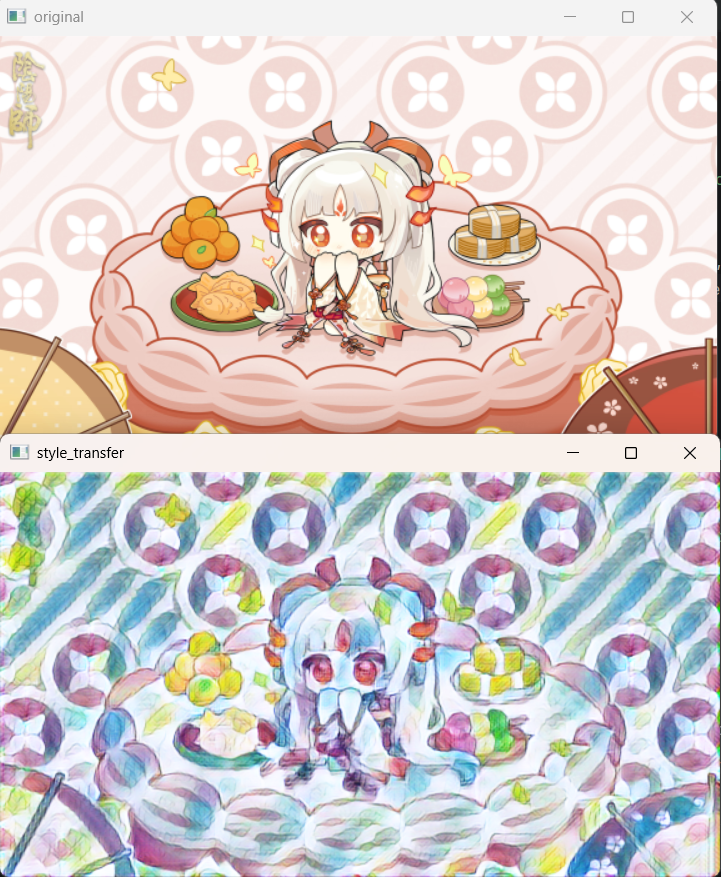
5.3 关键步骤说明
| 步骤 | 说明 |
|---|---|
| blobFromImage | 将图像转换为深度学习模型可接受的输入格式 |
| readNet | 加载预训练的.t7格式风格迁移模型 |
| forward | 执行模型前向推理,生成风格化图像 |
| normalize | 将输出归一化到0,1范围以便正确显示 |
| transpose | 调整维度顺序从(C,H,W)转为(H,W,C) |
六、总结
核心函数速查
| 类别 | 函数 | 用途 |
|---|---|---|
| 特征提取 | SIFT_create()、detectAndCompute() |
提取图像特征点 |
| 特征匹配 | BFMatcher()、knnMatch() |
匹配特征点 |
| 单应性矩阵 | findHomography() |
计算图像变换矩阵 |
| 背景减除 | createBackgroundSubtractorMOG2() |
分离前景与背景 |
| 光流计算 | calcOpticalFlowPyrLK() |
计算像素运动矢量 |
| 角点检测 | goodFeaturesToTrack() |
检测高质量特征角点 |
| 透视变换 | getPerspectiveTransform()、warpPerspective() |
矫正图像视角 |
| DNN推理 | dnn.readNet()、forward() |
加载模型并执行推理 |
注意事项
| 要点 | 说明 |
|---|---|
| 图像拼接 | 两张图片必须有足够重叠区域,否则匹配特征点数量不足 |
| 背景减除 | 需要连续视频流支持,单张图片无法建模背景 |
| 光流估计 | 依赖连续两帧图像,特征点数量直接影响跟踪效果 |
| 透视变换 | 需要准确的四个角点坐标,角点排序必须正确 |
| DNN模型 | 需提前下载.t7格式模型文件,确保文件路径正确 |
系列直达
- 上篇 :OpenCV入门(四):图像金字塔与图像透视转换
- 本篇:OpenCV入门(五):图像拼接、背景建模、光流估计与DNN风格迁移(本文)
- 下篇:敬请期待