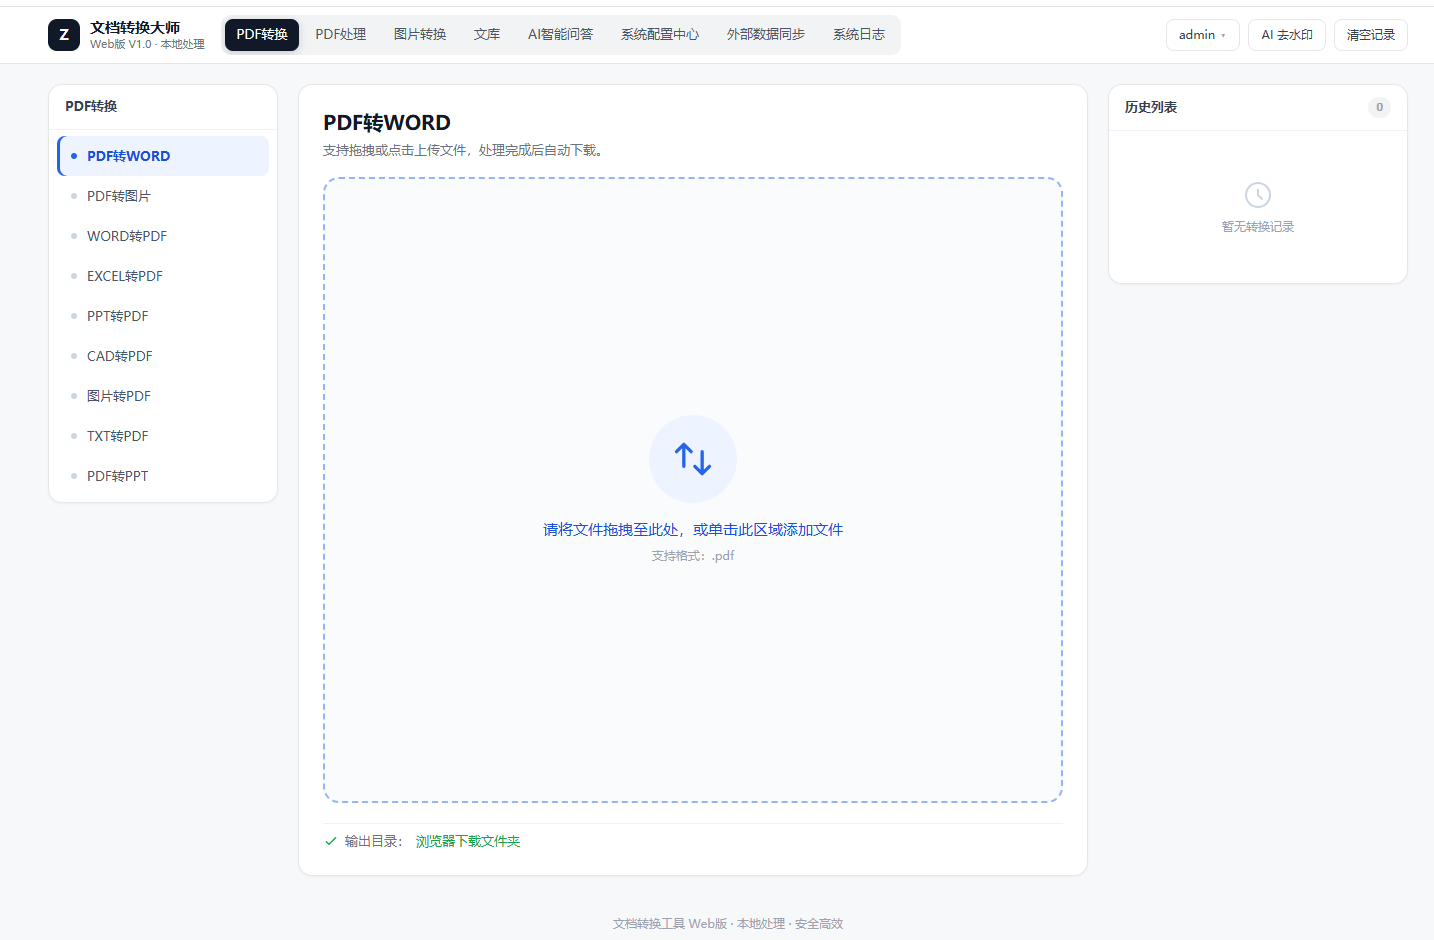
一、为什么还要自己造一个文档处理工具?
如果你在制造业、检测类或法务类企业待过,一定对下面两个场景不陌生。
第一,合同、质检单、报价单这类带敏感信息的 PDF,想转成 Word 改一改,或者想去掉上面的水印、盖上电子章------打开搜索引擎,排在最前面的全是"免费在线转换",但点进去要么按页收费、限速到怀疑人生,要么在上传那一刻,你的文件就已经躺在别人的服务器上了。对企业来说,这等于把商业机密主动交了出去。
第二,企业内网里跑着成千上万份文档,合规部门明确要求"数据不出本地",可市面上能本地离线、还能批量处理的工具几乎为零。要么闭源收费,价格随授权人数翻番;要么只支持单文件、点一下等半天,根本谈不上"批量"。
这两个场景叠加出同一个结论:企业需要的是一把能装在自家机器上、离线可用、又能批量处理的"文档瑞士军刀"。这正是 DocConverter Web(文档转换大师 Web 版)的立项原点。
二、立项起点:先让核心能力跑起来
项目从 2026 年 8 月启动。最初的目标很朴素------复刻"转转大师"截图里那些看着好用的功能,先把最核心的格式转换能力跑通。我们先用团队已有的 doc-converter Skill 把 PDF/Word 互转的主链路验证了一遍,确认"本地转换"在工程上完全可行,才正式立项为独立的 Web 产品。
这一步很关键:它让我们避开了"先搭漂亮界面、再发现核心引擎根本转不准"的典型陷阱。能力先行,产品在后,这个顺序决定了整个项目"本地优先"的基因。
三、技术选型:单体服务 + 零构建前端
立项时的架构决策,今天回看依然成立,核心只有四句话:
后端用 FastAPI + Uvicorn 单体服务。文档处理本质是 CPU/IO 密集的同步任务,单体结构调试简单、部署轻,不必为一堆微服务通信操心。
前端用原生 HTML + Tailwind + Vanilla JS,零构建。没有 webpack、没有打包步骤,静态文件即前端。对内网工具来说,可维护性远比重构灵活性重要。
转换引擎复用成熟库:PyMuPDF 负责 PDF 底层操作,pdf2docx 负责版式还原,python-pptx 处理 Office 互转。不重复造轮子。
AI 依赖隔离在独立 docweb venv。向量库、深度学习推理这些环境极易污染系统 Python,单独隔离后,主服务升级互不干扰。
用一个对比表说清取舍:
维度 我们的选型 放弃的备选 理由
后端形态 FastAPI 单体 微服务 同步重任务,单体调试简单
前端形态 原生 + 零构建 React/Vue 重构建 内网工具重可维护性
转换引擎 复用 PyMuPDF 等 自研解析器 不重复造轮子
AI 环境 docweb venv 隔离 全局安装 防污染系统 Python
部署形态(示意):单体 + 静态目录
app = FastAPI() # 后端 API
app.mount("/", StaticFiles(...)) # 前端静态文件即站点
AI 相关依赖全部装在 docweb venv,与主服务隔离,避免污染系统环境
四、贯穿始终的主线:本地可控
有人会问:现成的 SaaS 这么多,为什么非要自己扛?
答案只有四个字------本地可控。文件不过网、参数可调、批量可编排、还能接企业内网的权限体系。这既是合规底线,也是后续六大阶段(转换、签章、AI去水印、AI批量去水印、AI智能问答、外部向量数据库接入、权限部署)共同的技术底座。
系列路线图:七个阶段一口气走完
为了把"本地可控"真正落地,这个项目不是一步到位的,而是分六个阶段逐步长出能力:先是本文讲的格式互转引擎,解决"转得准";接着是电子签章与批量盖章,把质检中心每天 500--600 个章变成可审计的配置;然后是 AI 单图/PDF 去水印与 AI 批量去水印,分别解决"精准去除"和"几百张离线批量清理";再到 AI 智能问答与 RAG 知识库,让文档能被"对话";最后是权限安全与一键部署,把单点工具封成可落地系统。本系列会按这个顺序逐篇拆解,下一篇先从最硬的骨头------格式互转保真------说起。
回头看,立项时最幸运的决定,是先把核心转换能力跑通再谈产品。这个顺序让我们避开了无数团队踩过的坑:界面做得很美,底层引擎却转不准,最后用户用一次就走。能力先行、产品在后,是这个项目贯穿始终的节奏,后续每一篇都会印证这一点。
小结
本地可控不是一句口号,而是一连串具体的取舍:单体而非微服务、零构建而非重前端、venv 隔离而非全局安装。这些选择让一个单人就能维护的项目,扛起了企业级文档处理的完整需求。
下期预告:核心能力跑通只是第一步。真正折磨人的是------PDF 转 Word 转出来版式错乱、表格图片丢失,Office 转 PDF 又强依赖本机有没有装 Word。下一篇我们啃下"格式互转保真"这块第一硬骨头。
标签:#DocConverter #PDF转换 #本地化部署 #FastAPI #文档处理 #大模型 #AI #Agent