词级分词(word level)
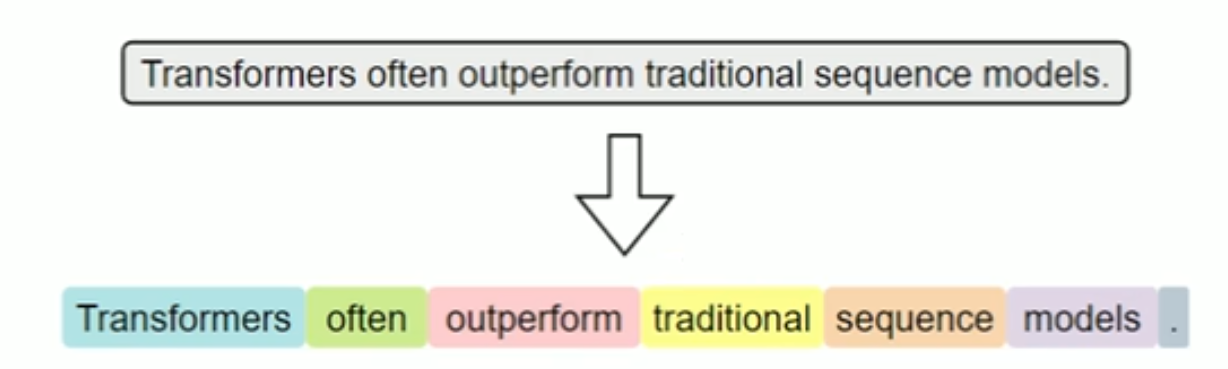
词级分词是指将文本按词语切分。是最传统、最直观的分词方式。英文中,空格和标点往往是天然的分隔符。
分词效果如下:
缺陷 :
词级分词,在实际应用中,容易出现未知词(Out of Vocabulary)问题。例如此表中已有
I love you he her ...如果分词中突然出现个chatGPT,模型就无法识别到这个词。只能用UNK标记。使用字符级分词,就不会有这个问题。如下。
字符级分词 (character level)
字符级分词,是以单个字符为最小单元的分词方法。文本中的每一个字母、数字、标点甚至空格,都被视作一个独立的token。效果如下:
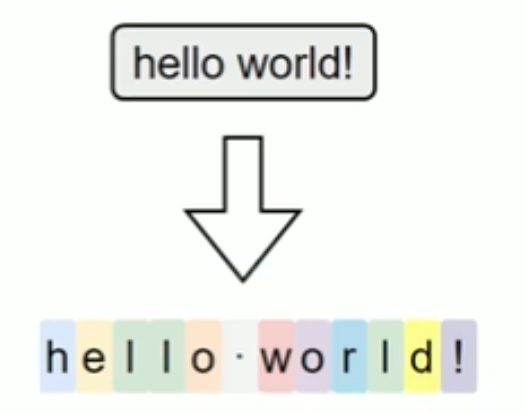
这种分词方式不会有oov问题。
缺陷 :
单个字符语义信息极弱,输入序列长度大大增加。
子词级分词 (subword level)
子词分词,是基于词级分词和字符级分词之间的一种分词方法。它将词语切分成更小的单元:子词(subword),例如:词根、前缀、后缀、词片段。
与词级分词相比,可以缓解OOV问题。
与字符级分词相比,它能更好的保留一定的语义结构。
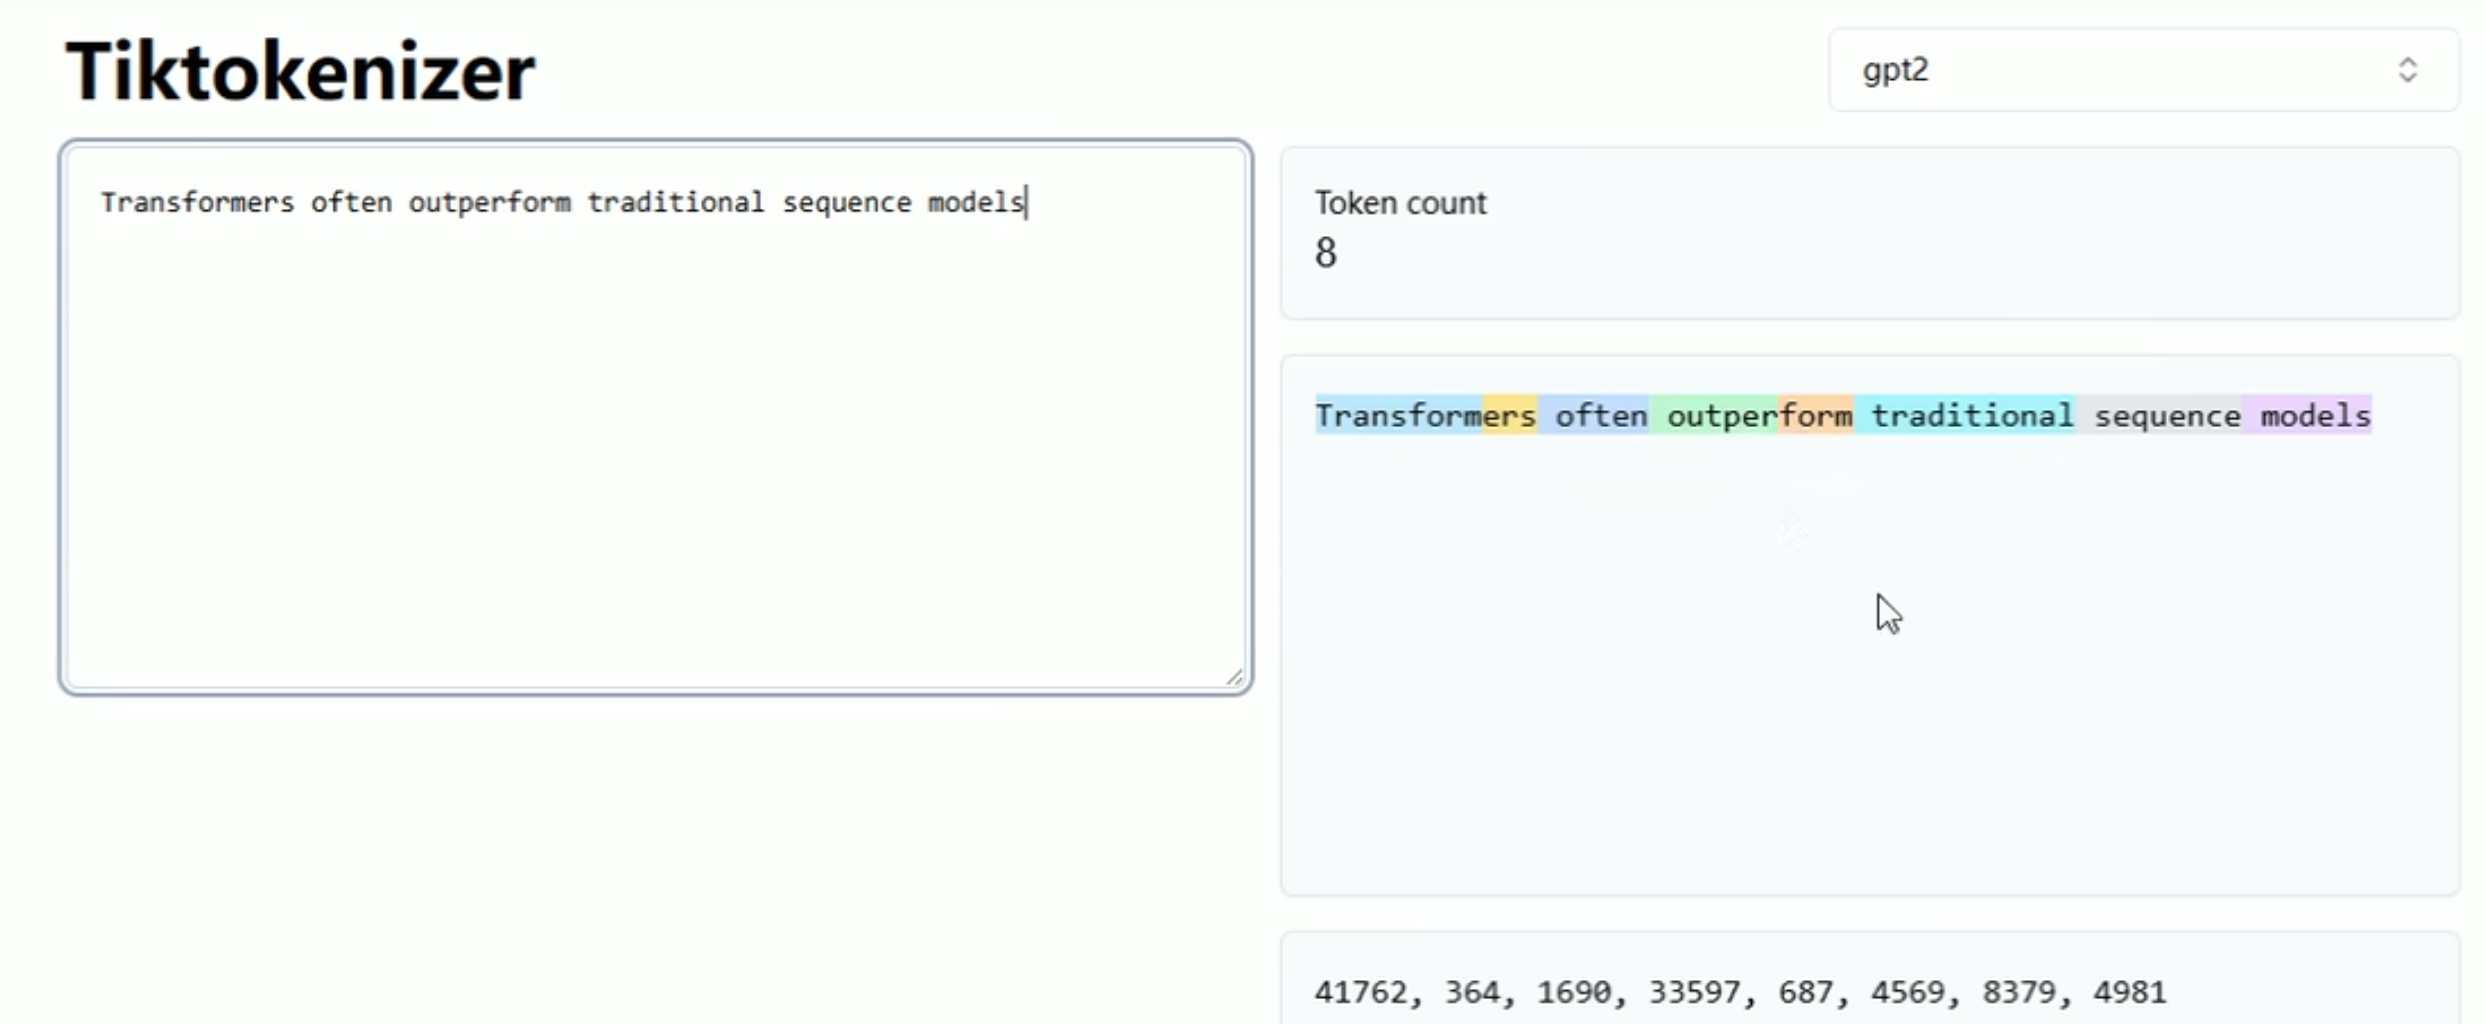
子词分词,可以在 https://tiktokenizer.vercel.app/ 体验,如下图.
图中,有6个单词,用子词级分词,得到8个token。
常见的子词算法有:
- BPE(Byte Pair Encoding)
- WordPiece
- Unigram Language Model
其中,BPE是最早被广泛应用的字词分词方法。其基本思想是,在训练阶段,首先将语料中的词汇拆分为单个字符,构建初始此表;然后统计语料中,出现频率最高的相邻字符对,将其合并为新的子词单元,并加入词表。这个过程持续进行,直到此表达到预设上限。
关于BPE算法,详细可以了解:https://huggingface.co/learn/llm-course/chapter6/5?fw=pt