这里需要注意,下面介绍的所有函数都是在debian系统下的RK3588芯片进行运行的,其CPU框架为aarch64,因此下面所有的函数需要自己核对官方文档是否为同一型号。
参考:rknn-toolkit2/rknn-toolkit2/examples/functions/hybrid_quant at master · airockchip/rknn-toolkit2
背景
之前的文章中,我们介绍通过量化将模型转化为onnx格式,同时在树莓派上利用c++部署onnx的模型。这里我们将通过onnx这个中间态转化为rknn后,将rknn格式利用c++部署在rk3588上。
转化好过后的fp32格式可能会含有两个文件,model.onnx和model.onnx.data
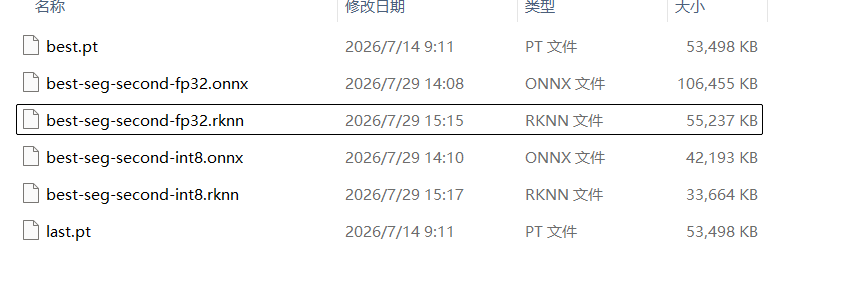
前者虽然显示的是fp32,但是实际上是fp16格式,这是因为rknn的量化没有fp32的格式,这里只是为了方便阅读所以标注为fp32,可以看出其大概为onnx-fp32的0.5倍,同时下面的int8格式采用的是int8和fp16混合的格式,大部分采用int8进行量化,分割头采用fp16回退,这样得到的结果虽然内存相对大一些,但是精度却降低得更少。
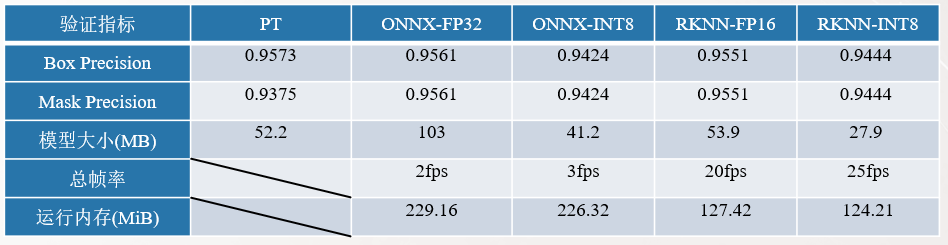
但是其实通过模型得运行内存可以看出,fp32和int8之间无论是onnx还是rknn格式都没有降低太多,这是因为数据采集、预处理等过程更加消耗内存,同时由于其模型使用的是yolov8n-seg,其本身便是最小的实例分割模型,因此量化后运行内存的提升并不明显。
流程
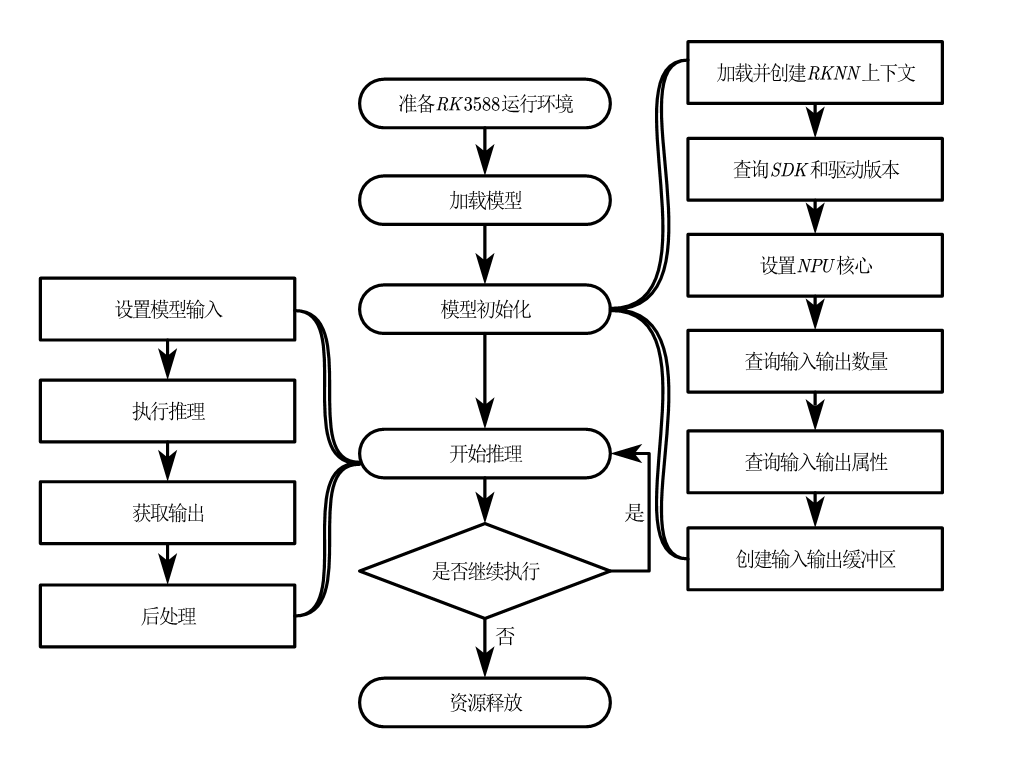
准备RK3588运行环境->加载模型->模型初始化->开始推理->资源释放,其中后处理的方式和onnx完全相同,都是通过nms,但是由于这里是实例分割模型,因此使用二值掩膜输出物体的质心和角度。
可以看出这里加载模型相对于onnx其实提前了,这是因为在加载onnx格式之前还需要确定具体如何执行这个模型,比如分配多少核CPU去处理onnx格式的并行算子,是否进行图优化等。
而rknn则在转化后就基本决定了怎么执行,准确来说也不是提前了,二是rknn将图优化、目标硬件适配等工作提前在量化阶段变完成了,因此后续初始化的目的也与onnx格式不同,其目标便是确定量化好的rknn与板端之间是否有通信、驱动或者硬件之间的问题,同时确定好上下文和输入输出。
准备RK3588运行环境
由于RK各个系列之间算子的兼容性、CPU框架等都不尽相同,因此这一阶段的任务主要是确认开发板的型号以及NPU是否运行等。
确认系统和CPU框架
首先这是一个Linux的系统,我购买的是正点原子的RK3588,其包含安卓和Linux两个系统,安卓系统我不太熟悉,因此重新安装了Linux中Debian的镜像。其本身便是Ubuntu的基础,因此Ubuntu上面的只是在这里也可以使用,后续都在此基础上进行讲解。
查看Linux内核版本
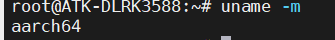
查看处理器架构
最主要的便是确定处理器架构,因此后续在链接动态库中需要的是Linux aarch64版本下的so文件,该so文件在瑞芯微官方存在多个版本,因此需要仔细分辨。通常编译时需要的文件为librknnrt.so(程序运行时使用的动态库)和rknn_api.h(编译时使用的头文件)。
在此需要区分板端和PC端分别需要的文件是什么,PC端通常用于做RKNN的量化,因此需要完整的RKNN-Toolkit2,而这个库只有Linux版本的,因此这需要在你的电脑上安装一下Linux虚拟环境系统。如果你的电脑不算特别老的话,这里建议是直接通过微软在自己系统上安装的WSL软件,其可以直接帮你下载Ubuntu系统,同时其功能和完整的Ubuntu也基本相同,也无需自行分配内存,其可以在指定硬盘内安装。

确认芯片的NPU驱动是否正常
NPU是RK3588最主要的推理模块,同时瑞芯微官方封装好的函数都会使用NPU进行模型的处理。
sudo dmesg | grep -Ei "rknpu|npu"通过sudo dmesg读取完整的内核日志,然后通过grep -Ei "rknpu|npu"来筛选内核日志中带有"rknpu"或者"npu"的日志信息,其无论大小写均可以匹配。-E是因为后面有"|"来表示"或者",-i则表示忽略大小写。
因此其实后面还可以抓取一些错误信息,如再通过管道筛选抓取
sudo dmesg | grep -Ei "rknpu|npu" | grep -i "fail"当然具体的错误肯定不止fail,还有很多其他的,这些不做过多赘述。
通过上面代码来确定NPU驱动是否正常,通常并不能说明NPU驱动完全无法使用,其只要不出现下述关键字,都可以向下执行,直接在程序端口进行进一步检查。
日志关键词 含义 在 RK3588 NPU 中可能表示 严重程度 iommu faultIOMMU 地址转换异常 NPU访问了没有映射、已释放或无权限的内存 高 page fault页地址访问异常 NPU或程序访问了无效虚拟地址 中到高 timeout等待操作超过规定时间 NPU任务长时间未完成或没有返回中断 高 failed to submit提交任务失败 RKNN任务没有成功提交给NPU执行 高 device unavailable设备不可用 RKNN Runtime当前无法使用NPU设备 高 probe failed驱动探测初始化失败 NPU驱动没有成功绑定硬件 很高 reset设备被复位 驱动主动重置NPU,可能是在恢复异常 看是否反复出现 hang设备或任务卡住 NPU任务不再继续执行 高 lockup内核或CPU长时间无法调度 系统级卡死,比普通程序卡住更严重 很高 segmentation fault段错误 C/C++程序访问了非法内存 高
加载模型
// 模型
std::ifstream model_stream(use_model, std::ios::binary | std::ios::ate);

// 模型大小
const std::streamoff model_size = model_stream.tellg();

// 模型数据
std::vector<uint8_t> model_data(static_cast<std::size_t>(model_size));
model_stream.seekg(0, std::ios::beg);
model_stream.read(reinterpret_cast<char*>(model_data.data()),static_cast<std::streamsize>(model_size))
首先通过<fstream>库读取模型信息,然后使用tellg函数进行字节偏移,从而得出的大小,最后通过read函数将模型信息读取进容器中保存。
RKNN常用函数和宏定义
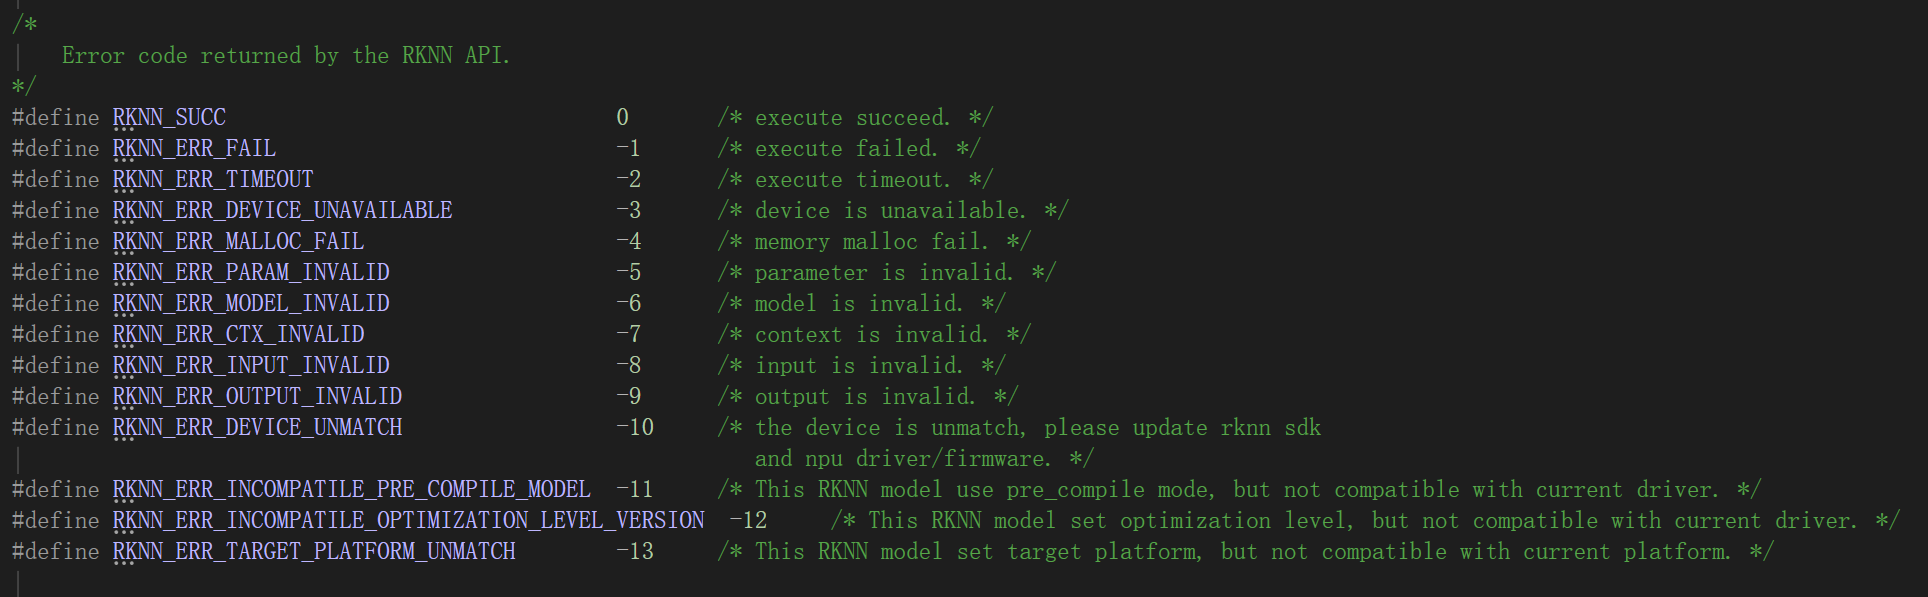
RKNN错误码
在具体讲解模型之前,首先需要补充一下RKNN中错误码的知识,RKNN错误码存在于rknn_api.h中,这个文件可能会因为不同架构不同,因此在具体书写代码之前需要先对该文档进行一个阅读和了解。
|-----------------------------|----|--------|
| RKNN_SUCC | 0 | 成功 |
| RKNN_ERR_FAIL | -1 | 一般性错误 |
| RKNN_ERR_TIMEOUT | -2 | 超时 |
| RKNN_ERR_DEVICE_UNAVAILABLE | -3 | 设备不可用 |
| RKNN_ERR_MOALLOC_FAIL | -4 | 内存分配无效 |
| RKNN_ERR_PARAM_INVALID | -5 | 参数无效 |
| RKNN_ERR_MODEL_INVALID | -6 | 模型无效 |
查询参数信息--rknn_query
int rknn_query(
    rknn_context context,         // 上下文权柄
    rknn_query_cmd cmd,           // 需要查找参数的信息
    void* info,                   // 输出信息
    uint32_t size                 // 输出信息的大小
);

// 返回RKNN错误码
在使用这个函数之前,通常需要创建该参数对应的结构体
|------------------------|----------|---------------------------------|
| cmd(需要查找的参数信息) | 意义 | 结构体 |
| RKNN_QUERY_SDK_VERSION | SDK和驱动版本 | rknn_sdk_version sdk_version{}; |
| RKNN_QUERY_IN_OUT_NUM | 输入输出数量 | rknn_input_output_num io_num{}; |
| RKNN_QUERY_INPUT_ATTR | 输入张量属性 | rknn_tensor_attr input_attr{}; |
| RKNN_QUERY_OUTPUT_ATTR | 输出张量属性 | rknn_tensor_attr output_attr{}; |
| RKNN_QUERY_MEM_SIZE | 模型内存信息 | rknn_mem_size mem_size{}; |
| RKNN_QUERY_PERF_RUN | 推理耗时 | rknn_perf_run perf_run{}; |RKNN_QUERY_SDK_VERSION:其有两个char类型的参数api_version256、drv_version256,第一个参数储存程序运行时实际加载的RKNN Runtime/API版本,第二个参数表示当前NPU内核驱动版本。
RKNN_QUERY_IN_OUT_NUM:其有两个uint32_t类型的参数n_input、n_output,第一个参数表示输入参数数量,第二参数表示输出参数数量。
RKNN_QUERY_INPUT_ATTR:其参数较多,放在下面做介绍
RKNN_QUERY_OUTPUT_ATTR:同RKNN_QUERY_INPUT_ATTR
RKNN_QUERY_MEM_SIZE:其参数如下
|----------|--------------------------|--------------------------|
| 类型 | 参数 | 意义 |
| uint32_t | total_weight_size | 模型权重运行时需要的内存 |
| uint32_t | total_internal_size | 模型推理中间张量和工作区需要的内存,不包括缓冲区 |
| uint64_t | total_dma_allocated_size | 当前分配的DMA相关内存总量 |
| uint32_t | total_sram_size | RKNN预留或使用的系统SRAM规模 |
| uint32_t | free_sram_size | 当前这部分预留SRAM中还剩多少可用空间 |
| uint32_t | reserved10 | 为上面结果预留的位置 |这个并不能查找全部的内存信息,其需要使用"cat /proc/进程PID/status"来进行查找,其主要查看RSS(当前实际占用内存)和HWM(运行以来最高RSS)即可。
RKNN_QUERY_PERF_RUN:其仅有一个int64_t类型的参数run_duration,表示最近一次模型推理的运行时间,单位是微秒。
张量属性--rknn_tensor_attr
在使用查找张量属性之前需要将rknn_tensor_attr.index=0
字段 含义 对程序的作用 index张量编号 区分第几个输入或输出 name张量名称 检查是否为预期节点 n_dims维度数量 例如四维图像张量 dims[]每个维度的大小 确定输入高、宽、通道和批次 n_elems元素总数 检查张量元素数量 size不考虑额外步长时的字节数 普通逻辑数据大小 size_with_stride包含对齐或步长后的字节数 零拷贝申请内存时尤其重要 fmtNCHW、NHWC等格式决定数据排列方式 typeUINT8、INT8、FP16、FP32等决定输入数据类型 qnt_type量化类型 判断是否采用仿射量化等 zp零点 仿射量化参数 scale缩放系数 仿射量化或反量化参数 w_stride宽方向步长 判断是否存在宽度填充 h_stride高方向步长相关配置 设置IO内存时使用
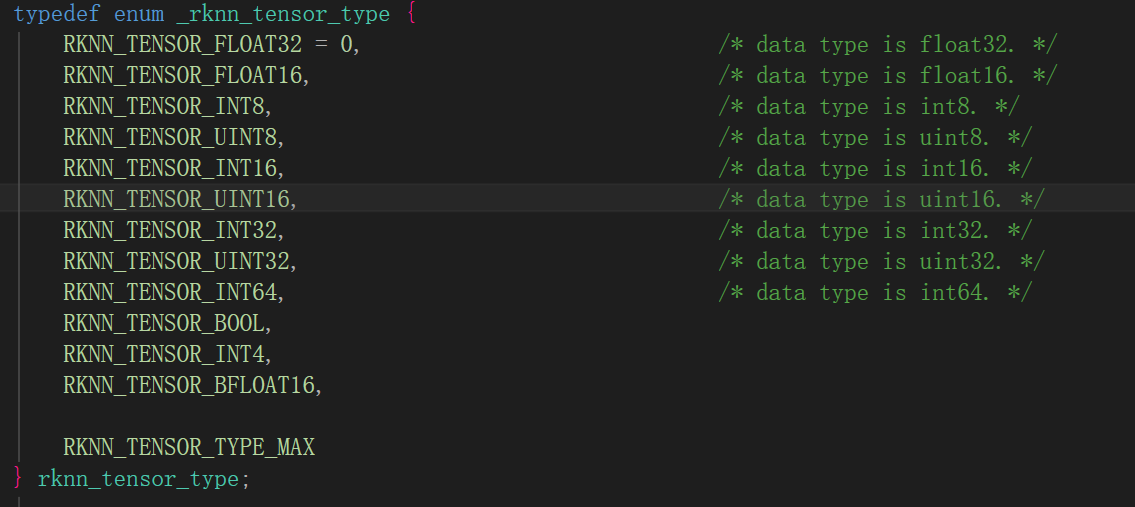
数据类型
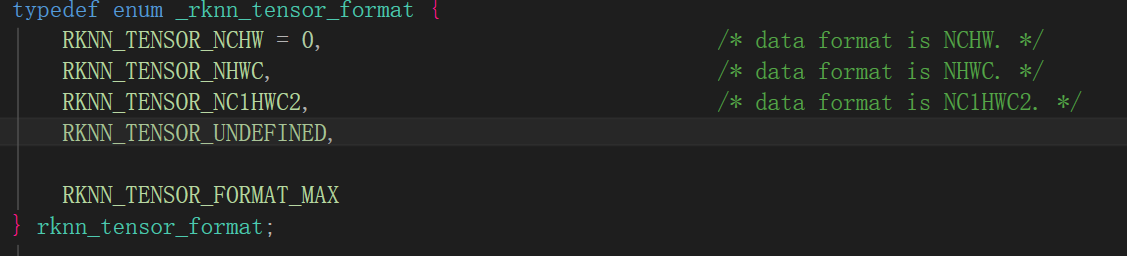
数据格式
模型初始化
加载并创建上下文
int rknn_init(
    rknn_context* context,         // 上下文--类成员
    void* model,                   // 模型数据
    uint32_t size,                 // 模型大小
    uint32_t flag,                 // 初始化标志
    rknn_init_extend* extend       // 额外扩展信息
);

// 返回RKNN错误码
|-----------------------------|----------------------------|
| 初始化标志 | 意义 |
| 0(默认) | 无设置 |
| RKNN_FLAG_PRIOR_HIGH | 设置高优先级环境 |
| RKNN_FLAG_PRIOR_MEDIUM | 设置中优先级环境 |
| RKNN_FLAG_PRIOR_LOW | 设置低优先级环境 |
| RKNN_FLAG_ASYNC_MASK | 异步模式 |
| RKNN_FLAG_COLLECT_PERF_MASK | 性能采集模式 |
| RKNN_FLAG_MEM_ALLOC_OUTSIDE | 将所有内存分配到外部,包括权重/内部/输入/输出部分 |RKNN_FLAG_PRIOR_HIGH/MEDIUM/LOW:在系统有多个任务时,通过这个标志分配任务的优先级
RKNN_FLAG_ASYNC_MASK:异步模型,启用后,rknn_outputs_get直接获取上一帧的结果,从而提高单线程模式下的帧率,但代价是 rknn_outputs_get 无法获取当前帧的结果。 在多线程模式下,无需开启此模式。
RKNN_FLAG_COLLECT_PERF_MASK:启用后,可通过 rknn_query(...) 中获取详细的性能报告,但会降低帧率。
RKNN_FLAG_MEM_ALLOC_OUTSIDE:将所有内存分配到外部,包括权重/内部/输入/输出部分。
查询SDK和驱动版本
同上面查询参数信息所述
rknn_sdk_version sdk_version{};
rknn_query(
    context_,
    RKNN_QUERY_SDK_VERSION,
    &sdk_version,
    sizeof(sdk_version)
)
std::cout << "RKNN API: " << sdk_version.api_version
          << ", 驱动: " << sdk_version.drv_version << std::endl;
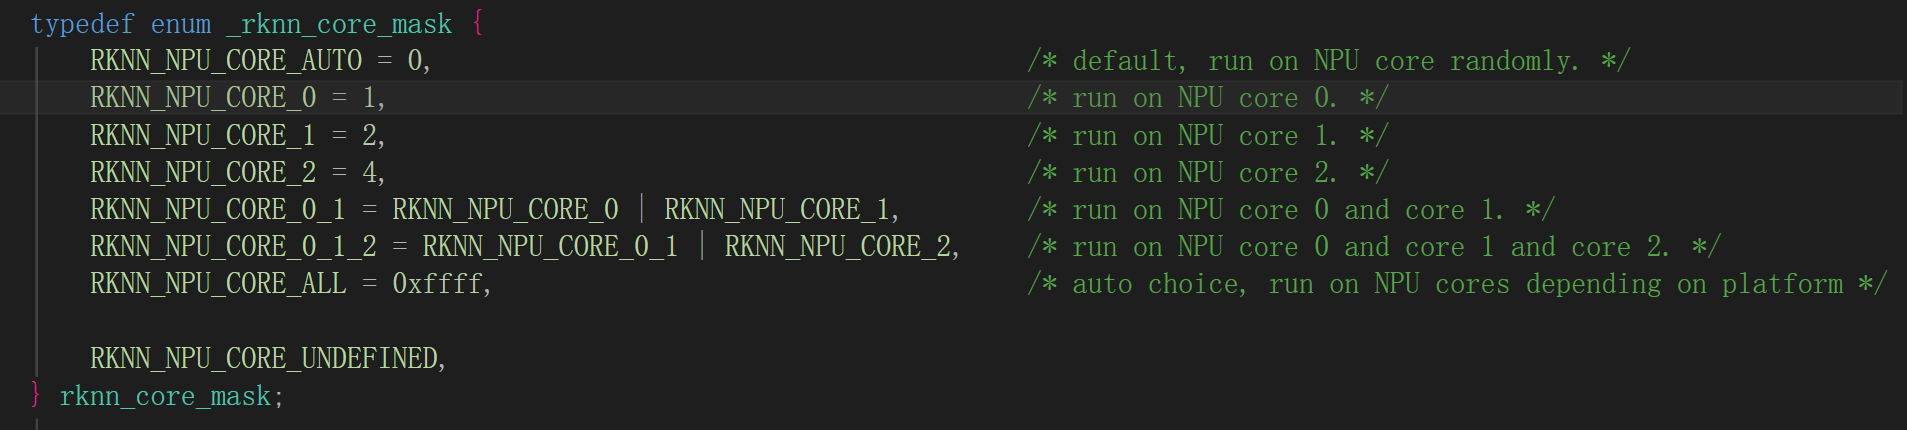
设置NPU核心
int rknn_set_core_mask(
    rknn_context context,         // 模型上下文
    rknn_core_mask core_mask      //
);

// 返回RKNN错误码
|---------------------|--------------------------------------|--------------------|
| core_mask | 数字 | 意义 |
| RKNN_NPU_CORE_AUTO | 0 | 默认,会在NPU上随机运行 |
| RKNN_NPU_CORE_0 | 1 | 在NPU0上运行 |
| RKNN_NPU_CORE_1 | 2 | 在NPU1上运行 |
| RKNN_NPU_CORE_2 | 4 | 在NPU2上运行 |
| RKNN_NPU_CORE_0_1 | RKNN_NPU_CORE_0 | RKNN_NPU_CORE_1 | 在NPU0和NPU1上运行 |
| RKNN_NPU_CORE_0_1_2 | RKNN_NPU_CORE_0_1 | RKNN_NPU_CORE_2 | 在NPU0、NPU1和NPU2上运行 |
| RKNN_NPU_CORE_ALL | 0xffff | 自动选择,据情况选择运行平台 |
查询输入输出数量
同上面查询参数信息所述
rknn_input_output_num io_num_{};
rknn_query(
    context_,
    RKNN_QUERY_IN_OUT_NUM,
    &io_num_,
    sizeof(io_num_))
查询输入输出属性
同上面查询参数信息所述
std::vector<rknn_tensor_attr> input_attrs_;
std::vector<rknn_tensor_attr> output_attrs_;

input_attrs_.assign(io_num_.n_input, rknn_tensor_attr{});
for (uint32_t index = 0; index < io_num_.n_input; ++index) {
    input_attrs_[index].index = index;
    rknn_query(
        context_,
        RKNN_QUERY_INPUT_ATTR,
        &input_attrs_[index],
        sizeof(rknn_tensor_attr)));
}

output_attrs_.assign(io_num_.n_output, rknn_tensor_attr{});
for (uint32_t index = 0; index < io_num_.n_output; ++index) {
    output_attrs_[index].index = index;
    rknn_query(
        context_,
        RKNN_QUERY_OUTPUT_ATTR,
        &output_attrs_[index],
        sizeof(rknn_tensor_attr)));
}
创建输入输出缓冲区
在此之前通常都需要确定这个输入和输出的维度、长度等信息是否正确。
普通接口
普通接口的输入由程序管理,输出由RKNN Runtime自动分配。
所需要的函数
rknn_inputs_set();
rknn_run();
rknn_outputs_get();
rknn_outputs_release();
均会在下面介绍
零拷贝接口
开始推理
设置模型输入
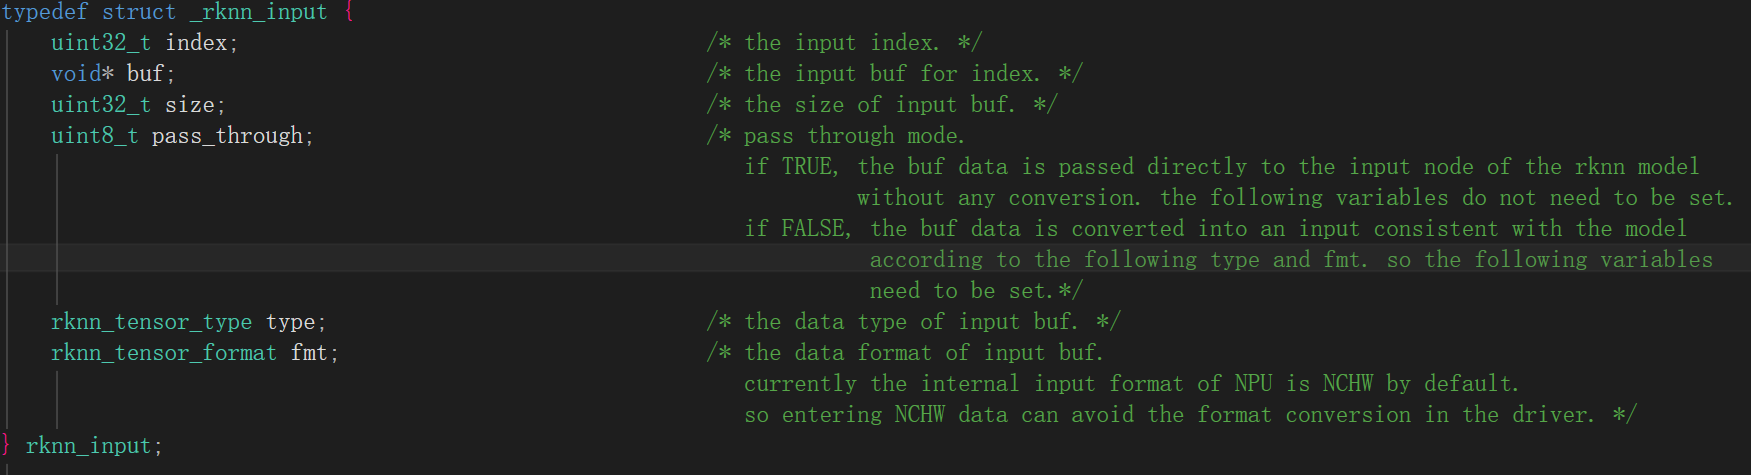
输入格式--rknn_input
rknn_input input{};
input.index = 0;
input.buf = img.get_image_buffer();
input.size = static_cast<uint32_t>(img.get_image_size());
input.pass_through = 0;
input.type = RKNN_TENSOR_UINT8;
input.fmt = RKNN_TENSOR_NHWC;
index:输入索引
buf:输入数据
size:输入大小
pass_through:通过模式。若为真,则会将buf数据直接传递给RKNN模型的输入节点,无需任何转换。若为假,则会将buf数据转换为与模型相一致的输入形式,其会根据以下类型和格式进行设置。因此需要设置后续变量。
type:输入数据类型
fmt:输入数据格式。NPU的内部输入格式默认为NCHW。
设置输入数据--rknn_inputs_set
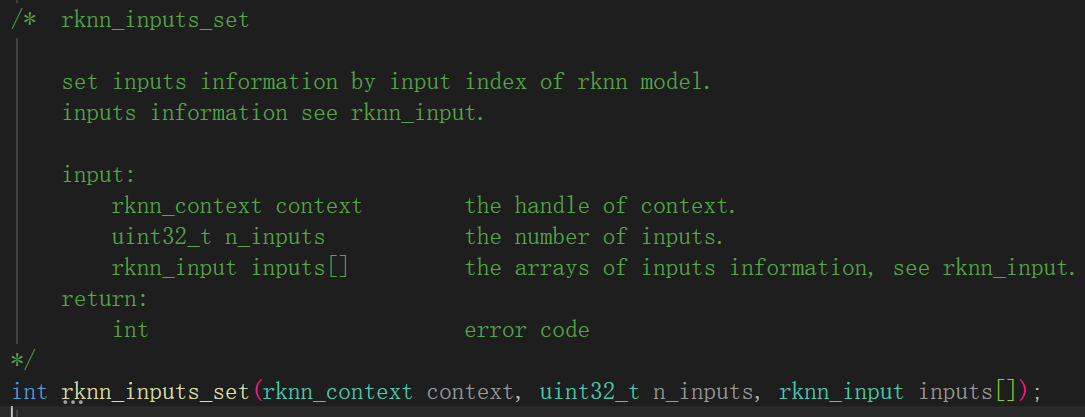
rknn_inputs_set(context_, 1, &input)输入:context:模型上下文
n_inputs:输入数量
input\[\]:输入信息
输出:RKNN错误码
执行推理--rknn_run
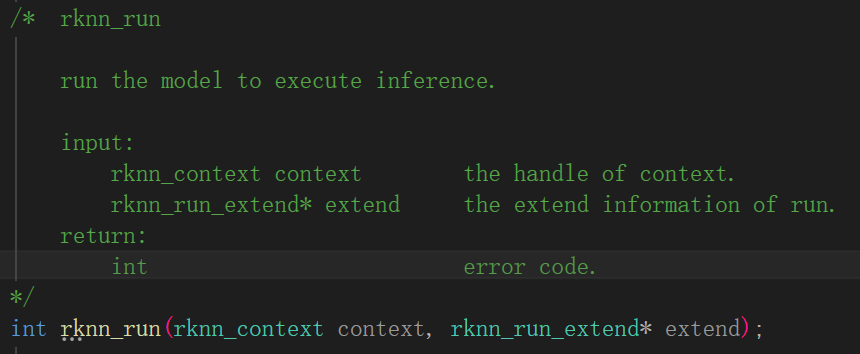
rknn_run(context_, nullptr)输入:context:模型上下文
extend:
输出:RKNN错误码
获取输出
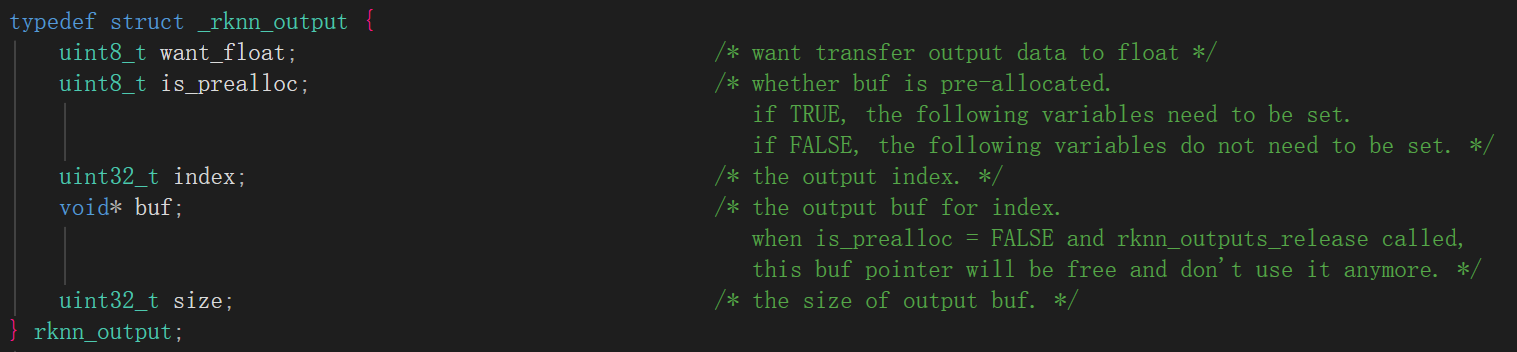
输出格式--_rknn_output
std::vector<rknn_output> outputs(io_num_.n_output);
for (uint32_t index = 0; index < io_num_.n_output; ++index) {
    outputs[index].index = index;
    outputs[index].want_float = 1;
    outputs[index].is_prealloc = 0;
}
输入:want_float:是否将模型原始输出通过反量化转化为float32
is_prealloc:输出缓存区是否已经提前申请好了,这是也是普通接口和零拷贝接口最明显的特征,当为false时,下面的参数无法填写,当为true时,则需要填写
index:输出索引
buf:输出数据
size:输出大小
释放上一帧出错时的资源
在程序运行中,获得输出数据后,将输出数据缓存在输出缓存区,但是在后续后处理中出现问题,提前return或者抛出异常,输出缓存区中的数据并不会自动清空,因此在每次分配输出缓存区时需要释放上一帧出错的资源。
但是如果上一帧没有出错,这一帧仍然释放则会出现重复释放的问题,因此通常需要一个标志符判断。
class RknnOutputsGuard {
    public:
        RknnOutputsGuard(rknn_context context, std::vector<rknn_output>& outputs)
            : context_(context), outputs_(outputs) {
        }

        RknnOutputsGuard(const RknnOutputsGuard&) = delete;
        RknnOutputsGuard& operator=(const RknnOutputsGuard&) = delete;

        void arm() noexcept {
            active_ = true;
        }

        ~RknnOutputsGuard() {
            if (!active_) {
                return;
            }

            const int result = rknn_outputs_release(
                context_,
                static_cast<uint32_t>(outputs_.size()),
                outputs_.data());
            if (result != RKNN_SUCC) {
                std::cerr << "rknn_outputs_release 失败,RKNN 错误码: "
                          << result << std::endl;
            }
        }

    private:
        rknn_context context_;
        std::vector<rknn_output>& outputs_;
        bool active_{false};
};
RknnOutputsGuard output_guard(context_, outputs);
其实这也类似于多线程中的RAII资源守卫,在成功获取输出数据后,调用类成员函数arm将标识符转为true。
设置输出数据--rknn_outputs_set
rknn_outputs_get(context_, io_num_.n_output, outputs.data(), nullptr)输入:context:模型上下文
n_outputs:输出个数
outputs\[\]:输出数据
extend:输出扩展内容
输出:RKNN错误码
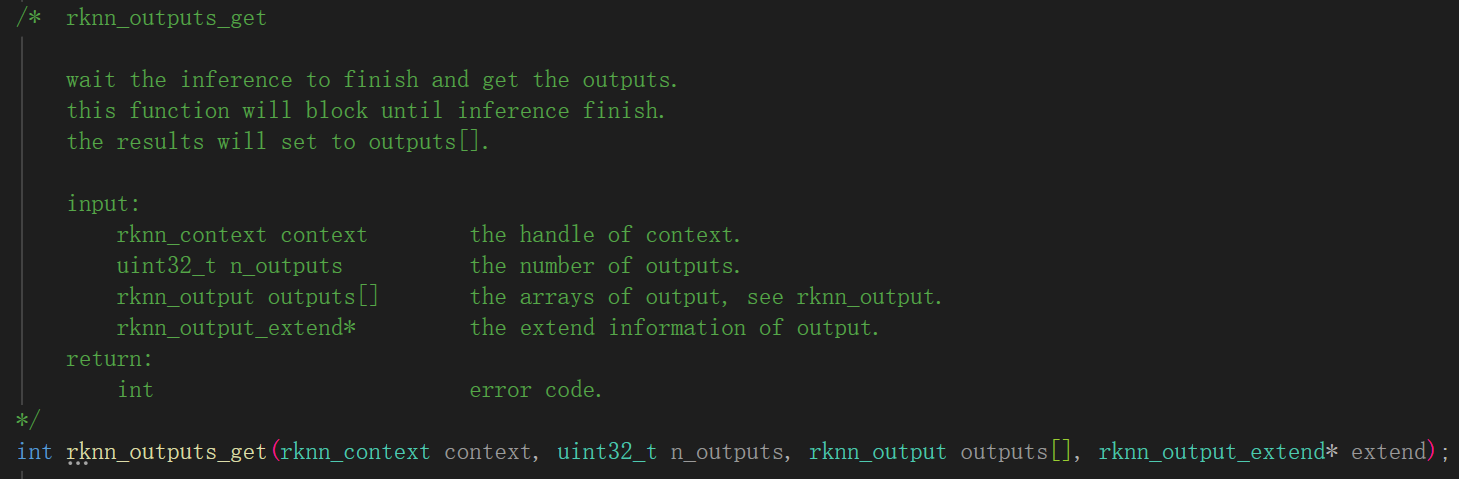
获取输出数据
const rknn_output& detection_output = outputs[detection_output_index_];
const rknn_output& prototype_output = outputs[prototype_output_index_];
后处理
后处理的详细介绍可以查看"c++运行onnx模型"这篇文章,后处理都相同,这里不做过多介绍
资源释放
由于RK3588有自己的上下文,因此需要在析构函数中删除,而官方的rknn_destroy函数便是实现此功能
void ClassifyModel::destroy_context() noexcept {
    if (context_ == 0) {
        return;
    }

    const int result = rknn_destroy(context_);
    if (result != RKNN_SUCC) {
        std::cerr << "rknn_destroy 失败,RKNN 错误码: " << result << std::endl;
    }
    context_ = 0;
}
后台查看模型运行情况
查看RK3588三个核心的实时负载
sudo cat /sys/kernel/debug/rknpu/load
查看RK3588运行内存
sudo cat /proc/进程PID/status