note
- GLM-5.3-Flash模型:320B总参数,19B激活参数。在编码和智能体评估方面,GLM-5.3-Flash 的表现接近 Claude Opus 4.8 的水平。
- 基准上 MVBench 约 77.8,MMVU 约 80.5,属 Flash 级多模态视频理解可用水平,但不支持音频输入
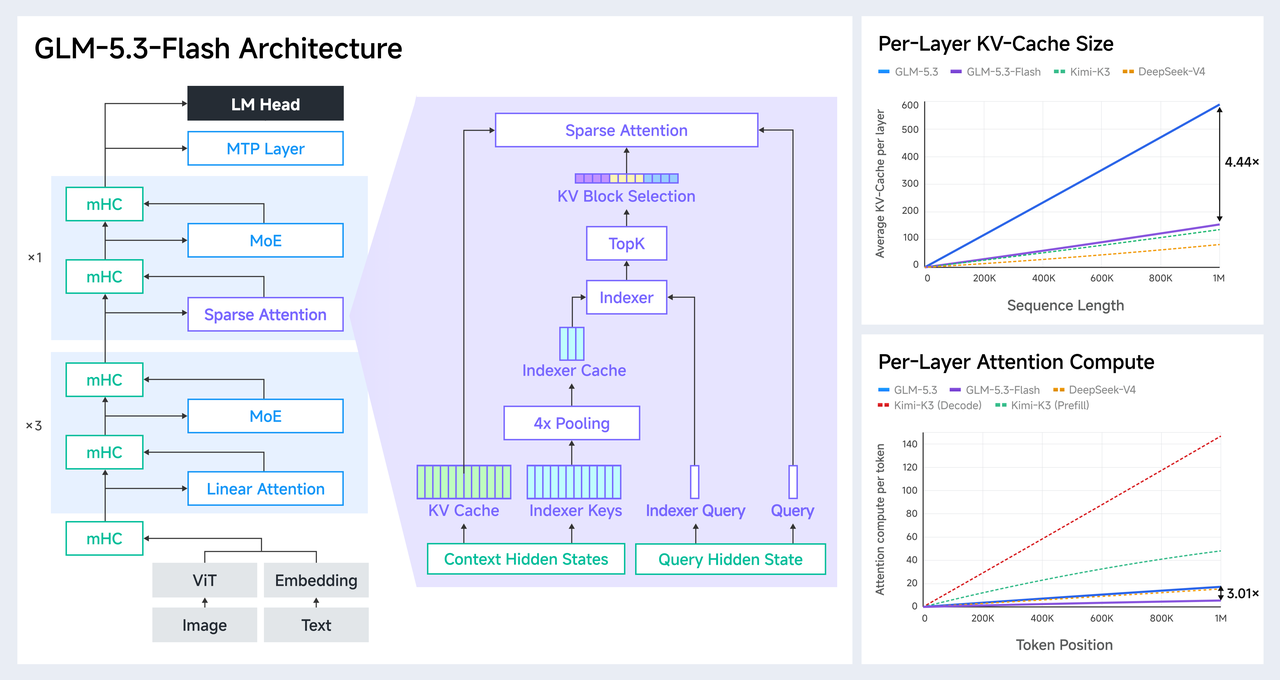
- GLM-5.3-Flash 在多个方面进行了架构改进。首次引入了混合式架构,结合了稀疏注意力机制和线性注意力机制,从而显著降低了长上下文服务的成本,同时保留了精确的长上下文处理能力。此外,采用了 Manifold-Constrained Hyper-Connections(mHC)技术,进一步提升了扩展效率。结合最新的 30T 令牌多模态预训练语料库,这些改进使得 GLM-5.3-Flash 能够在较少的计算资源下实现更强大的性能。
文章目录
一、模型架构
二、效果
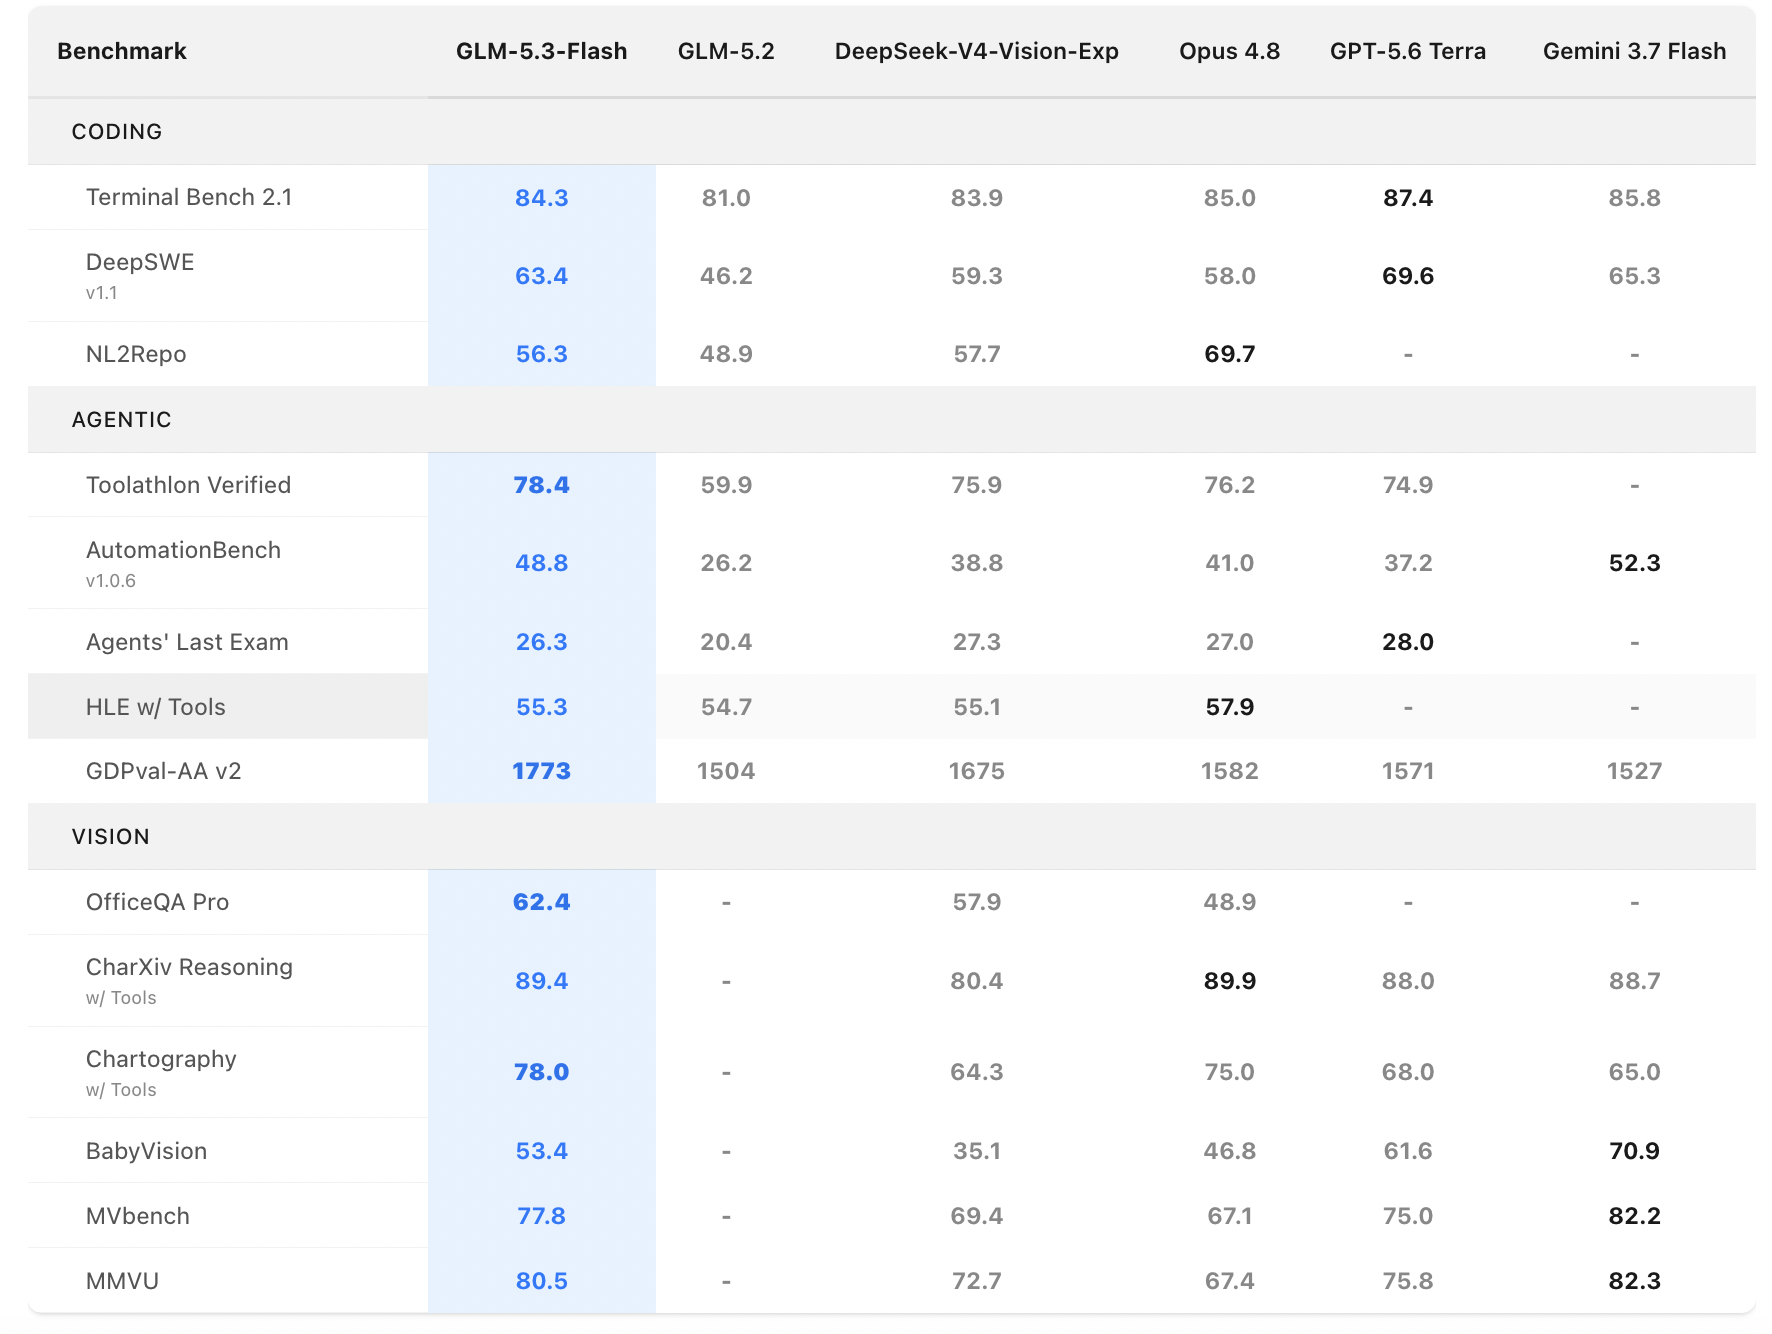
MVBench 和 MMVU:我们使用的参数设置为温度=1.0,top_p=0.95,最大上下文长度为 256K 个令牌。对于那些原生支持视频输入的模型,比如 Gemini 3.7 Flash,我们可以直接将原始视频作为输入进行评估。而对于那些不支持视频输入的模型,我们会采用默认的 1 帧每秒的提取策略。如果提取出的帧数超过 API 的最大限制,我们会在整个视频范围内进行均匀采样,直到达到这个最大帧数限制为止。
Reference
1 https://docs.z.ai/guides/vlm/glm-5.3-flash
2 https://huggingface.co/zai-org/GLM-5.3-Flash
3 GLM-5.3: Frontier Coding with Emergent Cyber Capabilities:https://z.ai/blog/glm-5.3