一、StrOutputParser
1. 场景需求
以第一次模型的输出结果,拿去第二次询问模型
python
from langchain_core.prompts import PromptTemplate
from langchain_ollama import ChatOllama

model = ChatOllama(model="gemma4:12b")

prompt = PromptTemplate.from_template(
    "我是{band}乐队的粉丝,帮我推荐一首音乐,仅告知歌曲名称,无需其他内容"
)

chain = prompt | model

res = chain.stream({"band": "Beyond"})
for chunk in res:
print(chunk, end="", flush=True)现在需要:chain = prompt | model | model,参与链的构建的组件完全符合要求,但运行会报错
ValueError: Invalid input type <class 'langchain_core.messages.ai.AIMessageChunk'>. Must be a PromptValue, str, or list of BaseMessages.
首先,提示词模板PromptTemplate.from_template(即prompt )是PromptValue类型
model的输入是PromptValue | str | Sequence[MessageLikeRepresentation]类型,输出是AIMessage类对象
故类型不对,通过LangChain内置的解析器StrOutputParser字符串输出解析器完成类型转换
2. StrOutputParser字符串输出解析
StrOutputParser是LangChain内置的简单字符串解析器
- 可以将
AIMessage解析为简单的字符串,符合了模型invoke方法要求(可传入字符串,不接收AIMessage类型) - 是Runnable接口的子类(可以加入链)
parser = StrOutputParser()
chain = prompt | model | parser |model
| 组件名称 | 输入类型 | 输出类型 |
|---|---|---|
| PromptTemplate.from_template | 可占位的str | PromptValue |
| model | PromptValue \ str \ SequenceMessageLikeRepresentation | AIMessage |
| StrOutputParser | AIMessage | str |
3. 完整流程
chain = prompt | model | parser | model
prompt --输出--> PromptValue类型 -> model --输出--> AIMessage类型 -> parser --输出--> str类型 -> model --输出--> AIMessage类型,res为AIMessage类型,通过res.content()拿到模型输出的内容
python
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_ollama import ChatOllama

model = ChatOllama(model="gemma4:12b")

prompt = PromptTemplate.from_template(
    "我是{band}乐队的粉丝,你最喜欢的是哪首歌?仅输出一首歌曲的名称即可"
)

parser = StrOutputParser()

chain = prompt | model | parser | model

res = chain.stream({"band": "Beyond"})
for chunk in res:
print(chunk.content, end="", flush=True)也可以再加一个parser,拿到str类型,chain = prompt | model | parser | model | parser,res直接输出即可
python
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_ollama import ChatOllama

model = ChatOllama(model="gemma4:12b")

prompt = PromptTemplate.from_template(
    "我是{band}乐队的粉丝,你最喜欢的是哪首歌?仅输出一首歌曲的名称即可"
)

parser = StrOutputParser()

chain = prompt | model | parser | model | parser

res = chain.stream({"band": "Beyond"})
for chunk in res:
    print(chunk, end="", flush=True)
二、JsonOutputParser
1. 问题分析
StrOutputParser中有个问题:直接拿模型给的结果再次喂给模型,第一次模型给的数据并没有进行处理
即上一个模型的输出,没有被处理就输入给了下一个模型
标准的做法流程如下:

为了符合标准做法,需要加入数据处理和提示词模板功能
模型输入:PromptValue | str | Sequence[MessageLikeRepresentation],输出:AIMessage
提示词模板输入:dict字典,输出PromptValue
数据处理:将AIMessage转为dict字典输出

2. 数据处理和提示词模板
数据处理:将AIMessage转为dict字典输出
StrOutputParser:AIMessage转为str
JsonOutputParser:AIMessage转为Dist(JSON)
python
from langchain_core.output_parsers import StrOutputParser, JsonOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_ollama import ChatOllama

str_parser = StrOutputParser()
json_parser = JsonOutputParser()

model = ChatOllama(model="gemma4:12b")

first_prompt = PromptTemplate.from_template(
    "我朋友姓:{lastname},刚生了一个{gender},帮我起一个名字"
    "封装到Json格式返回,要求key是name,value是你给的名字,请简要回答,只需要提供一个名字即可,严格遵守格式要求。"
)

second_prompt = PromptTemplate.from_template(
    "姓名{name},这个名字怎么样?"
)

"""
chain = first_prompt | model | json_parser
res = chain.invoke({"lastname":"薛","gender":"女"})
print(res) # {'name': '薛若汐'}
print(type(res)) #<class 'dict'>
"""

chain = first_prompt | model | json_parser | second_prompt | model | str_parser
res = chain.stream({"lastname": "薛", "gender": "女"})

for chunk in res:
    print(chunk, end="", flush=True)
chain = first_prompt | model | json_parser | second_prompt | model | str_parser

三、自定义函数加入链
StrOutputParser:AIMessage转为str
JsonOutputParser:AIMessage转为Dist(JSON)
LangChain还支持编写Lambda匿名函数来实现自定义逻辑的数据转换,需要基于RunnableLambda类实现
RunnaLambda类是LangChain内置的,将普通函数等转换为Runnable接口实例,方便自定义函数加入chain
语法:RunnableLambda(函数对象或lambda匿名函数)
通过自定义函数my_func = RunnableLambda(lambda ai_msg: {"name": ai_msg.content})实现自定义逻辑的数据转换,输入AIMessage,输出str(AIMessage的name所对应的内容)
python
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnableLambda
from langchain_ollama import ChatOllama

str_parser = StrOutputParser()

# 输入:AIMessage  输出:Dict("name":"XXX")
my_func = RunnableLambda(lambda ai_msg: {"name": ai_msg.content})

model = ChatOllama(model="gemma4:12b")

first_prompt = PromptTemplate.from_template(
    "我朋友姓:{lastname},刚生了一个{gender},帮我起一个名字"
    "封装到Json格式返回,要求key是name,value是你给的名字,请简要回答,只需要提供一个名字即可,严格遵守格式要求。"
)

second_prompt = PromptTemplate.from_template(
    "姓名{name},这个名字怎么样?"
)

"""
chain = first_prompt | model | (lambda ai_msg:{"name":ai_msg.content})
res = chain.stream({"lastname": "薛", "gender": "女"})

for chunk in res:
    print(chunk, end="", flush=True)
"""

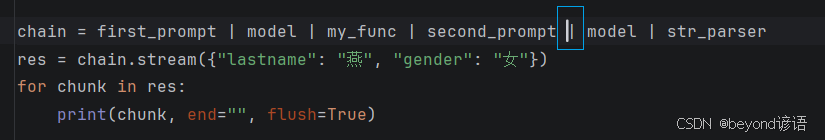
chain = first_prompt | model | my_func | second_prompt | model | str_parser
res = chain.stream({"lastname": "燕", "gender": "女"})
for chunk in res:
    print(chunk, end="", flush=True)
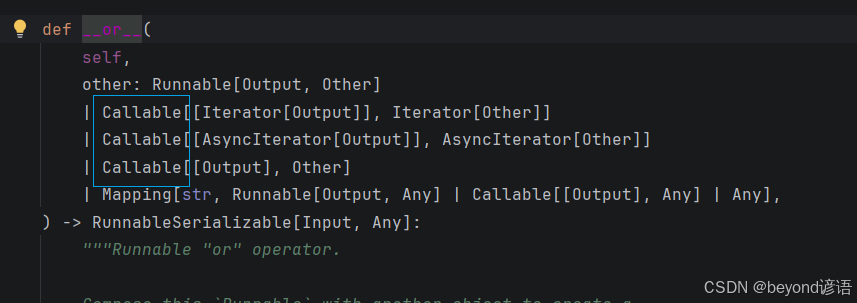
chain中的或运算符是支持Callable参数的,故可以提供lambda直接传入