AI Infra实战02:GPU监控实战,用DCGM+Prometheus+Grafana看清每一张卡
本篇配套的全部脚本、YAML、Helm Chart、预检工具和 Terraform 配置已开源在 GitHub:https://github.com/Jich1123/gpu-k8s-lab 。clone 下来按
00-lab/execution-checklist.md的顺序执行即可复现全部实验(仓库不含任何真实 IP、密钥或账号信息)。
本篇目标
在上一篇(GPU Operator)的基础上,接入 NVIDIA DCGM Exporter 采集 GPU 指标,部署 kube-prometheus-stack(Prometheus + Grafana),让你在 Grafana 面板上实时看到每张 GPU 的利用率、显存、温度和功耗,并配置 GPU 告警规则。
学完本篇你将掌握:
- DCGM Exporter 是什么、采集了哪些 GPU 指标
- 如何让 Prometheus 通过 ServiceMonitor 自动发现 DCGM 指标
- 如何在 Grafana 自动加载 GPU 监控面板
- 如何配置 GPU 告警规则(温度过高、利用率为零)
- 空闲 vs 满载状态下 GPU 面板的真实对比
证据等级:B级实验复现。本篇所有命令和输出来自一次真实执行(AWS g4dn.xlarge / T4),Grafana 截图为真实面板。
实操环境
| 配置 | 值 |
|---|---|
| 平台 | AWS EC2 g4dn.xlarge |
| GPU | Tesla T4(16GB显存) |
| 系统 | Ubuntu 22.04.5 LTS |
| 驱动 | 595.84 / CUDA 13.2 |
| k3s | v1.34.10+k3s1 |
| GPU Operator | 已部署(上一篇完成) |
| kube-prometheus-stack | 88.5.2 |
| 费用 | 约 0.526/小时,本篇实操约 0.2 |
一、监控链路全景
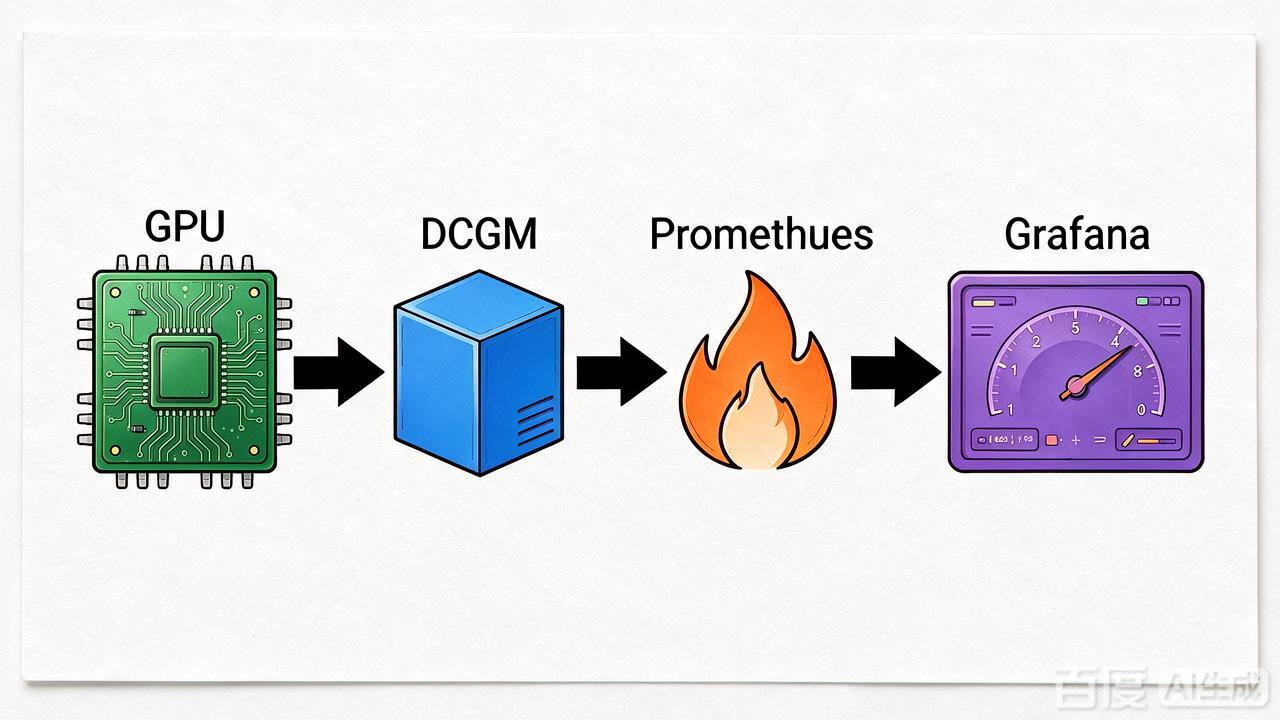
GPU 监控链路一共四环,缺一不可:
GPU 硬件
  ↓
DCGM Exporter(采集 GPU 指标,暴露 /metrics 端口 9400)
  ↓
Prometheus(通过 ServiceMonitor 自动发现并抓取)
  ↓
Grafana(展示面板 + 告警)
GPU Operator 在上一篇已经部署了 DCGM Exporter(你可能注意到 nvidia-dcgm-exporter Pod 已经在跑了)。这一篇要做的是:把 Prometheus 和 Grafana 接上去,让数据"可见"。
二、部署 kube-prometheus-stack
一条 Helm 命令搞定 Prometheus + Grafana + Alertmanager 全家桶:
bash
export GRAFANA_ADMIN_PASSWORD='你的临时密码'
bash install-monitoring.sh
脚本分两步 Helm 操作,这个顺序很关键:
第一步,装 kube-prometheus-stack(此时 Prometheus Operator 的 CRD 才会被创建,尤其是 ServiceMonitor 这个 CRD):
bash
helm upgrade --install kube-prometheus-stack prometheus-community/kube-prometheus-stack \
  --namespace monitoring --create-namespace \
  --values kube-prometheus-stack-values.yaml \
  --set-string grafana.adminPassword="$GRAFANA_ADMIN_PASSWORD" --wait
第二步,等 CRD 就绪后,再回头升级 GPU Operator,让它创建 DCGM 的 ServiceMonitor:
bash
helm upgrade gpu-operator nvidia/gpu-operator --reuse-values \
  --set dcgmExporter.serviceMonitor.enabled=true \
  --set dcgmExporter.serviceMonitor.interval=15s \
  --set-string dcgmExporter.serviceMonitor.additionalLabels.release=kube-prometheus-stack
这里有两个关键点:
- 顺序不能反:ServiceMonitor 是 Prometheus Operator 定义的 CRD,必须先装 kube-prometheus-stack 把这个 CRD 建出来,GPU Operator 才能创建 ServiceMonitor。反过来会报"no matches for kind ServiceMonitor"。
additionalLabels.release=kube-prometheus-stack是最容易漏的一步 :kube-prometheus-stack 的 Prometheus 默认只抓带release=kube-prometheus-stack标签的 ServiceMonitor。DCGM 的 ServiceMonitor 不打这个标签,Prometheus 就"看不见"它,指标永远抓不到。很多人 GPU 监控没数据,就卡在这个标签上。
脚本最后还做了两件事:应用 GPU 告警规则(gpu-alert-rules.yaml),以及把 Grafana 面板 JSON 做成 ConfigMap 并打上 grafana_dashboard=1 标签,Grafana 的 sidecar 会自动发现并加载这个面板,不用手动导入。
关键输出:
Release "kube-prometheus-stack" does not exist. Installing it now.
STATUS: deployed
NAMESPACE: monitoring
安装脚本做了三件事:
- 部署 kube-prometheus-stack(Prometheus + Grafana + Alertmanager + node-exporter + kube-state-metrics)
- 升级 GPU Operator(REVISION 2),让它创建 DCGM 的 ServiceMonitor,Prometheus 就能自动发现 DCGM 指标
- 注入 GPU 告警规则和 Grafana Dashboard(通过 ConfigMap + 标签,Grafana 自动加载)
等约1分钟,检查组件状态:
bash
kubectl get pods -n monitoringalertmanager-kube-prometheus-stack-alertmanager-0 2/2 Running
kube-prometheus-stack-grafana-... 3/3 Running
kube-prometheus-stack-kube-state-metrics-... 1/1 Running
kube-prometheus-stack-operator-... 1/1 Running
kube-prometheus-stack-prometheus-node-exporter-... 1/1 Running
prometheus-kube-prometheus-stack-prometheus-0 2/2 Running全部 Running。
三、验证:Prometheus 真的抓到 GPU 指标了吗
Pod 起来不代表数据在流动。真正的验证是:Prometheus 里能查到 DCGM 开头的指标。
bash
bash verify.sh关键输出:
1. DCGM Exporter
nvidia-dcgm-exporter   1/1   Running   ClusterIP 10.43.125.222:9400

2. ServiceMonitor
gpu-operator           已创建
nvidia-dcgm-exporter   已创建

3. Prometheus中的DCGM指标
{"status":"success","data":{"resultType":"vector","result":[{"metric":{},"value":[...,"1"]}]}}
Prometheus已采集到DCGM GPU指标

4. 告警和Dashboard
gpu-alerts             已创建
ai-infra-gpu-dashboard 已创建
关键是第3步:脚本向 Prometheus 查询 count(DCGM_FI_DEV_GPU_UTIL),返回 "result":[{"value":[...,"1"]}],说明 Prometheus 确实抓到了这张 T4 的 GPU 利用率指标。链路通了。
四、打开 Grafana 看面板
Grafana 在集群内部(ClusterIP),要从外部浏览器访问需要做端口转发:
bash
kubectl -n monitoring port-forward --address 0.0.0.0 \
  svc/kube-prometheus-stack-grafana 3000:80
浏览器打开 http://<实例IP>:3000,用 admin 和你设的密码登录。
如果实例安全组没开 3000 端口,可以用 SSH 隧道:
ssh -L 3000:localhost:3000 ubuntu@<IP>,然后访问http://localhost:3000。两种方式的完整步骤见配套资料中的操作日志。
在 Dashboards 菜单里找到"AI Infra - NVIDIA GPU监控",打开就能看到四个核心面板:
- GPU利用率(百分比)
- GPU显存(已用/空闲)
- GPU温度(摄氏度)
- GPU功耗(瓦特)
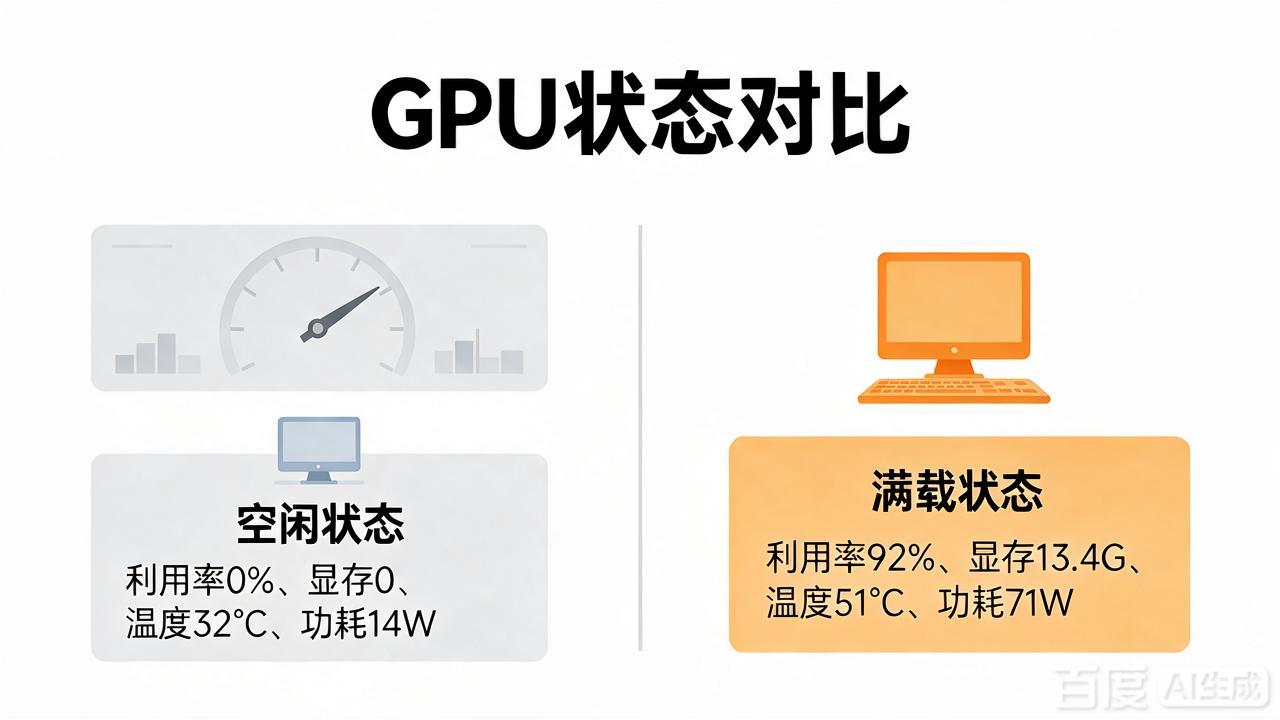
五、空闲 vs 满载:真实对比
这是本篇最有价值的部分。同一个面板,两个截然不同的状态。
空闲状态(无推理负载)
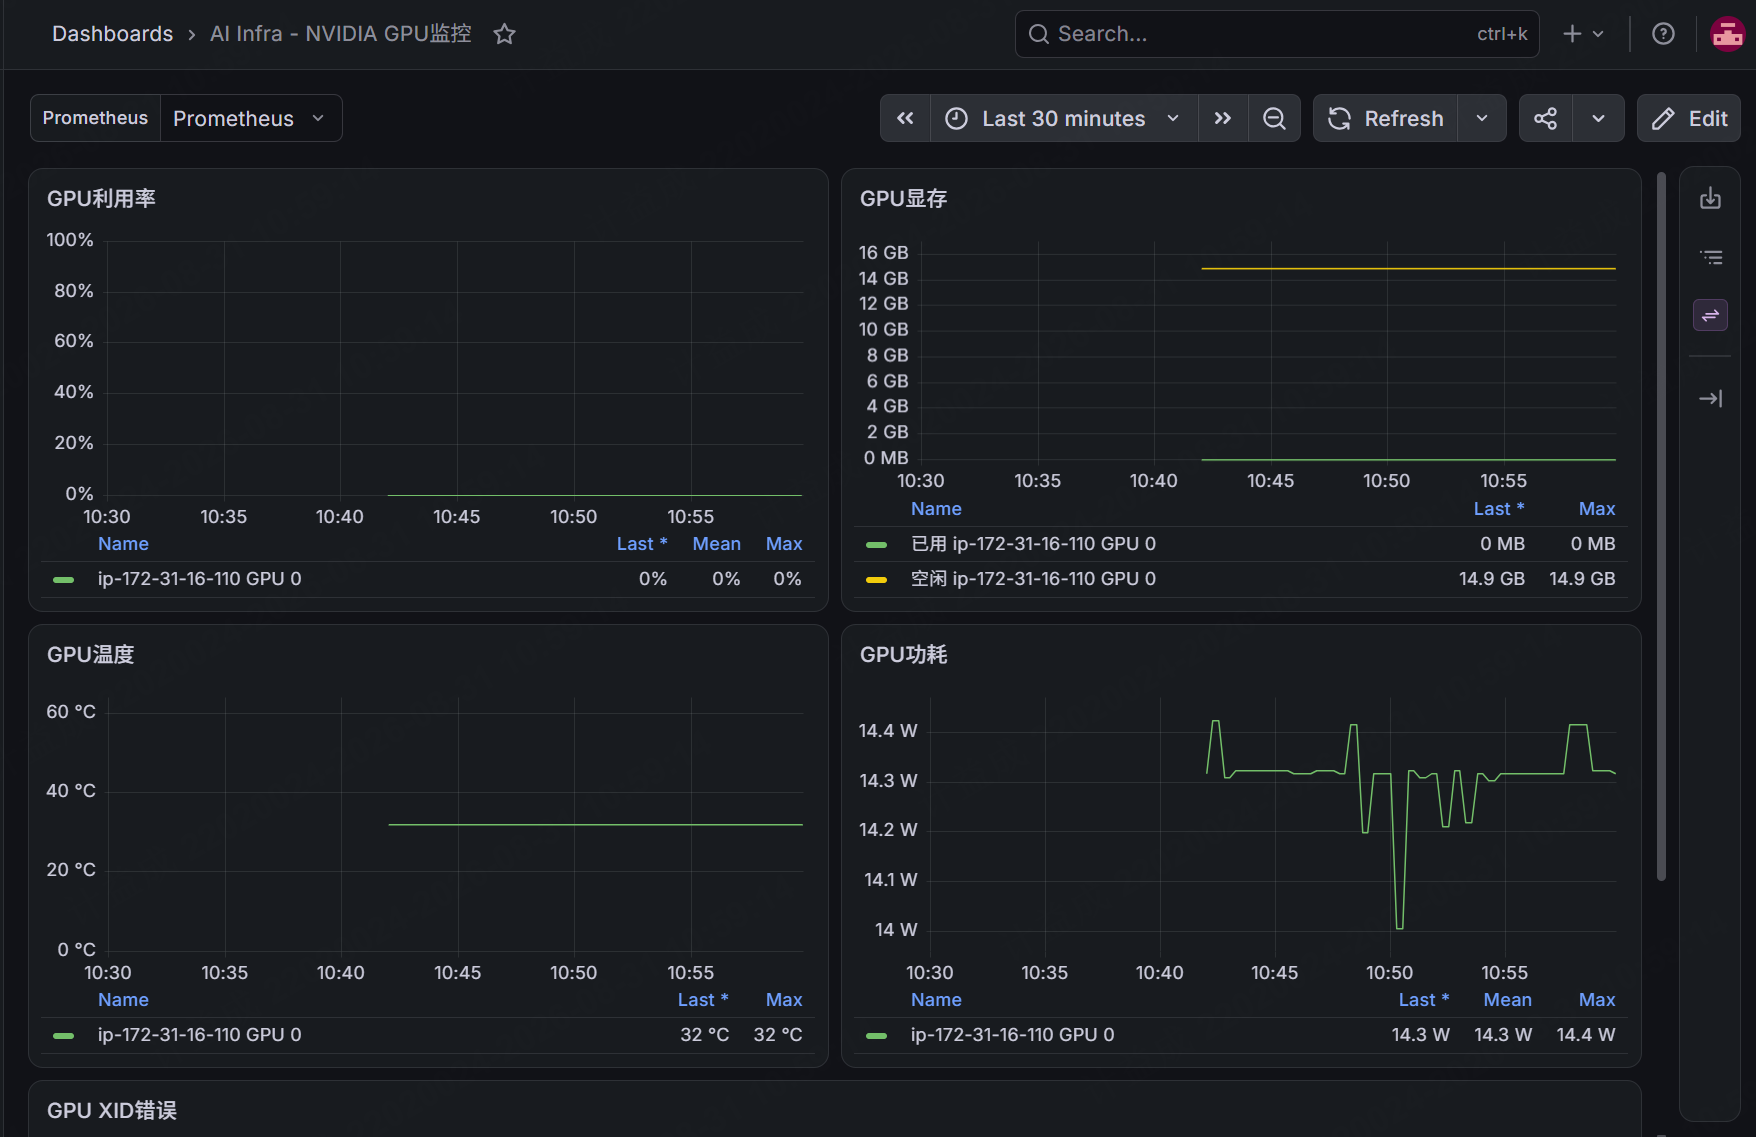
| 指标 | 读数 |
|---|---|
| GPU利用率 | 0% |
| GPU显存 | 已用 0 MB,空闲 14.9 GB |
| 温度 | 32C |
| 功耗 | 14.3W(P8 待机档) |
这就是一张 T4 空闲时的基线。
满载状态(vLLM 压测 2500 请求 / 并发 10)
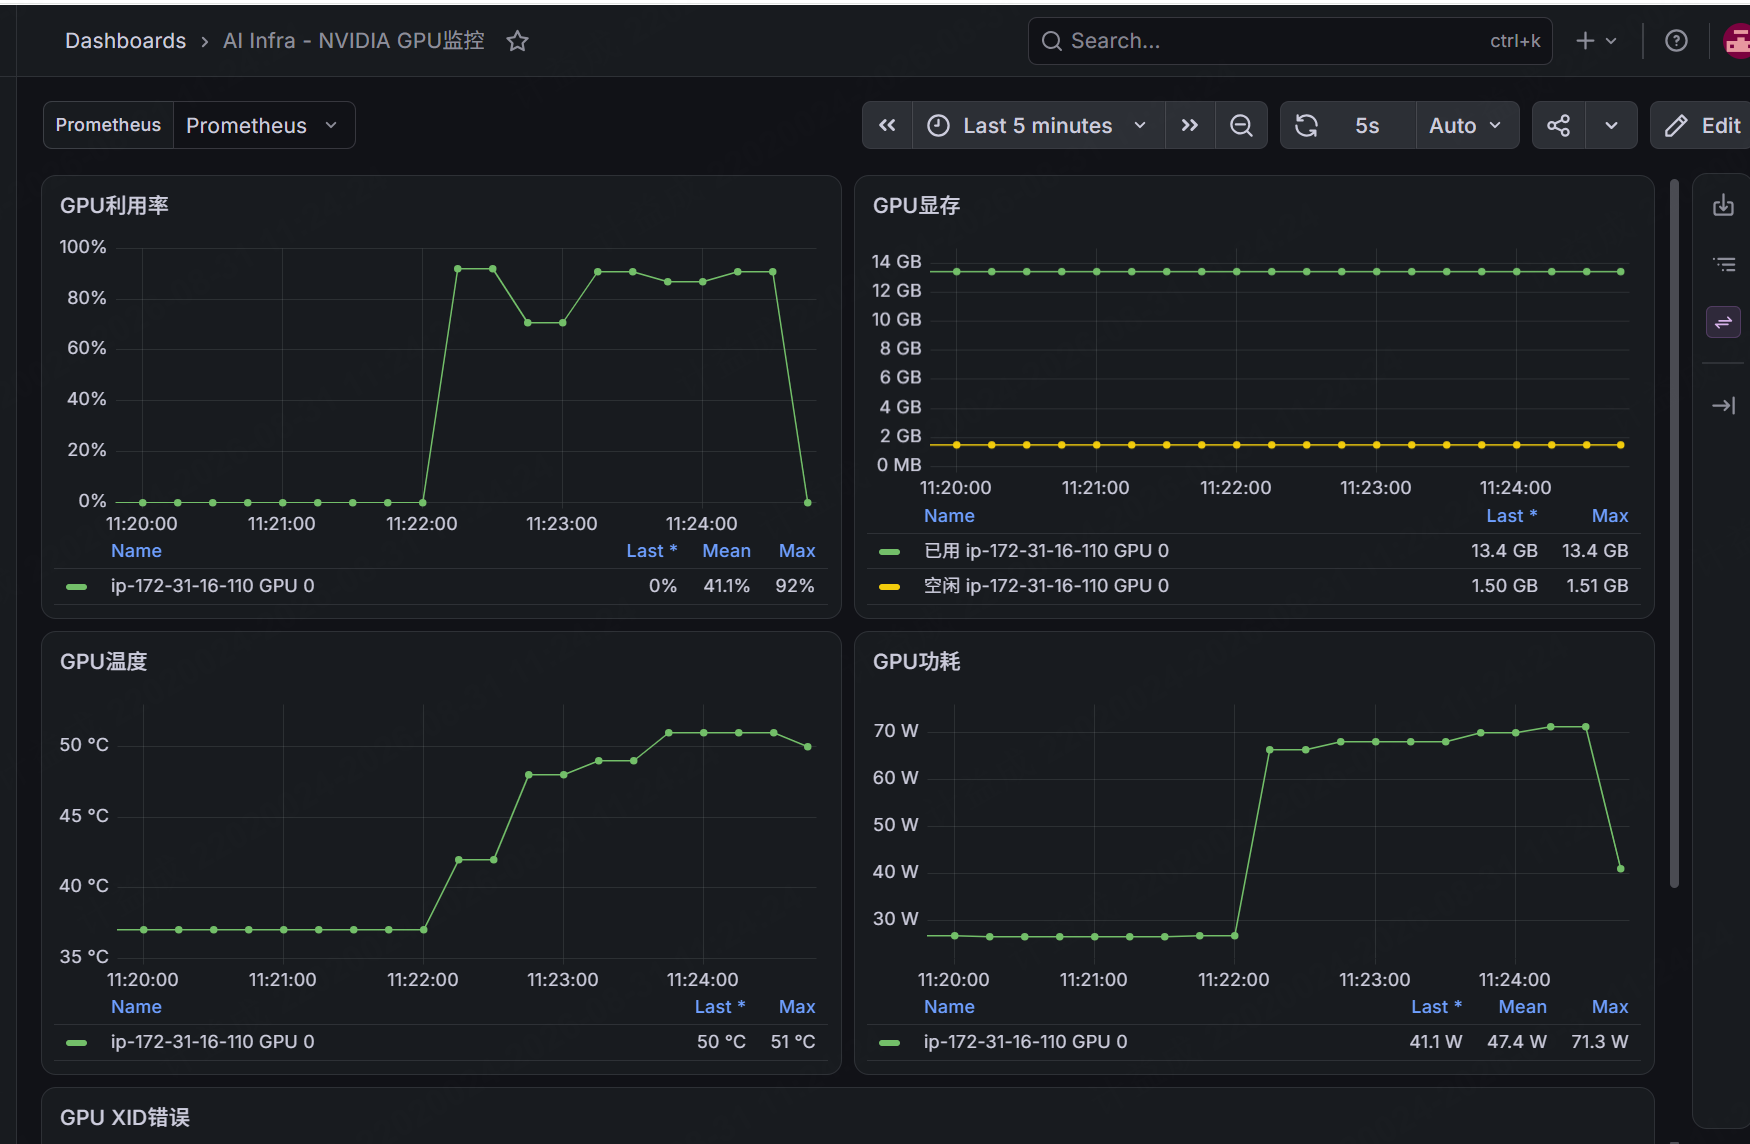
| 指标 | 空闲 | 满载 | 变化 |
|---|---|---|---|
| GPU利用率 | 0% | 92%(峰值) | 从 0 跃升到 92% |
| GPU显存 | 0 用 | 13.4 GB 用 | vLLM 加载模型+KV Cache |
| 温度 | 32C | 51C | 升了 19 度 |
| 功耗 | 14.3W | 71.3W(峰值) | 5倍,顶到 TDP 上限 |
几个值得注意的点:
- 利用率从 0% 到 92% 再回落到 0%,曲线清晰,说明监控的采集频率(DCGM 默认约每秒)足够捕捉推理负载
- 显存 13.4 GB 是常驻的(模型权重 + KV Cache 预留),即使负载回落,显存不释放,这是 vLLM 的正常行为
- 功耗 71.3W 已经到了 T4 的 70W TDP 上限,说明 GPU 在压测时确实满负荷运行
- 温度 51C 很安全,T4 的降频阈值是 96C,远没到
这两张图放在文章里,读者一眼就能感受到"GPU 监控到底在看什么"。
六、告警规则
安装脚本自动创建了 GPU 告警规则(PrometheusRule):
bash
kubectl get prometheusrule -n monitoringNAME AGE
gpu-alerts 已创建预置的告警包括:
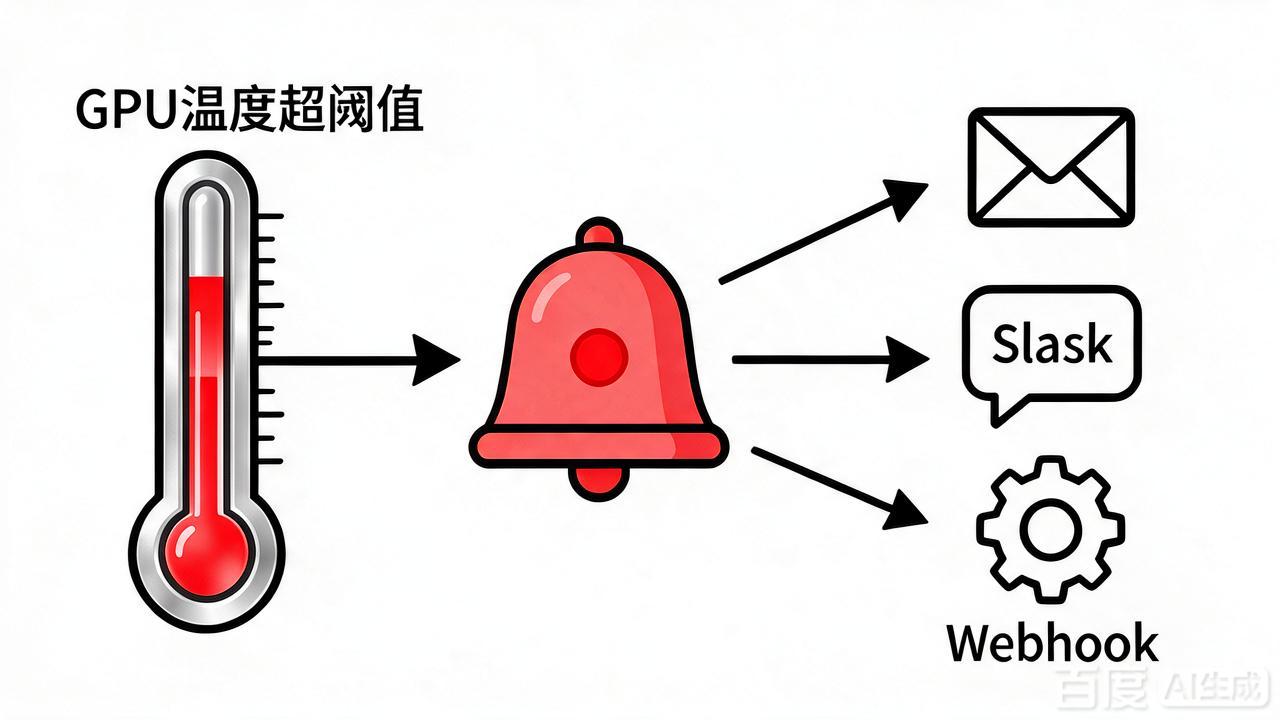
- GPU 温度超阈值(可配)
- GPU 长时间利用率为 0(卡被占着但没在用,浪费)
告警触发后会通过 Alertmanager 发出,可接邮件、Slack、Webhook 等。具体告警规则配置在 gpu-alert-rules.yaml 中,见配套资料。
七、完整链路回顾
GPU 硬件(T4)
  ↓
DCGM Exporter(Pod Running,9400端口采集指标)
  ↓
ServiceMonitor(gpu-operator + nvidia-dcgm-exporter)
  ↓
Prometheus(查询 DCGM_FI_DEV_GPU_UTIL 返回成功)
  ↓
Grafana(面板自动加载,空闲/满载截图已采集)
  ↓
告警(gpu-alerts PrometheusRule 已创建)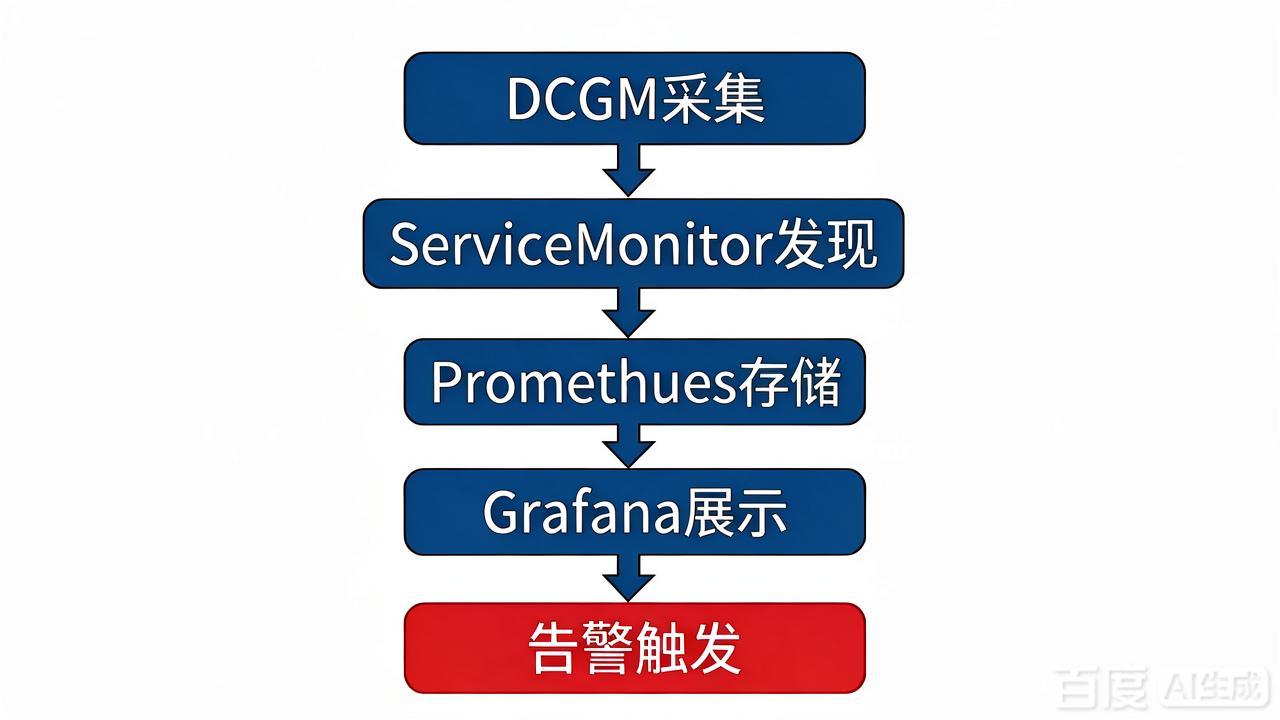
小结
GPU 监控不是可选项,是生产环境的必备。没有监控,你不知道卡在空跑、不知道显存快满了、不知道温度在飙。
这一篇建立的监控基线,会在后续每一篇实验中反复用到:05 篇(vLLM)的压测对比图,就是在这套监控上截的;如果有多卡环境,面板会自动展开为多 GPU 视图。
下一篇(实验05)会在这套环境上用 Helm 部署 vLLM 推理服务,跑通 OpenAI 兼容 API,并用 2500 次请求压测拿到真实的 P50/P95/P99 数据。
参考链接
- 本系列开源仓库(脚本 + Helm Chart + Terraform):https://github.com/Jich1123/gpu-k8s-lab
- NVIDIA DCGM Exporter:https://github.com/NVIDIA/dcgm-exporter
- kube-prometheus-stack(Helm Chart):https://github.com/prometheus-community/helm-charts/tree/main/charts/kube-prometheus-stack
- Prometheus Operator ServiceMonitor 说明:https://prometheus-operator.dev/docs/operator/design/