作者:来自 Elastic David Turner, Yang Wang
集群可以在负载增加时进行横向扩展,而无需等待快照完成,因为快照现在可以直接从对象存储中读取,不再将分片固定在原位置。
亲自体验 Elasticsearch:深入了解我们在 Elasticsearch Labs repo 中的示例 notebooks,开始免费云试用,或者立即在你的本地机器上试用 Elastic。
无状态快照现在可以直接从对象存储中读取。正式发布后,服务端的"由于快照导致的不理想分配"警告已完全停止。快照运行期间,主分片可以自由迁移,因此集群可以在负载增加时进行横向扩展,而无需等待快照完成。在整个集群中,缓存未命中次数下降了超过 60%,缓存填充吞吐量中位数提高了约 50%。
为什么快照会在有状态 Elasticsearch 中固定主分片
在传统的有状态 Elasticsearch 中,快照会将主分片锁定在其活动节点上,从而完全阻止分片迁移。当集群拓扑稳定,并且节点在维护窗口之间始终保持在线时,这种方式运行良好,但无状态 Elasticsearch 的工作方式有所不同。索引数据存储在外部对象存储中,本地磁盘作为缓存,而集群会根据 CPU、内存和数据大小自动进行扩展,包括纵向扩展(升级节点)和横向扩展(添加节点)。
在纵向扩展期间,现有节点必须迁出所有分片并关闭,然后由新的硬件接管。自 Elasticsearch 8.13 版本开始,分片快照可以在节点关闭时暂停,并在迁移完成后恢复,因此长时间运行的快照不会阻塞基础设施更新。
横向扩展则是另一种情况:没有节点关闭,因此暂停逻辑不会触发。新节点会处于空闲状态,而现有节点则需要完成自己的快照;一旦快照进入队列,主分片就会被固定在其所在节点上,从而显著延迟分片迁移。
集群通常是在已经处于高负载状态时进行横向扩展的。在这个时候阻止分片迁移,会限制集群降低压力的能力,从而表现为索引吞吐量下降和延迟升高。资源不均衡还可能触发意外的自动扩缩容行为。即使整体拓扑保持不变,分片锁定也会干扰热点缓解和工作负载分配。这些问题过去会以服务端警告的形式出现:"由于快照导致的不理想分配"。
| 有状态 Elasticsearch | 无状态 Elasticsearch |
|---|---|
| 快照读取自 | 快照读取自 |
| 持有主分片的节点上的本地分片数据 | 对象存储,使用 commit 中记录的文件位置 |
| 快照期间的主分片 | 快照期间的主分片 |
| 固定在其节点上,直到快照完成 | 随时可以自由迁移 |
| 对横向扩展的影响 | 对横向扩展的影响 |
| 新节点必须等待正在进行的快照完成后才能接管分片 | 新节点可以立即接管分片,无论快照处于什么状态 |
无状态快照如何直接从对象存储读取
分片快照之所以会固定主分片,是因为它需要读取本地分片数据。在无状态 Elasticsearch 中,这些数据本来就存储在对象存储中,因此没有必要从本地磁盘读取。让快照直接从对象存储读取,就消除了锁定主分片的要求。主分片可以自由迁移,备份也因此与集群负载均衡解耦。
无状态 commit 包含对象存储中每个数据文件的位置信息,因此快照可以直接读取数据,并将其流式传输到快照仓库(一个独立的对象存储 bucket)。未来,我们计划研究对象存储原生支持的服务端范围复制,以完全跳过本地复制步骤。
跟踪快照过程中分片迁移时的 commit
快照绑定到一个特定的 commit point,该 commit point 决定需要备份哪些文件,而这些文件必须在整个操作期间保持可访问。在有状态集群中,这很简单:执行快照的节点和数据节点是同一个节点,因此 commit 在本地进行管理,并一直保留到操作完成。
在无状态模型中,执行快照的节点和数据节点可能完全不同;或者,如果分片在快照过程中发生迁移,两者也可能发生变化。为处理这种情况,我们添加了一个 transport action,可以通过网络从远程数据节点获取 commit。数据节点会跟踪哪个 commit 属于哪个快照,并在集群状态表明操作完成后释放该 commit。
分片迁移期间还有一个需要处理的问题。对于保持不动的分片,它依赖 commit point 来保留文件。而正在迁移的分片则必须释放其 commit,以便本地存储可以正常关闭。为了确保在这一过渡期间文件仍然可访问,新恢复的主分片会暂时保留对象存储中的所有现有数据文件,直到通过集群状态收到快照完成的通知。这同时处理了正常的分片迁移,以及节点或引擎故障导致的非正常恢复。
不再有分配延迟,并改善缓存统计信息
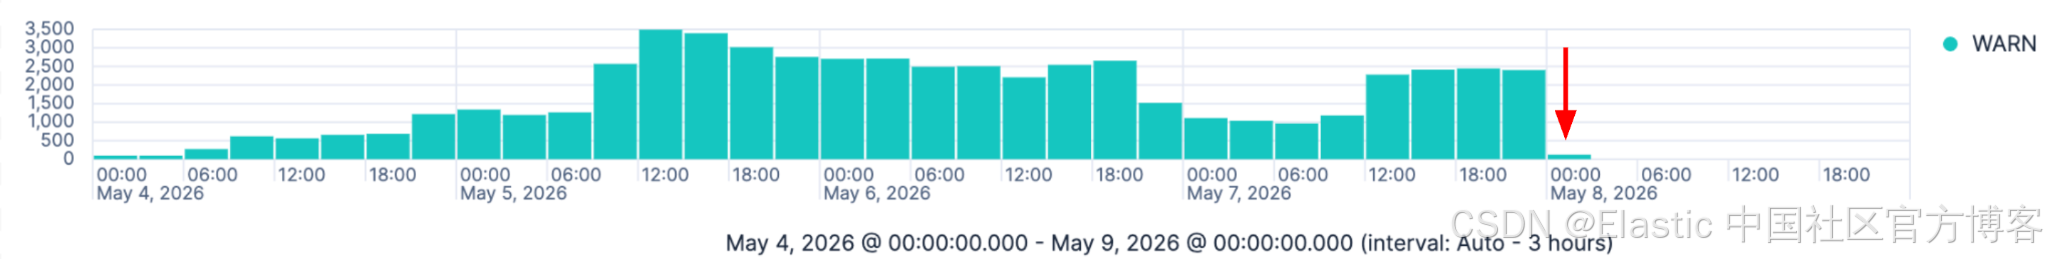
无状态快照正式发布后,服务端的 "由于快照导致的不理想分配" 警告停止出现。下面的图表展示了正式发布前后的情况,红色箭头标记了正式发布的时间点。由于分片迁移不再需要等待备份操作完成,热点缓解的响应速度也得到了提升。
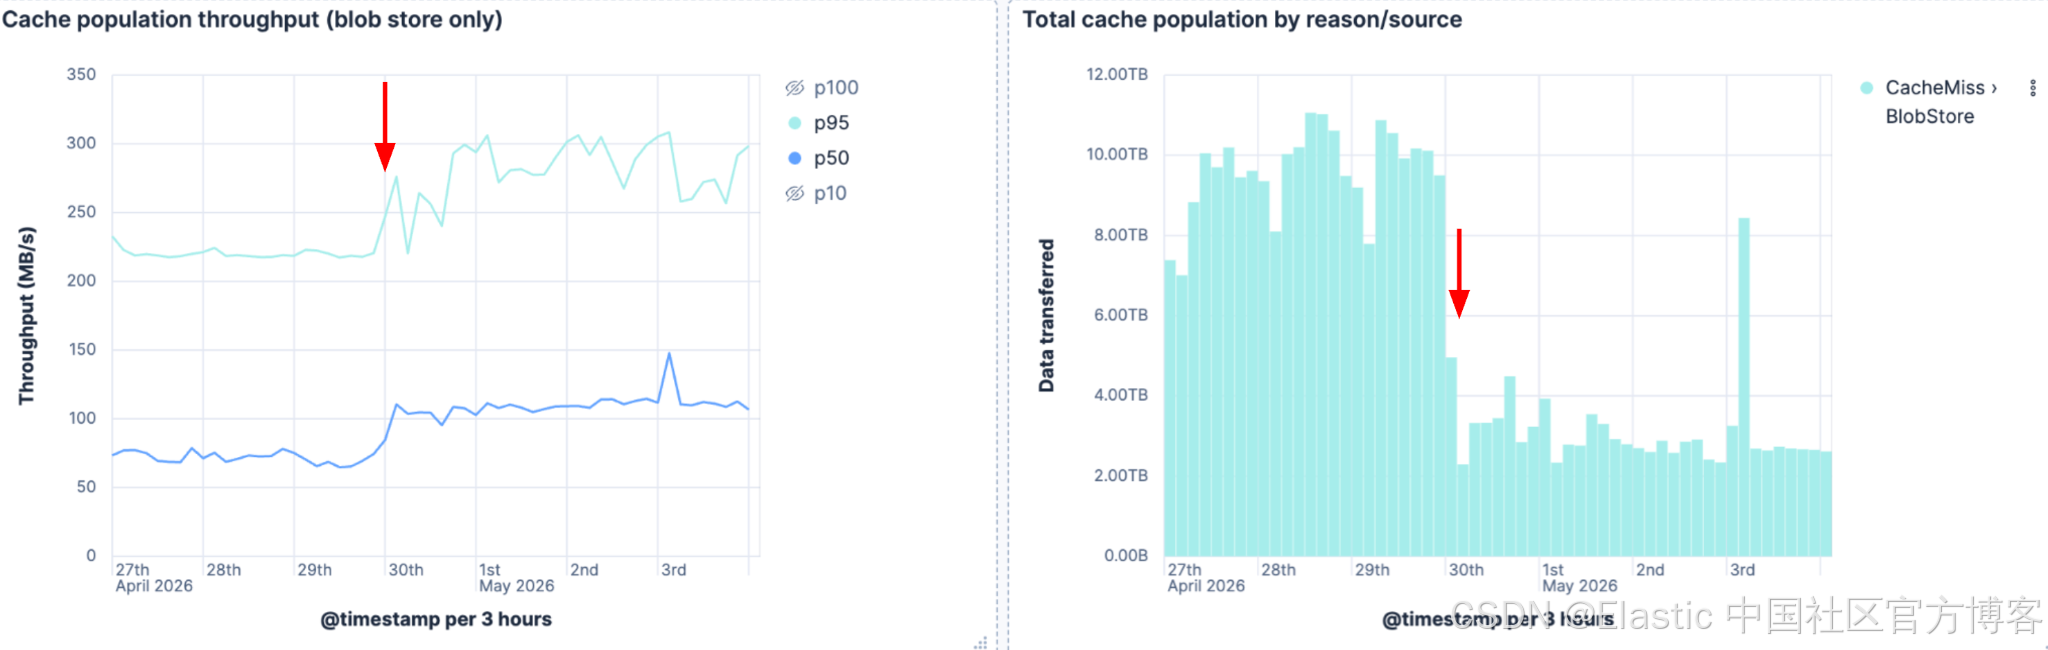
缓存使用情况也得到了改善。绕过本地分片数据的快照不再与索引操作竞争缓存空间。正式发布后(图表中同样进行了标记),我们在缓存指标中观察到了以下两个积极变化:
-
缓存填充吞吐量中位数提高了约 50%。这里的缓存填充吞吐量定义为从对象存储填充本地磁盘缓存时的每秒字节数。
-
缓存未命中次数下降了超过 60%。缓存未命中是指必须从对象存储获取数据,以填充本地磁盘缓存的情况。
无状态快照之后的发展方向
对象存储原生架构正日益成为云原生数据系统的标准,而无状态快照是充分利用这一模型、并将其应用于 Elasticsearch 各项操作的一步。备份从对象存储读取数据,而分片可以自由迁移。两者互不等待。消除对本地分片的依赖,是进一步模块化无状态架构的一步。
原文:Stateless snapshots remove allocation delays in Elasticsearch | Elasticsearch Labs