神经
激活函数是指在多层神经网络中,上层神经元的输出和下层神经元的输入存在一个函数关系,这个函数就是激活函数。如下图所示,上层神经元通过加权求和,得到输出值,然后被作用一个激活函数,得到下一层的输入值。引入激活函数的目的是为了增加神经网络的非线性拟合能力。
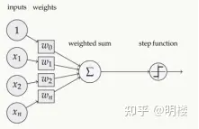
人工神经网络灵感来自人脑神经元,但只是极简化模拟;主流拓扑多为前馈堆叠层状结构 ,信息单向逐层流动,每层神经元只和上一层全部神经元相连;信息传递就是上层向量乘权重、加偏置、过激活函数得到下层输出,而 Transformer‑LLM 在此基础上额外加入注意力旁路,允许不同位置的神经元跨层、跨 token 直接交换信息。
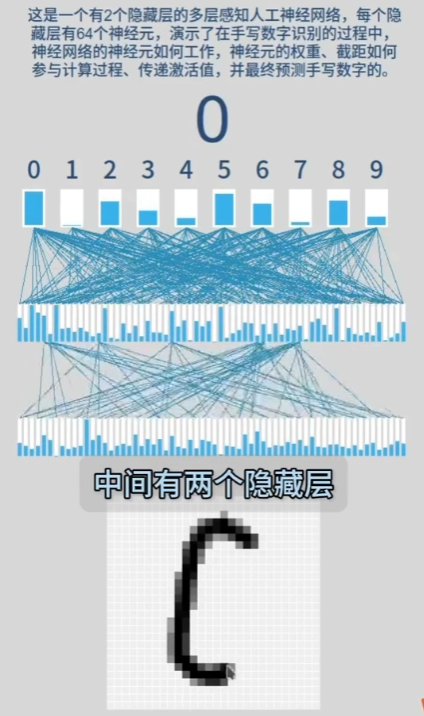
跨‑token 信息交换只发生在同一 Decoder 层内部的掩码自注意力,不存在 "跨层注意力旁路";
层与层之间依靠**残差主干流(residual stream)**传递全部 token 向量,实现深层信息流动。
同一层里,全部 token 的向量生成各自 Q/K/V,每个 token 用自己的 Q,和本层所有 token 的 K 做点积算出关联分数,因果掩码遮住未来 token,softmax 转为权重,再加权求和所有 token 的 V,于是本层内各个词元完成上下文信息交换;
注意力加工完走残差加到原始向量,再经 MLP 单 token 语义加工,产出整层结果;这份包含上下文的新向量整体送入下一层 Decoder,新一轮注意力再次做一次跨‑token 交流;而残差旁路相当于一条贯穿全部堆叠层级的主干道,浅层的原始信号可以直达深层,让几十层逐层迭代深化词语之间的关系理解。
问题1:梳理从 token 到概率的整条数据流,纠正部分理解偏差,再分模块拆解,最终讲清 ReLU、SiLU、GELU 在该链条中扮演的角色。
先梳理完整数据流,从文字 token 一路走到最后的概率预测
先把整条链路铺开,你就能看清激活函数处在哪个环节、它不干概率的活:
- 文字
我 爱 猫→分词器→得到一串整数 token id - 嵌入层(权重矩阵查表)→ 每一个 token 转为高维向量 (\boldsymbol x)
向量 = 这个词语承载的所有语义信息;向量里面每一个数字代表某一条语义线索的强弱
- 送入 Decoder 块
- 多头注意力 (QKV) :计算词与词之间的关联关系 。也就是你所说的词‑词、事态之间的联系。
Q‑K 点积衡量两个词语关联有多强;注意力内部的softmax,才把关联分数转为 0‑1 的概率权重。 - 注意力输出 + 残差 → 送入 MLP 前馈网络 + 激活函数(ReLU / SiLU / GELU)
- 多头注意力 (QKV) :计算词与词之间的关联关系 。也就是你所说的词‑词、事态之间的联系。
- MLP 加工完成,再经过残差,传给下一层 Decoder
- 所有 Decoder 层全部跑完 →最末尾输出层 + 最后的 Softmax →生成「下一个 token 是什么」的预测概率
首先纠正一个关键误区
激活函数 ReLU / SiLU / GELU 完全不是用来计算词语之间发生事态的概率 。
计算词与词关联概率、预测下一个字的概率,是 Softmax 的工作。
注意力负责:词 ↔ 词 的外部关系 (谁和谁有关联)
MLP + 激活函数负责:单个 token 向量内部语义的深度加工,它根本不去看别的词语。
用通俗的语义线索模型理解 MLP 内部发生了什么
进入 MLP 的时候向量会先过一层权重矩阵:
(\boldsymbol u = \boldsymbol x \cdot W_1)
(W_1) 就是训练学到的权重,它会把原来向量里面的语义线索重新混合,生成一批新的、半成品线索,存放在 (\boldsymbol u) 的一堆数字里面。
但是到此为止,全部操作依旧是纯线性组合。
如果直接拿着 (\boldsymbol u) 再乘第二个权重矩阵 (W_2),两层线性运算合并等价于一层。网络学不到任何复杂新知识。
激活函数,就是这条流水线的「线索筛选器」 。
它挨个查看 (\boldsymbol u) 里面每一条半成品语义线索(每一个数字),然后执行一条规则:这条线索我要保留多少?放大?削弱?还是舍弃一部分?
分别三个激活函数做的筛选行为
1、ReLU:强硬的线索筛选器
规则:
- 线索数值>0:这条线索可信,原样全部保留
- 线索数值 ≤ 0:这条线索直接彻底扔掉,清零
后果:
只要一条语义线索变成负数,ReLU 就直接把它删掉,这条微弱信息永久消失。
语言里面有很多微妙、微弱、隐晦的语义,经常会表现为负数信号。一旦被切掉,模型就学不到细腻含义。
👉所以大语言模型的 MLP 几乎不用 ReLU,它更适合图像任务。
2、GELU(GPT 系列用的激活):概率式温和筛选器
它不会一刀把负数线索砍成零。
负数线索会平滑地慢慢衰减;数值越负,保留下来的线索分量就越小。负数不会瞬间归零。
形象例子:
一条微弱负面语义线索,ReLU 直接丢垃圾桶。
GELU:我不完全扔掉它,只是降低这条线索的可信度,留一点点微弱痕迹。
这样模型就可以捕捉到语言里面委婉、微弱、模糊的语义。
3、SiLU(LLaMA 系列底层激活):顺滑衰减筛选器
负数线索沿着一条平滑曲线慢慢趋近于 0,过渡没有任何生硬拐角。
效果和 GELU 很接近,温柔地削弱微弱负线索而不是直接删除。LLaMA 实际使用的变种叫 SwiGLU,内核就是 SiLU。
一张分工对照表,彻底分清各个模块职责
表格
| 组件 | 它到底干什么 | 工作对象 |
|---|---|---|
| Q‑K 点积 | 衡量两个词语之间关联有多强 | 词 A ↔ 词 B(外部关系) |
| 注意力内部 Softmax | 把关联分数转为 0‑1 的概率权重 | 生成注意力权重 |
| ReLU / SiLU / GELU(激活函数) | 筛选、变换单个词语向量内部的语义线索,引入非线性,让网络能学到复杂知识 | 单个 token 自己内部的向量,完全不看别的词 |
| 模型末尾 Softmax | 输出下一个 token 出现的概率分布 | 预测生成文字 |
最精炼一句话总结
注意力模块找到了词语之间的关系;激活函数(GELU/SiLU)负责深挖单个词语内部的深层语义,把微弱细腻的语义线索尽可能保住,不让信息粗暴丢失;ReLU 则会粗暴丢掉负数线索,不太适合大模型。