电视台自建AI短视频生产线与算力底座:技术架构、关键实现与优化实践
媒体行业正在被AIGC重构。电视台每天产生大量新闻素材,传统拆条、字幕、配音、剪辑流程耗时费力。本文将拆解一套面向电视台场景的AI短视频生产平台与算力工具链,涵盖GPU算力池、模型服务、智能拆条、数字人合成、自动剪辑及性能优化,适合正在做媒体AI中台的技术团队参考。
1 背景与痛点
电视台短视频生产面临几个典型问题:
• **素材量大但利用率低:**一档新闻节目可能只有3分钟被剪成短视频,人工拆条效率低。
• **多平台分发需求:**抖音、快手、视频号、自有App需要不同比例、时长、字幕样式。
 • **主持人/配音资源有限:**大量口播内容需要快速生成,且希望保留主持人音色和形象。
• **算力分散、利用率低:**GPU服务器缺乏统一调度,训练和推理资源冲突。
目标:用AI工具链将"2小时人工剪辑"压缩到"10分钟内自动生成",同时保证成片质量和安全合规。
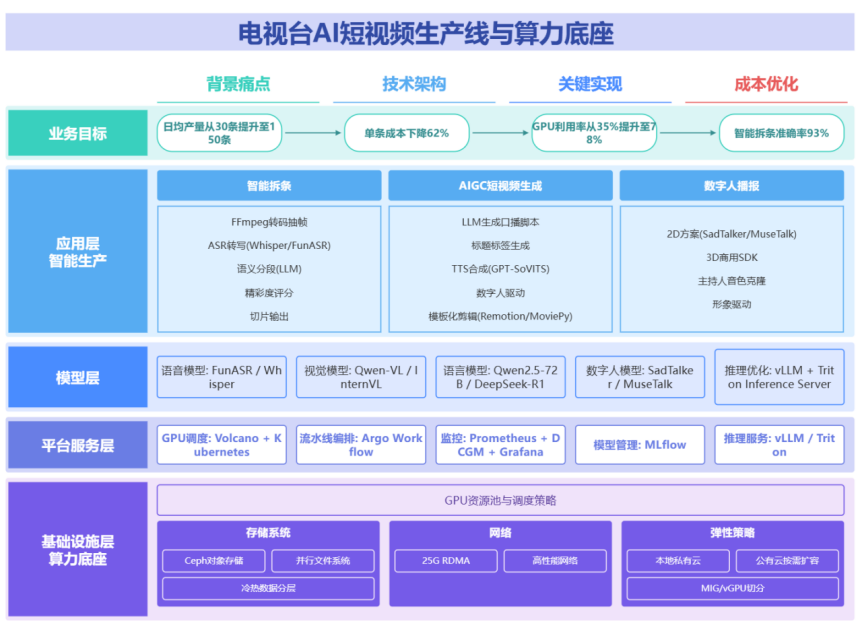
2 总体技术架构
平台分为四层:
|--------|-------------------|---------------------------------------------------------|
| 层级 | 主要组件 | 技术选型 |
| 基础设施层 | GPU算力池、存储、网络 | Kubernetes + NVIDIA MIG/vGPU、Ceph/对象存储、25G RDMA |
| 平台服务层 | 调度、流水线、监控、模型管理 | Volcano、Argo Workflow、Prometheus + DCGM、MLflow |
| 模型层 | 语音、视觉、语言、数字人 | FunASR/Whisper、Qwen-VL/InternVL、vLLM、SadTalker/MuseTalk |
| 应用层 | 智能拆条、AIGC剪辑、数字人播报 | FastAPI + FFmpeg/MoviePy + 模板引擎 |
核心思路:模型服务化、算力池化、流水线标准化。
图1 总体技术架构图(四层架构全景)
3 算力底座:GPU资源池与调度
电视台场景通常是混合负载:白天推理高峰(拆条、字幕、数字人),夜间训练/微调。
我们采用:
• **Kubernetes + Volcano:**支持队列优先级、公平调度、GPU拓扑感知。
• **NVIDIA MIG/vGPU:**A100/H800按 1G.10GB 或 2G.20GB 切分,跑轻量推理。
• **多集群弹性:**本地私有云保底,突发流量扩容到公有云。
一个Volcano Job示例:
apiVersion: batch.volcano.sh/v1alpha1
kind: Job
metadata:
name: asr-batch
spec:
schedulerName: volcano
queue: inference
tasks:
- replicas: 4
name: asr-worker
policies: - event: TaskCompleted
action: CompleteJob
template:
spec:
containers: - name: asr
image: registry.local/funasr:latest
resources:
limits:
nvidia.com/gpu: 1
这样可以避免训练任务抢占推理资源,保证生产任务SLA。
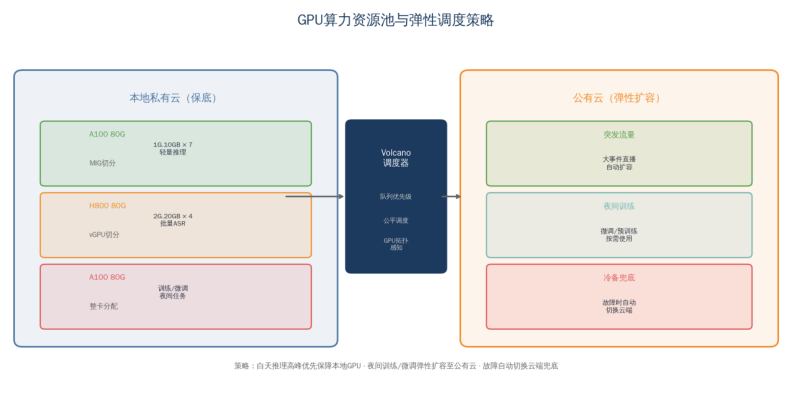
图2 GPU算力资源调度与弹性策略图
4 关键模块实现
4.1 智能拆条与视频理解
流程:
原始视频 → FFmpeg转码抽帧 → 语音转写(ASR) → 语义分段(NLP/LLM) → 关键帧/精彩度评分 → 切片
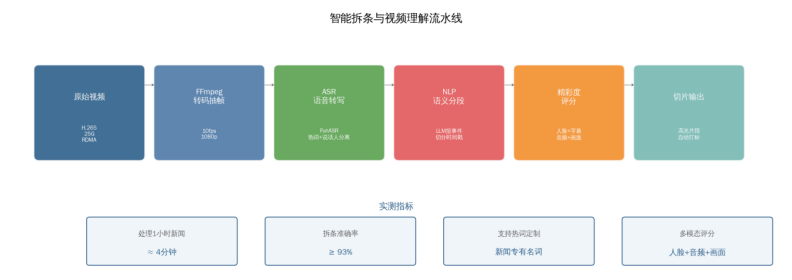 图3 智能拆条与视频理解流水线
各环节技术细节:
• **ASR:**支持热词、说话人分离,对新闻专有名词友好;Whisper作为兜底方案。
• **语义分段:**将ASR文本输入LLM,按新闻事件、话题转折切分,输出时间戳区间。
• **精彩度评分:**结合人脸、字幕、音频能量、画面切换频率,用轻量模型打分,筛选高光片段。
实测在A100上处理1小时新闻节目,拆条耗时约4分钟,准确率可达93%以上(以人工复核通过率计算)。
4.2 AIGC短视频自动生成
核心链路:
新闻稿件/拆条文本 → LLM生成口播脚本+标题+话题标签 → TTS合成语音 → 数字人驱动/画面匹配 → 模板化剪辑
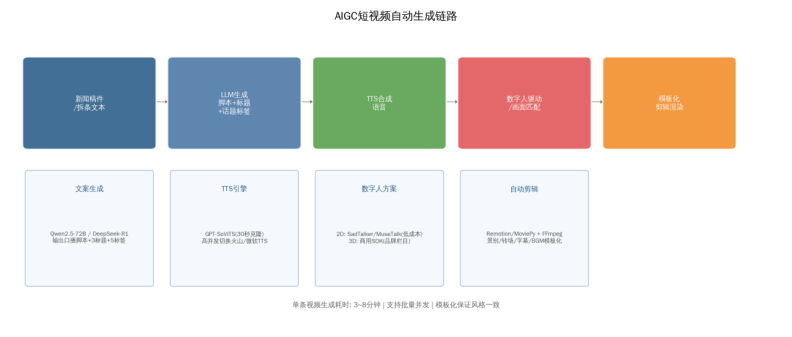 图4 AIGC短视频自动生成链路
各环节技术选型:
• **文案生成:**基于Qwen2.5-72B或DeepSeek-R1,输入新闻稿件,输出符合平台调性的口播脚本,并自动生成3个标题、5个话题标签。
• **TTS:**GPT-SoVITS可克隆主持人音色,只需30秒样本;高并发场景可切换为火山引擎/微软TTS。
• **数字人:**2D方案用SadTalker/MuseTalk,成本低、部署快;3D方案可接入商用SDK,适合品牌栏目。
• **自动剪辑:**基于Remotion或MoviePy,配合FFmpeg合成。模板定义好景别、转场、字幕位置、BGM,批量渲染。
4.3 模型服务与推理优化
模型服务统一走 vLLM + Triton Inference Server:
• **语言模型:**vLLM开启PagedAttention、Continuous Batching,7B模型在A100 80G上吞吐提升5-10倍。
• **语音模型:**Triton动态批处理,ASR并发提升3倍。
• **视觉模型:**TensorRT对关键帧模型量化到FP16/INT8,延迟降低40%。
量化与缓存策略:
• **模型量化:**使用AWQ/GPTQ对7B/13B模型量化,显存下降50%,精度损失可控。
• **KV Cache:**对重复Prompt启用KV Cache,口播脚本生成延迟从3.2s降到1.1s。
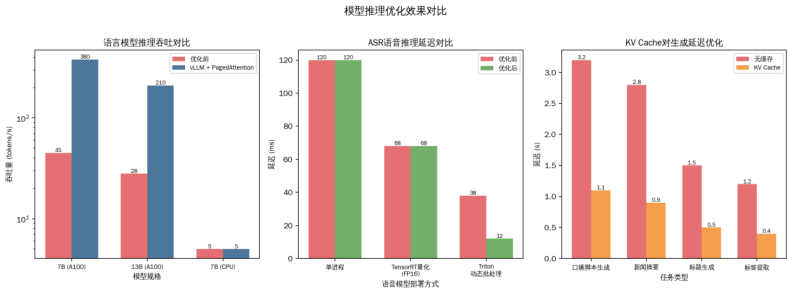 图5 模型推理优化效果对比
5 流水线与监控
用Argo Workflow编排整个AI生产流水线,每个步骤可重试、可观测。
监控重点:
• **GPU监控:**GPU利用率、显存、温度、功耗:DCGM + Prometheus + Grafana。
• **推理监控:**模型推理延迟、队列长度、失败率:自定义Exporter。
• **存储监控:**对象存储和并行文件系统分开,冷数据自动下沉。
6 成本与效果
某省级电视台落地后指标:
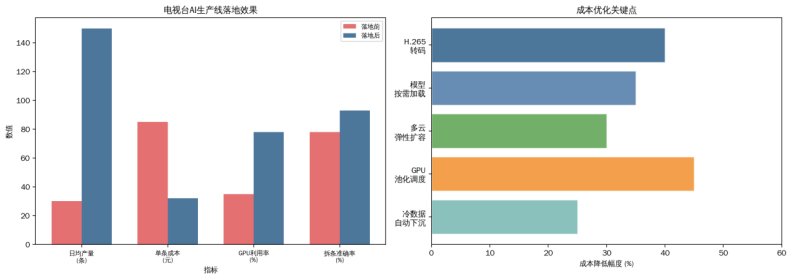 图6 电视台AI生产线落地效果与成本优化
• **产量提升:**短视频日均产量从30条提升到150条。
• **成本下降:**单条短视频平均生产成本下降62%。
• **算力利用率:**GPU资源利用率从35%提升到78%。
• **拆条质量:**智能拆条准确率93%,人工仅需快速复核。
成本优化关键点:
• **多云弹性:**本地固定GPU池负责日常任务,云上按需扩容处理突发大事件。
• **按需加载:**模型按需加载,空闲时自动缩容到0。
• **H.265转码:**全链路视频转码用H.265,存储成本降低约40%。
7 未来方向
• **多模态统一模型:**一个模型完成视频理解、描述、剪辑建议。
• **AI原生媒资库:**向量化存储视频片段,支持自然语言检索。
• **实时直播AI:**直播流实时拆条、自动生成切片并发布。
• **边缘算力:**将ASR、拆条模型下沉到边缘节点,降低中心带宽压力。