7> 🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻
💕💕文末获取源码
文章目录
- 1、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-前言介绍
-
- 1.1背景
- 1.2课题功能、技术
- [1.3 意义](#1.3 意义)
- 2、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-研究内容
- 3、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析分析设计与实现-开发技术与环境
- 4、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-功能介绍
- 5、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-论文参考
- 6、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-成果展示
- 7、代码展示
- 8、结语(文末获取源码)
本次文章主要是介绍基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析的设计与实现
1、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-前言介绍
1.1背景
随着职业网球赛事全球化发展,WTA(Women's Tennis Association)女子职业网球巡回赛积累了大量球员排名、积分、国籍、年龄、单双打成绩及赛事参与记录等数据。传统人工统计方式难以从多年、跨维度的历史数据中快速识别竞技格局的变化规律,例如不同国籍球员的竞争力差异、单打和双打榜首球员的更迭特征、排名前十球员的稳定程度以及球员职业生涯的发展类型等。同时,原始赛事数据通常具有数据量大、字段类型复杂、时间跨度长和更新频繁等特点,普通数据处理工具难以兼顾处理效率与分析深度。因此,有必要构建一个基于大数据技术的WTA职业网球赛事演变与竞技格局数据可视化分析系统,对多年度WTA球员数据进行清洗、存储、统计、挖掘和可视化展示,为网球爱好者、体育数据研究人员及赛事分析人员提供直观、可靠的数据参考。
1.2课题功能、技术
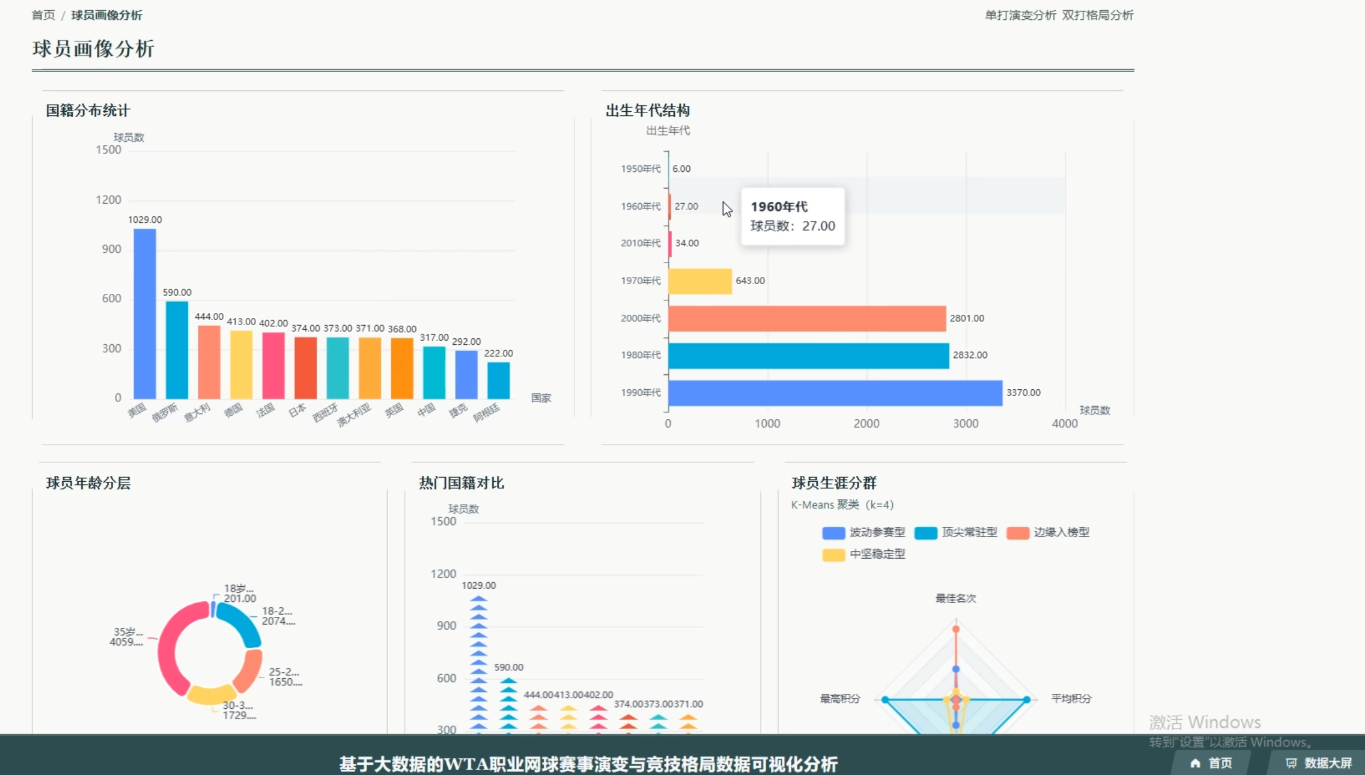
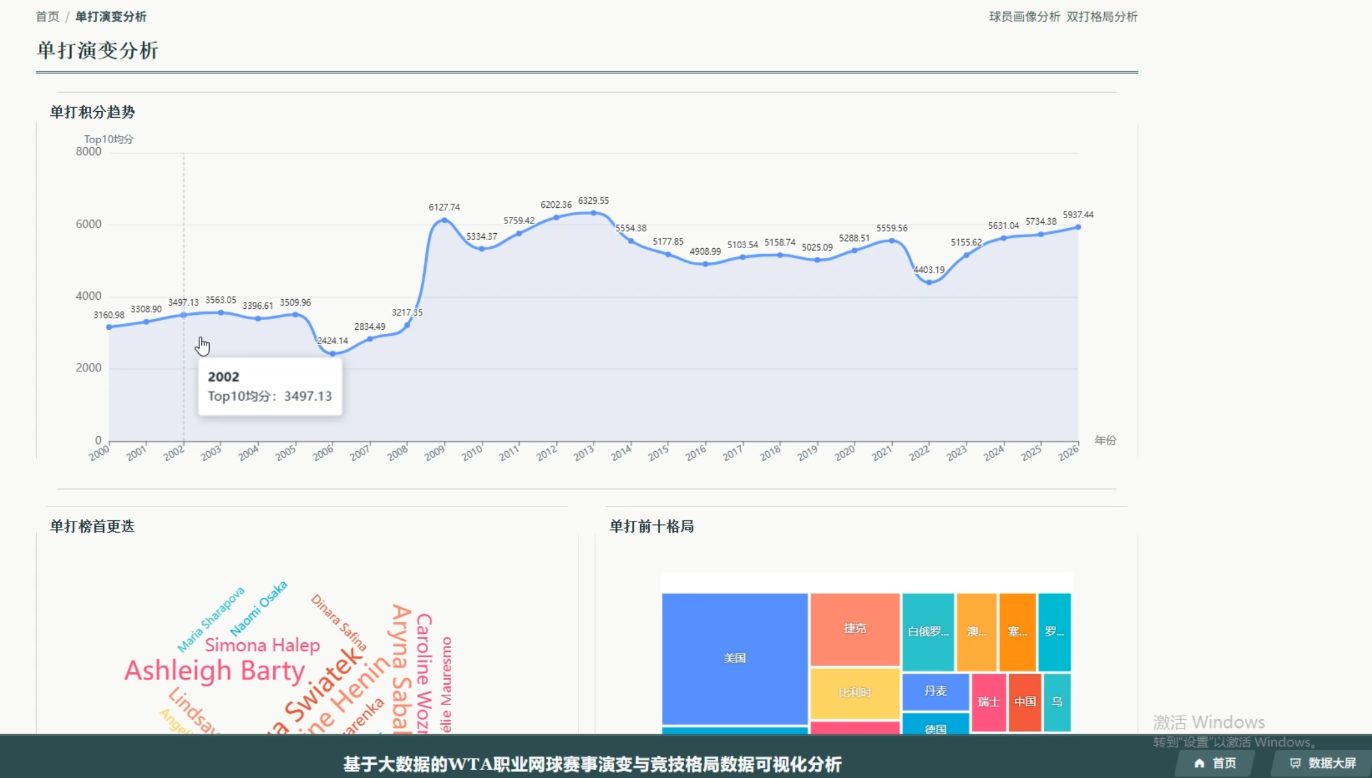
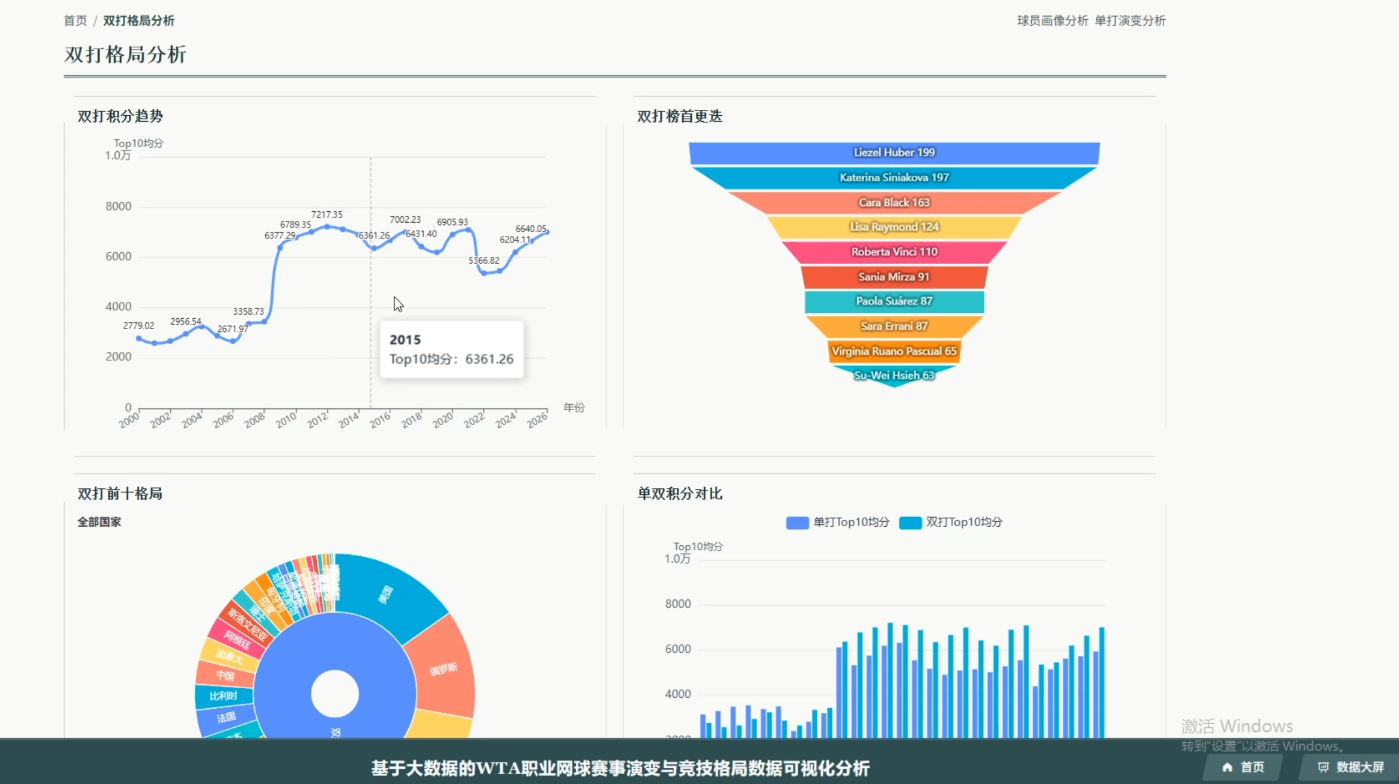
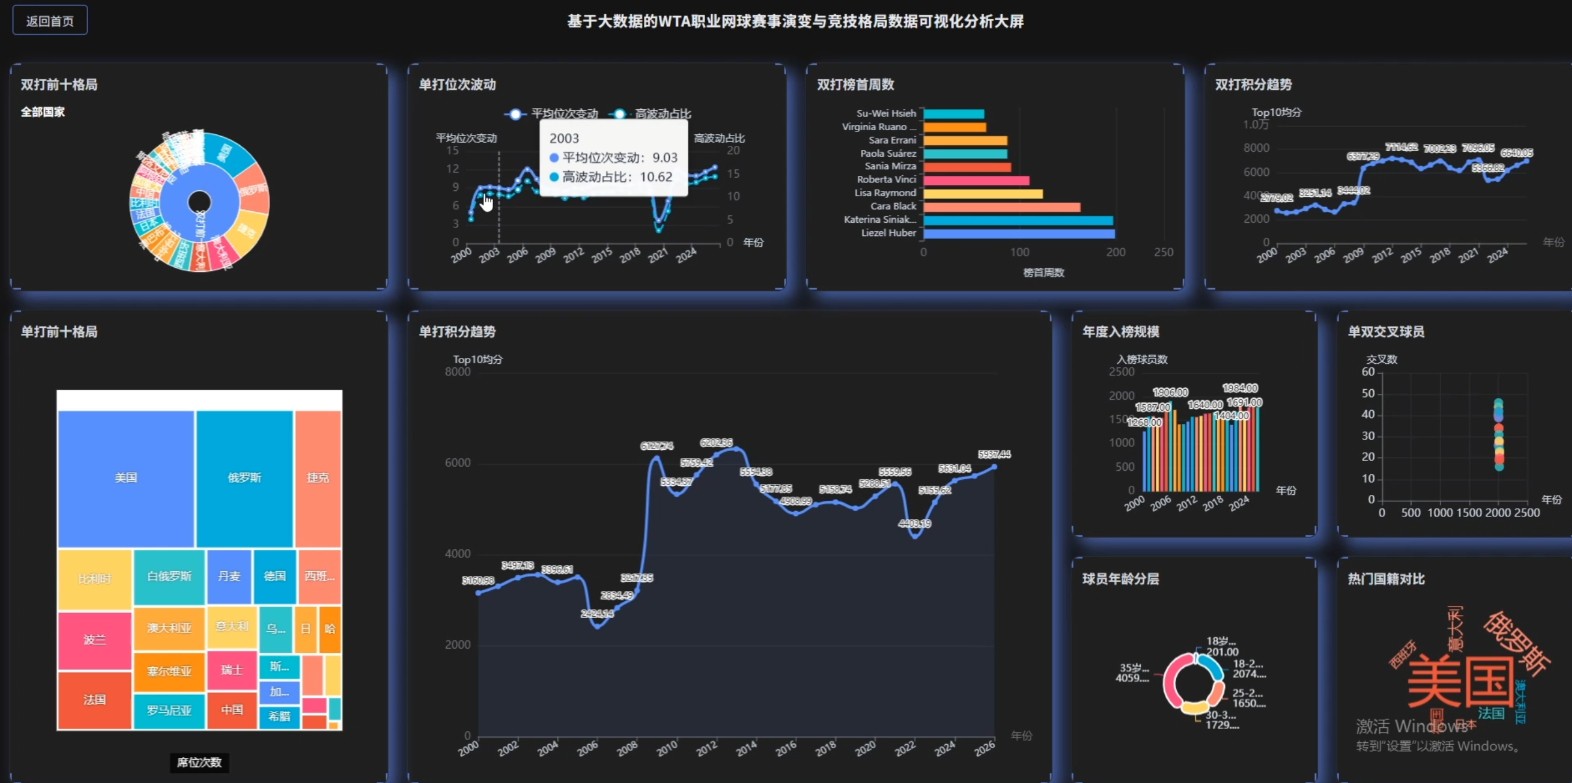
本课题以Python作为主要开发语言,采用Hadoop分布式存储平台、Spark大数据计算框架和Hive数据仓库完成WTA历史数据的采集、清洗、转换及离线分析,并使用MySQL保存系统用户、页面配置和热点统计结果等业务数据。后端采用Django框架构建RESTful接口,负责数据查询、分析任务调度及结果返回;前端采用Vue框架实现页面交互,并结合Echarts完成折线图、柱状图、饼图、散点图、雷达图和排行图等可视化展示。系统主要包括球员画像分析、单打演变分析、双打演变分析和数据大屏四个模块。其中,球员画像模块实现国籍分布、出生年代结构、年龄分层和基于K-means算法的职业生涯分群;单打与双打模块实现积分趋势、榜首更迭、前十格局和位次波动分析;数据大屏集中展示双打前十格局、单打位次波动、双打榜首积分周数、年度入围规模及热门国籍对比等核心指标。
1.3 意义
本系统将大数据处理技术、机器学习聚类算法与体育赛事数据可视化相结合,能够从海量WTA赛事和排名数据中提取有价值的信息,直观展示女子职业网球运动的长期演变过程及竞技竞争格局。一方面,系统能够帮助用户了解不同国家和地区球员的参与情况与竞争表现,分析年龄、积分、排名和职业周期之间的关系,并通过K-means聚类识别不同类型的球员生涯发展路径;另一方面,系统能够从单打和双打两个维度揭示榜首更替频率、前十球员集中程度以及排名波动特征。该课题对体育大数据在职业网球领域的应用具有一定实践价值,也为其他竞技体育项目的数据治理、赛事分析、运动员评价和可视化决策支持系统开发提供了可借鉴的设计思路。
2、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-研究内容
1、数据采集:通过Python爬虫或公开财经数据接口,采集DAX40成分股的股票代码、公司名称、新闻标题、新闻正文、发布时间、新闻来源等信息,并按照统一格式保存,为后续情感分析和舆情研究提供完整的数据基础。
1、数据采集: 通过公开WTA赛事数据平台、网球历史排名数据集及相关体育数据网站获取球员基础信息、单打与双打排名、积分、赛事日期、国籍、出生日期等数据。使用Python编写数据采集与导入脚本,将CSV、Excel或网页结构化数据统一保存,为后续分析提供可靠的数据来源。
2、数据清洗与处理: 利用Python、Pandas及Spark对原始数据进行预处理,包括删除重复记录、处理缺失值、统一球员姓名与国籍编码、转换日期格式、修正异常积分和排名数据等。同时根据业务需求构建球员信息表、单打排名表、双打排名表和年度统计表,并导入Hive数据仓库。
3、数据分析: 基于Spark SQL和Hive对WTA历史数据进行多维统计分析,围绕球员国籍、出生年代、年龄层次、职业生涯、排名、积分和年度赛事参与情况等指标展开研究。系统分别从单打和双打角度分析积分趋势、榜首更迭、前十格局及位次波动,挖掘竞技格局演变规律。
4、数据可视化: 使用Vue前端框架结合Echarts图表工具,对数据分析结果进行可视化呈现。系统采用柱状图、折线图、饼图、散点图、排行图和数据大屏等形式,展示热门国籍分布、球员年龄结构、单双打积分变化、排名波动及榜首球员周数,使复杂数据更加直观易懂。
5、模型构建: 采用K-means聚类算法构建球员职业生涯分群模型,以职业生涯年限、最高排名、累计积分、参赛场次和排名稳定性等特征作为输入指标。通过数据标准化和聚类训练,将球员划分为不同发展类型,如顶尖稳定型、短期爆发型、持续成长型和普通参与型,为球员画像分析提供支持。
6、Web系统开发: 系统后端采用Django框架开发数据接口、用户请求处理和业务逻辑服务,前端采用Vue框架实现页面布局、交互操作和图表展示。MySQL用于存储系统用户及部分业务数据,Hive保存大规模分析数据,前后端通过RESTful接口进行通信,形成完整的WTA赛事数据分析与可视化平台。
3、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析分析设计与实现-开发技术与环境
- 开发语言:Python
- 大数据技术:hadoop、spark、hive
- 框架:Django后端框架、Vue前端框架、Echarts可视化
- 机器学习算法:K-means聚类分析
- 软件工具:Pycharm
- 数据库:MySQL
4、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-功能介绍
1个角色:管理员
可视化分析:
球员画像分析分析:国籍分布统计、出生年代结构、球员生涯分群、球员年龄分层
单打演变分析:单打积分趋势、单打榜首更迭、单打前十格局、单打位次波动
双打演变分析: 双打积分趋势、双打榜首更迭、双打前十格局、双打位次波动
大屏:双打前十格局、单打位次波动、双打榜首积分周数、年度入围规模、热门国籍对比
5、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-论文参考
6、基于大数据的WTA职业网球赛事演变与竞技格局数据可视化分析设计与实现-成果展示
6.1演示视频
6.2演示图片
☀️球员画像分析分析☀️
☀️单打演变分析☀️
☀️双打演变分析☀️
☀️大屏可视化☀️
7、代码展示
1.球员国籍分布统计功能【代码如下(示例):】
bash
# apps/analysis/views.py
from django.http import JsonResponse
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count

def nationality_distribution(request):
    spark = SparkSession.builder \
        .appName("WTANationalityAnalysis") \
        .enableHiveSupport() \
        .getOrCreate()

    player_df = spark.table("wta_db.player_info")

    result_df = player_df.filter(
        col("nationality").isNotNull() &
        (col("nationality") != "")
    ).groupBy("nationality").agg(
        count("player_id").alias("player_count")
    ).orderBy(col("player_count").desc())

    result_list = result_df.limit(20).collect()

    data = []
    for row in result_list:
        data.append({
            "name": row["nationality"],
            "value": row["player_count"]
        })

    spark.stop()
    return JsonResponse({
        "code": 200,
        "message": "国籍分布统计成功",
        "data": data
    })
2.球员生涯K-means聚类分析功能【代码如下(示例):】
bash
# apps/analysis/services/player_cluster.py
from pyspark.sql import SparkSession
from pyspark.ml.feature import VectorAssembler, StandardScaler
from pyspark.ml.clustering import KMeans

def player_career_cluster():
    spark = SparkSession.builder \
        .appName("WTAPlayerCluster") \
        .enableHiveSupport() \
        .getOrCreate()

    df = spark.table("wta_db.player_career_summary").select(
        "player_id", "player_name", "career_years",
        "best_rank", "total_points", "match_count"
    ).dropna()

    assembler = VectorAssembler(
        inputCols=["career_years", "best_rank", "total_points", "match_count"],
        outputCol="features"
    )
    feature_df = assembler.transform(df)

    scaler = StandardScaler(
        inputCol="features",
        outputCol="scaled_features",
        withMean=True,
        withStd=True
    )
    scaled_df = scaler.fit(feature_df).transform(feature_df)

    model = KMeans(k=4, seed=2024, featuresCol="scaled_features").fit(scaled_df)
    result_df = model.transform(scaled_df)
    result_df.write.mode("overwrite").saveAsTable("wta_db.player_cluster_result")
    return result_df.select("player_name", "prediction")
8、结语(文末获取源码)
💕💕
💟💟如果大家有任何疑虑,或者对这个系统感兴趣,欢迎点赞收藏、留言交流啦!
💟💟欢迎在下方位置详细交流。
🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻