DeepSeek Harness 可观测性:用 OpenTelemetry 把会话遥测出去
上一篇讲配置与 Patch,是「跑起来之前」的事。这一篇讲跑起来之后------Agent 在后台跑了几百个 turn,怎么知道它到底干得怎么样、有没有出错、用户会话都流向了哪?
答案在 Harness 的会话遥测(Session Telemetry)子系统。它把「会话里发生了什么」从会话日志里抽出来,交给 OpenTelemetry 的日志管线往外送。但这一篇我最想讲的不是「怎么接 OTel」,而是它凭什么设计得这么克制------这个子系统的边界感,比它暴露的功能更值得学。
一、先立边界:它是可选能力,不是主循环脊梁
官方文档第一段就把边界划死了:
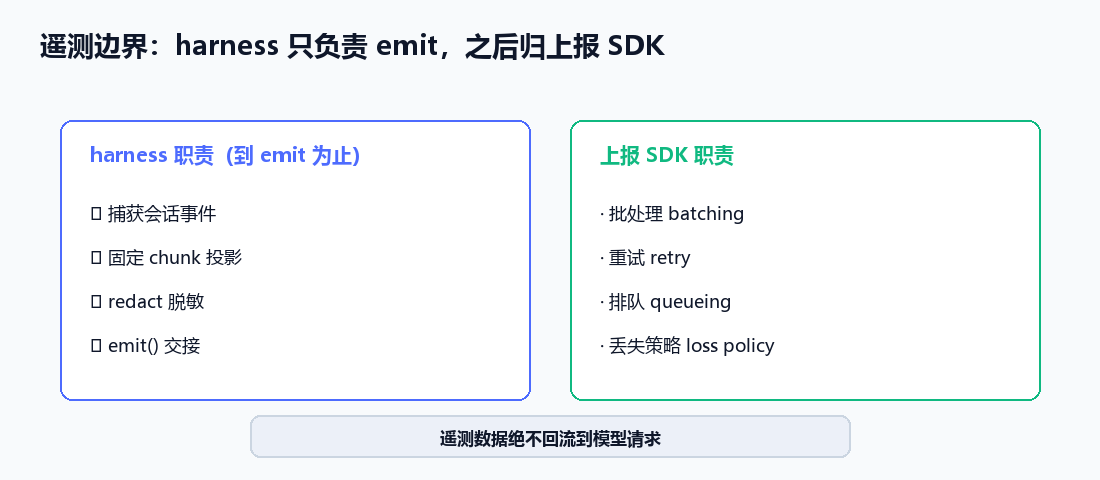
它是一个可选能力,不是 agent-loop 脊梁的一部分 ,这里没有任何东西会到达模型请求。harness 的职责到
emit()为止;批处理、重试、排队、丢失策略都归上报 SDK 管。
这句话信息量很大。翻译成人话:
- 遥测不是 Agent 跑起来的必要条件,卸了它 Agent 照转;
- 遥测数据绝不回流到模型请求里(不会污染上下文);
- Harness 只负责「把记录交出去」这一个动作(
emit()),之后网络怎么发、失败了怎么办,一概不管------那是 OTel SDK 自己的事。
这条「边界公理」是理解后面一切的前提。
二、逻辑记录:两个通道 + 三级严重度
Harness 交给后端的是统一的逻辑记录 SessionTelemetryRecord。它分两个通道:
ledger:会话日志的一一镜像 ------每个 session event 对应一条。带session.id、event.type、event.seq等身份属性;ops:运行信号 ------比如agent-error、shutdown这种在日志里没有家的事件。它故意不带event.seq之类的身份,就是为了让人「永远别把它误当成 ledger 行」。
严重度在捕获时就预映射好了,接收方零配置就能告警:
error:事件自身的 outcome 标记为错(工具结果的isError、turn/end的错误原因),以及agent-error运行记录;info:其余默认;warn:留给session-telemetry/record策略和后端使用。
一个巧妙的细节:每个 (turn, step) 只发第一条 assistant/chunk (流开始的信号),其余的在捕获时就丢了。所以线上 seq 有缺口是常态,不是丢包信号------别看到 seq 不连续就拉警报。
三、redact waterfall:脱敏是扩展点,不是写死的
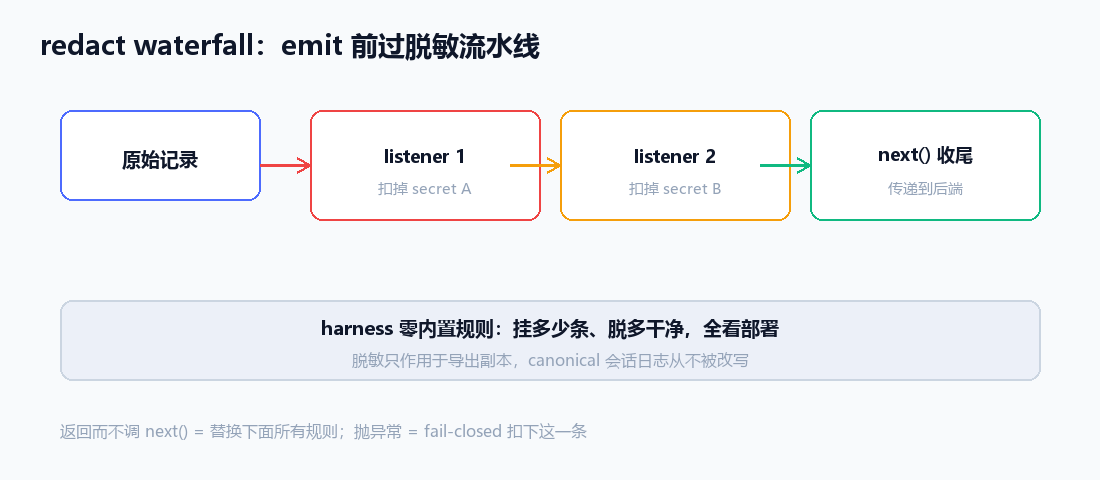
最值得说的一处:遥测出海前要过一条脱敏流水线 ------session-telemetry/record 这个 waterfall。
它的语义是:每条记录在投影和 emit() 之间,会经过这条 waterfall。监听器通过变换 next() 的返回值来叠加规则;返回而不调 next() 会替换掉下面的所有规则;抛异常则fail-closed------把这一条扣下不发。
关键在于:Harness 自己一条规则都不内置 。没有监听器挂载时,记录原样到达后端------「导出的数据有多干净,取决于你的部署挂了多干净的规则」。脱敏只作用于导出的副本,canonical 会话日志从不被改写。
ts
// 概念示意:挂一条脱敏规则
ctx.on('session-telemetry/record', (record, next) => {
  const r = next()                       // 先让下层规则跑完
  if (r.channel === 'ledger' && r.attributes['event.type'] === 'tool/result') {
    return scrubSecretFrom(r)            // 再扣掉自己关心的 secret
  }
  return r
})
这是典型 Harness 式设计:把安全策略做成可插拔的 seam,而不是写死的 if 判断。
四、backend contract:emit / flush / shutdown
后端要满足的最小契约只有三个方法:
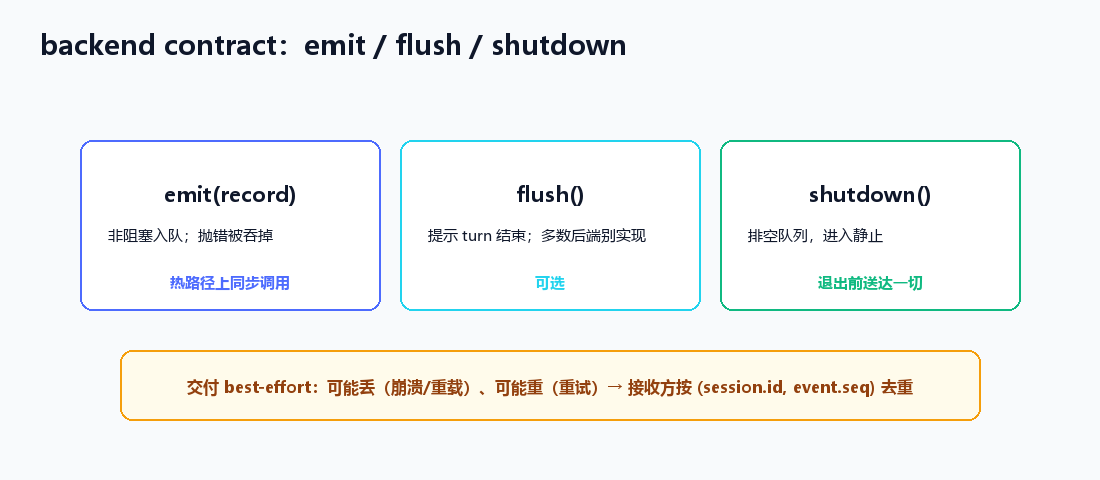
emit(record):把一条记录交给后端管线。必须是非阻塞入队 ------因为协调器在session/event热路径上同步调用它,比入队慢一丁点都会拖累 agent 循环。这里抛错会被协调器吞掉、记日志,绝不回流到循环;flush()(可选) :提示「一个 turn 结束了」,后端可以借此 flush。但官方建议多数后端别实现它,让 SDK 自己的批处理节奏管导出时机;shutdown():把排队的都 flush 掉、进入静止状态。此前 emit 的一切都必须送达。
交付是 best-effort 的:cursor 标记的是「已交接」,不是「已送达」。记录可能丢失(崩溃、reload 窗口),也可能重复(cursor 缺失重收、SDK 重试)。所以接收方要在 (session.id, event.seq) 上去重 ledger 记录;ops 记录故意不带这身份------它们是「用来告警的信号」,重复了也无所谓。
五、sharing disclosure:把分享策略摆到明面上
最后一块是分享披露 。每个后端必须通过 ctx.sessionTelemetry 上必需的 sharing 成员,披露部署选择的分享策略:
ts
type SessionTelemetrySharingStatus = 'full' | 'feedback-only' | 'disabled'消费方(比如 /feedback 命令的确认文案)把它渲染给用户。它披露的是当前策略,不是「送达或留存情况」------因为后者根本不在 harness 职责内。只有没有挂载任何遥测服务时,才显示「未配置」。这个设计把「我的会话数据会不会被分享」这个隐私问题,从「用户猜」变成了「系统明说」。
六、避坑清单
- 别拿 seq 缺口当丢包 。
assistant/chunk每 turn 只发第一条,seq 不连续是设计使然,不是事故。 - 去重只在接收方做 。harness 交付是 best-effort 且可能重复,接收方必须在
(session.id, event.seq)上去重;ops 记录别拿去求和。 - 脱敏规则要自己挂 。harness 零内置脱敏,不挂
session-telemetry/record规则就是「原样外发」,敏感数据要不要脱干净完全取决于你。 emit必须是纯入队 。后端实现里别在emit里做同步网络 IO,否则会拖慢 agent 循环;抛错也只会被吞掉,别指望它兜住你的网络故障。- 遥测不回流模型。它是单向出海的能力,别把遥测数据再喂回 agent 上下文,那既污染上下文也违背它「不达模型」的边界。
小结
这一篇看似讲 OTel,其实讲的是 Harness 一贯的设计品味:边界划清楚、职责交干净。遥测子系统把「捕获」和「上报」硬生生切开------harness 负责把记录交出去,SDK 负责发出去,中间一条可插拔的脱敏 waterfall 负责「该不该让某条数据出去」。这种「到我为止,之后不归我管」的克制,正是它能在复杂场景里保持可维护性的原因。
到这里,「把 DSH 用进生产」的工程化拼图还差最后一块:Agent 要动你的文件、跑你的命令时,谁说了算? 下一篇讲权限与审批------给 Agent 上一个 human-in-the-loop 的安全阀。
参考:deepseek-ai/deepseek-harness 官方仓库 docs/subsystems/session-telemetry.md。