精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖
文章目录
- 一、项目介绍
- 二、视频展示
- 三、开发环境
- 四、系统展示
- 五、代码展示
- 六、项目文档展示
- 七、项目总结
- [<font color=#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻](#fe2c24 >大家可以帮忙点赞、收藏、关注、评论啦 👇🏻)
一、项目介绍
城市公共交通网络规模庞大、结构复杂,公交与地铁线路交织,传统统计手段难以高效提取线网密度、站点共线度、区段重复系数等运营特征。随着多城市公交地铁数据集规模激增,亟需借助大数据技术完成全量数据的聚合计算与可视化呈现。本文通过开发一个基于大数据的公共交通运营数据分析与可视化系统,用以帮助解决城市公共交通线网结构分析效率低、多城市对比困难的问题。
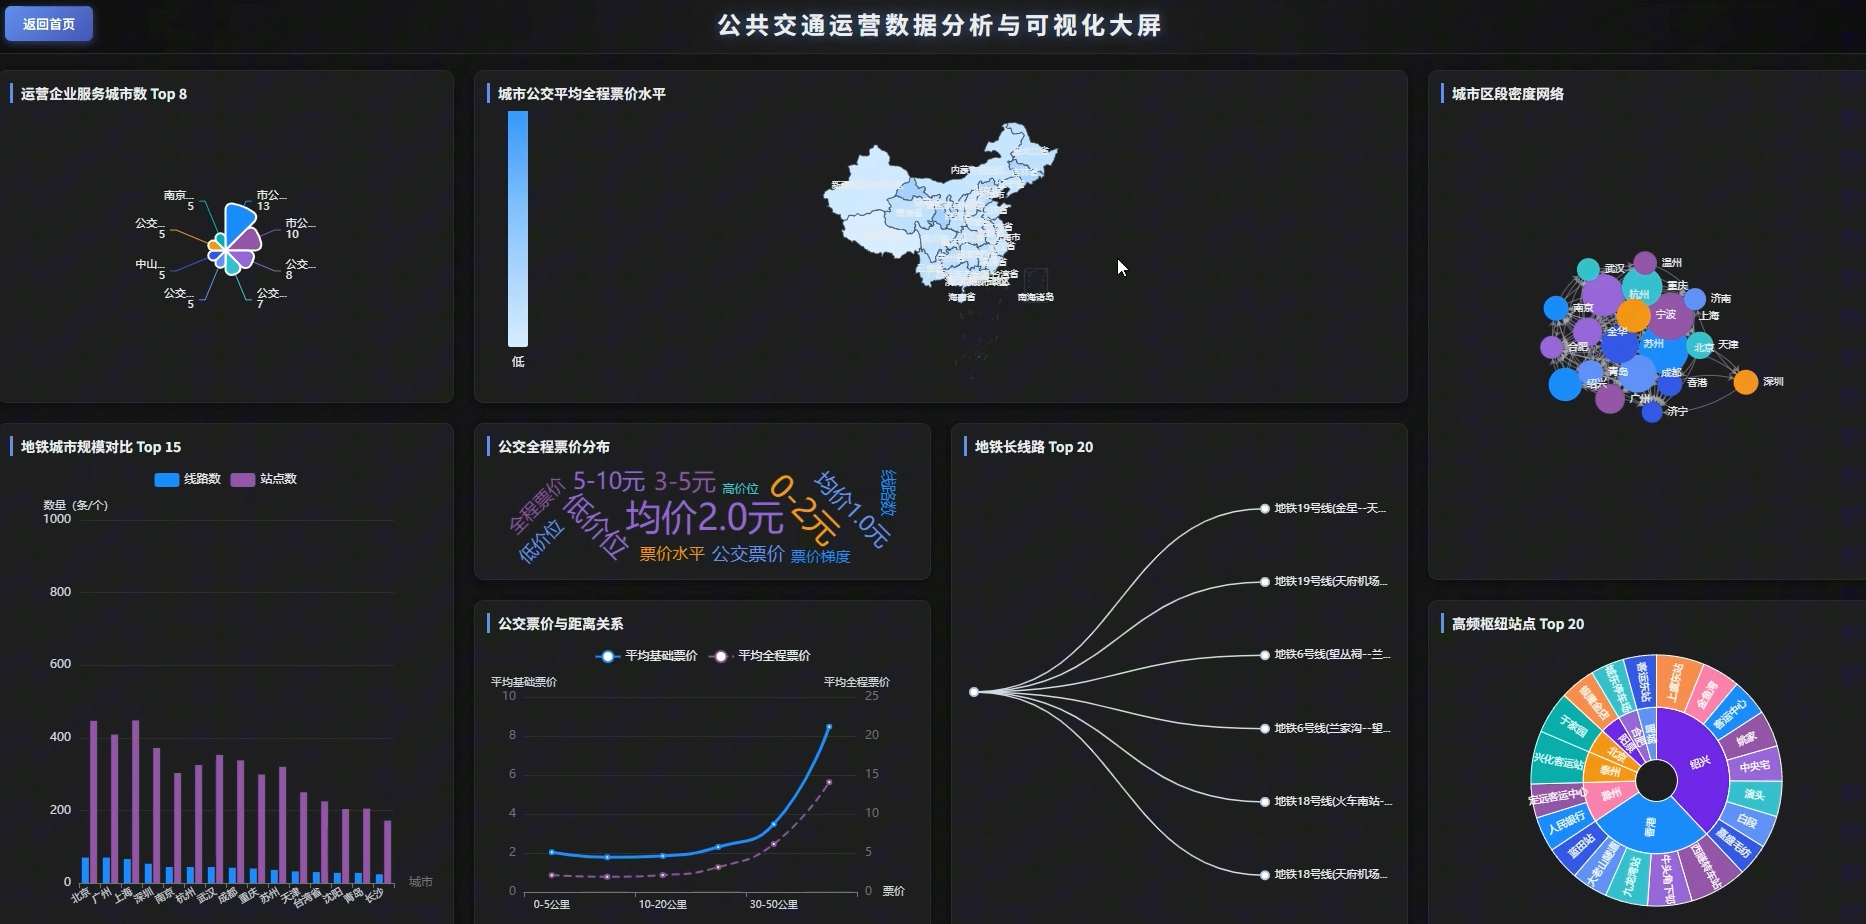
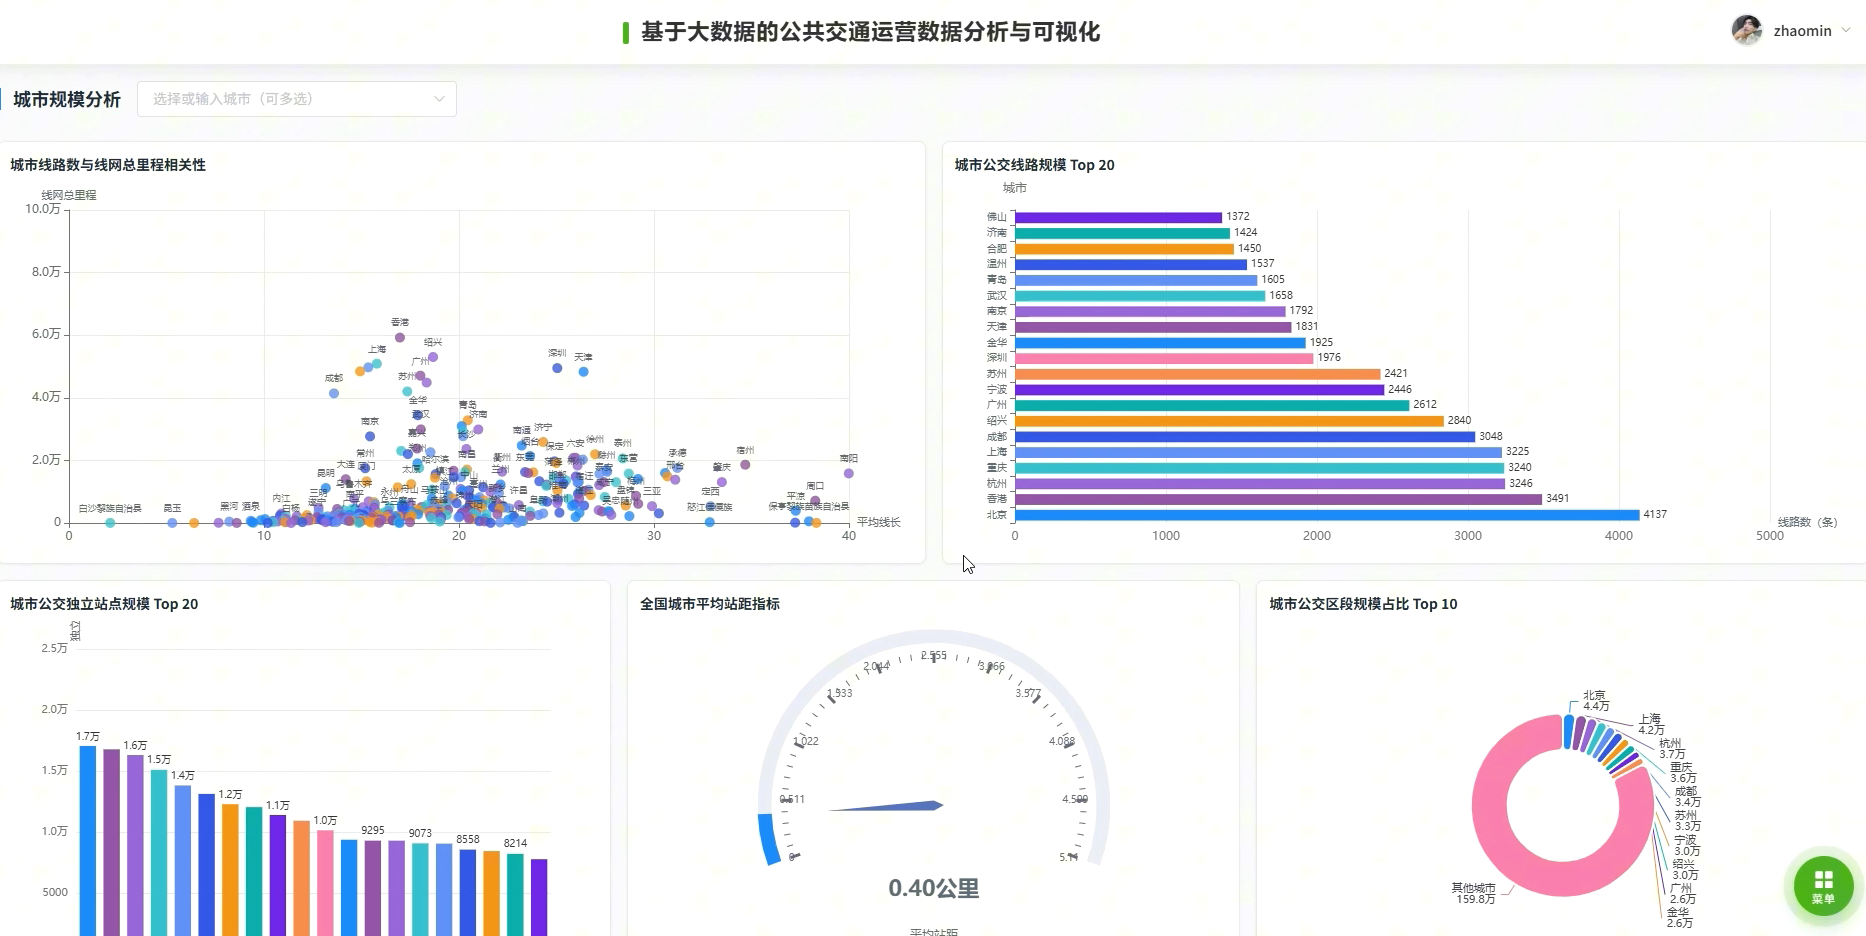
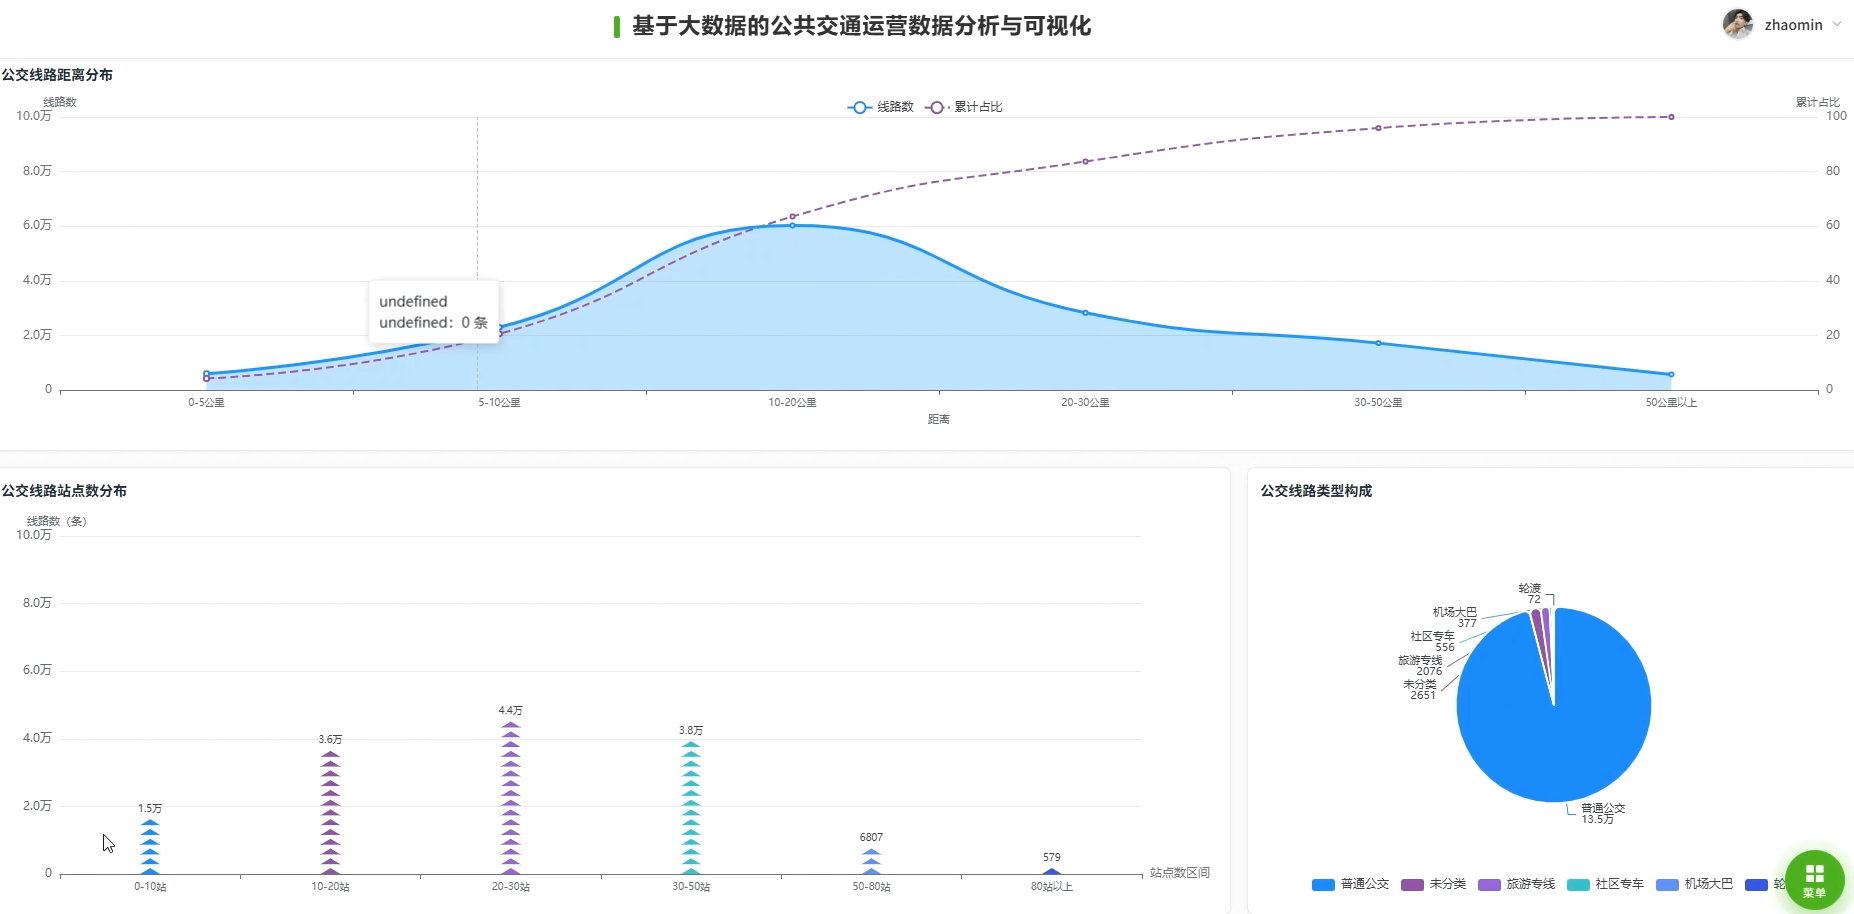
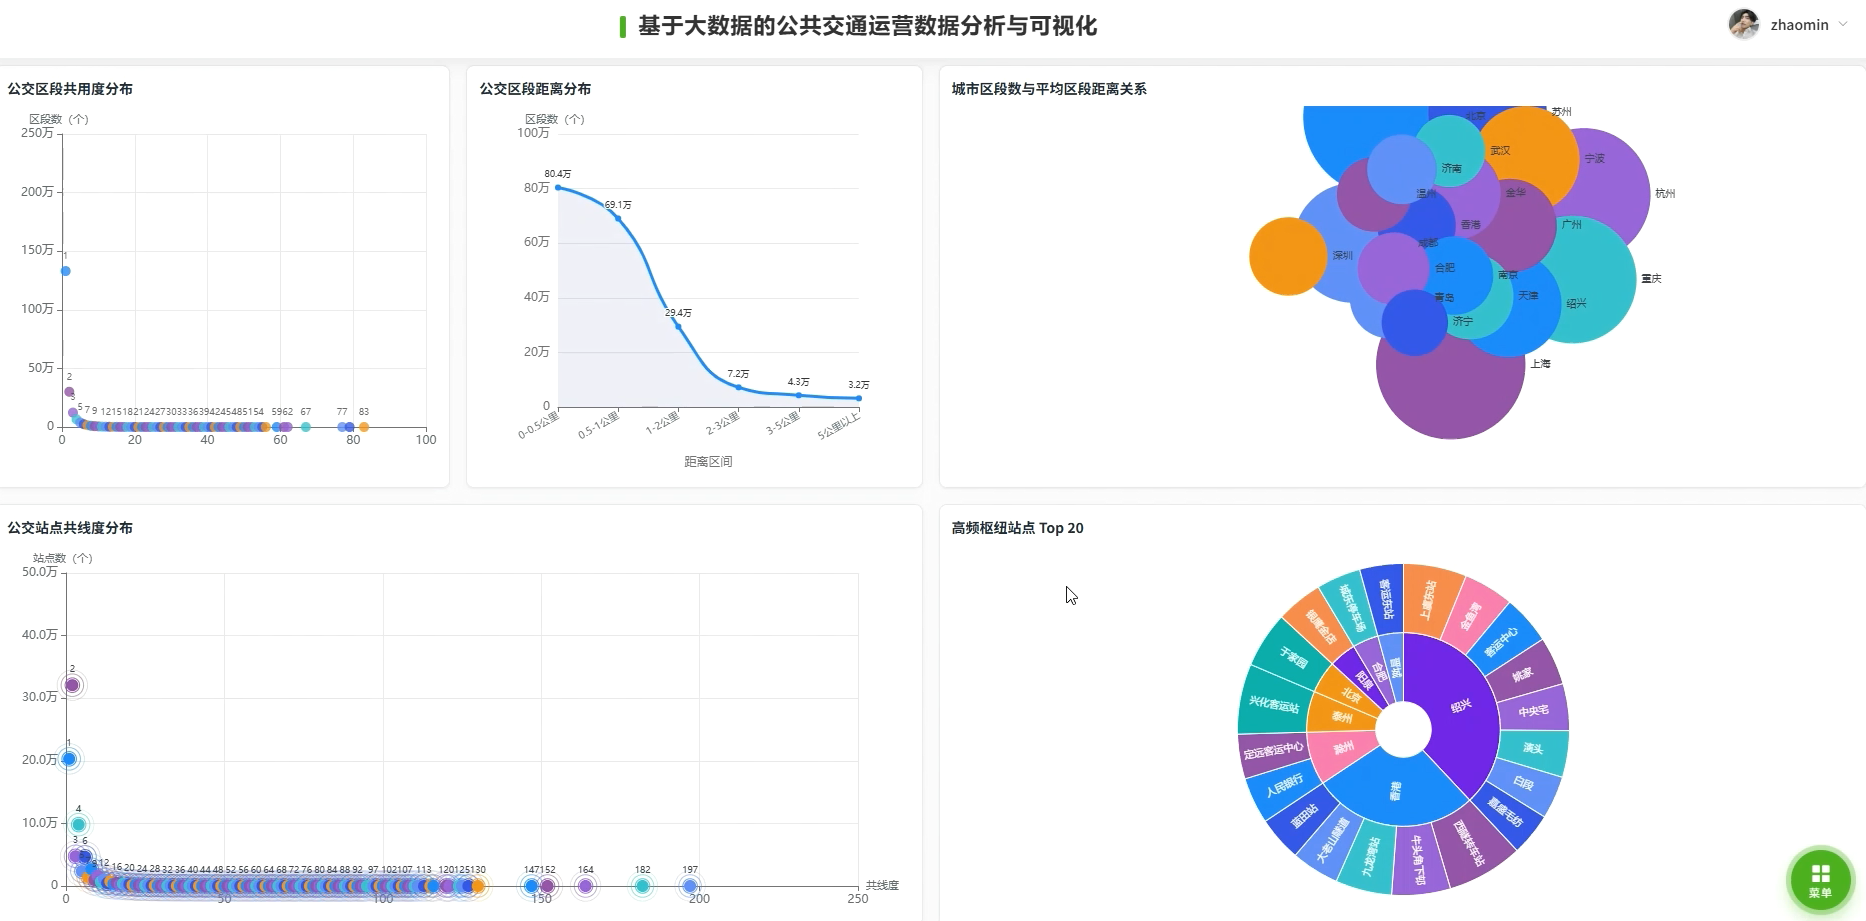
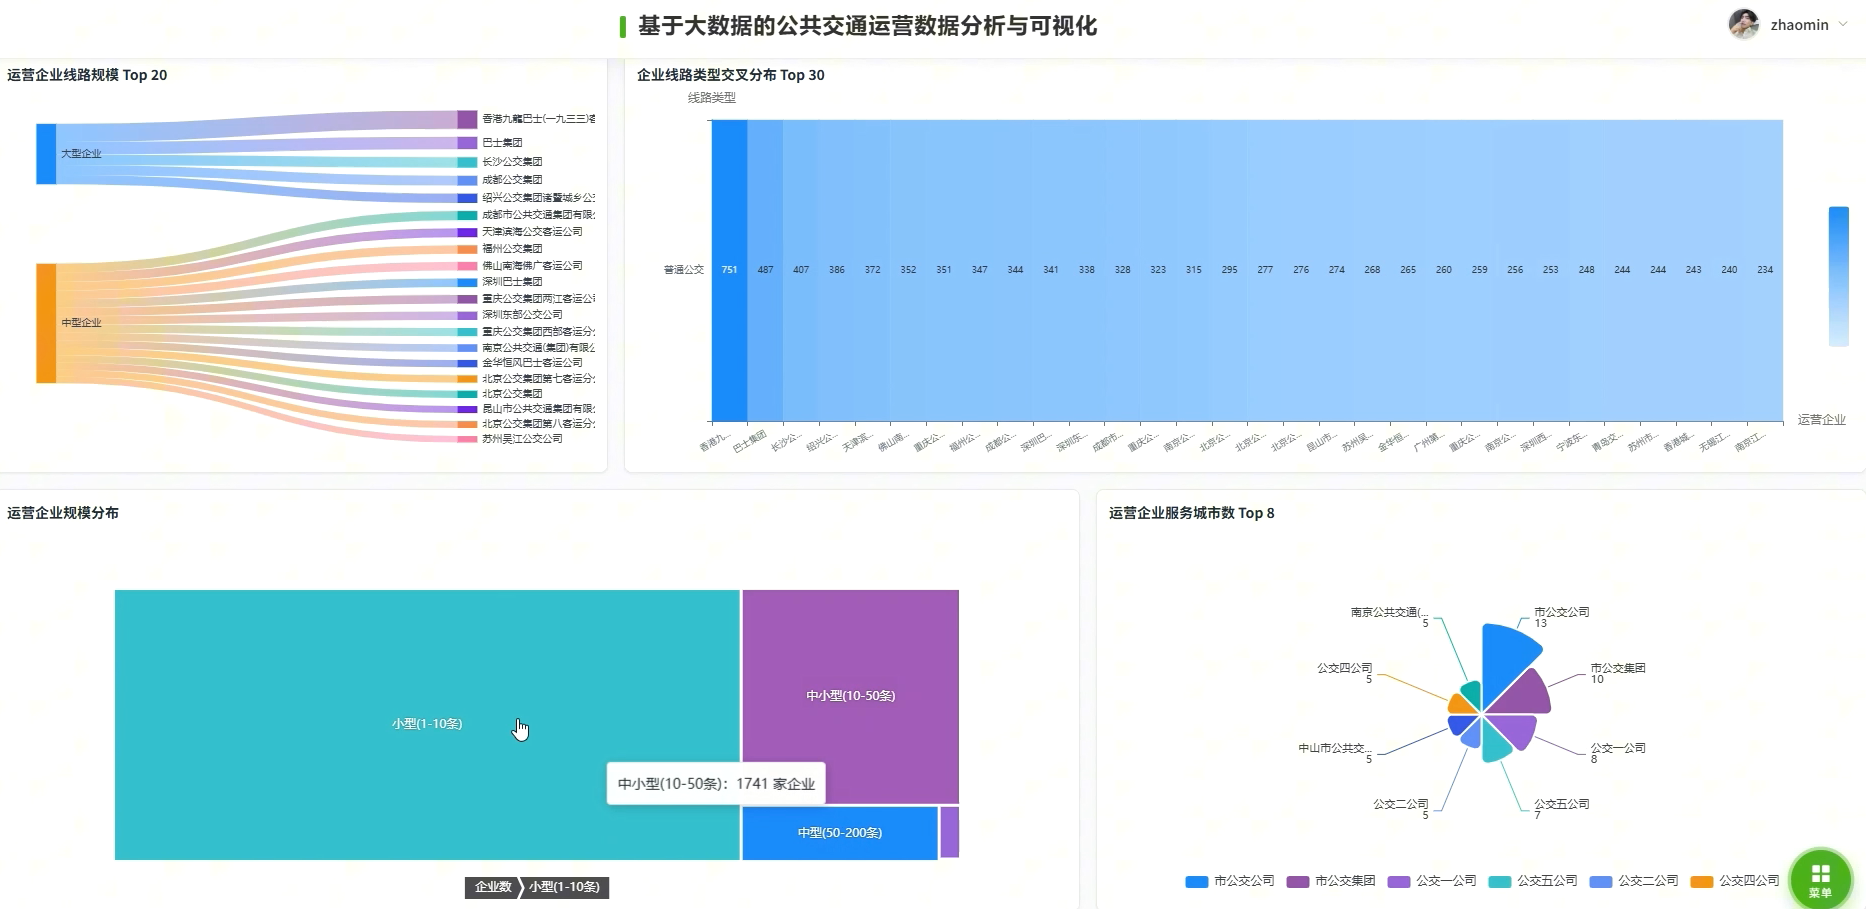
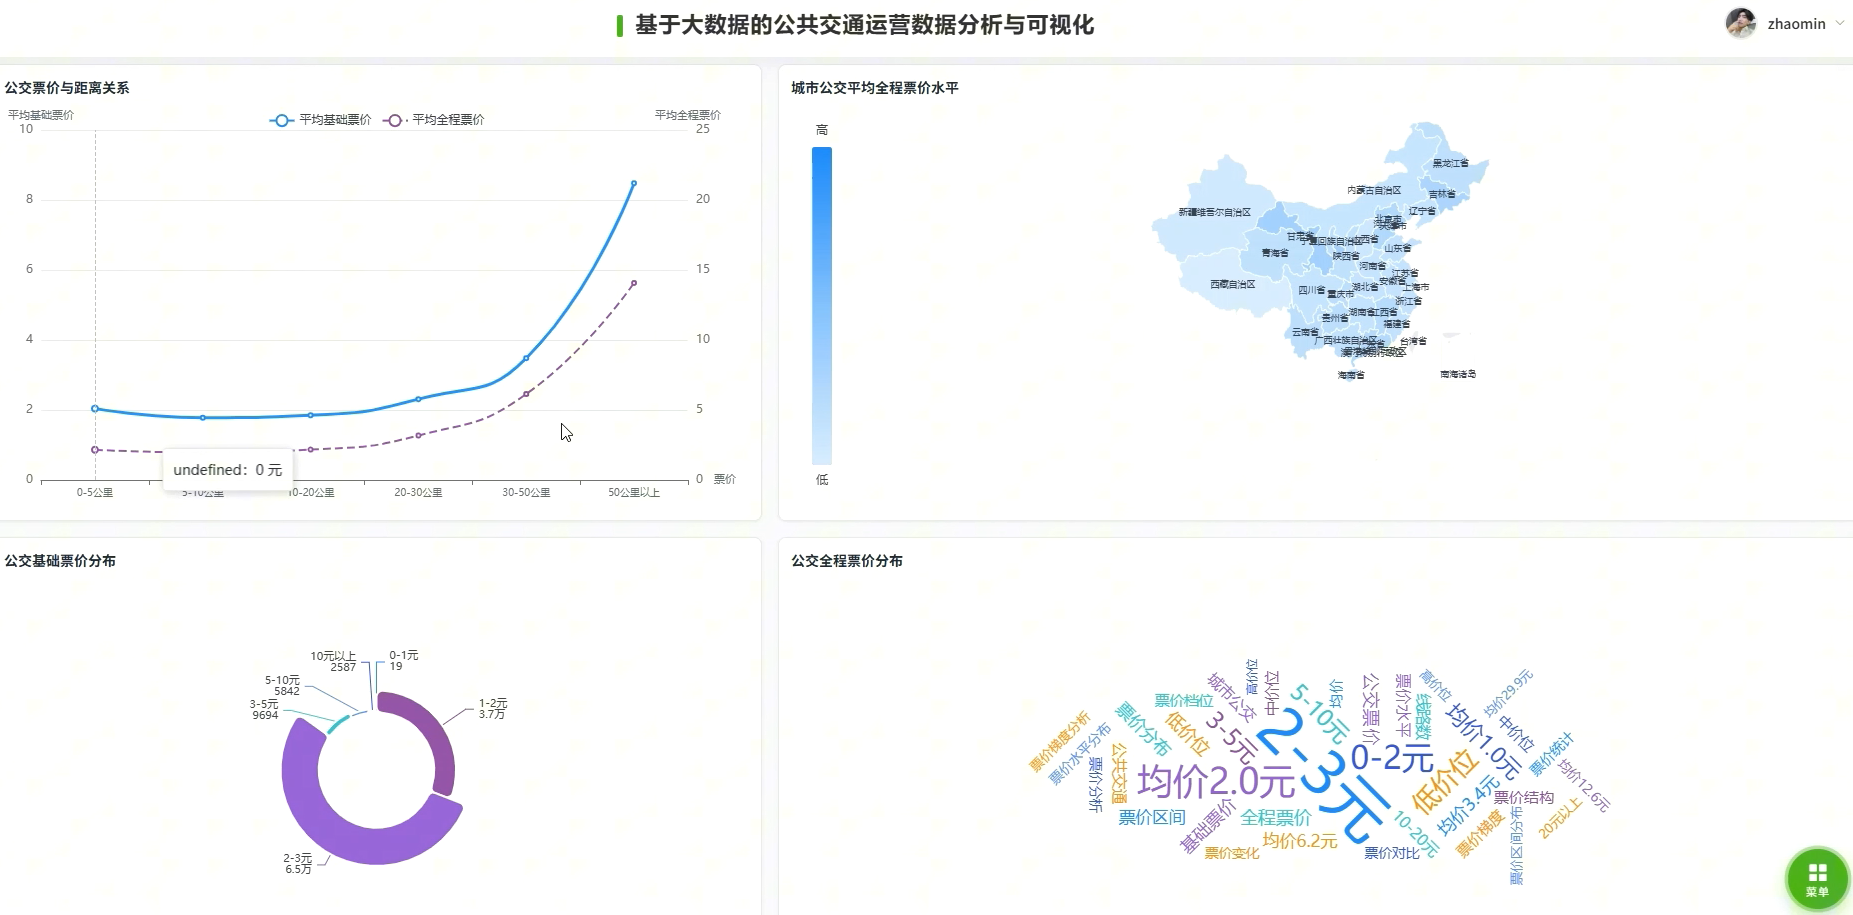
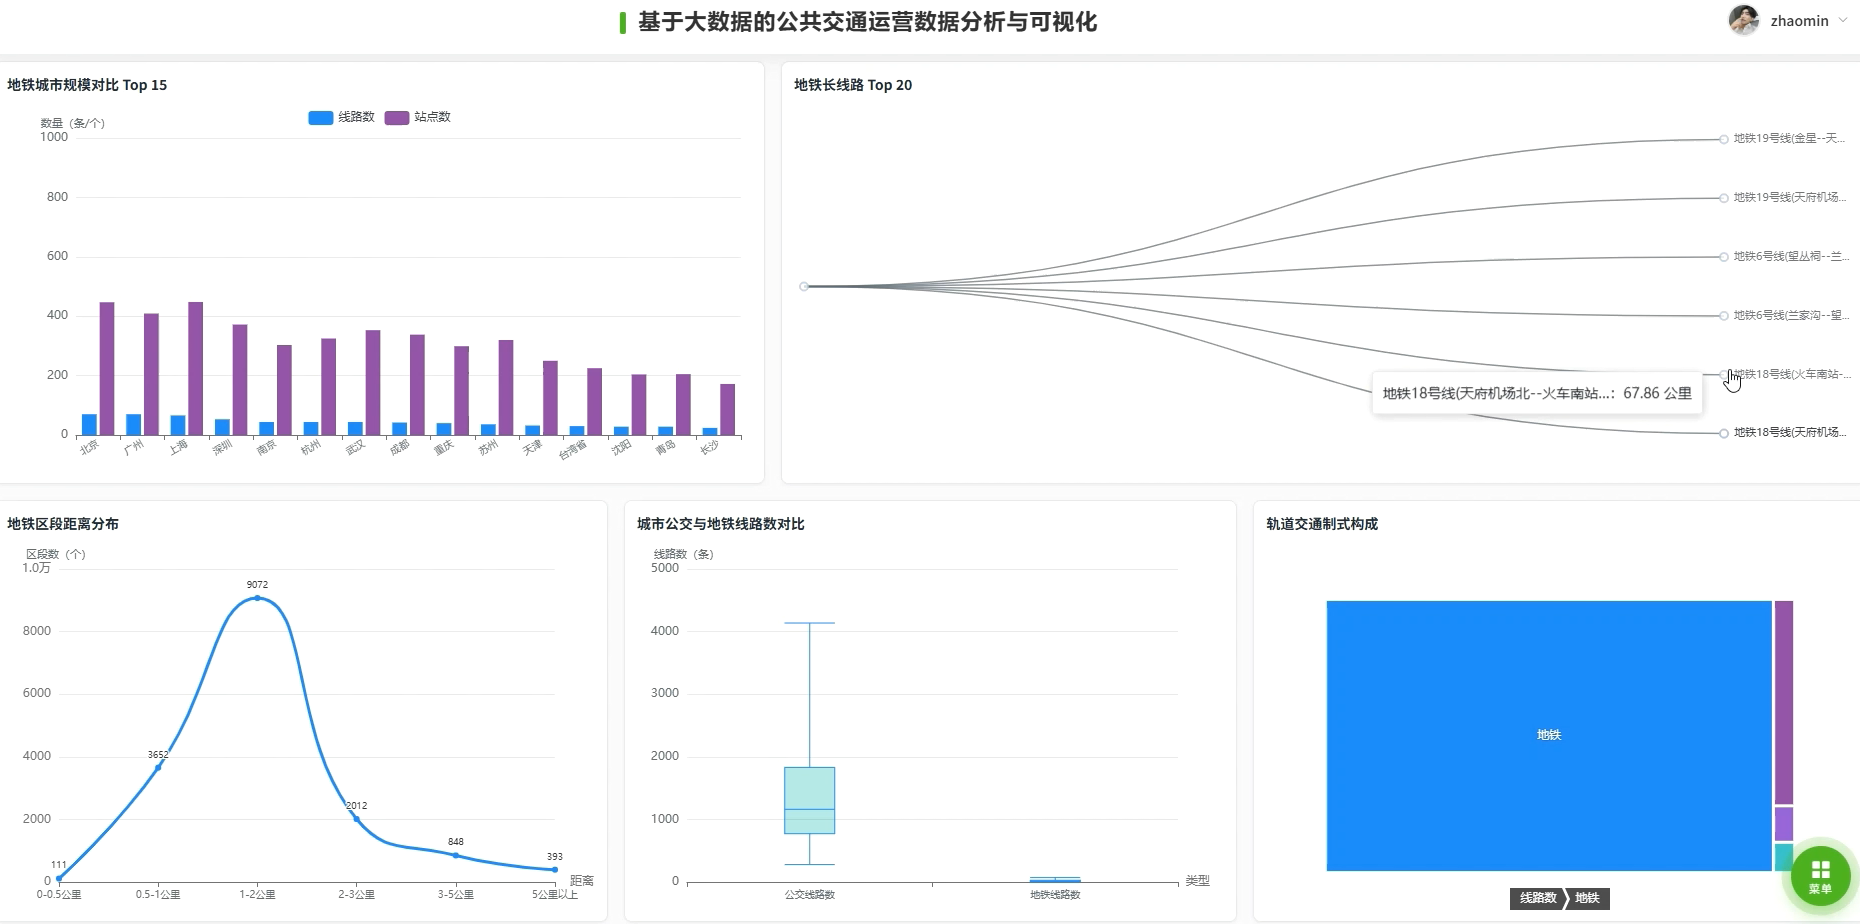
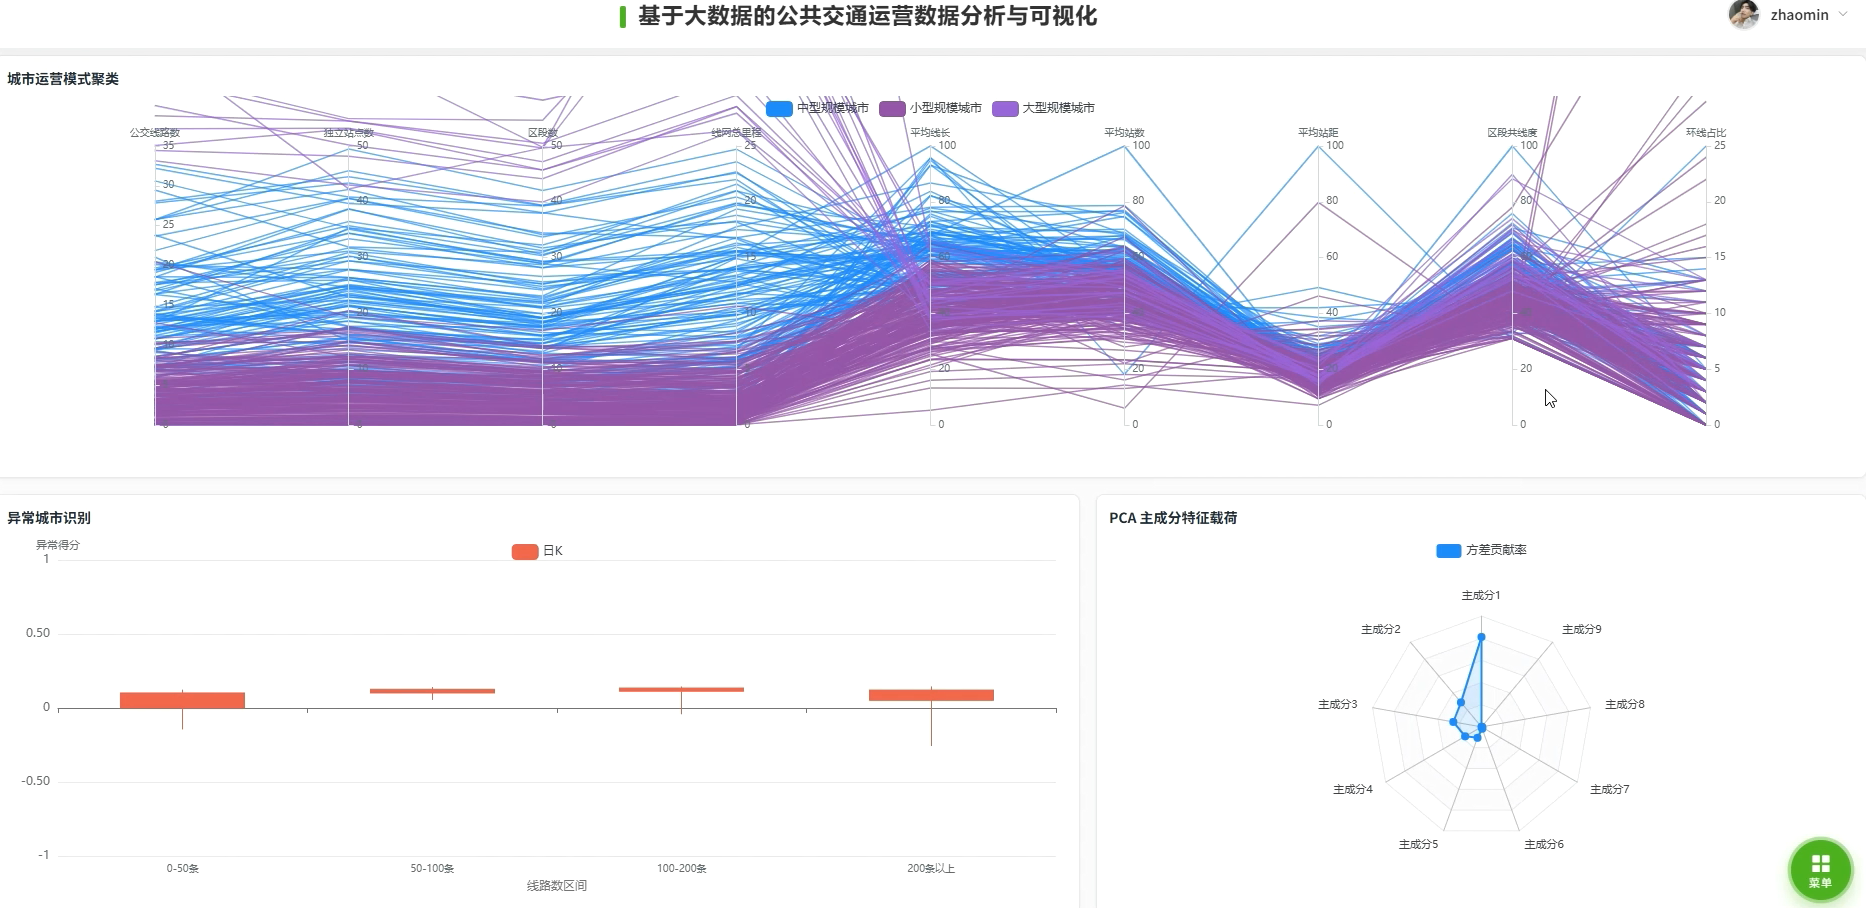
本系统以Python+PySpark为核心计算引擎,在Hadoop集群上完成ETL清洗与聚合统计,后端采用Django提供API,前端用Vue+ECharts搭建可视化大屏。系统覆盖城市规模、线路特征、站点网络、运营企业、票价结构、轨道交通、运营模式七个分析维度,其中运营模式分析对城市级聚合特征施以K-Means聚类、PCA主成分降维和Isolation Forest异常检测三项算法,输出城市分群标签、综合得分排名和离群城市清单。
经系统测试,本系统能满足交通规划人员与研究人员对多城市公交地铁线网结构对比、运营模式分类及异常城市识别的分析需求,为公共交通资源配置与线网优化提供数据参考。
二、视频展示
计算机毕设选题推荐:基于大数据的公共交通运营数据分析与可视化
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
系统页面模块展示:
五、代码展示
bash
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, countDistinct, count, sum as spark_sum, avg, round as spark_round
from pyspark.sql.types import DoubleType

spark = SparkSession.builder.appName('TransitAnalysis').getOrCreate()

# 读取全量CSV
df_stops = spark.read.option('header', 'true').csv('hdfs://bus_stops_all.csv', inferSchema=True)
df_routes = spark.read.option('header', 'true').csv('hdfs://bus_routes_all.csv', inferSchema=True)

# 类型清洗:metro_routes的distance是字符串,转为Double
df_routes = df_routes.withColumn('distance', col('distance').cast(DoubleType()))

# 1. 城市规模统计:按城市聚合线路数、独立站点数、总里程
city_scale = df_routes.groupBy('city_cn').agg(
    countDistinct('route_id').alias('route_count'),
    spark_round(sum('distance'), 2).alias('total_mileage')
)

# 2. 站点共线度:按stop_id分组,对route_id去重计数
stop_transfer = df_stops.groupBy('city_cn', 'stop_id', 'name_cn').agg(
    countDistinct('route_id').alias('co_line_degree')
).filter(col('co_line_degree') > 1)

# 3. 高频枢纽站点:按共线度降序取Top
top_hubs = stop_transfer.orderBy(col('co_line_degree').desc()).limit(20)

# 4. 票价与距离关系:按距离分箱计算平均票价
distance_bins = [0, 5, 10, 20, 30, 50, 100]
df_routes_binned = df_routes.withColumn(
    'distance_bin',
    when(col('distance') < 5, '0-5km')
    .when(col('distance') < 10, '5-10km')
    .when(col('distance') < 20, '10-20km')
    .when(col('distance') < 30, '20-30km')
    .when(col('distance') < 50, '30-50km')
    .otherwise('50km+')
)
price_distance = df_routes_binned.filter(col('basic_prc').isNotNull()).groupBy('distance_bin').agg(
    spark_round(avg('basic_prc'), 2).alias('avg_basic_price')
)
六、项目文档展示

七、项目总结
系统以全国350个城市的公交数据与46个城市的地铁数据为分析对象,预处理阶段使用GeoPandas将Shapefile属性表批量导出为CSV,规避GIS格式在Spark集群上的读取瓶颈;计算分析阶段以PySpark为核心引擎,在Hadoop集群上完成城市规模聚合、站点共线度计算、区段共用度统计及票价结构分析等批量处理任务,业务层面覆盖城市规模、线路特征、站点网络、运营企业、票价结构、轨道交通六大分析模块,并基于城市级聚合特征表进一步引入K-Means聚类、PCA主成分降维与Isolation Forest异常检测三项无监督算法,从数据挖掘视角识别城市运营模式类别、合成综合发展水平排名并定位结构与规模异常的离群城市。后端采用Django提供API接口,前端基于Vue与ECharts搭建可视化大屏,实现了多维度分析结果的联动展示与图表交互。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页 :计算机毕设木哥🔥 💖