《AI 知识卡片》第 17 期 · 模型自己什么都不记得,是你每次把整段聊天重新递了一遍
换个医生看同一个毛病,你得从头把病史再讲一遍。讲久了你会自己想办法:要么只讲最近这两周的症状,要么随身带一页纸的病历摘要,要么把几年前的检查单收进一个文件夹,医生问到哪一段你就翻哪一段。
大模型面对的也是类似的处境,而且它比换个医生忘的更彻底------它连上一句都不记得。
模型不记事,是你替它记的
调用大模型时,除了传入当前对话的 query,还需要递过去一个 messages 数组:先放 SystemMessage 交代角色,再放 HumanMessage。模型返回 AIMessage,如果里面带了 tool_calls,你就执行工具、追加 ToolMessage、再发起调用------直到不再返回 tool_calls。
模型每一次都是从零开始读这个数组。能接上话,全靠历史消息又被完整地递了一遍。这套「不断往数组里 push」的做法有个必然的终点:上下文有上限。所谓大模型的 Memory 管理,本质就是这个数组的预算。
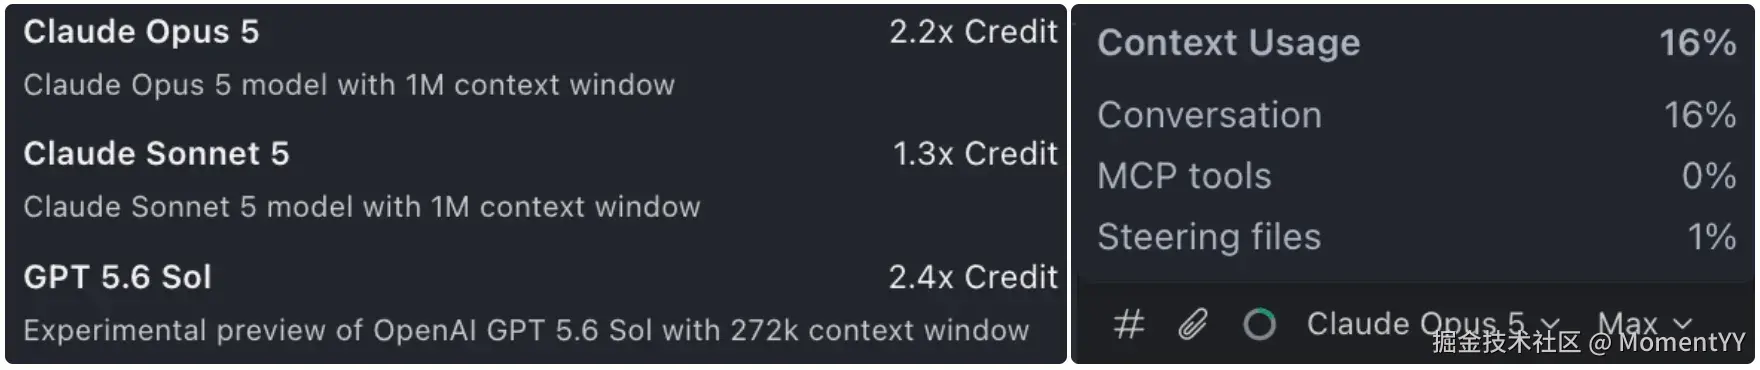
常见大模型的上下文上限:Claude Opus 5(1M)、GPT 5.6 Sol(272k)。
三种策略:截断、总结、检索
主流做法就三种,差别在于「旧消息怎么处置」:
| 策略 | 做法 | 旧消息处理 |
|---|---|---|
| 截断 | 保留最近 N 条,或按 token 数保留最近若干条 | 直接丢弃 |
| 总结 | 让模型给旧消息生成摘要,摘要 + 最近几条一起发 | 压缩成一段文字 |
| 检索 | 历史存进向量数据库,按当前提问召回相关的那几条 | 挪到库里,用得上才回来 |
截断最省事,按 token 截断的核心就一个 API:
javascript
import { HumanMessage, AIMessage, trimMessages } from "@langchain/core/messages";
import { getEncoding } from "js-tiktoken";

const enc = getEncoding("cl100k_base");
const countTokens = (msgs) => msgs.reduce((n, m) => n + enc.encode(m.content).length, 0);

const messages = [
  new HumanMessage("我想去北京玩"),
  new AIMessage("北京是个很棒的选择!你打算什么时候去?"),
  new HumanMessage("大概十一黄金周,想看天安门"),
  new AIMessage("十一期间天安门广场会有花坛布置,非常壮观。你还想去哪些地方?"),
  new HumanMessage("故宫和长城也想去,帮我推荐一下路线"),
  new AIMessage("建议第一天天安门+故宫,第二天八达岭长城,第三天颐和园+圆明园。"),
];

// 按 token 预算保留最近的消息,超出的直接丢弃
const trimmed = await trimMessages(messages, {
  maxTokens: 100,
  tokenCounter: (msgs) => countTokens(msgs), // tiktoken 精确计数
  strategy: "last",                          // 保留最近的
});
// 结果:前 3 条被丢弃,只剩最近的 3 条(96 token)总结需多花一次模型调用:超阈值时,把旧消息交给模型压成一句摘要,再和最近几条拼回去。大多数编码助手就是这套------上下文达上限动触发总结。
javascript
import { SystemMessage, getBufferString } from "@langchain/core/messages";

const totalTokens = countTokens(allMessages); // 247 token,超过阈值 100

// 从后往前保留最近的消息(约 80 token),剩下的交给模型总结
const recentMessages = allMessages.slice(-2);                // 最近 1 轮
const oldMessages = allMessages.slice(0, -2);                // 前 8 条要被总结
const oldText = getBufferString(oldMessages, { humanPrefix: "用户", aiPrefix: "助手" });

const summary = (await model.invoke([
  new SystemMessage(`请用一句话总结以下对话:\n${oldText}`)
])).content;
// → "用户计划十一黄金周去北京,关注天安门、故宫、长城路线及住宿预算"

// 摘要塞进 system,和最近几条一起发
const newMessages = [
  new SystemMessage("你是一个旅行助手"),
  new SystemMessage(`之前的对话摘要:${summary}`),
  ...recentMessages,
];
// 10 条 247 token → 4 条约 150 token检索本质上就是 RAG,只不过检索数据换成了对话记录:每轮对话算出向量写进向量库,下次提问先检索最相关的几条历史拼进 prompt。不管多久以前聊过,都能被捞出来。
javascript
import { OpenAIEmbeddings } from "@langchain/openai";
import { MilvusClient, MetricType } from "@zilliz/milvus2-sdk-node";

const embeddings = new OpenAIEmbeddings({ model: "text-embedding-v3", dimensions: 1024 });
const client = new MilvusClient({ address: "localhost:19530" });

// 存:每轮对话写入向量库
const content = `用户: ${humanText}\n助手: ${aiText}`;
const vector = await embeddings.embedQuery(content);
await client.insert({
  collection_name: "conversations",
  data: [{ id: `conv_${roundNum}`, vector, content, round: roundNum }],
});

// 取:按当前问题召回最相关的历史
const queryVector = await embeddings.embedQuery("北京住哪里比较方便");
const results = await client.search({
  collection_name: "conversations",
  vector: queryVector,
  limit: 2,
  metric_type: MetricType.COSINE,
  output_fields: ["content"],
});
// → 召回了"住宿建议"那轮(相似度 0.63)和"去北京玩"那轮(0.59)

// 拼:召回的历史塞进 prompt
const context = results.results.map((r) => r.content).join("\n---\n");
const response = await model.invoke([
  new SystemMessage(`以下是与用户的历史对话片段,请参考回答:\n${context}`),
  new HumanMessage("北京住哪里比较方便"),
]);
// 回答完后把这一轮也写回向量库
各有各的代价
截断最便宜,代价是真的会丢事实------三十轮前说过的名字,扔掉就是扔掉了。
总结不丢主线但会磨掉细节,而且不可逆:摘要生成完原始消息被清空,还得额外付一次模型调用。
检索能翻回任意久以前的内容,但要养一套向量库和 embedding 服务,召回准不准直接决定它有没有用------捞错了两条历史,比不捞更糟。
真实项目里常见的是总结加检索一起上,比如:每聊够二十条触发一次总结,把摘要写进向量库。这样既压住了单轮的 token,又保留了长期可回溯的线索。
一句话总结
模型无状态,Memory 管理的好坏决定了你们对话的质量和效率。