用 XGrammar 约束大模型工具调用:解决参数为空的问题
工具调用成功了,为什么
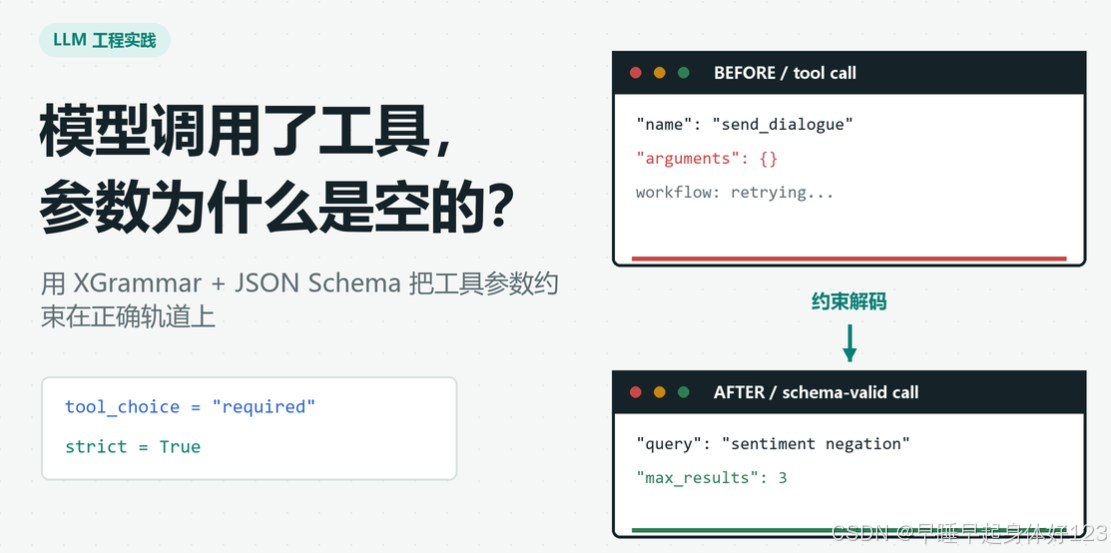
arguments仍然可能是空对象?这篇文章记录一个多智能体系统中的真实问题,以及如何使用tool_choice、严格 JSON Schema 和 XGrammar 提高工具调用的可靠性。
一、问题背景
最近在运行一个面向科研场景的多智能体系统(Multi-Agent System,MAS)时,我遇到了一个比较棘手的问题。
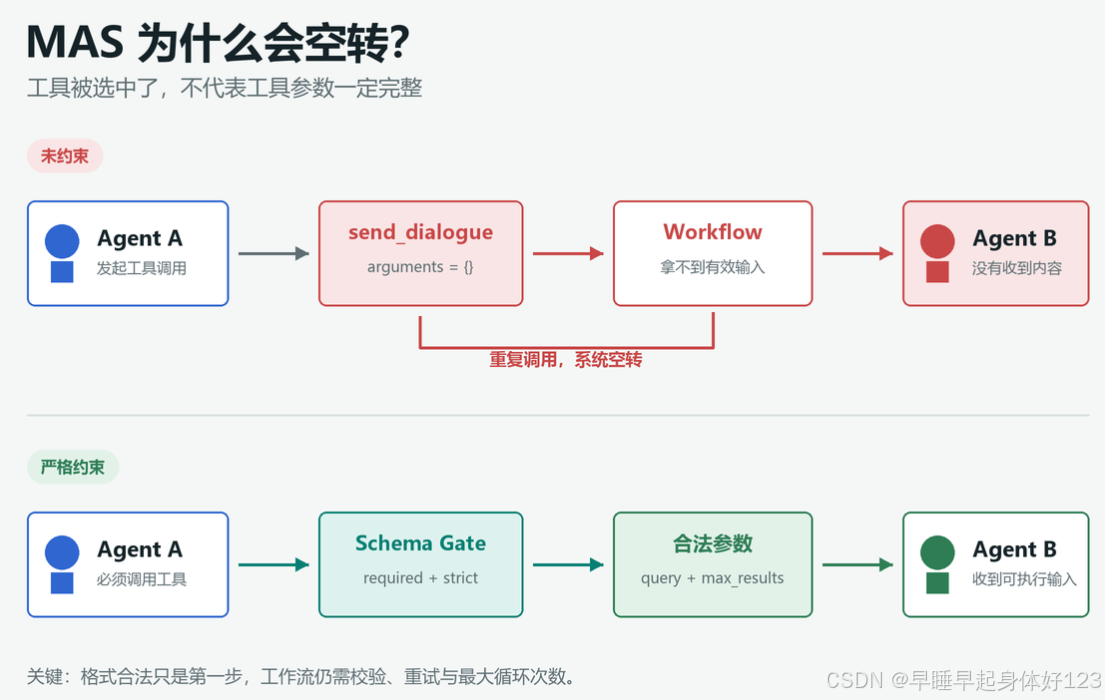
系统中的 Agent 主要通过工具完成工作,Agent 之间也不直接交换自然语言消息。例如,Agent A 需要先调用 send_dialogue,生成准备发送给 Agent B 的内容,再由工作流把工具参数传递给 Agent B。
简化后的链路如下:
text
Agent A -> send_dialogue -> Workflow -> Agent B项目使用的是 Qwen 32B 级别的模型。在处理较复杂的任务时,模型偶尔会返回这样的工具调用:
json
{
  "name": "send_dialogue",
  "arguments": {}
}
从协议层面看,模型已经"调用了工具";但从业务层面看,真正需要的参数一个都没有。
如果工作流没有及时校验并终止这类调用,就可能出现下面的情况:
- Agent A 发起工具调用;
- 工具执行器发现参数为空,无法执行;
- 错误没有被正确反馈给 Agent;
- Agent 再次生成同样的空调用;
- 整个系统不断重试,看起来像是在运行,实际上一直空转。
一开始,我尝试在 Prompt 中反复强调"必须填写所有参数""不允许返回空对象",但这只能提高成功概率,不能提供确定性保证。
模型能力是影响因素之一,但并不是唯一原因。JSON Schema 是否正确、必填字段是否声明、Chat Template 和 Tool Call Parser 是否匹配,以及工作流有没有参数校验,都会影响最终结果。
二、为什么 tool_choice="required" 还不够?
在兼容 OpenAI 风格的接口中,可以通过下面的参数要求模型必须调用工具:
python
tool_choice = "required"它解决的是"这一轮要不要调用工具"的问题,含义是:本轮必须调用至少一个工具。
但是,下面的结果同样满足"调用了工具":
json
{
  "name": "search_arxiv",
  "arguments": {}
}
模型确实选择了 search_arxiv,只是没有填写参数。因此,仅设置 tool_choice="required",不能等价为"参数一定完整"。
可以把两个配置的职责概括为:
text
tool_choice="required":要求本轮至少调用一个工具
strict=True:要求工具参数符合声明的 JSON Schema
三、使用严格 JSON Schema 约束工具参数
在支持严格工具 Schema 的推理框架和版本中,可以在工具定义里加入 strict=True:
python
def schema(self):
    return {
        "type": "function",
        "function": {
            "name": self.name,
            "description": self.description,
            "strict": True,
            "parameters": self.parameters,
        },
    }
仅仅打开 strict 还不够,parameters 本身也要写严谨。下面以论文搜索工具为例:
python
search_arxiv = {
    "type": "function",
    "function": {
        "name": "search_arxiv",
        "description": "Search papers on arXiv.",
        "strict": True,
        "parameters": {
            "type": "object",
            "properties": {
                "query": {
                    "type": "string",
                    "description": "The paper topic or search query.",
                    "minLength": 1,
                },
                "max_results": {
                    "type": "integer",
                    "description": "Maximum number of returned papers.",
                    "minimum": 1,
                    "maximum": 10,
                },
            },
            "required": ["query", "max_results"],
            "additionalProperties": False,
        },
    },
}
这里有四类重要约束:
required:规定哪些字段必须出现;minLength:避免字符串虽然存在,却仍然是空字符串;minimum和maximum:限制数字的合法范围;additionalProperties=False:禁止生成 Schema 之外的字段。
调用接口时,再配合 tool_choice="required":
python
response = client.chat.completions.create(
    model=model_name,
    messages=messages,
    tools=[search_arxiv],
    tool_choice="required",
    temperature=0,
    max_tokens=512,
)
理想输出类似:
json
{
  "query": "sentiment negation",
  "max_results": 3
}
四、XGrammar 在其中做了什么?
XGrammar 是一个用于结构化生成和约束解码的 Grammar Engine。它可以把 JSON Schema、正则表达式或 EBNF 等约束编译成生成规则,并在模型生成每个 Token 时屏蔽不合法的候选项。
假设 Schema 规定 query 和 max_results 都是必填字段。当模型只生成了 {,或者只生成了其中一个字段时,此时直接输出 } 会形成不符合 Schema 的对象。约束解码器会屏蔽这类候选,让模型继续生成仍然合法的内容。
这与"生成完成后发现格式错误,再要求模型修改"不同。约束是在解码过程中实时生效的。
在当前 SGLang 文档中,XGrammar 是默认的 Grammar Backend,也可以在启动服务时显式指定:
bash
python -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-32B-Instruct \
  --tool-call-parser qwen25 \
  --grammar-backend xgrammar
上面的模型和 Parser 仅作为示例。不同 Qwen 型号及不同 SGLang 版本支持的 Parser 名称可能不同,应以实际版本文档为准。strict=True 表示要求严格遵循工具参数 Schema;真正执行约束的是推理端配置的 Grammar Backend,而不是这个字段单独"启动"了 XGrammar。
五、有哪些方法可以让模型结构化输出?
结构化输出并不只有一种实现方式。不同方法解决的问题不同,可靠性、成本和接入难度也不一样。
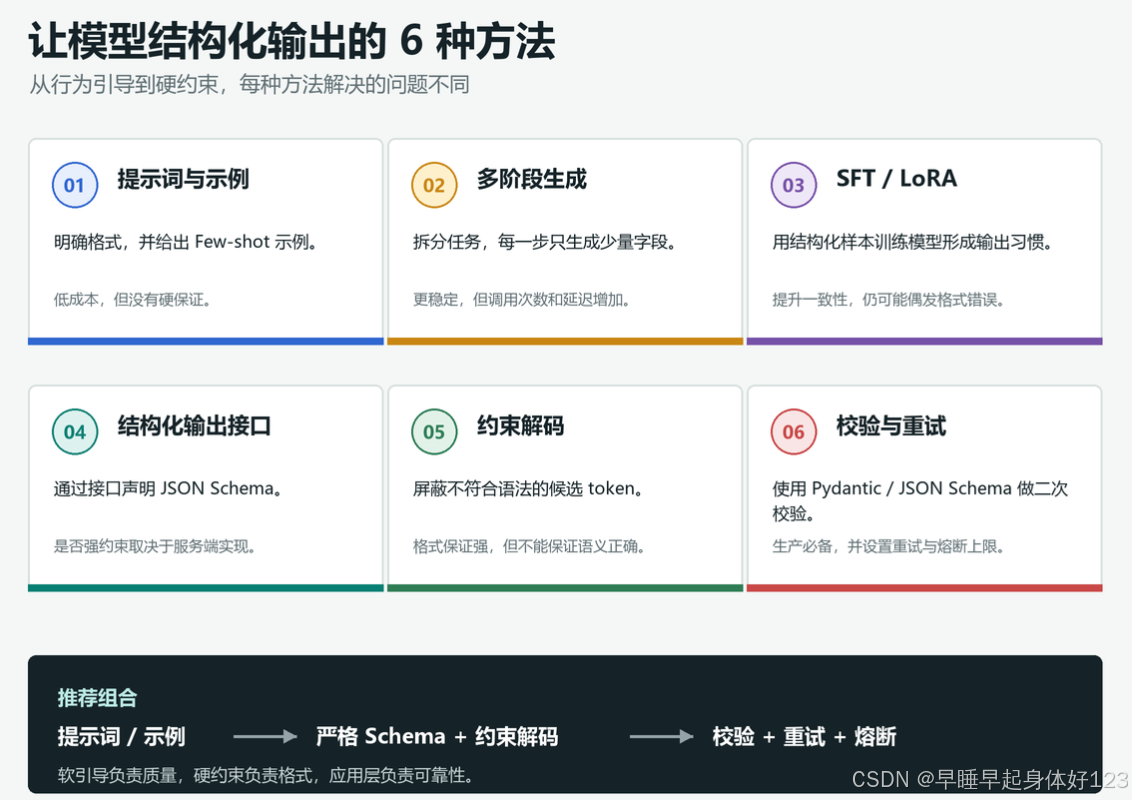
1. 提示词与 Few-shot 示例
在 Prompt 中明确要求输出 JSON、XML 或其他固定格式,并提供一到多个正确示例。
这种方法成本最低,适合原型验证;但它属于行为引导,不能保证模型每次都严格遵守格式。
2. 多阶段生成
将复杂结构拆成多个步骤,让模型每次只生成少量字段,最后再由程序组装结果。
这种方式可以降低单次生成难度,但会增加请求次数、延迟和工作流复杂度。
3. SFT 与 LoRA
使用大量符合目标格式的输入输出样本进行监督微调(SFT)。LoRA 可以作为一种参数高效的微调方式,降低训练和显存成本。
微调能够让模型形成更稳定的输出习惯,但仍然不是严格的格式证明,极端输入下依然可能出错。
4. 结构化输出接口
通过服务提供的 tools、response_format 或 json_schema 等参数声明期望结构。
需要注意,接口只是使用入口。它究竟属于"格式提示"还是"硬约束",取决于服务端是否真正接入了约束解码,以及当前模型、Parser 和版本是否支持。
5. Constrained Decoding(约束解码)
在每一步生成时,根据 JSON Schema、Grammar、正则表达式等规则,过滤掉会导致输出非法的候选 Token。
这种方法能够提供较强的格式保证,尤其适合能力有限但必须精确输出结构的小模型。不过,它只能保证格式和声明的约束成立,不能保证内容在语义上正确。
6. 应用层校验与重试
在拿到模型结果后,使用 Pydantic、JSON Schema Validator 或业务代码再次检查:
- 字段是否为空;
- 数值是否在合理范围内;
- 枚举值是否受支持;
- 参数之间是否满足业务关系;
- 工具是否真的适合当前任务。
如果校验失败,应把明确的错误原因反馈给 Agent,并进行有限次数的重试,而不是让工作流无限循环。
六、生产环境中的推荐组合
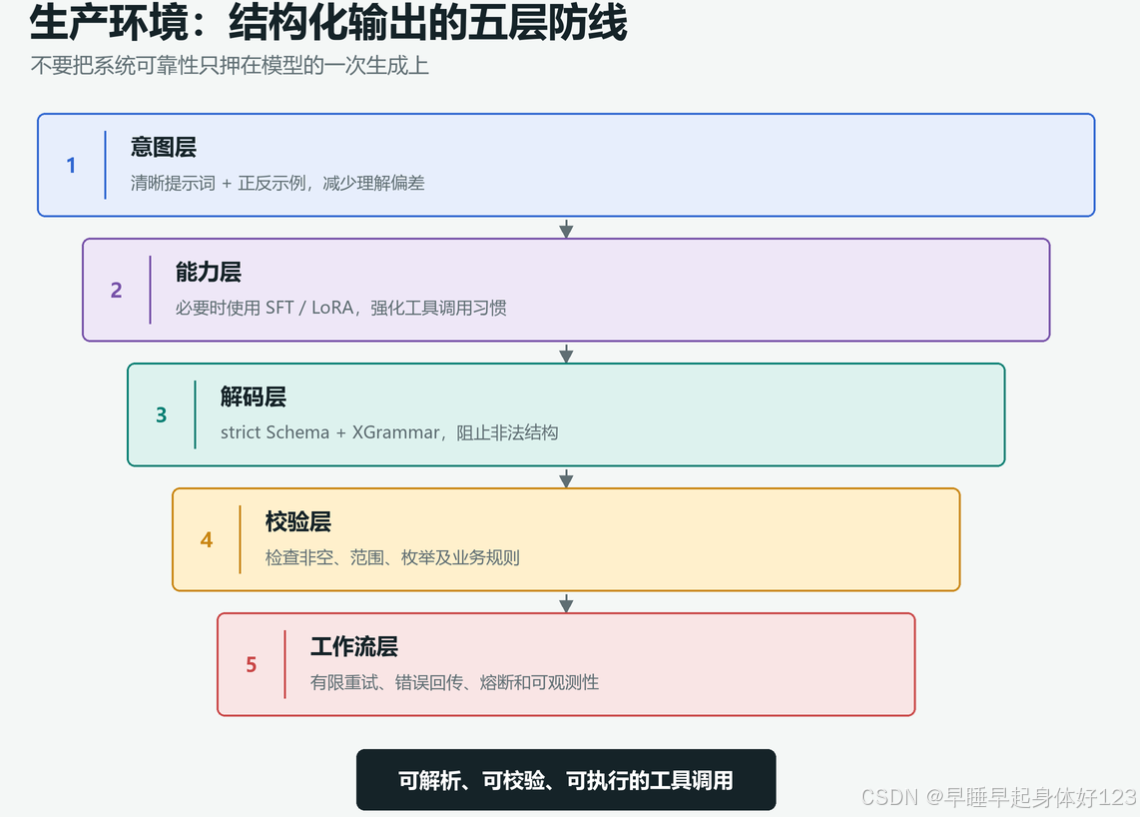
对于多智能体系统,我更推荐组合使用下面几层措施:
text
清晰 Prompt 和示例
        ↓
严格 JSON Schema + 约束解码
        ↓
应用层参数校验
        ↓
有限重试、错误回传和熔断
        ↓
日志、指标与链路追踪
尤其要注意下面几点:
- 匹配模型与 Tool Call Parser:解析器或 Chat Template 不匹配时,Schema 再严格也无法弥补协议解析问题。
- 把语义要求写进 Schema :字符串使用
minLength,数字使用范围约束,固定选项使用enum。 - 执行前再次校验:不要因为输出经过约束解码,就跳过业务层校验。
- 限制 Agent 最大循环次数:避免同一种失败反复发生并持续消耗 Token。
- 记录原始输出和失败原因:方便区分模型错误、解析错误、Schema 错误和工具执行错误。
七、XGrammar 不能解决什么?
XGrammar 能保证输出符合可执行的结构约束,但不能保证:
- 模型选择了最合适的工具;
query的内容与用户意图一致;- 参数虽然合法,但业务含义一定正确;
- 请求被
max_tokens截断时仍能得到完整结果; - 所有 JSON Schema 关键字都被当前版本完整支持;
- 所有模型的并行工具调用格式都能被 Parser 正确解析。
因此,更准确的说法不是"XGrammar 解决了工具调用的所有问题",而是:
XGrammar 把原本依赖模型自觉遵守的格式要求,变成了解码阶段的强约束,从而显著降低缺少必填参数和结构非法的概率。
八、总结
这个问题的关键在于区分两个概念:
text
调用工具 ≠ 参数完整
结构合法 ≠ 语义正确
tool_choice="required" 负责要求模型调用工具,strict=True 和严格 JSON Schema 负责约束参数结构,XGrammar 在解码阶段阻止不合法的 Token,而应用层校验、重试和熔断则负责整个工作流的最终可靠性。
当显存有限、只能部署 32B 甚至更小的模型时,约束解码尤其有价值。它没有让模型本身变得更聪明,而是缩小了模型可以犯错的空间。