一个 AI Agent 帮你整理资料、查数据库、写邮件,看起来都很顺利。问题出现在最后一步:它把邮件直接发给了客户,顺手把共享盘里"旧版本"文件删掉,还把 CRM 里的联系人状态改了。
这些动作单独看都不复杂,却有一个共同点:一旦做错,影响已经进入真实世界。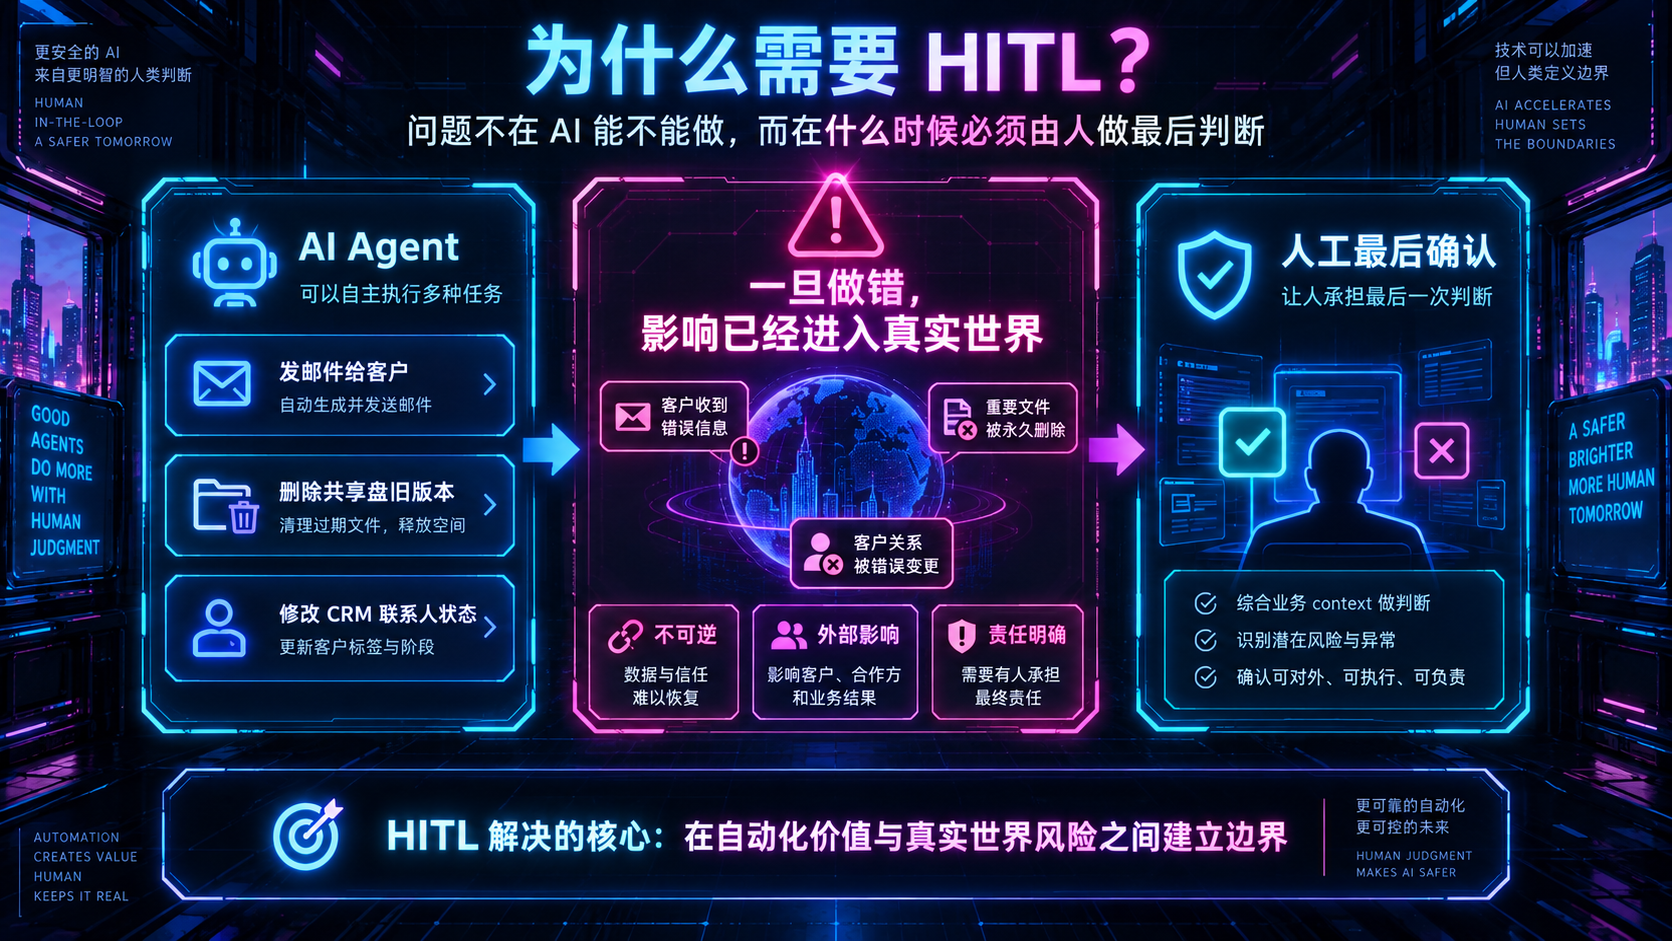
所以,Human-in-the-Loop(HITL)真正要解决的,不是"AI 能不能做",而是"什么时候必须由人承担最后一次判断"。审批设计如果太松,会出事故;如果所有操作都审批,Agent 又会退化成一个不断弹窗的半自动工具。
真正合理的边界,是按风险,而不是按工具类型来划。
不是所有 Write Tool 都需要人工审批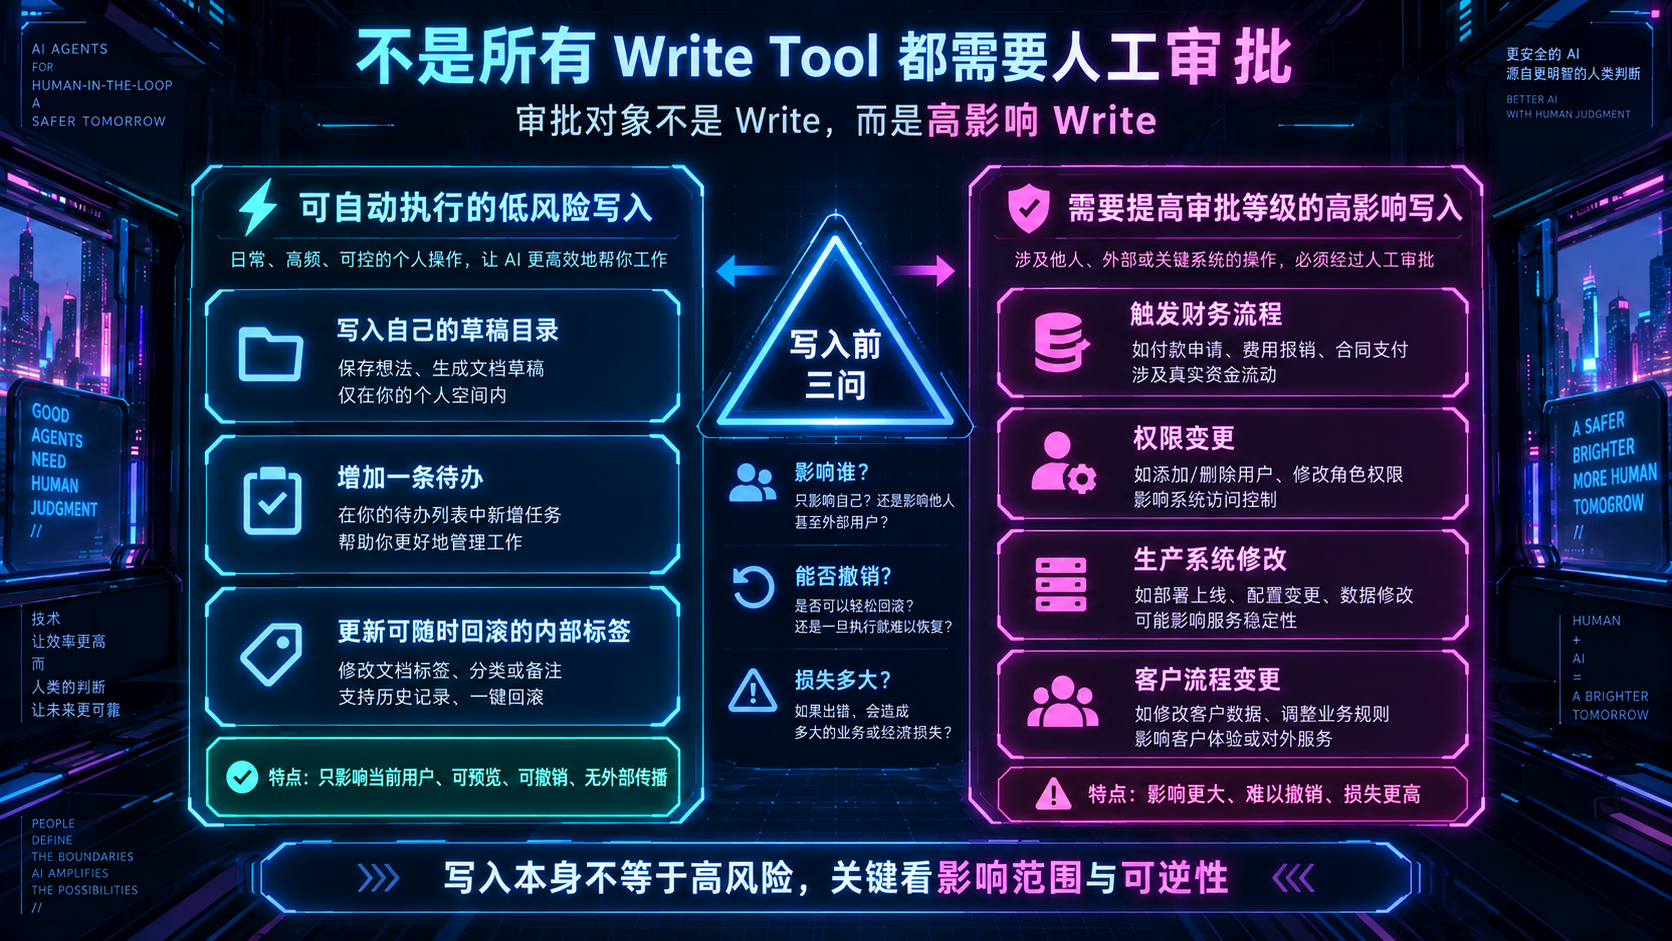
很多团队最容易采用的规则是:"只要是写操作,就必须审批。"这种做法简单,但很快会变得低效。
写入本身并不等于高风险。
例如,Agent 把会议纪要写入自己的草稿目录、给任务列表增加一条待办、更新一个可随时回滚的内部标签,这些操作即使出错,成本通常也很低。强制人工确认,只会制造审批疲劳。
更值得关注的是三个问题:这次写入影响谁?能不能撤销?出错后的损失有多大?
如果写入只影响当前用户、结果可预览、可撤销,而且没有外部传播,通常可以自动执行。反过来,即使只是改一个字段,只要它会触发财务、权限、生产系统或客户流程,就应该提高审批等级。
审批对象不是"Write",而是"高影响 Write"。
查询敏感数据,也可能需要审批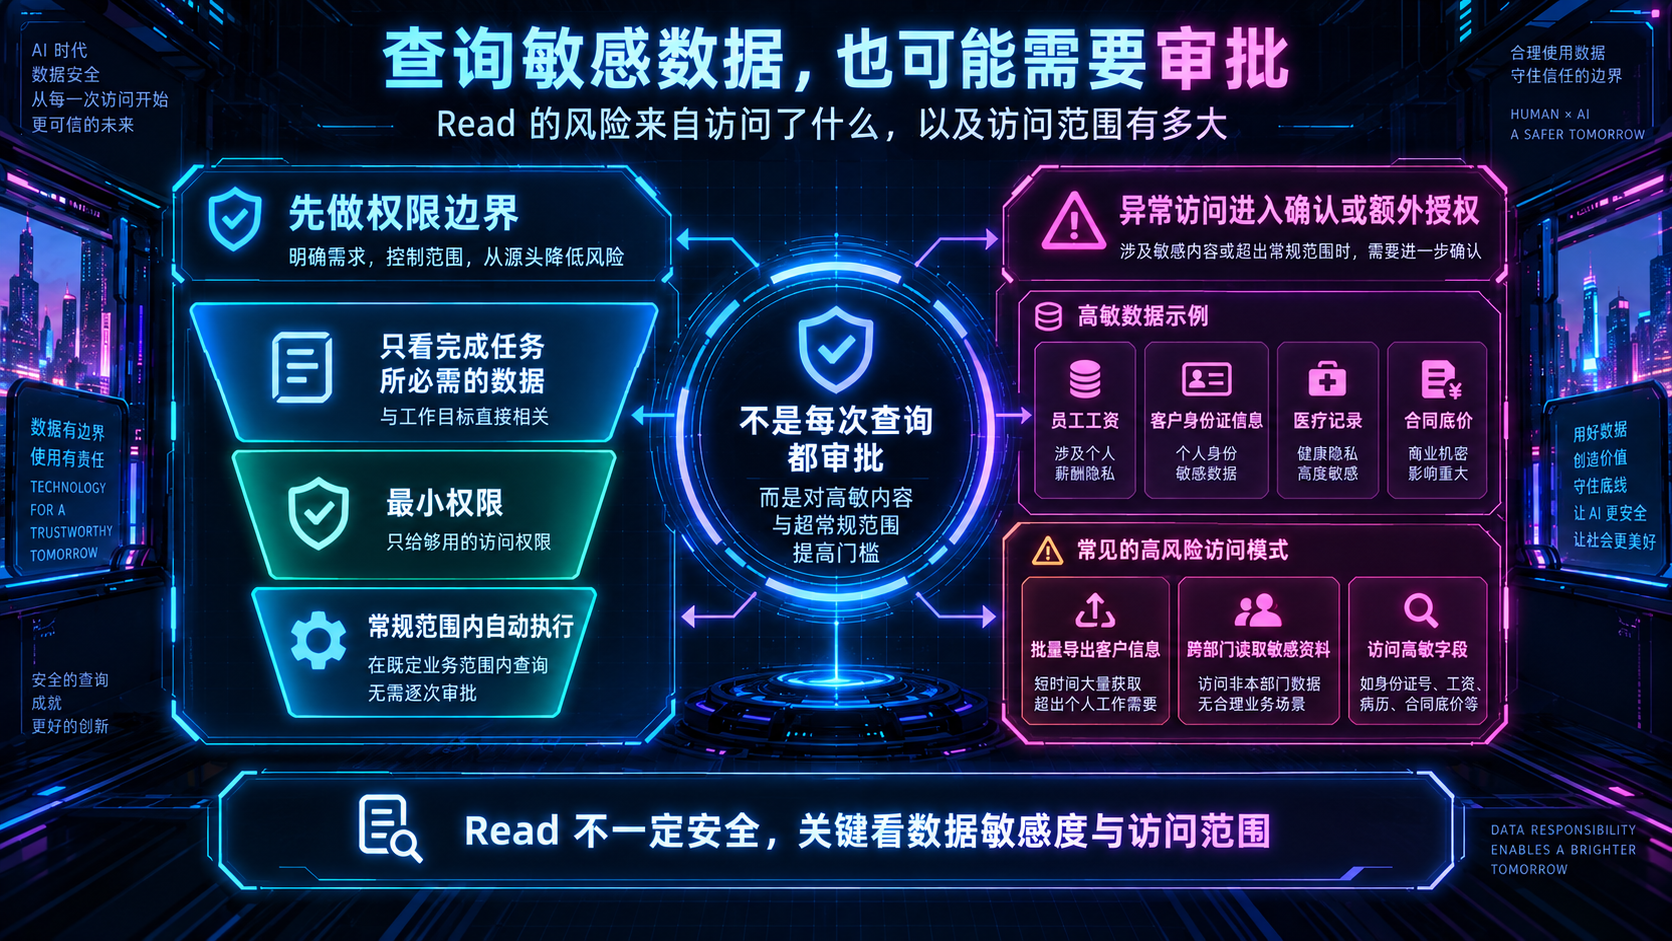
很多人把"读"理解成安全,把"写"理解成危险。这个判断并不完整。
假设一个 Agent 能查询员工工资、客户身份证信息、医疗记录、合同底价。它没有修改任何数据,但一次不必要的读取,本身就可能构成越权访问或隐私暴露。
因此,敏感数据的控制重点通常不是"每次查询都弹审批",而是先做权限边界:Agent 只能看到完成任务所必需的数据。
当查询超出常规范围,例如批量导出客户信息、跨部门读取敏感资料、访问高敏字段,才进入人工确认或额外授权流程。
也就是说,Read Tool 的风险主要来自"访问了什么"和"访问范围多大",而不是"有没有改东西"。
发送邮件,关键看收件人和内容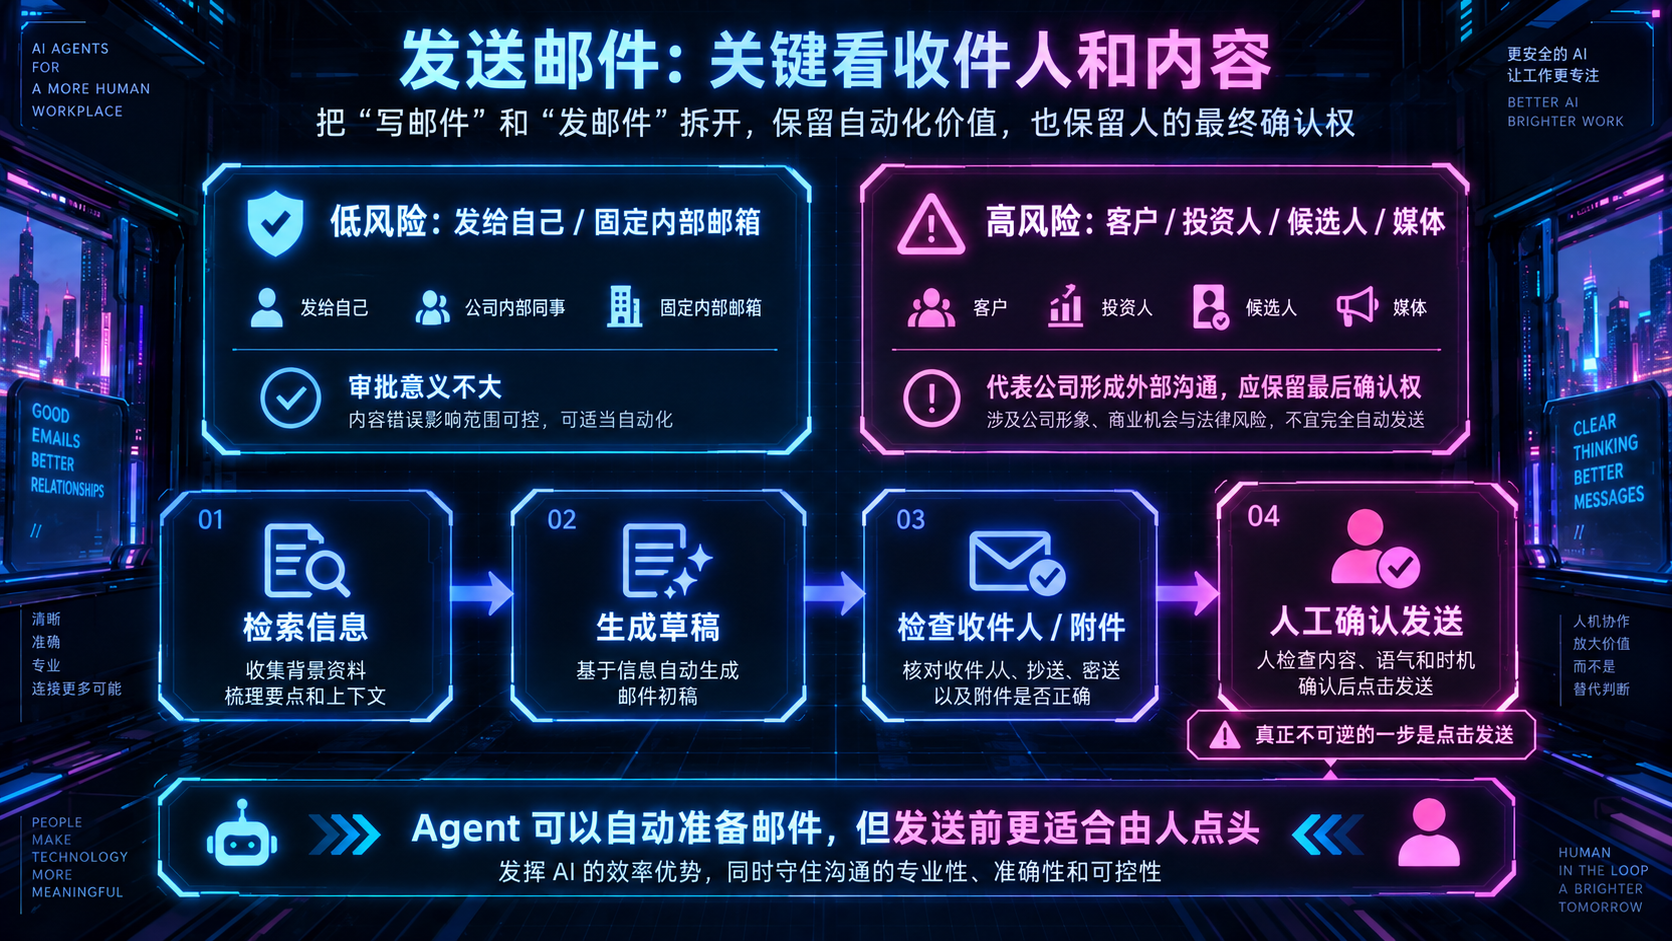
"发送邮件必须审批吗?"答案同样不是简单的"是"。
如果 Agent 每天给自己发送一份日报,或者把系统告警发到固定内部邮箱,审批意义不大。
但如果邮件会发给客户、投资人、候选人、媒体,甚至代表公司形成承诺,人应该保留最后确认权。因为此时风险来自外部沟通,而不仅仅是一次 API 调用。
一个实用的设计是把"写邮件"和"发邮件"拆开。
Agent 可以自动检索信息、生成草稿、补充附件、检查收件人;真正点击发送之前,再让人确认。这样既保留了自动化价值,也把最不可逆的一步留给人。
当前一些 Agent 平台也采用类似思路:低风险动作可以自动执行,而发送、修改、发布、删除等更高风险动作可设置审批门槛。
删除文件,应该默认比创建文件更谨慎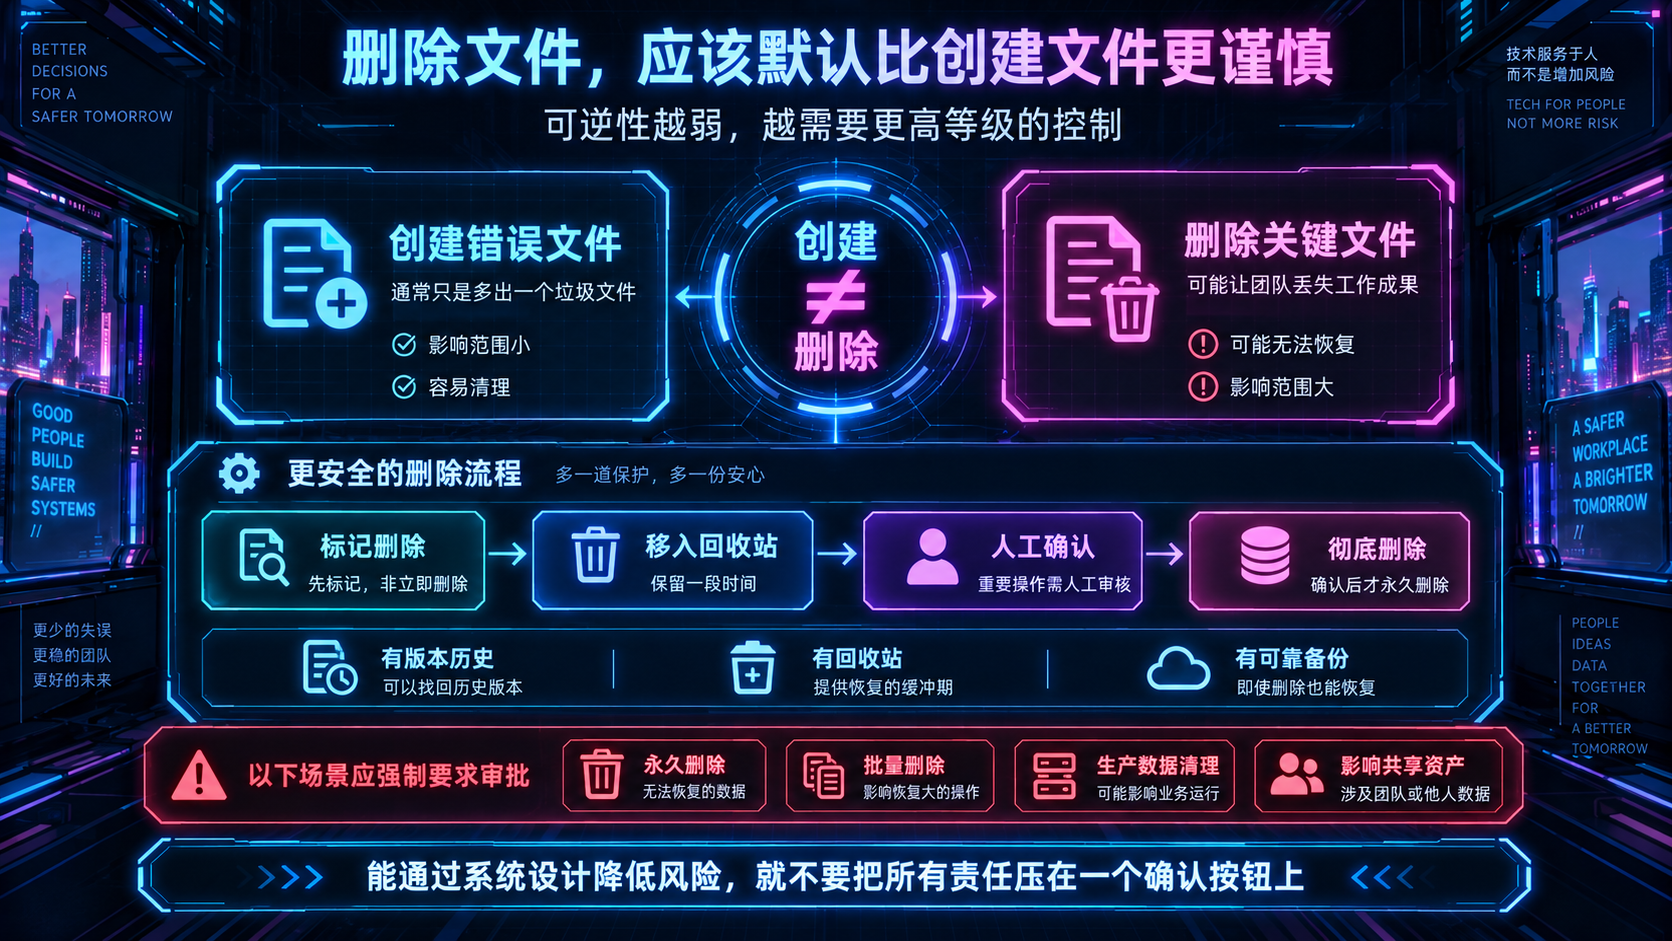
创建一份错误文件,通常只是多出一个垃圾文件;删除一份关键文件,可能让整个团队丢失工作成果。
这就是"可逆性"为什么重要。
如果文件有版本历史、回收站和可靠备份,删除可以先进入软删除,再由系统自动处理。可如果是永久删除、批量删除、生产数据清理,或者影响共享资产,就应该要求人工确认。
更稳妥的 Agent 设计甚至不会直接提供"永久删除",而是把动作拆成"标记删除""移入回收站""人工确认后彻底删除"。
能通过系统设计降低风险,就不要把所有安全责任都交给一个"确认"按钮。
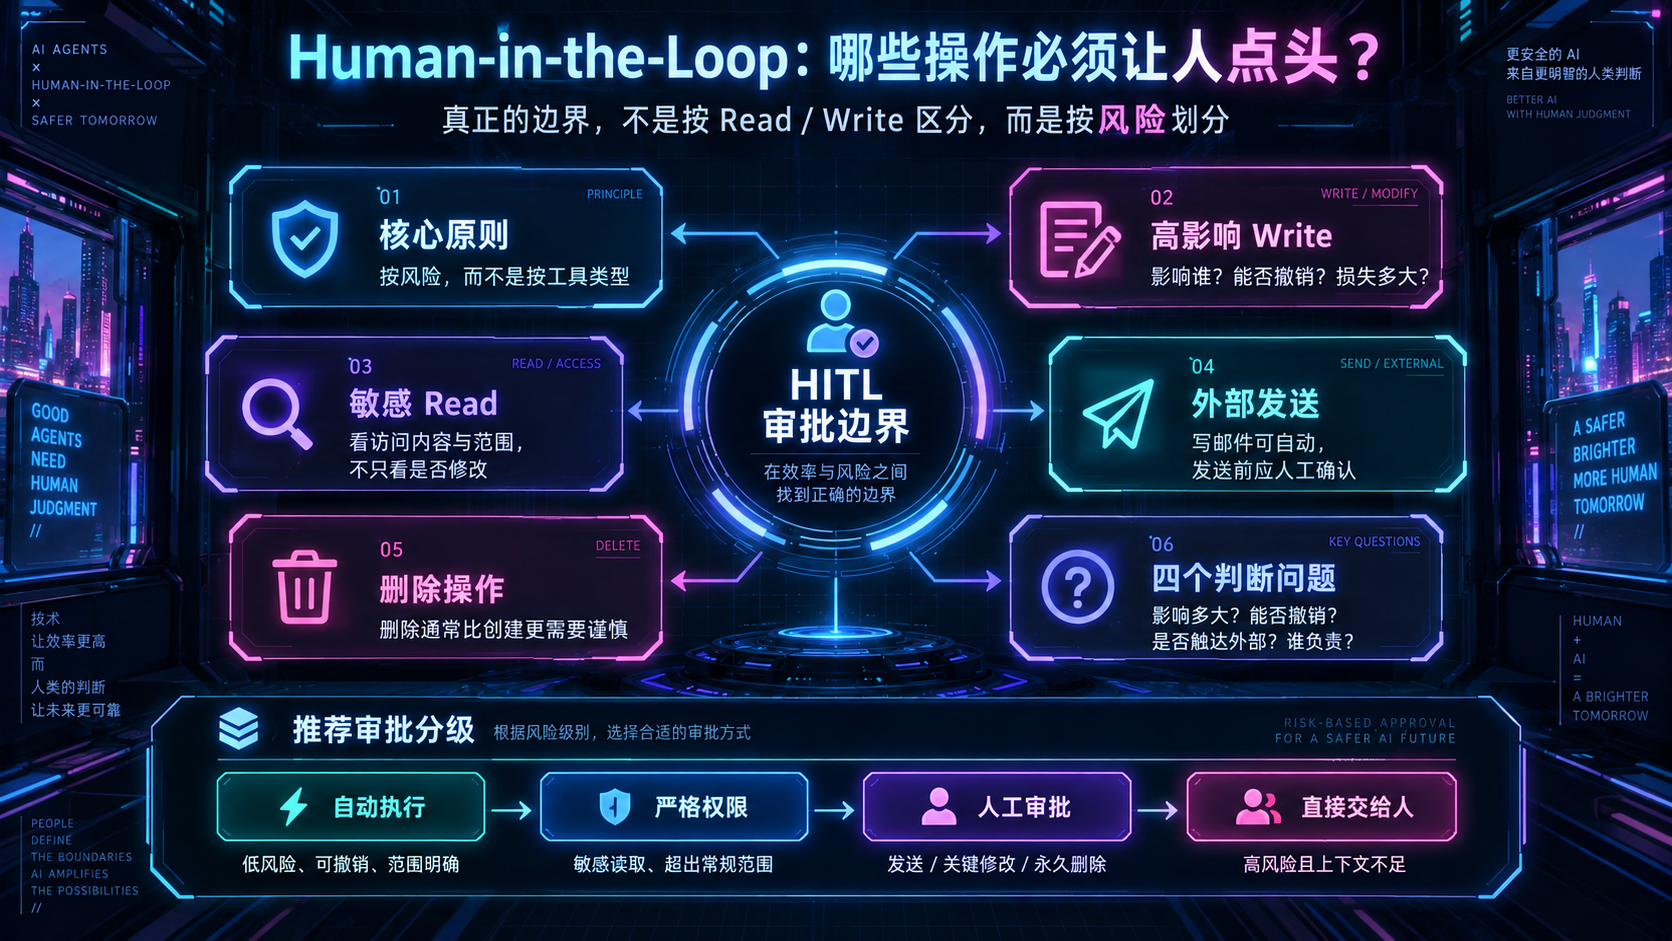
判断要不要 HITL,可以看四件事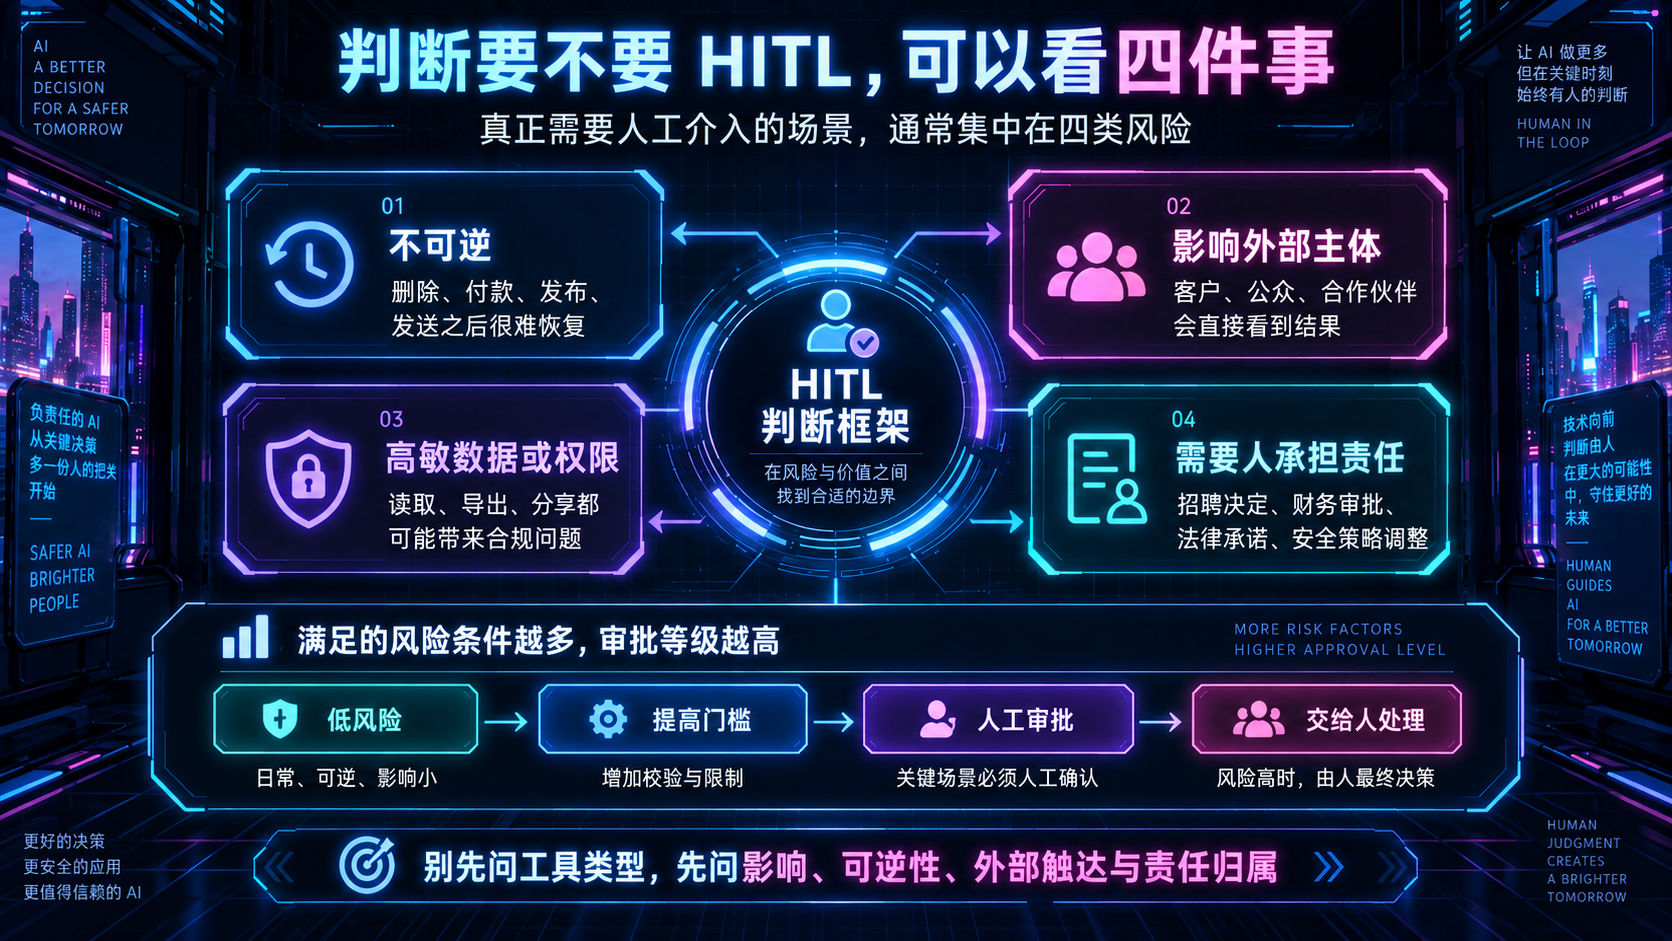
真正需要人工介入的场景,通常集中在四类风险。
第一,影响不可逆。删除、付款、发布、发送之后很难恢复。
第二,影响外部主体。客户、公众、合作伙伴会直接看到结果。
第三,涉及高敏数据或权限。读取、导出、分享都可能带来合规问题。
第四,需要人承担责任。比如招聘决定、财务审批、法律承诺、安全策略调整。AI 可以提供材料和建议,但最终责任不能模糊。
反过来,低风险、可撤销、范围明确、规则稳定的动作,更适合自动化。
这也是 HITL 最容易被误解的地方:它不是给 AI 每一步都装一个刹车,而是在真正危险的路口设置闸门。
最好的审批机制,不是审批最多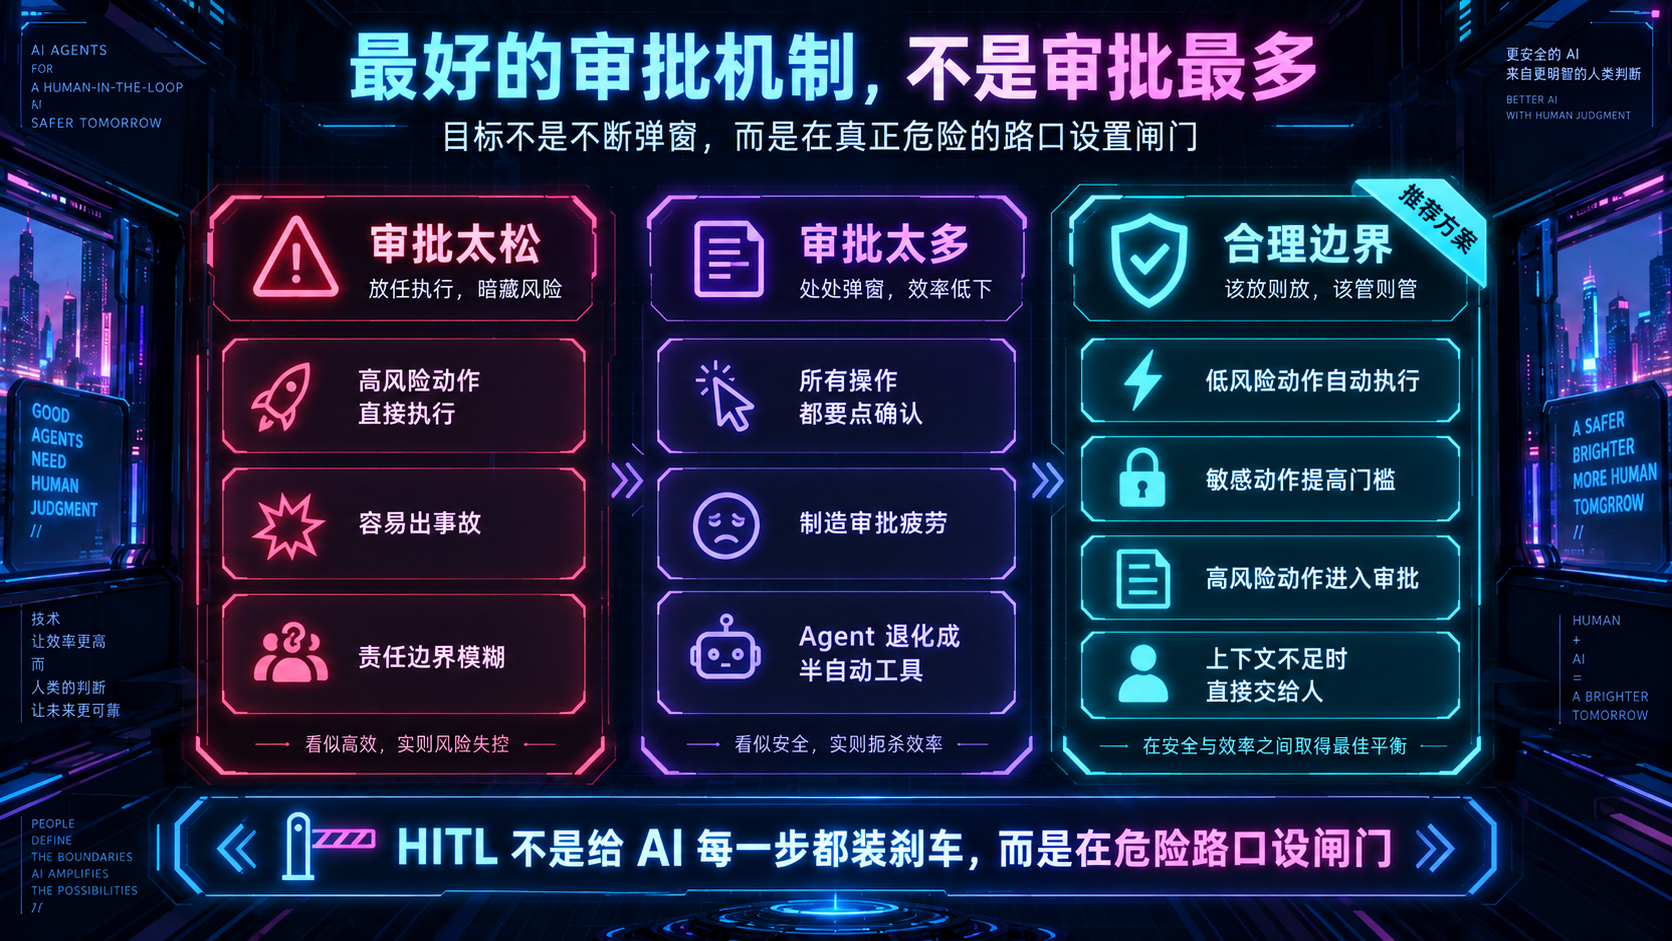
一个成熟的 Agent 系统,不应该让用户不断点击"允许"。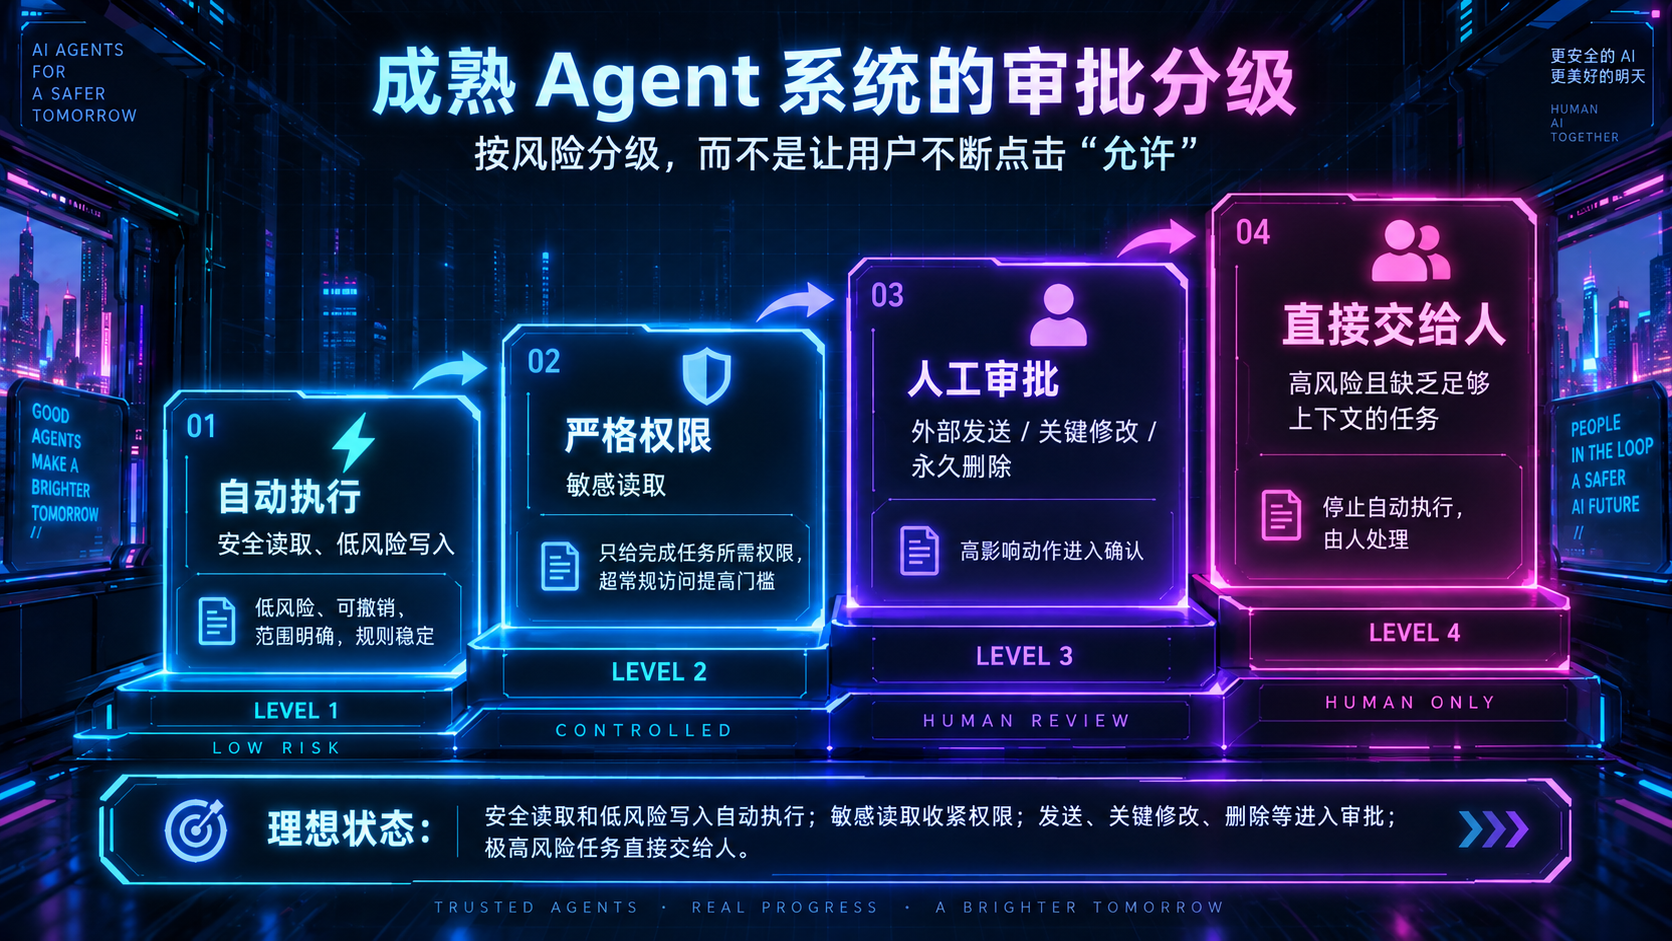
更好的方式是先把动作分级:安全读取和低风险写入自动执行;敏感读取需要更严格权限;外部发送、关键修改、永久删除等动作进入审批;高风险且缺乏足够上下文的任务则直接停止并交给人处理。
这样设计后,Human-in-the-Loop 才不会成为自动化的障碍,而会变成责任边界的一部分。
下次判断某个 Tool 是否需要审批,不妨先别问"这是 Read 还是 Write",而问四个更具体的问题:影响有多大?能否撤销?会不会触达外部?出了问题谁负责?
这四个问题,往往比工具名称更接近正确答案。