目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第七讲 Part 8:时序差分方法(TD 算法的统一形式和总结),记录个人学习笔记,和大家一起分享交流😄
1. A unified point of view
到此为止我们介绍完了 Q-learning,刚刚学习了 Q-learning 的算法是什么以及它解决什么数学问题,我们只用了两页幻灯片介绍这两个内容,因为前面关于 TD 还有 Sarsa 都给我们打下了非常好的基础。
之后我们重点介绍了 on-policy 和 off-policy ,这是强化学习中非常重要的两个概念,也分析了 Sarsa 和蒙特卡洛方法都是 on-policy,Q-learning 是 off-policy 。我们还通过例子来看了如何用 off-policy 的 Q-learning 来学习最优的策略,off-policy 的性质实际上非常重要,之后学习 Deep Q-learning 时会看到:神经网络与 TD 算法结合时为什么选择 Q-learning--- Q-learning 的 off-policy 性质发挥了重要作用。
下面来到最后一节:对刚才所有 TD 算法的总结。你会发现所有算法其实非常相似,为什么呢?来看一下。
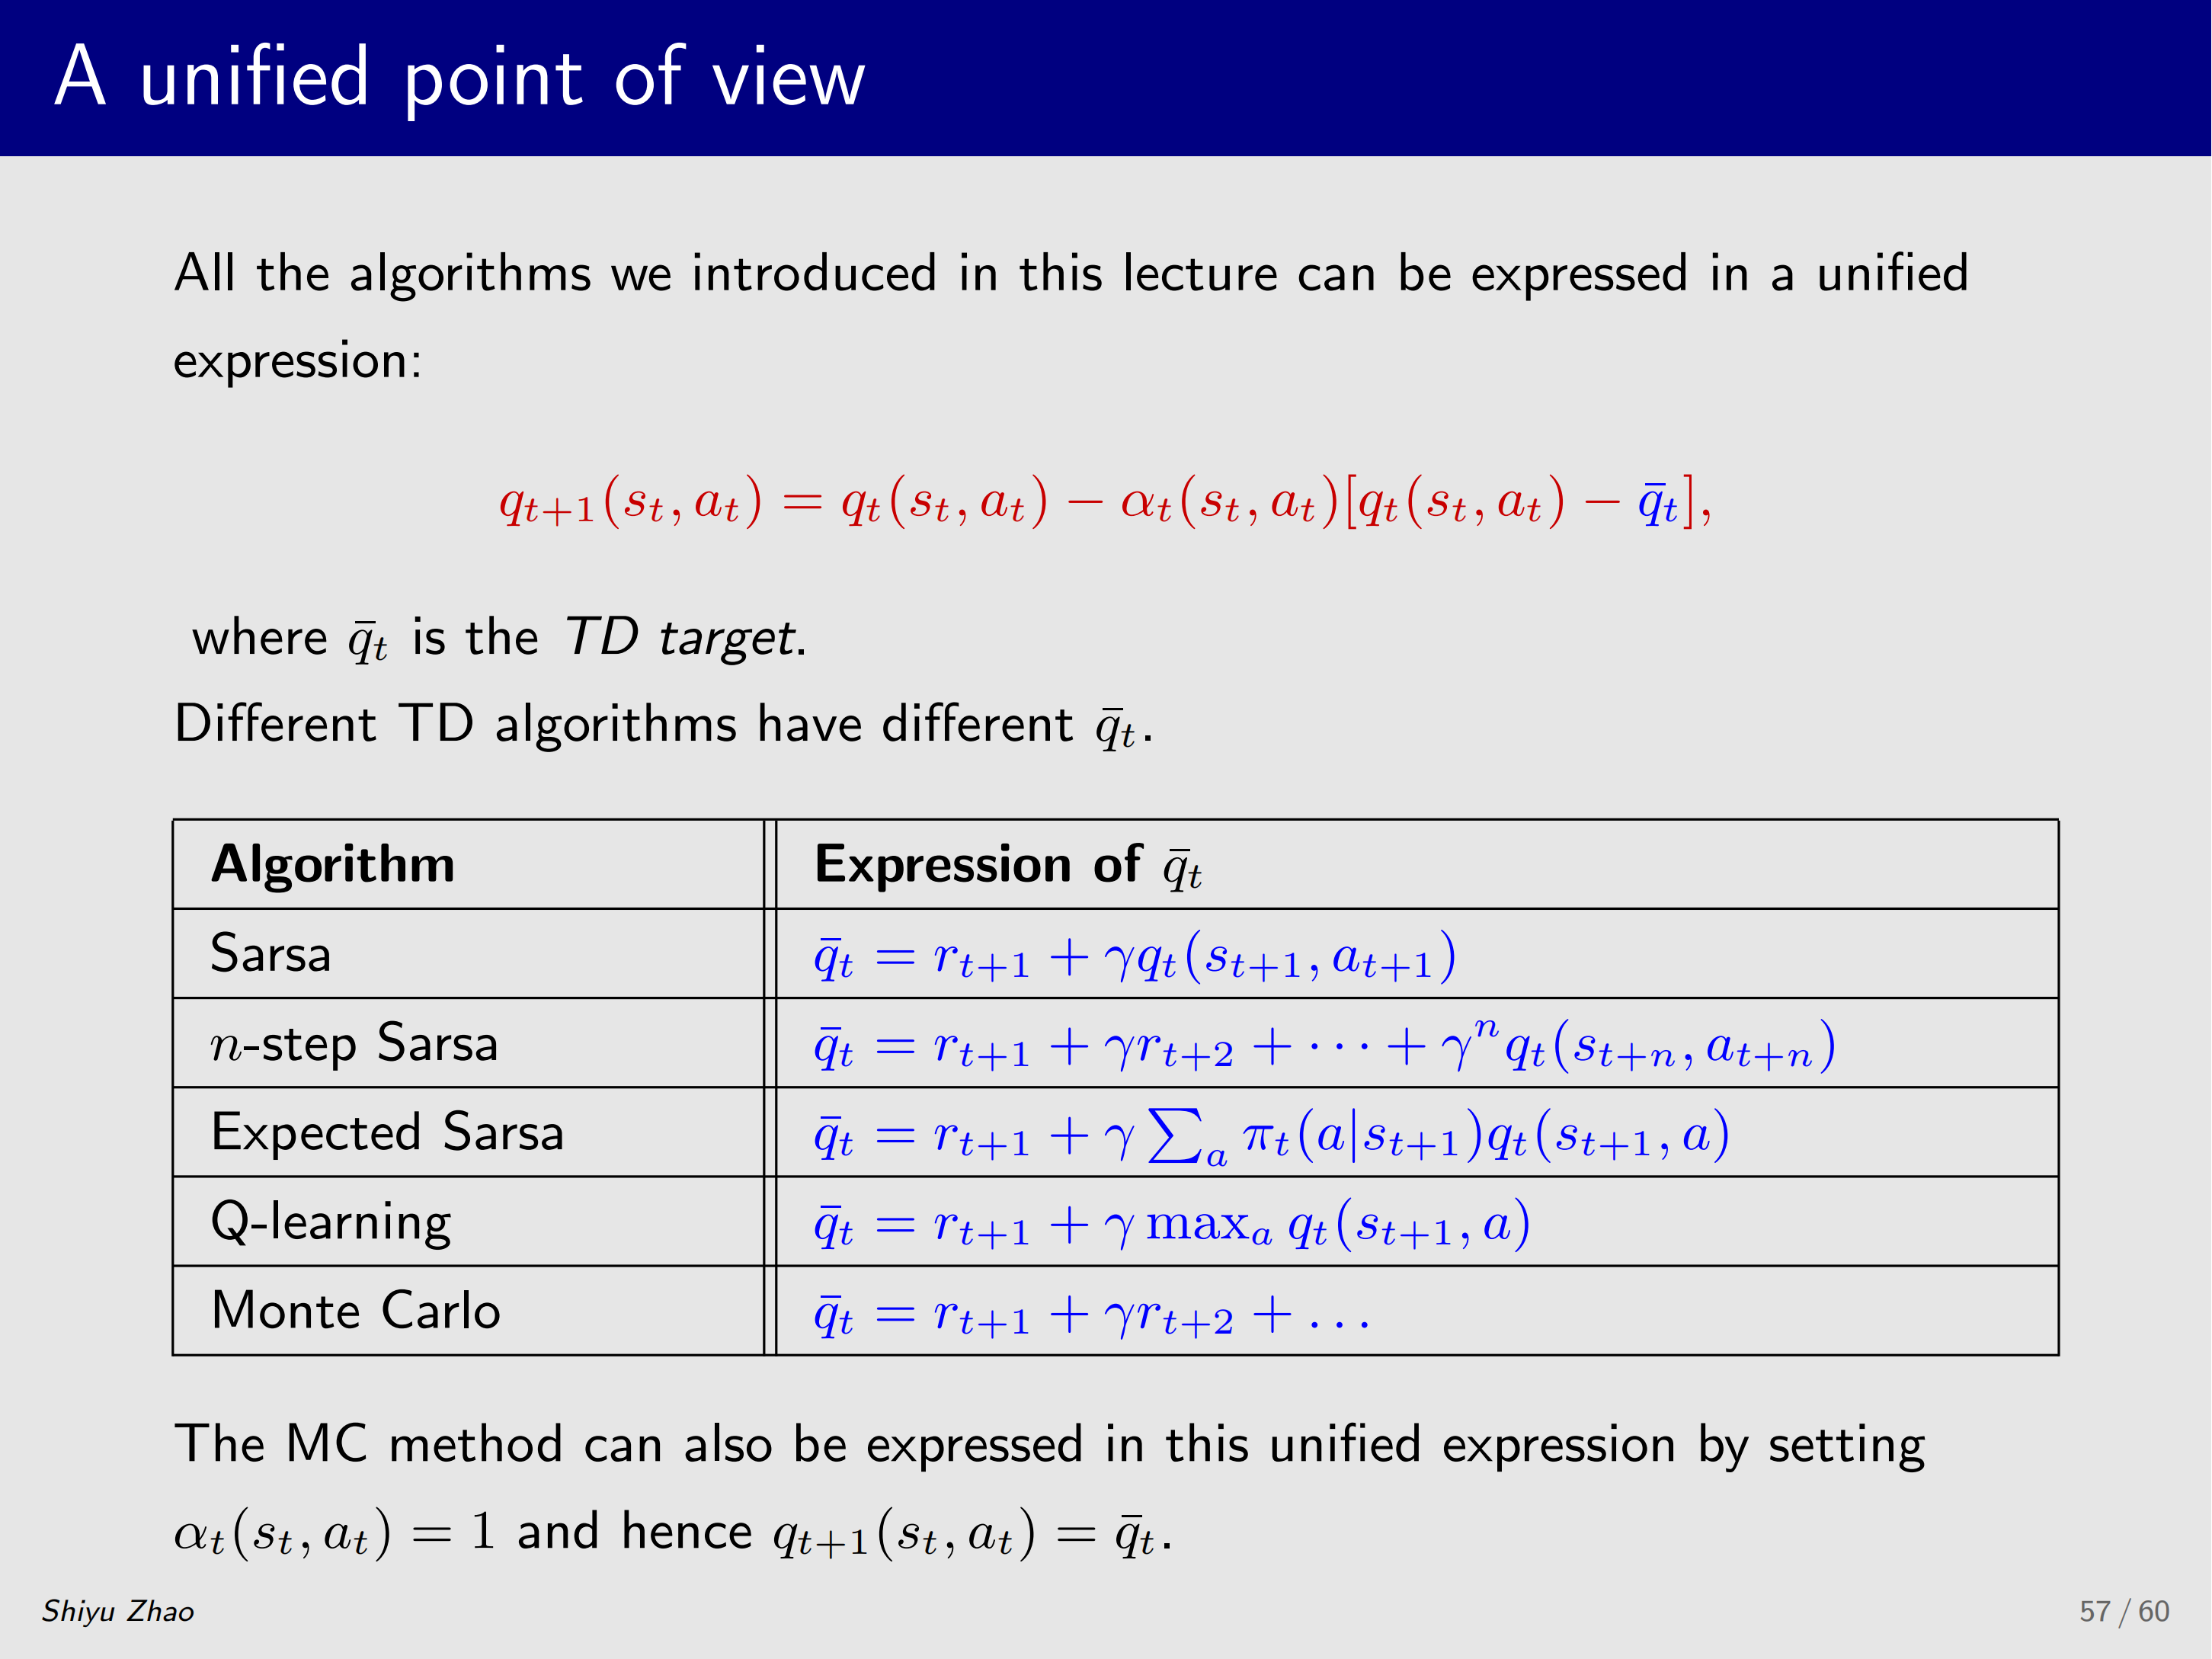
q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) q t ( s t , a t ) − q ˉ t , \textcolor{red}{q_{t+1}(s_t, a_t) = q_t(s_t, a_t) - \alpha_t(s_t, a_t)\leftq_t(s_t, a_t) - \\textcolor{blue}{\\bar{q}_t}\\right,} qt+1(st,at)=qt(st,at)−αt(st,at)qt(st,at)−qˉt,
首先刚才介绍的所有的 TD 算法,都可以用上面这个 统一表达式 表示,其中 q t ( s t , a t ) q_t(s_t,a_t) qt(st,at) 是 ( s t , a t ) (s_t,a_t) (st,at) 的 action value 在 t t t 时刻的估计值,左边是 q t + 1 q_{t+1} qt+1 ,等于 q t q_t qt 减去 α t q t ( s t , a t ) − q ˉ t \alpha_tq_t(s_t,a_t)-\\bar{q}_t αtqt(st,at)−qˉt 。
这个蓝色的 q ˉ t \bar{q}_t qˉt 代表的就是 TD target , TD 算法的一个基本思路就是让 q t q_t qt 接近 TD target 。前面也介绍过为什么它叫 TD target---因为这个式子的作用就是让 q t q_t qt 朝 q ˉ t \bar{q}_t qˉt 靠近。两者的差距就叫 TD error ,让 q t q_t qt 接近 q ˉ t \bar{q}_t qˉt,自然也就是减小 TD error。
所有 TD 算法的不同点在哪?就在 q ˉ t \bar{q}_t qˉt 的构造上:
| 算法 | q ˉ t \bar{q}_t qˉt 的表达式 |
|---|---|
| Sarsa | q ˉ t = r t + 1 + γ q t ( s t + 1 , a t + 1 ) \color{blue}\bar{q}t = r{t+1} + \gamma q_t(s_{t+1}, a_{t+1}) qˉt=rt+1+γqt(st+1,at+1) |
| n n n-step Sarsa | q ˉ t = r t + 1 + γ r t + 2 + ⋯ + γ n q t ( s t + n , a t + n ) \color{blue}\bar{q}t = r{t+1} + \gamma r_{t+2} + \dots + \gamma^n q_t(s_{t+n}, a_{t+n}) qˉt=rt+1+γrt+2+⋯+γnqt(st+n,at+n) |
| Expected Sarsa | q ˉ t = r t + 1 + γ ∑ a π t ( a ∣ s t + 1 ) q t ( s t + 1 , a ) \color{blue} \bar{q}t = r{t+1} + \gamma \sum_a \pi_t(a \mid s_{t+1}) q_t(s_{t+1},a) qˉt=rt+1+γ∑aπt(a∣st+1)qt(st+1,a) |
| Q-learning | q ˉ t = r t + 1 + γ max a q t ( s t + 1 , a ) \color{blue} \bar{q}t = r{t+1} + \gamma \max_a q_t(s_{t+1}, a) qˉt=rt+1+γmaxaqt(st+1,a) |
| Monte Carlo | q ˉ t = r t + 1 + γ r t + 2 + ... \color{blue} \bar{q}t = r{t+1} + \gamma r_{t+2} + \dots qˉt=rt+1+γrt+2+... |
比如 Sarsa,对此我们都很熟悉了,它的 TD target 就是 r t + 1 + γ q t ( s t + 1 , a t + 1 ) r_{t+1} + \gamma q_t(s_{t+1}, a_{t+1}) rt+1+γqt(st+1,at+1) , n n n-step Sarsa 是多做几步分解,最后是 q t ( s t + n , a t + n ) q_t(s_{t+n},a_{t+n}) qt(st+n,at+n) ,Expected Sarsa 的 TD target 中没有 a t + 1 a_{t+1} at+1 ,它对 a a a 求期望,Q-learning 则对 a a a 求最大化,这些是我们刚才所介绍的 TD 算法。
实际上 蒙特卡洛方法也可以用这个式子表达 ,这时候它的 TD target 是什么呢?就是 r t + 1 + γ r t + 2 + ... r_{t+1} + \gamma r_{t+2} + \dots rt+1+γrt+2+... ,最后没有 q t q_t qt 项,全是 immediate reward,可以看成 n n n-step Sarsa 的特殊情况。要把蒙特卡洛方法写成这个形式,可以取 α t = 1 \alpha_t = 1 αt=1 :此时 α t \alpha_t αt 可以省略,式中 q t q_t qt 减 q t q_t qt 抵消,最后 q t + 1 q_{t+1} qt+1 就等于 q ˉ t \bar{q}_t qˉt 。
所有算法都可以写成这个统一形式 。除了形式统一之外,它们在做的事情也可以统一表述--- 它们在做什么?都在求解某些方程。
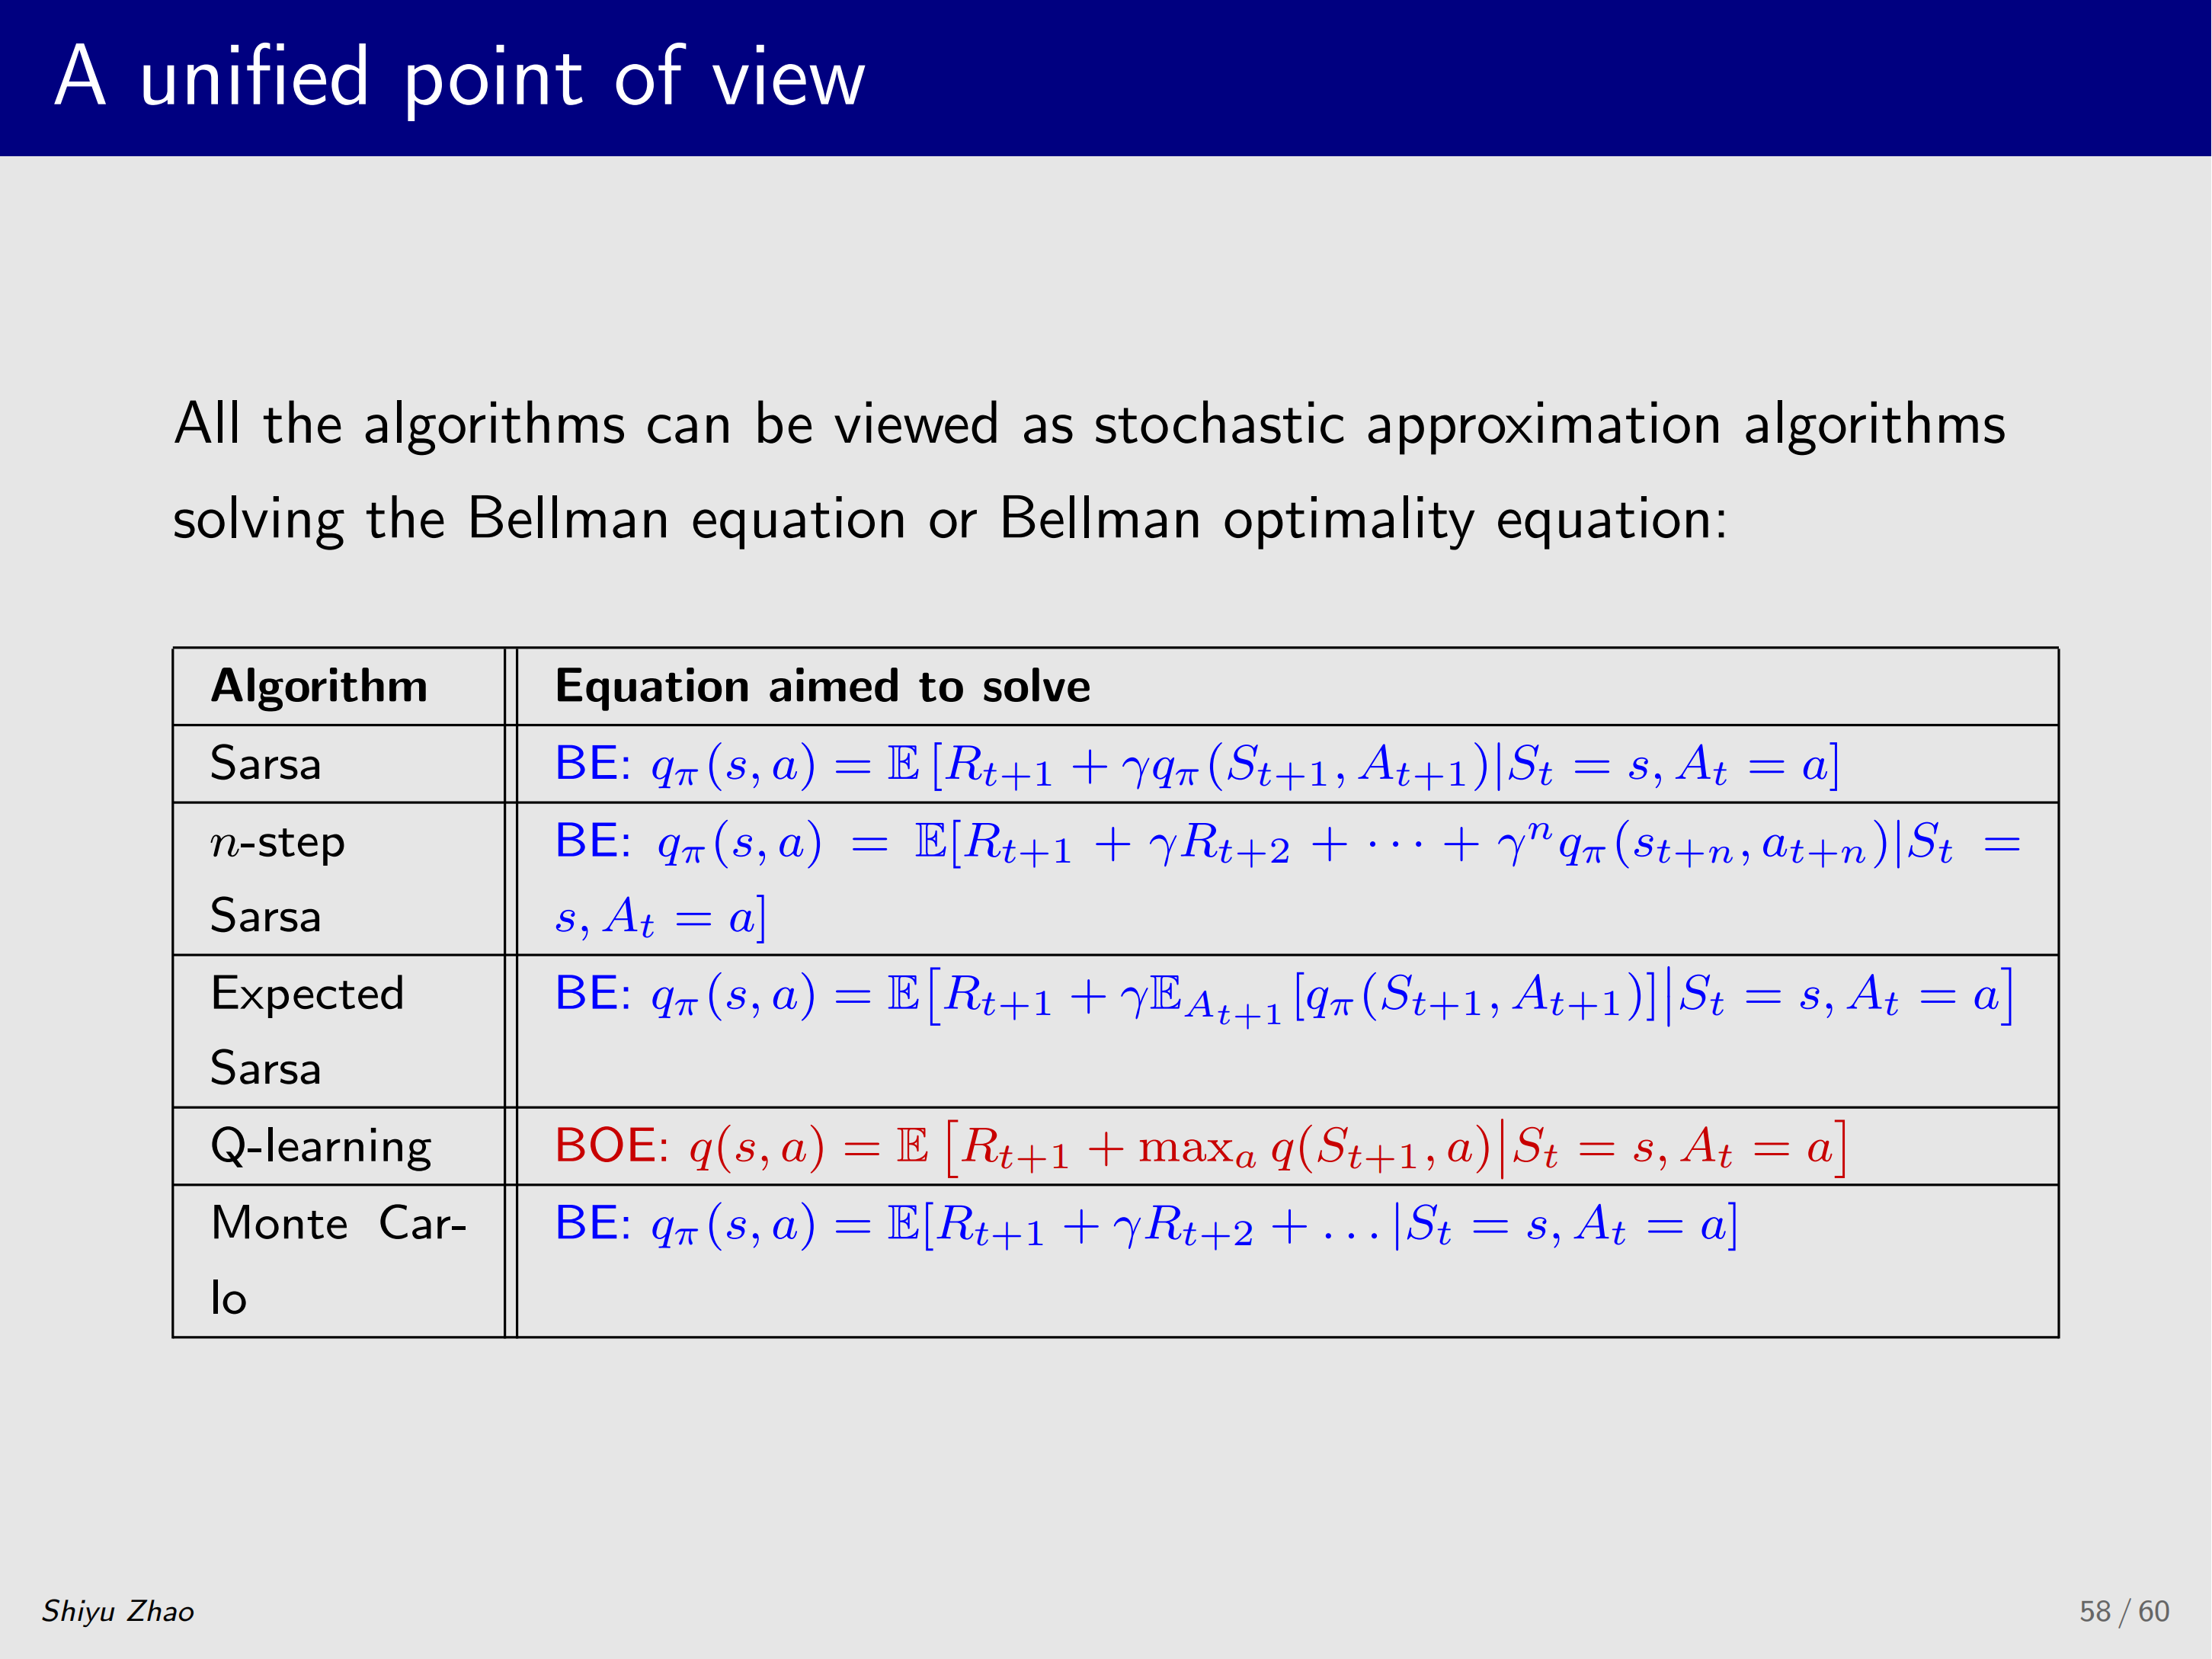
| 算法 | 旨在求解的方程 |
|---|---|
| Sarsa | BE: q π ( s , a ) = E R t + 1 + γ q π ( S t + 1 , A t + 1 ) ∣ S t = s , A t = a \color{blue} \text{BE: } q_\pi(s, a) = \mathbb{E}R_{t+1} + \\gamma q_\\pi(S_{t+1}, A_{t+1}) \\mid S_t = s, A_t = a BE: qπ(s,a)=ERt+1+γqπ(St+1,At+1)∣St=s,At=a |
| n n n-step Sarsa | BE: q π ( s , a ) = E R t + 1 + γ R t + 2 + ⋯ + γ n q π ( S t + n , A t + n ) ∣ S t = s , A t = a \color{blue} \text{BE: } q_\pi(s, a) = \mathbb{E}R_{t+1} + \\gamma R_{t+2} + \\dots + \\gamma\^n q_\\pi(S_{t+n}, A_{t+n}) \\mid S_t = s, A_t = a BE: qπ(s,a)=ERt+1+γRt+2+⋯+γnqπ(St+n,At+n)∣St=s,At=a |
| Expected Sarsa | BE: q π ( s , a ) = E R t + 1 + γ E A t + 1 \[ q π ( S t + 1 , A t + 1 ) ∣ S t = s , A t = a ] \color{blue} \text{BE: } q_\pi(s, a) = \mathbb{E}R_{t+1} + \\gamma \\mathbb{E}_{A_{t+1}}\[q_\\pi(S_{t+1}, A_{t+1}) \mid S_t = s, A_t = a] BE: qπ(s,a)=ERt+1+γEAt+1\[qπ(St+1,At+1)∣St=s,At=a] |
| Q-learning | BOE: q ( s , a ) = E R t + 1 + γ max a q ( S t + 1 , a ) ∣ S t = s , A t = a \color{red} \text{BOE: } q(s, a) = \mathbb{E}R_{t+1} + \\gamma \\max_a q(S_{t+1}, a) \\mid S_t = s, A_t = a BOE: q(s,a)=ERt+1+γmaxaq(St+1,a)∣St=s,At=a |
| Monte Carlo | BE: q π ( s , a ) = E R t + 1 + γ R t + 2 + ⋯ ∣ S t = s , A t = a \color{blue} \text{BE: } q_\pi(s, a) = \mathbb{E}R_{t+1} + \\gamma R_{t+2} + \\dots \\mid S_t = s, A_t = a BE: qπ(s,a)=ERt+1+γRt+2+⋯∣St=s,At=a |
实际上就是 贝尔曼公式或贝尔曼最优公式 ,相应的算法就是求解这些公式的 stochastic approximation 的算法,比如 Sarsa 就是求解这样一个贝尔曼公式,当然,这个贝尔曼公式与最开始介绍的不同---它用 action value 表示。
所以这次课也介绍了 贝尔曼公式的多种表达形式 ,它们实际上都是贝尔曼公式。大家可能也注意到:expectation 里的这些项是什么?实际上就是对应算法里的 TD target,这里我们就不再逐个讲了,之前都已介绍过。需要强调的一点是: Q-learning 不是求解贝尔曼公式,而是求解贝尔曼最优公式,所以它直接求出最优 q value,相应得到的 policy 也就是最优的。
还有一点需要补充:这些 TD 方法本质上是在求解给定策略的贝尔曼公式。怎么用它搜索最优策略呢?把 policy evaluation 与 policy improvement 结合 ,就得到搜索最优策略的算法。蒙特卡洛方法也求解这样一个式子---可以说它是贝尔曼公式,实际上它就是 action value 最基本的定义。
2. Summary
到此我们介绍完了本节课的全部内容,最后做一个小结。
首先大家还记得,在 motivating example 中我们有给出几个例子:把上节课学的 RM 算法 用来求解一些公式,然后所得到的对应 RM 算法实际上和我们后面要介绍的 TD 算法 是非常类似的。
然后在第二节当中我们介绍了 TD 算法 ,这是非常经典的一个 TD 算法,当时也提到: TD 算法有时泛指所有 ---本章中所有算法都叫 TD 算法;但估计 state value 的这个算法,我们也叫它 TD 算法。我们不仅给出了算法的形式还说明了它解决的数学问题,还介绍了许多基本性质--- TD 算法最基本的思想和重要内容都在这一节,后面的内容都以这一节为基础,所以这一节非常重要。
之后过渡到 Sarsa 。大家的第一感觉应该是: Sarsa 与第二节介绍的 TD 算法,起码从结构上说一模一样,它只是把 state value 换成了 action value,这里介绍的另一个重要内容是:它不仅能做 policy evaluation,还可以与 policy improvement 结合来实现最优策略的搜索。
在此基础之上我们又介绍了 Sarsa 的两个变形 ,一个是 Expected Sarsa,一个是 n n n-step Sarsa, n n n-step Sarsa 既是变形,也可以理解为以一种推广。之后介绍了 Q-learning 与前几个算法的区别:它求解贝尔曼最优公式,所以它直接求解 optimal action value,除了介绍 Q-learning 的基本算法和它解决的数学问题之外,大家还记得:我们只用两页就介绍完了这些内容,正是因为前面奠定了非常好的基础。
除此之外,我们重点介绍了 off-policy 还有 on-policy ,也知道了 Sarsa、蒙特卡洛方法都是 on-policy,Q-learning 是 off-policy,下节课我们会介绍 Deep Q-learning,神经网络与 TD 算法结合时,为什么选择 Q-learning 呢?实际上, Q-learning 的 off-policy 性质发挥了非常重要的作用。
这里还想强调一点: 所有算法都可以用统一视角来看---表达式统一,唯一不同的是 TD target;要解决的数学问题也统一:都是求解贝尔曼公式或贝尔曼最优公式的 stochastic approximation 算法 。在这个意义上,TD 算法与之前介绍的值迭代、策略迭代就呼应上了: 后者是有模型时求解贝尔曼公式和贝尔曼最优公式,而现在是在无模型情况下求解它们。
这就是这节课的全部内容,希望大家到此为止对 TD learning 有了非常好的理解,下节课我们将会进一步介绍 TD learning,但会把基于表格的形式换成基于函数的形式,到时候神经网络就会登场,最经典的 Deep Q-learning 我们也会介绍,我们下次再见。
结语
本讲第八部分以一记漂亮的收尾完成了对整个 TD 算法家族的总结。所有算法的更新公式都可以统一为 q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) q t ( s t , a t ) − q ˉ t q_{t+1}(s_t,a_t) = q_t(s_t,a_t) - \alpha_t(s_t,a_t)q_t(s_t,a_t) - \\bar{q}_t qt+1(st,at)=qt(st,at)−αt(st,at)qt(st,at)−qˉt ,唯一的区别在于 TD target q ˉ t \bar{q}t qˉt 的构造---Sarsa 用采样 q t ( s t + 1 , a t + 1 ) q_t(s{t+1},a_{t+1}) qt(st+1,at+1) ,Expected Sarsa 用期望, n n n-step Sarsa 用 n n n 步展开,Q-learning 用最大化,而蒙特卡洛方法( α t = 1 \alpha_t = 1 αt=1 时)用完整的 return 和。从更深的层次看,它们统一为求解贝尔曼公式(Sarsa 家族与 MC)或贝尔曼最优公式(Q-learning)的随机近似算法。
这一统一视角具有承前启后的重大意义:往前看,它与 model-based 的值迭代、策略迭代遥相呼应---后者在有模型时求解贝尔曼(最优)公式,前者在无模型时用采样数据求解同样的方程,二者殊途同归;往后看,Q-learning 的 off-policy 性质为下一讲的 Deep Q-learning 埋下伏笔---正是 off-policy 允许用历史经验训练神经网络,才催生了深度强化学习的辉煌。至此,tabular 时代的 TD 学习画上圆满句号,函数逼近的时代即将开启🤗。